
Datos aleatorios
Datos aleatorios genera de 10 a 10,000 filas en hasta 10 columnas independientes a partir de una de 26 distribuciones, entre ellas Normal, Lognormal, Weibull, Triangular, Binomial, Poisson y Multivariate Normal. Los valores se generan sin semilla fija, por lo que cada ejecución da números nuevos. Un redondeo opcional y un resumen gráfico con histograma, prueba de normalidad de Anderson-Darling, intervalos de confianza y gráfica de probabilidad describen los datos generados.
Última revisión:
Idea clave
Datos aleatorios genera números aleatorios de cualquiera de 26 distribuciones continuas, discretas o normales multivariantes en el panel de datos, para datos de práctica, simulación, estudios hipotéticos y ver cuánto varían las muestras.
En esta página
Finalidad
Datos aleatorios genera números aleatorios de una de 26 distribuciones y los coloca en el panel de datos, listos para copiarlos o usarlos en otras herramientas. Úselo para crear datos de práctica para formación, para ver cuánto varía una muestra de un proceso conocido (un histograma de 30 valores de un proceso normal perfecto rara vez tiene forma de campana), para probar un análisis antes de que lleguen los datos reales o para simular un proceso en un estudio hipotético, por ejemplo, tiempos de ciclo a partir de una estimación triangular o tiempos de fallo a partir de un modelo de Weibull. Un resumen gráfico opcional describe los números generados.
Capacidades principales
- 26 distribuciones en una sola lista Distribution: continuas (Normal, Lognormal, Weibull, Exponential, Gamma, Uniform, Triangular y otras), discretas (Binomial, Poisson, Geometric, Hypergeometric, Integer, Discrete y otras) y Multivariate Normal.
- Solo se muestran los campos de parámetros de la distribución elegida.
- De 10 a 10,000 filas y de 1 a 10 columnas independientes (data_1, data_2, …).
- Redondeo opcional a un número determinado de decimales.
- Resumen gráfico opcional de todos los valores generados: histograma, estadísticos descriptivos, prueba de normalidad de Anderson-Darling, intervalos de confianza y gráfica de probabilidad.
- Multivariate Normal: columnas correlacionadas a partir de un vector de medias y una matriz de covarianzas, con las matrices de correlación y covarianza muestrales como comprobación.
Métodos estadísticos
Los valores se generan de forma independiente con los generadores de números aleatorios de NumPy y SciPy, sin semilla fija, por lo que cada Calculate da números nuevos. Cada columna es una muestra independiente del tamaño elegido de la misma distribución. Los parámetros siguen las definiciones habituales: por ejemplo, Normal (media μ, desviación estándar σ), Weibull (forma β, escala η, umbral opcional que se suma a cada valor), Exponential (escala = media, umbral opcional), Integer (números enteros de Minimum a Maximum, ambos incluidos), Geometric (número de ensayos hasta el primer evento, incluido este) y Negative Binomial (número de no eventos antes del número requerido de eventos). Para Lognormal se introducen la media y la desviación estándar de los propios datos: la herramienta las convierte en los parámetros de escala logarítmica σ = √ln(1 + (s/m)²) y μ = ln(m) − σ²/2. Para Discrete, las probabilidades se reescalan para que sumen 1.
Con Graphical Summary marcado, todas las columnas se agrupan en una sola muestra y se describen: media, desviación estándar, varianza, asimetría, curtosis, N, mínimo, cuartiles, mediana, máximo y coeficiente de variación (%); la prueba de normalidad de Anderson-Darling (A cuadrado y valor p); intervalos de confianza del 95% para la media (t), la mediana (Hettmansperger-Sheather) y la desviación estándar (chi cuadrado). Con Exclude outliers marcado, los valores fuera de Q1 − 1.5×IQR o Q3 + 1.5×IQR se omiten solo del resumen; los datos generados los conservan. Para Multivariate Normal, la matriz de covarianzas debe ser cuadrada, simétrica, semidefinida positiva y coincidir con el número de medias.
Campos y opciones de entrada
Campo | Descripción |
Distribution | Obligatorio. Una de las 26 distribuciones; los campos de parámetros de abajo cambian según la elegida. |
Number of rows of data to generate | Obligatorio, de 10 a 10,000. |
Number of columns | Valor predeterminado 1, hasta 10. Cada columna es una muestra independiente. No se usa para Multivariate Normal (una columna por media). |
Graphical Summary | Desmarcada de forma predeterminada. Añade a la salida el resumen gráfico de los valores generados. |
Exclude outliers (1.5×IQR rule) | Opcional. No tiene efecto a menos que Graphical Summary esté marcada; en ese caso, elimina los valores atípicos solo del resumen. |
Decimals | Opcional, de 0 a 10. Redondea los valores generados de las distribuciones continuas (Normal, Lognormal, Weibull, Exponential, T, F, Beta, Cauchy, Chi-Square, Gamma, Laplace, las de valores extremos, Logistic, Loglogistic, Triangular y Uniform). Para Normal, se conservan al menos los decimales suficientes para mostrar la desviación estándar. No se muestra para las distribuciones que dan números enteros o valores de una lista (Binomial, Poisson, Bernoulli, Discrete, Geometric, Hypergeometric, Integer y Negative Binomial) ni para Multivariate Normal. |
Mean / Standard Deviation | Normal; Lognormal (media y desviación estándar de los datos); Poisson usa solo Mean. |
Number of trials / Event probability | Binomial. Event probability sola: Bernoulli y Geometric; con Number of events (éxitos requeridos): Negative Binomial. |
Shape parameter / Scale parameter / Threshold parameter | Weibull (umbral opcional); Gamma y Loglogistic usan forma y escala. |
Scale parameter / Threshold parameter | Exponential (umbral opcional). |
Location parameter / Scale parameter | Cauchy, Laplace, Largest Extreme Value, Smallest Extreme Value y Logistic. |
Degrees of freedom / Numerator and Denominator degrees of freedom | T y Chi-Square; F. |
First shape parameter / Second shape parameter | Beta. |
Values / Probabilities | Discrete. Separados por comas o espacios, en igual cantidad, p. ej., “1 2 3” y “0.2 0.3 0.5” (se renormalizan si no suman 1). |
Population size (N) / Event count in population / Sample size (n) | Hypergeometric. El recuento de eventos y el tamaño de muestra no pueden superar el tamaño de la población. |
Minimum / Maximum / Mode (most likely value) | Integer (mínimo y máximo); Triangular (los tres, con la moda entre ellos). |
Lower endpoint / Upper endpoint | Uniform. |
Means / Covariance matrix | Multivariate Normal. Means una por variable, p. ej., “10 20 30”; filas de la covarianza separadas por punto y coma, p. ej., “4,2,0; 2,9,1; 0,1,1”. |
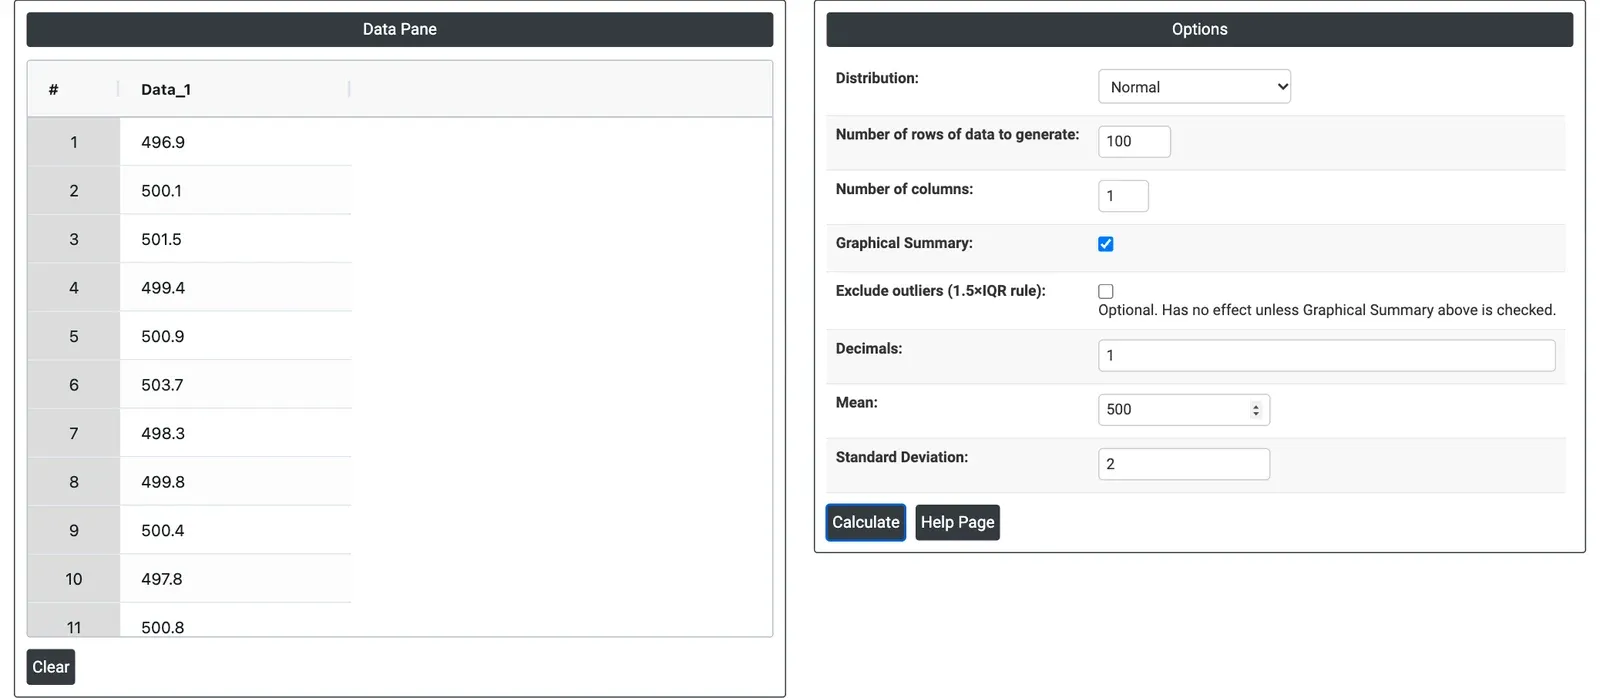
Figura 1: 100 valores de una distribución Normal con media 500 y desviación estándar 2, redondeados a 1 decimal, en el panel de datos (izquierda) con las Options (derecha).
Descripción de la salida
- Data Pane: los valores generados, una columna por muestra (data_1, data_2, …), que sustituyen a lo que había.
- Graphical summary (si está marcado): histograma con curva normal ajustada y gráfica de caja; tabla resumen con A-Squared, p-value, Mean, StDev, Variance, Skewness, Kurtosis, N, Minimum, 1st Quartile, Median, 3rd Quartile, Maximum y Coeff Var; gráfica de intervalos de confianza del 95% para la media y la mediana; Probability Plot con el resultado de Anderson-Darling; y una tabla de límites inferior y superior del 95% para la media, la mediana y la desviación estándar, con la semiamplitud de cada intervalo.
- Multivariate Normal: matrices de correlación y covarianza muestrales de las columnas generadas.
- Exportación a PDF mediante Download as PDF.
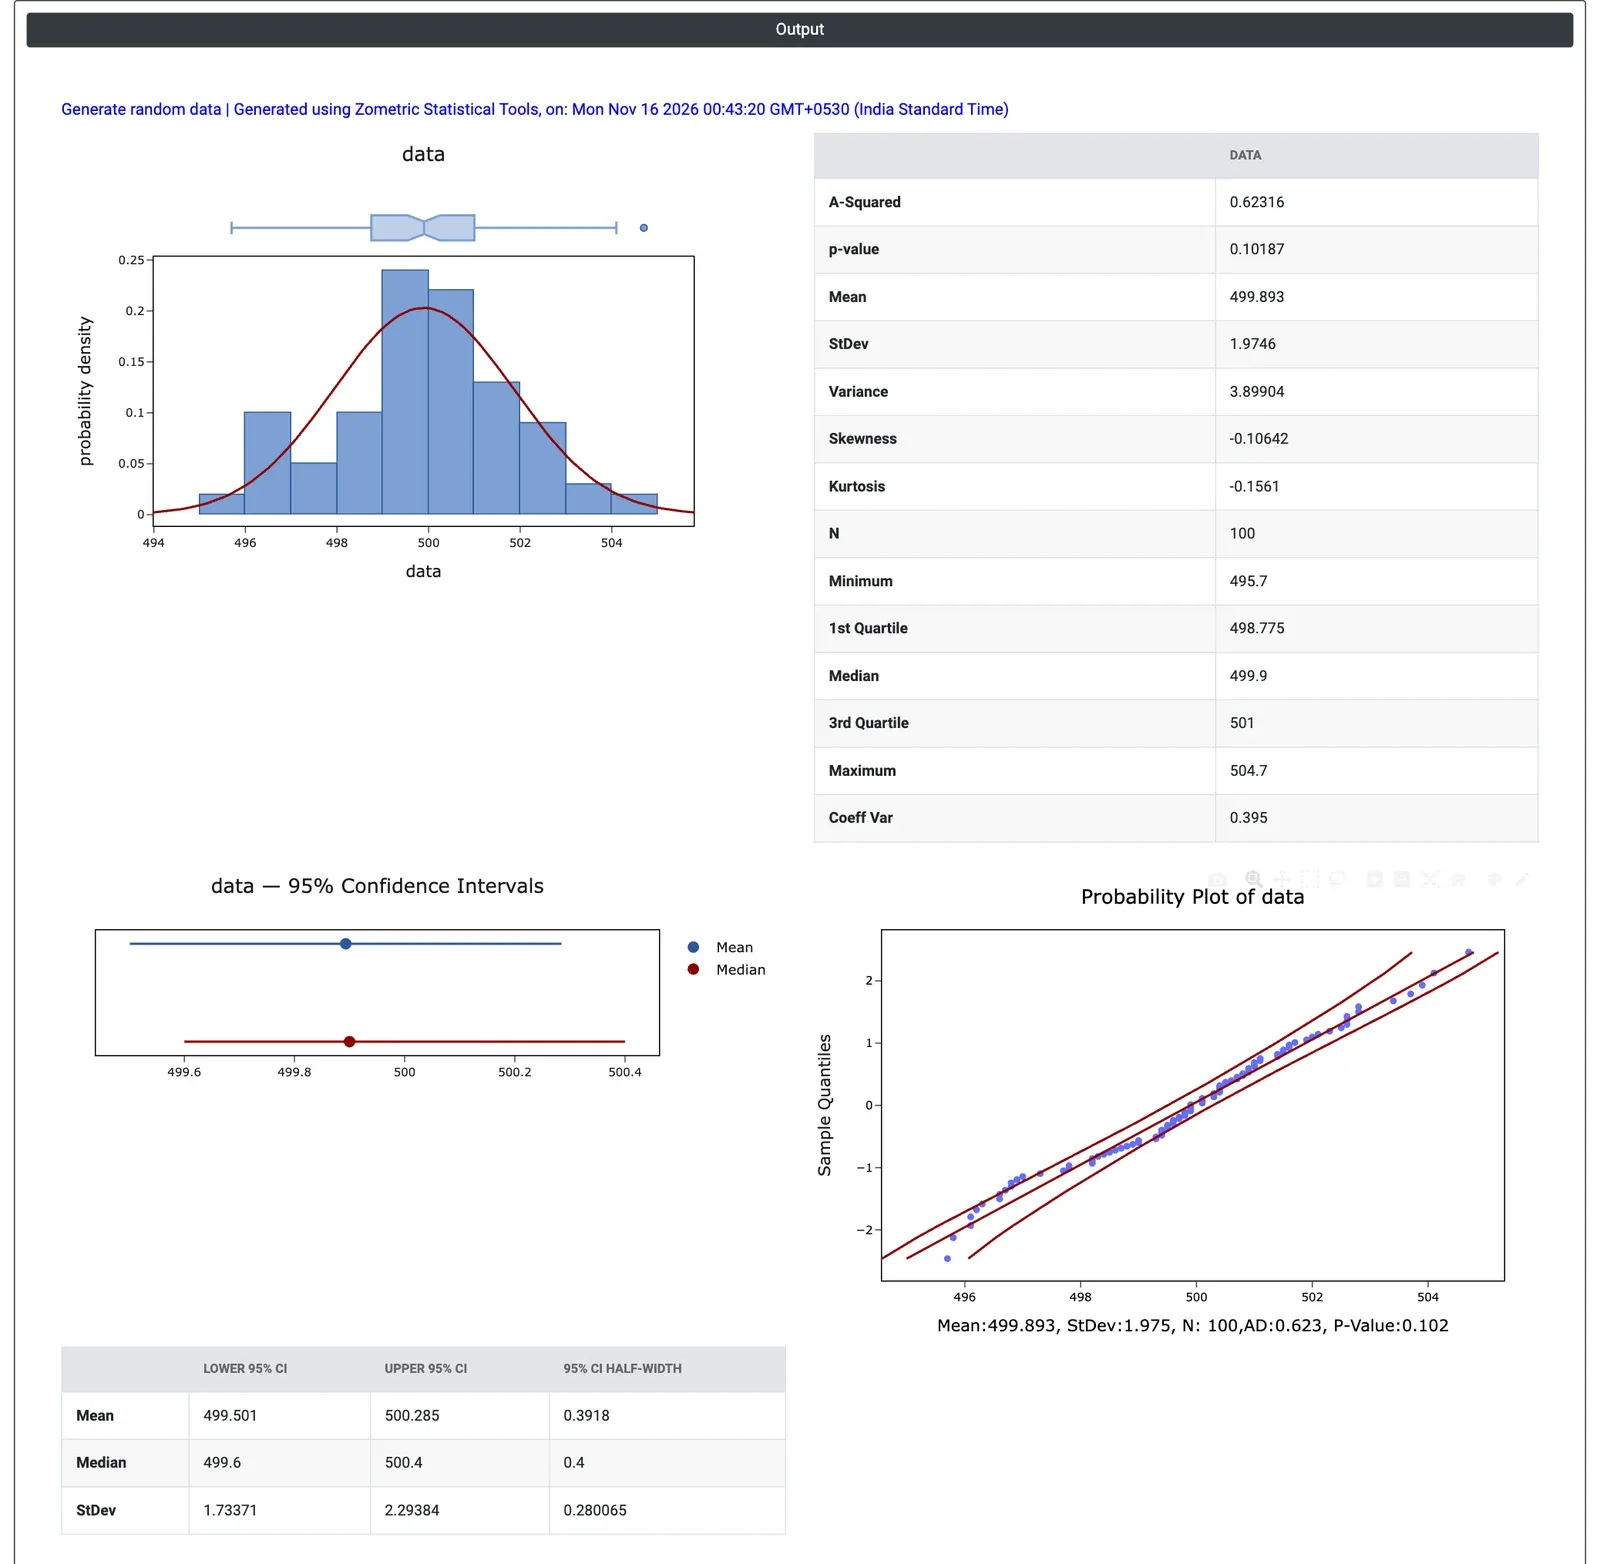
Figura 2: Resumen gráfico de los 100 valores generados: media 499.89, StDev 1.97, valor p de Anderson-Darling 0.102.
Ejemplo
Un instructor de calidad prepara una sesión sobre la variación del proceso para operadores de una línea de llenado. La línea llena botellas de 500 g con una desviación estándar de unos 2 g. Para mostrar cómo es la variación normal por sí sola, el instructor elige Distribution = Normal, Number of rows = 100, Number of columns = 1, Mean = 500, Standard Deviation = 2 y Decimals = 1, y marca Graphical Summary.
Los 100 pesos de llenado simulados van de 495.7 a 504.7 g, con media de 499.89 g y desviación estándar de 1.97 g, no exactamente 500 y 2 aunque el proceso se configuró con exactitud. El histograma es irregular, no una campana limpia, pero la prueba de Anderson-Darling da p = 0.102, por lo que no hay evidencia en contra de la normalidad. El intervalo de confianza del 95% para la media, de 499.50 a 500.29 g (semiamplitud de 0.39 g), contiene el valor verdadero de 500, y el intervalo para la desviación estándar, de 1.73 a 2.29 g, contiene el valor verdadero de 2.
La idea para los operadores: un proceso estable y centrado aun así produce botellas individuales a 4 g del objetivo y estadísticos muestrales que difieren de los valores verdaderos. Cada Calculate genera una muestra nueva con números ligeramente distintos, que el instructor puede usar para mostrar la variación entre muestras. Generar 5 columnas de 20 filas da cinco muestras pequeñas para comparar, o bien los datos pueden copiarse a una herramienta de capacidad o de gráficas de control para practicar.
Preguntas frecuentes
¿Para qué se usa la generación de datos aleatorios en el trabajo de calidad?
Se usa para crear datos de práctica para formación, para ver cuánto varían las muestras de un proceso conocido, para probar un análisis antes de que lleguen los datos reales y para simular un proceso en estudios hipotéticos, como tiempos de ciclo a partir de una estimación triangular o tiempos de fallo a partir de un modelo de Weibull. Los datos generados pueden copiarse a otras herramientas, como las de capacidad o las gráficas de control.
¿De qué distribuciones pueden generarse datos aleatorios?
Hay 26: distribuciones continuas como Normal, Lognormal, Weibull, Exponential, Gamma, Uniform y Triangular; distribuciones discretas como Binomial, Poisson, Geometric, Hypergeometric, Integer y Discrete; y Multivariate Normal, que produce columnas correlacionadas a partir de un vector de medias y una matriz de covarianzas. Solo se muestran los campos de parámetros de la distribución elegida.
¿Por qué una muestra aleatoria no coincide exactamente con la media y la desviación estándar de la población?
Cada muestra varía por azar. En un ejemplo, 100 valores de un proceso normal con media 500 y desviación estándar 2 tuvieron una media muestral de 499.89 y una desviación estándar de 1.97, y el histograma fue irregular y no con forma de campana, pero la prueba de Anderson-Darling dio p = 0.102, sin evidencia en contra de la normalidad.
¿Cómo se introducen los parámetros lognormales al generar datos aleatorios?
Para la distribución Lognormal se introducen la media y la desviación estándar de los propios datos, no de los logaritmos. La herramienta las convierte en parámetros de escala logarítmica: sigma es igual a la raíz cuadrada de ln(1 + (s/m) al cuadrado) y mu es igual a ln(m) menos sigma al cuadrado dividido entre 2.