
Datos aleatorios exponenciales
Datos aleatorios exponenciales simula tiempos de espera entre eventos independientes, como fallas de máquinas o llegadas de clientes, suponiendo una tasa de fallos constante (propiedad de falta de memoria). Usted define el número de filas y columnas, la escala, que es el tiempo medio entre eventos (1/tasa), y un umbral opcional que desplaza los valores hacia arriba. Si la tasa de fallos cambia con el tiempo, use en su lugar Datos aleatorios de Weibull.
Última revisión:
Idea clave
Datos aleatorios exponenciales genera valores estrictamente positivos de la distribución exponencial, dado su tiempo medio entre eventos, para simular tiempos entre fallas, llegadas o finalizaciones de servicio a una tasa constante.
En esta página
¿Qué son los datos aleatorios exponenciales?
Datos aleatorios exponenciales genera valores de la distribución exponencial, que modela el tiempo entre eventos independientes consecutivos, como el tiempo entre fallas de máquinas, llegadas de clientes o finalizaciones de servicio. Usted especifica la media (tiempo promedio entre eventos) y la herramienta genera duraciones aleatorias entre eventos.
Definición sencilla: Genera tiempos de espera aleatorios entre eventos, muy usados en ingeniería de fiabilidad y análisis de colas para simular cuánto falta hasta que ocurra la siguiente falla o llegada.
¿Cuándo usar datos aleatorios exponenciales?
- Úselo para simular tiempos entre fallas, llegadas o finalizaciones de servicio.
- Úselo para probar análisis de fiabilidad que suponen una tasa de fallos constante (modelo de fallas exponencial).
Pautas para el uso correcto de los datos aleatorios exponenciales
- La distribución exponencial supone una tasa de fallos constante (propiedad de falta de memoria) : si la tasa de fallos cambia con el tiempo, use en su lugar Weibull.
- Todos los valores generados son estrictamente positivos.
- Fije la media igual al tiempo promedio conocido entre eventos obtenido de datos históricos.
Alternativas: cuándo no usar datos aleatorios exponenciales
- Si la tasa de fallos cambia con el tiempo, use Datos aleatorios de Weibull
- Para mediciones continuas positivas asimétricas (no basadas en el tiempo), use Datos aleatorios lognormales
Ejemplo de datos aleatorios exponenciales
Estos son los pasos para generar datos aleatorios exponenciales:
- Para generar datos aleatorios exponenciales, es necesario completar las opciones requeridas.
- Ahora analice los datos en Zometric Statistical Software en https://statsai.zometric.com/.
- Para encontrar Random Exponential Data, elija Statistical module> Random Data > Random Exponential Data
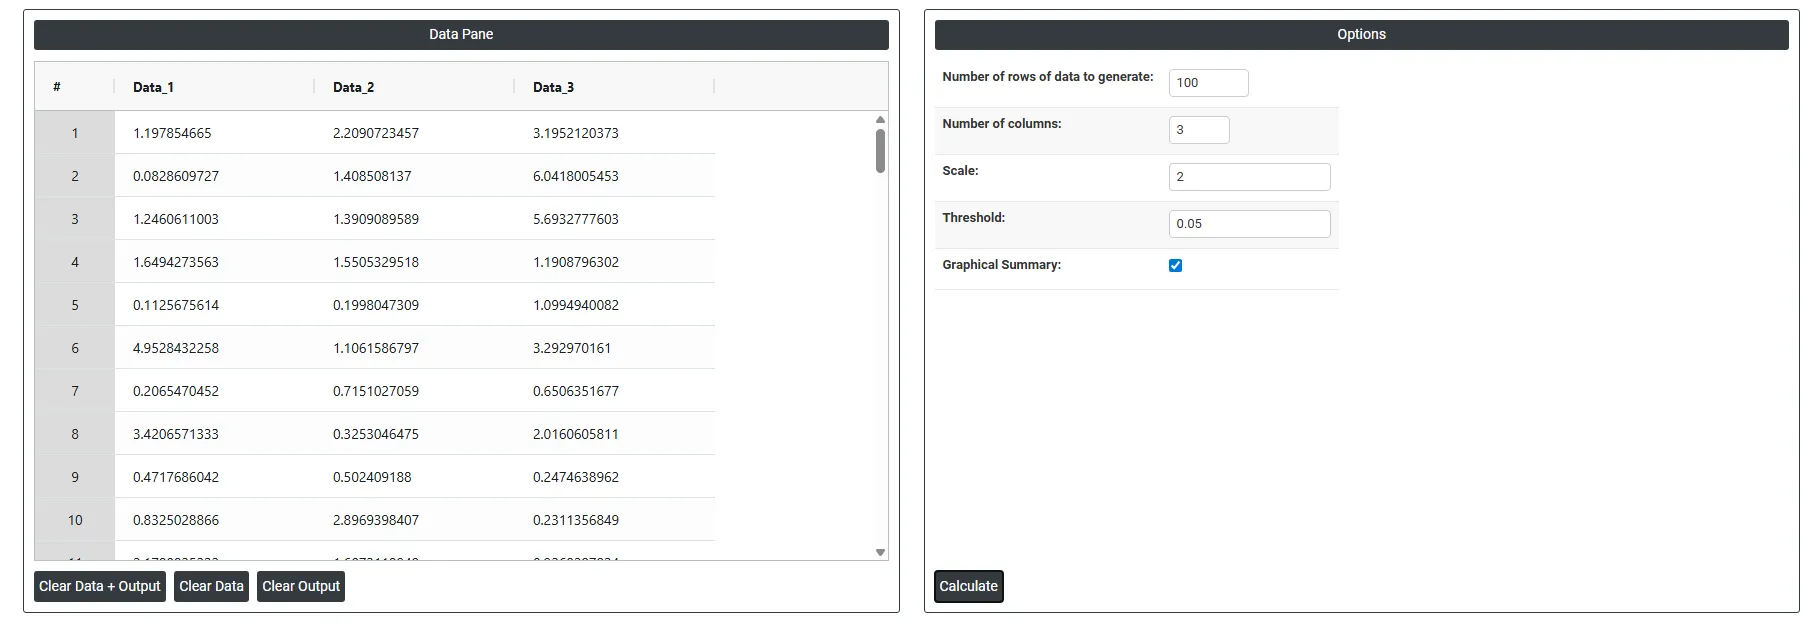
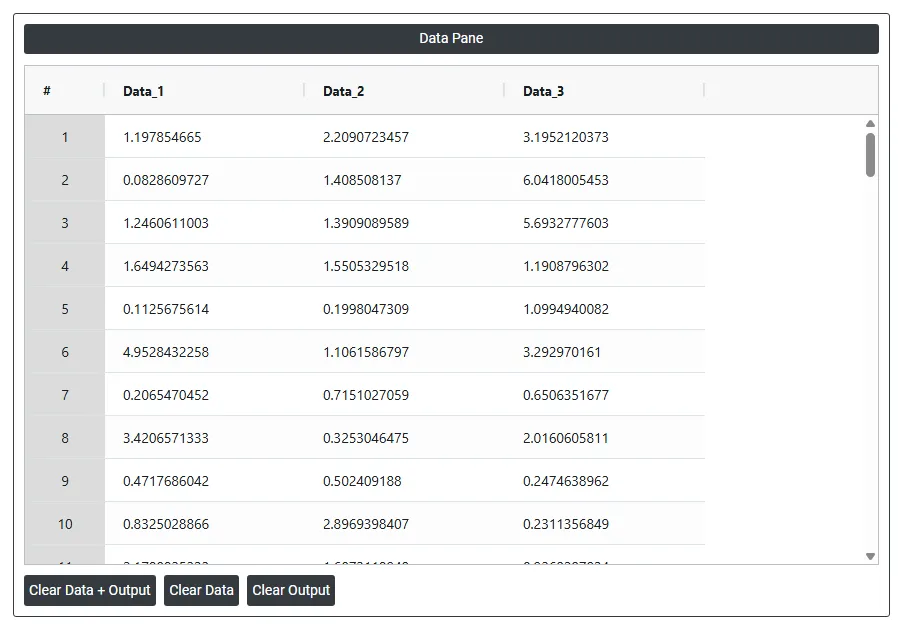
4. Después de usar la herramienta mencionada, se obtiene la salida siguiente:
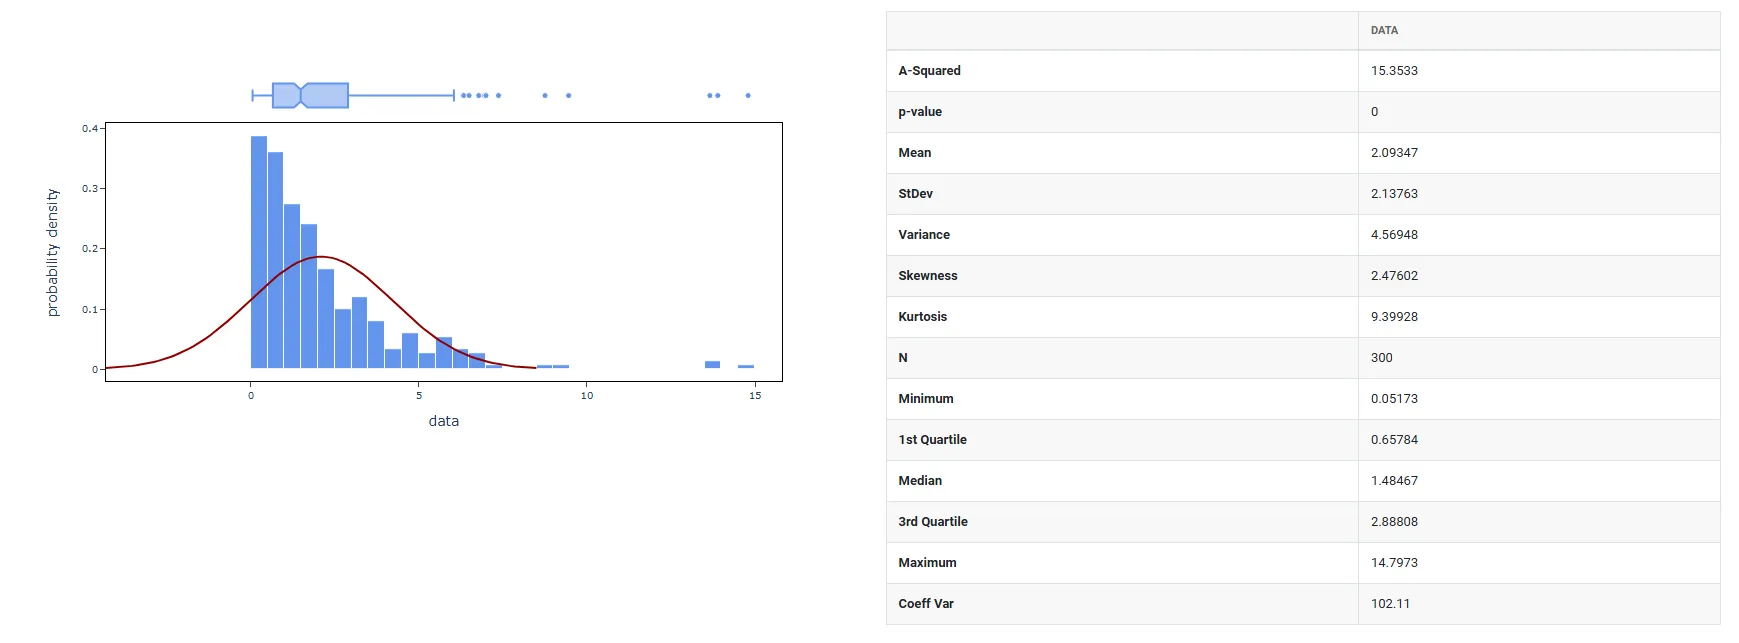
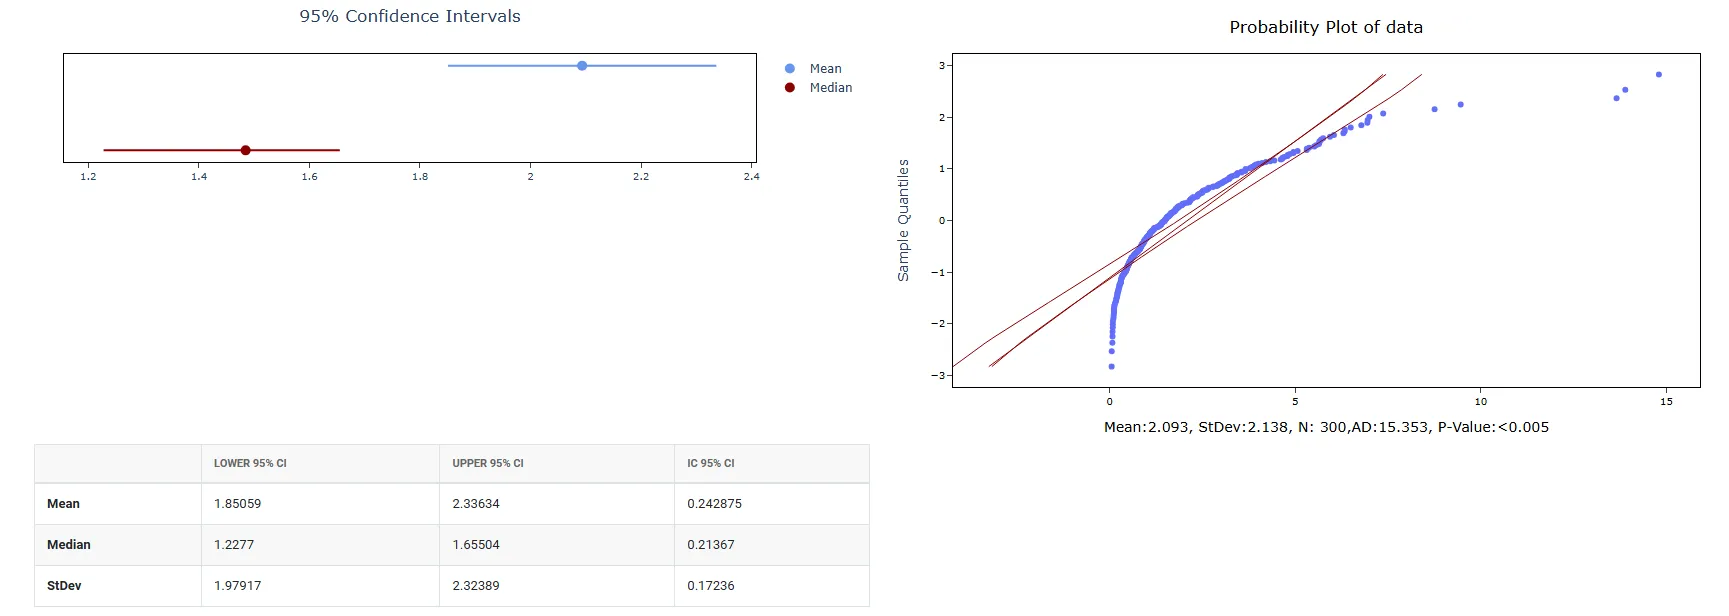
Cómo generar datos aleatorios exponenciales
La guía es la siguiente:
- Inicie sesión en Zometric Statistical Software en https://statsai.zometric.com/
- En la página de inicio, elija Statistical Tool> Random Data>Random Exponential Data.
- A continuación, complete las opciones requeridas.
- Por último, haga clic en calculate en la parte inferior de la página para obtener los resultados deseados.
En el tablero de Random Exponential Data, la ventana está dividida en dos partes.
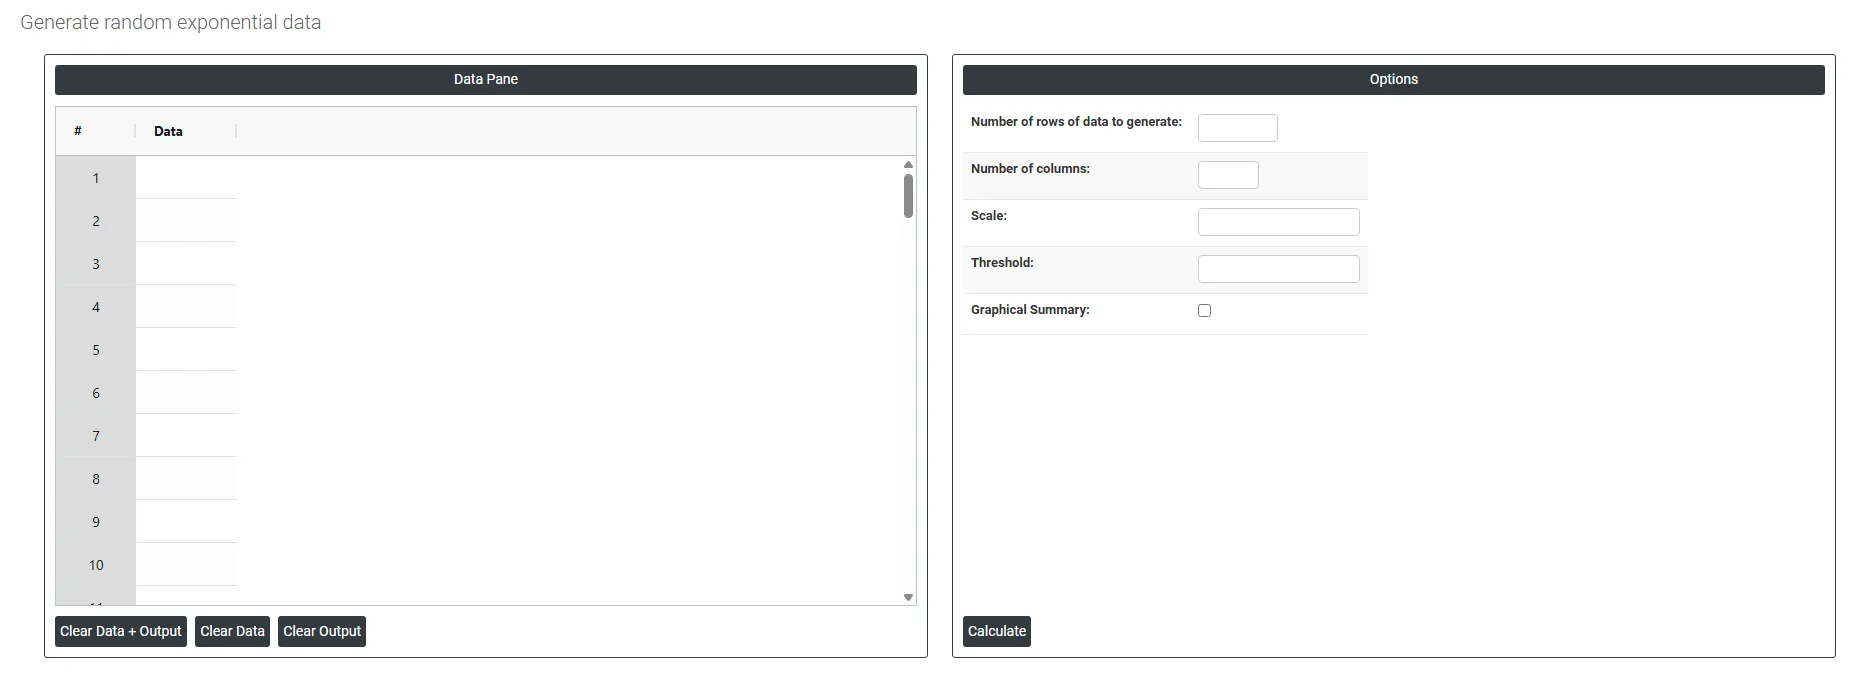
En la parte izquierda se encuentra el panel de datos (Data Pane). En el Data Pane, cada fila contiene datos aleatorios generados. Los datos se generarán después de completar las opciones requeridas.
En la parte derecha hay varias opciones, como las siguientes:
- Number of rows of data to generate: Especifica cuántos datos aleatorios se generan. Por ejemplo, al introducir 10 se producirán exactamente 10 filas de valores aleatorios, todas visibles en el panel de datos.
- Number of columns: Especifica cuántas variables (columnas) tendrá cada fila. Por ejemplo, al introducir 3 se producirán 3 columnas de datos generados aleatoriamente, una junto a otra, en el panel de datos.
- Scale: la media de la distribución exponencial, es decir, el tiempo promedio entre eventos (igual a 1/tasa). Un valor de escala mayor produce números más grandes y más dispersos; un valor de escala menor produce valores que se agrupan más cerca de cero. Todos los datos generados en el panel de datos reflejarán esta dispersión.
- Threshold: Establece un punto de partida mínimo para los datos generados. En lugar de comenzar desde cero, los números generados se desplazarán hacia arriba en esta cantidad. Por ejemplo, un umbral de 10 significa que todos los valores generados partirán de 10 hacia arriba, en lugar de partir de 0.
- Graphical summary: cuando se selecciona, todos los valores generados se combinan y se resumen: un histograma con una curva normal ajustada y una gráfica de caja, estadísticos descriptivos, una prueba de normalidad de Anderson-Darling, una gráfica de probabilidad e intervalos de confianza del 95% para la media, la mediana y la desviación estándar. Es un resultado visual basado en los datos que se acaban de crear.
Preguntas frecuentes
¿Qué simulan los datos aleatorios exponenciales?
Los datos aleatorios exponenciales simulan el tiempo entre eventos independientes consecutivos, como el tiempo entre fallas de máquinas, llegadas de clientes o finalizaciones de servicio. Se usan ampliamente en ingeniería de fiabilidad y análisis de colas para modelar cuánto falta hasta la siguiente falla o llegada, y para probar análisis de fiabilidad que suponen una tasa de fallos constante.
¿Cuándo conviene usar Weibull en lugar de la distribución exponencial?
La distribución exponencial supone una tasa de fallos constante, la propiedad de falta de memoria. Si la tasa de fallos cambia con el tiempo, ya sea creciente o decreciente, use en su lugar Datos aleatorios de Weibull. Para mediciones positivas asimétricas que no están basadas en el tiempo, Datos aleatorios lognormales es la mejor opción.
¿Qué hacen los ajustes de escala y umbral en los datos aleatorios exponenciales?
La escala es la media de la distribución exponencial, el tiempo promedio entre eventos, igual a 1/tasa. Una escala mayor da números más grandes y más dispersos, y una menor da valores agrupados más cerca de cero; fíjela a partir del tiempo promedio conocido entre eventos en los datos históricos. El umbral desplaza todos los valores hacia arriba, de modo que un umbral de 10 significa que los valores parten de 10 en lugar de 0.