
Datos F aleatorios
Random F Data simula estadísticos F como los de las comparaciones de varianzas, el ANOVA y la regresión. Usted define el número de filas y columnas, los grados de libertad del numerador y del denominador y el número de decimales. Ambos grados de libertad determinan la forma de la distribución; al aumentar, esta se vuelve menos asimétrica y más concentrada en torno a 1. Los valores siempre son no negativos. Úselo para validación, simulaciones de potencia y enseñanza.
Última revisión:
Idea clave
Random F Data genera valores de la distribución F, asimétrica a la derecha y no negativa, definida por los grados de libertad del numerador y del denominador, para validar comparaciones de varianzas, ANOVA y pruebas F de regresión.
En esta página
¿Qué son los datos F aleatorios?
Random F Data genera valores de la distribución F, una distribución asimétrica a la derecha y siempre positiva, definida por dos parámetros de grados de libertad (gl del numerador y gl del denominador). La distribución F surge de forma natural al comparar dos varianzas o al evaluar los estadísticos F del ANOVA y de la regresión.
Definición sencilla: Genera valores aleatorios de la distribución F que se usan para validar comparaciones de varianzas, salidas de ANOVA y estadísticos F de regresión.
¿Cuándo usar los datos F aleatorios?
- Úselos para validar análisis de ANOVA y de regresión con propiedades conocidas de la distribución F.
- Úselos en simulaciones de análisis de potencia para estimar el tamaño de muestra de estudios de comparación de varianzas.
- Úselos en demostraciones didácticas de cómo cambian las distribuciones F con distintos grados de libertad.
Pautas para el uso correcto de los datos F aleatorios
- Especifique correctamente los grados de libertad del numerador y del denominador : cambian de forma significativa la forma de la distribución.
- Los valores F siempre son no negativos.
Alternativas: cuándo no usar los datos F aleatorios
- Para simulaciones de pruebas t con distribución normal, use datos normales aleatorios
- Para simulaciones del estadístico t, use datos t aleatorios
Ejemplo de datos F aleatorios
Los pasos para generar datos F aleatorios son los siguientes:
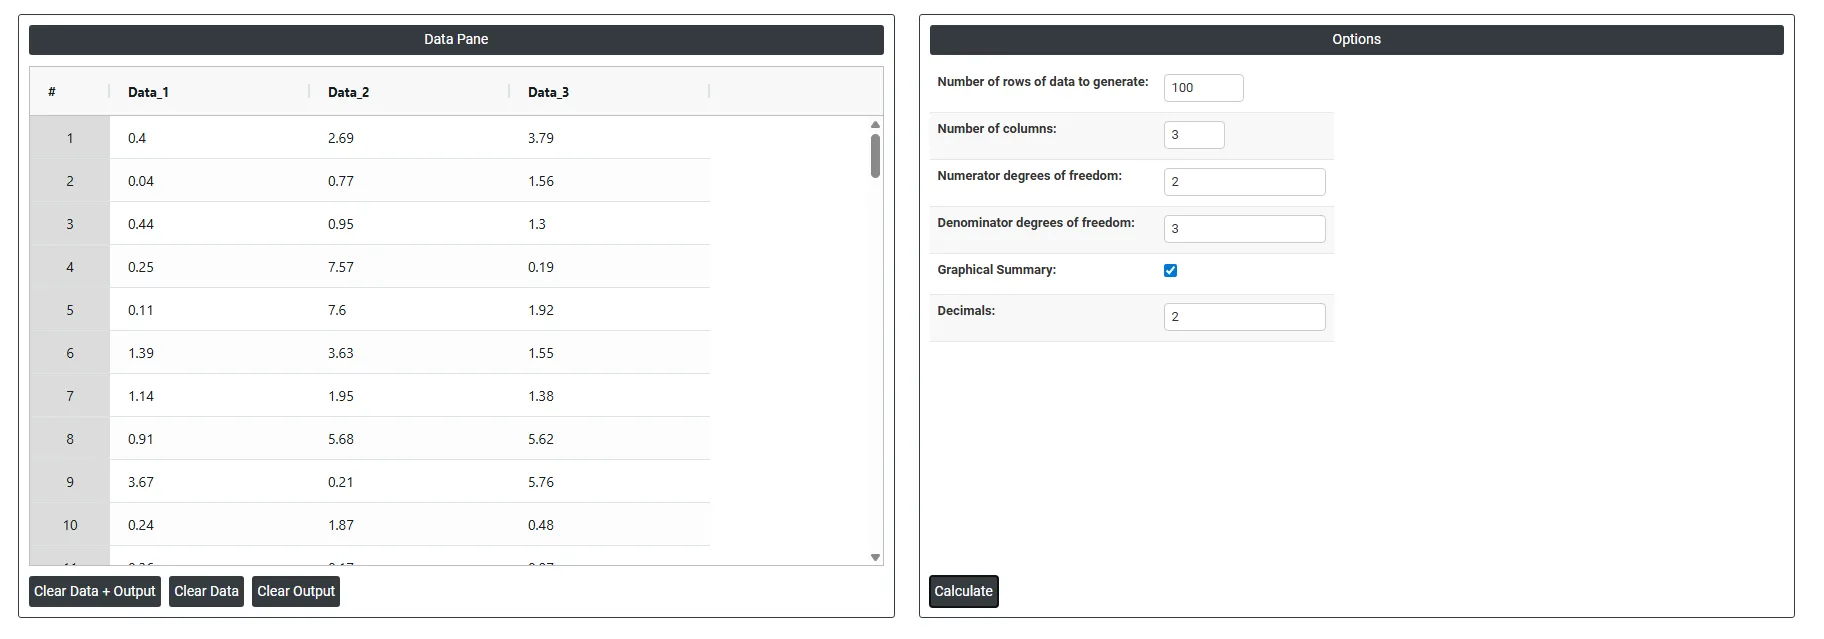
- Para generar datos F aleatorios, es necesario rellenar las opciones obligatorias.
- Ahora analice los datos en Zometric Statistical Software en https://statsai.zometric.com/.
- Para encontrar Random F data, elija Statistical module> Random Data > Random F data
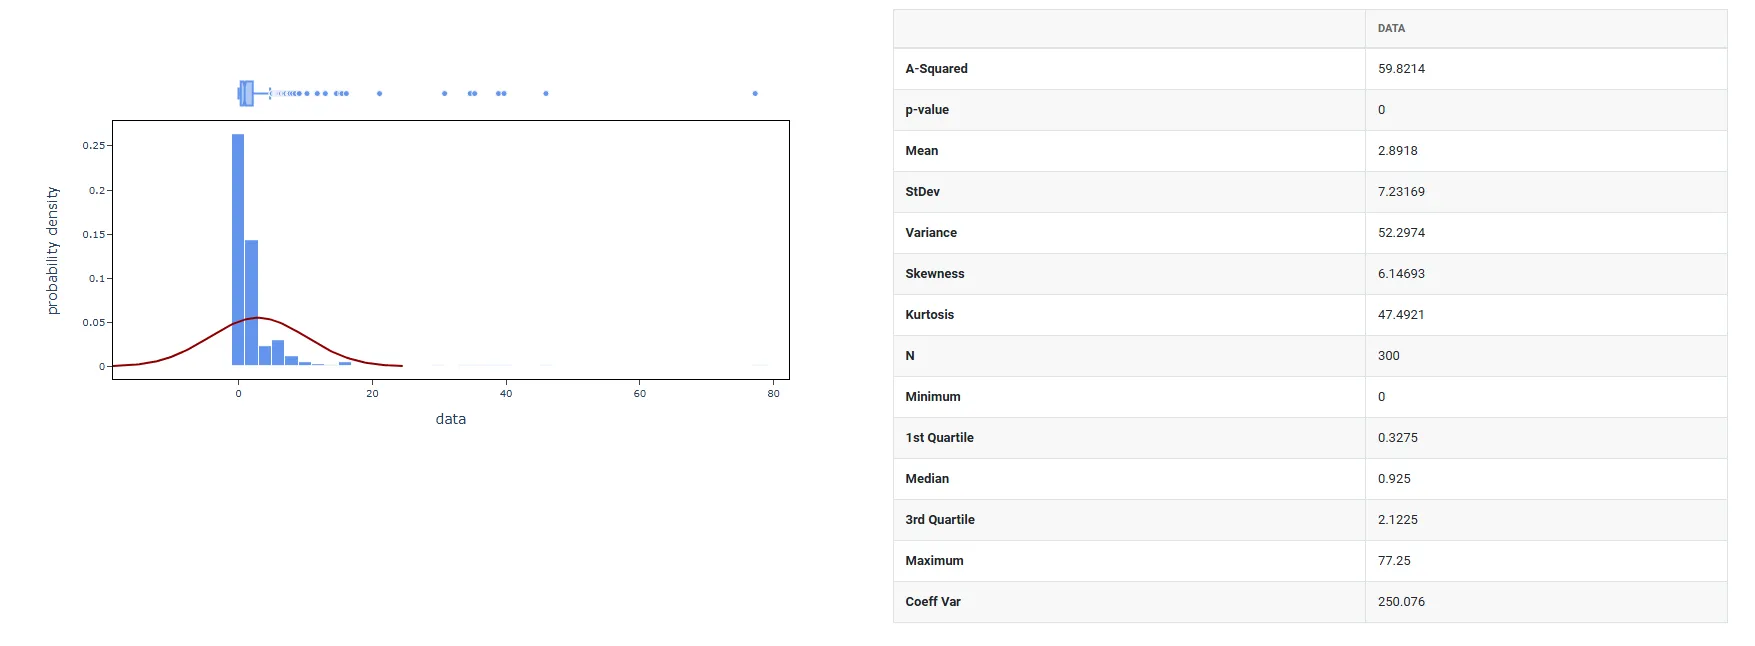
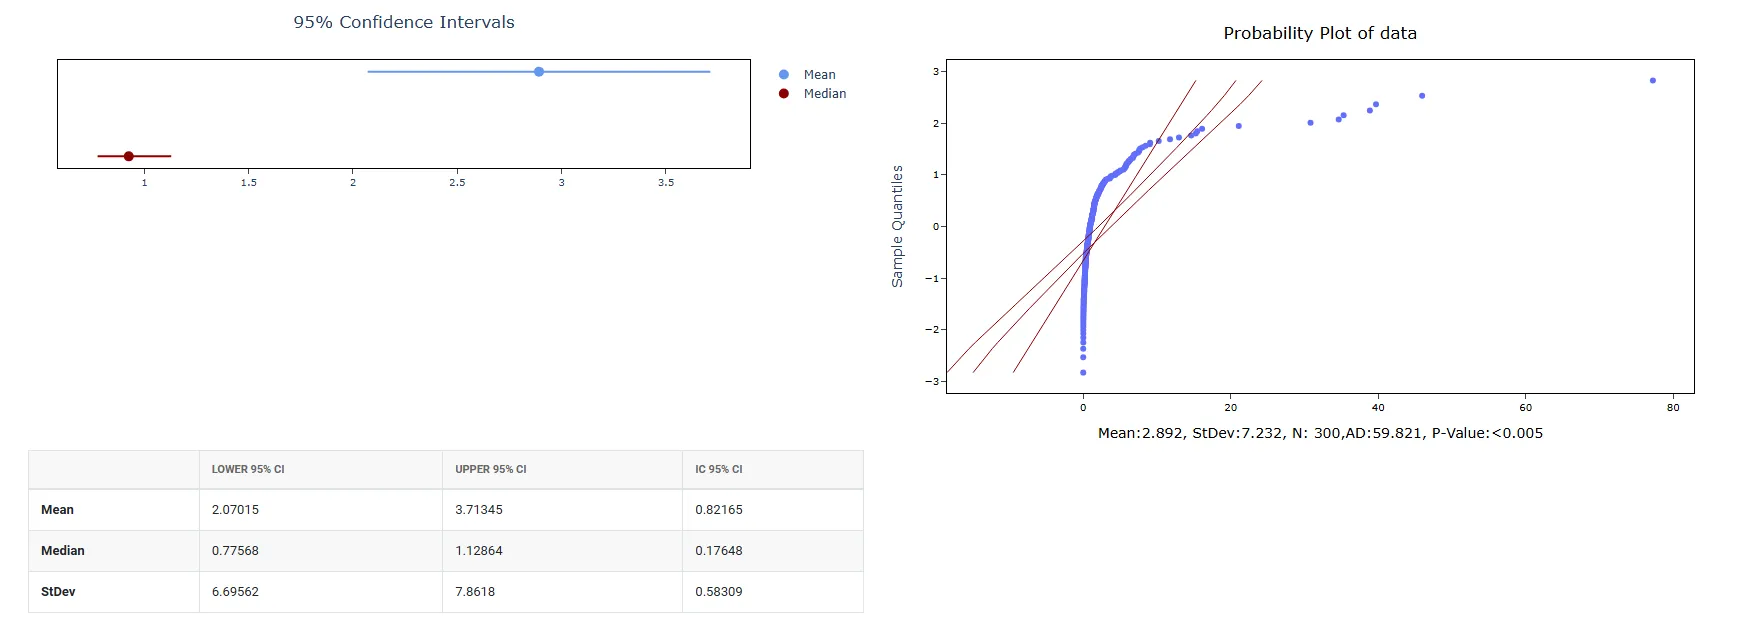
4. Después de usar la herramienta mencionada, se obtiene la siguiente salida:
Cómo generar datos F aleatorios
La guía es la siguiente:
- Inicie sesión en Zometric Statistical Software en https://statsai.zometric.com/
- En la página de inicio, elija Statistical Tool> Random Data>Random F data.
- A continuación, debe rellenar las opciones obligatorias.
- Por último, haga clic en calculate en la parte inferior de la página para obtener los resultados deseados.
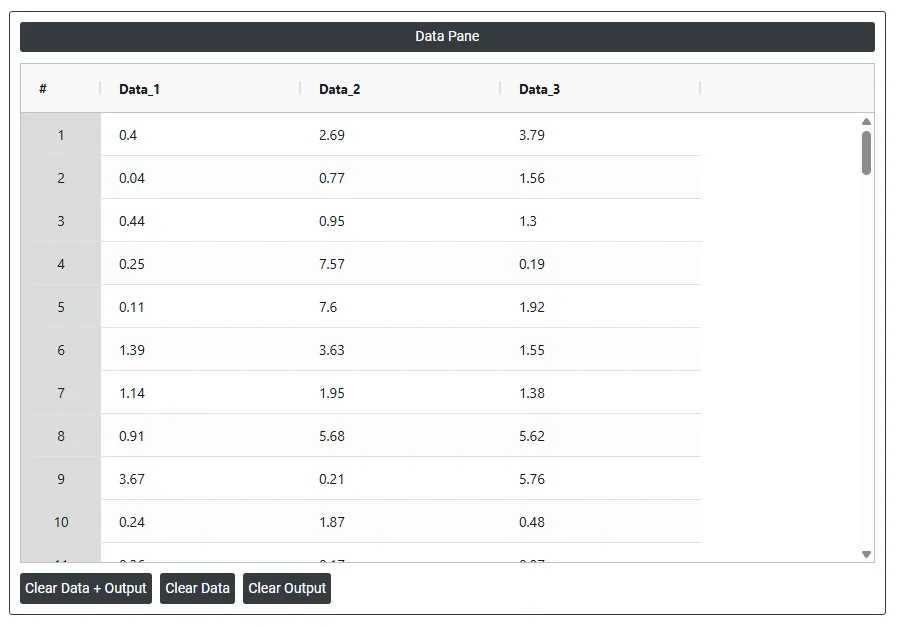
En el tablero de Random F data, la ventana está dividida en dos partes.
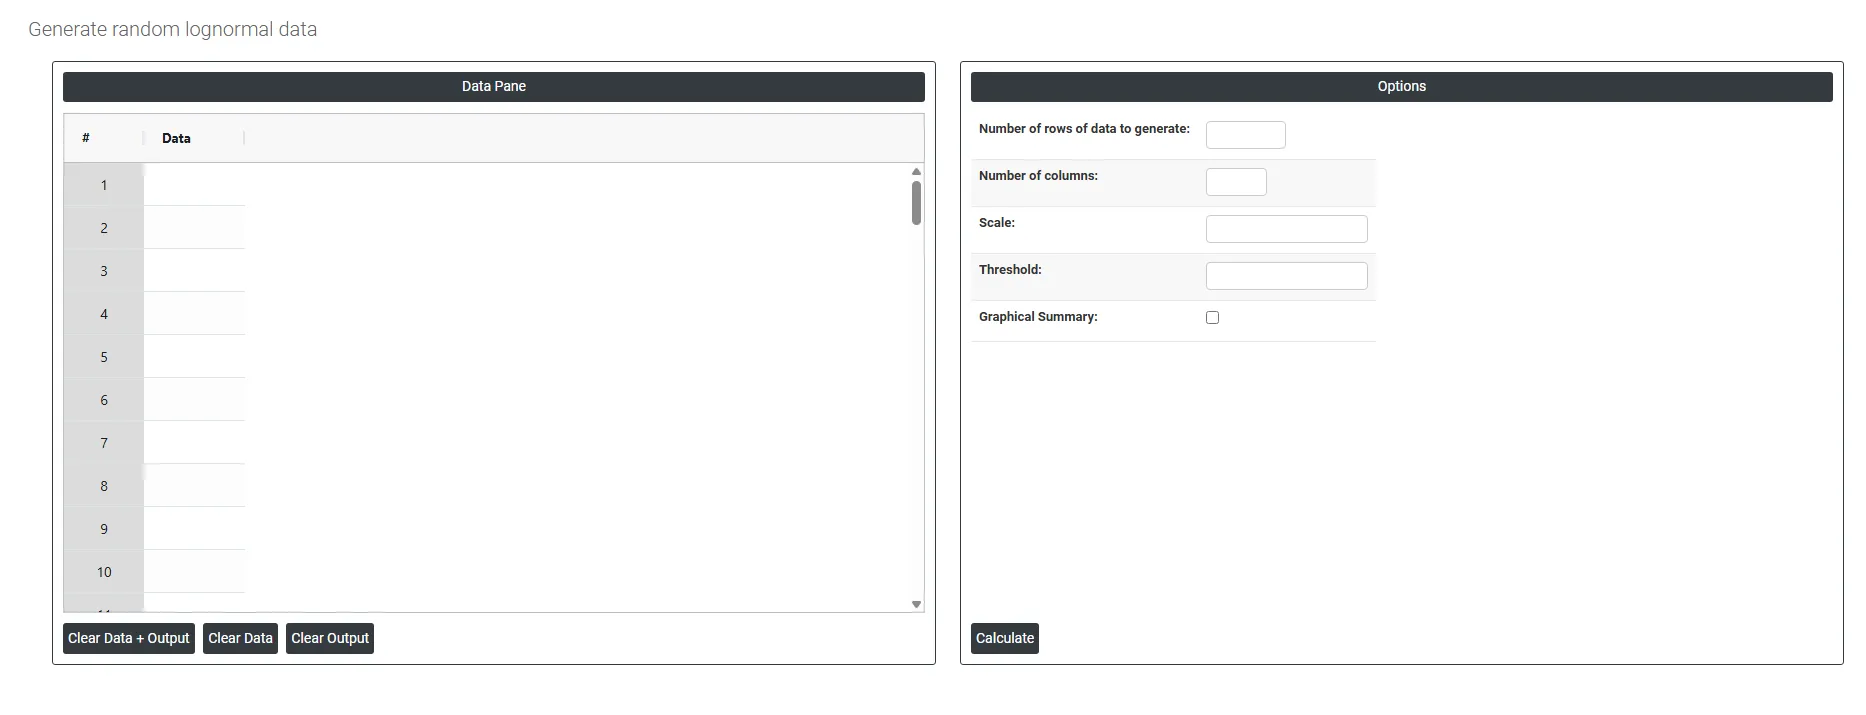
En la parte izquierda se encuentra el panel de datos (Data Pane). En el Data Pane, cada fila contiene datos aleatorios generados. Los datos se generarán después de rellenar las opciones obligatorias.
En la parte derecha se encuentran las siguientes opciones:
- Number of rows of data to generate: Especifica cuántos datos aleatorios se generan. Por ejemplo, si introduce 10, se producirán exactamente 10 filas de valores aleatorios, todas visibles en el Data Pane.
- Number of columns: Especifica cuántas variables (columnas) tendrá cada fila. Por ejemplo, si introduce 3, se producirán 3 columnas de datos generados aleatoriamente, una al lado de otra, en el Data Pane.
- Numerator degrees of freedom: El primer parámetro de forma de la distribución F, correspondiente a los grados de libertad de la varianza del numerador. Controla la forma general de la distribución generada. Por ejemplo, si introduce 2, se generarán valores F aleatorios basados en un numerador con 2 grados de libertad.
- Denominator degrees of freedom: el segundo parámetro de forma de la distribución F, correspondiente a los grados de libertad de la varianza del denominador. Junto con los grados de libertad del numerador, define por completo la forma de la distribución F de la que se generan los datos aleatorios. A medida que ambos grados de libertad aumentan, la distribución se vuelve menos asimétrica y más concentrada en torno a 1.
- Graphical summary: cuando se selecciona, todos los valores generados se agrupan y se resumen: un histograma con una curva normal ajustada y una gráfica de caja, estadísticos descriptivos, una prueba de normalidad de Anderson-Darling, una gráfica de probabilidad e intervalos de confianza del 95% para la media, la mediana y la desviación estándar. Es un resultado visual basado en los datos que se acaban de crear.
- Decimals: Controla el número de decimales de los propios valores aleatorios generados. Por ejemplo, si lo define en 2, todos los números generados se redondearán a 2 decimales, como 47.83 o 52.16. Si lo define en 0, solo se producen números enteros.
Preguntas frecuentes
¿Para qué se usa la distribución F?
La distribución F es una distribución asimétrica a la derecha y siempre no negativa, definida por los grados de libertad del numerador y del denominador. Surge al comparar dos varianzas y al evaluar los estadísticos F del ANOVA y de la regresión. Los datos F aleatorios se usan para validar esos análisis, en simulaciones de análisis de potencia para estudios de comparación de varianzas y para enseñar cómo cambia la distribución con los grados de libertad.
¿Cómo cambian los grados de libertad la distribución F?
Tanto los grados de libertad del numerador como los del denominador cambian de forma significativa la forma de la distribución F, por lo que deben especificarse correctamente. Los grados de libertad del numerador corresponden a la varianza del numerador y los del denominador a la varianza del denominador. A medida que ambos aumentan, la distribución se vuelve menos asimétrica y más concentrada en torno a 1.
¿Cómo se generan datos F aleatorios en Zometric Statistical Software?
Elija Statistical Tool > Random Data > Random F data y luego introduzca el número de filas y columnas que desea generar, los grados de libertad del numerador y del denominador y, opcionalmente, el número de decimales y un resumen gráfico. Haga clic en calculate y los valores generados aparecerán en el Data Pane, listos para usarse en otras herramientas.