
Datos aleatorios t (Random T Data)
Random T Data simula valores de la distribución t para validar pruebas t e intervalos de confianza, para análisis de potencia y para enseñanza. Usted define el número de filas y de columnas, los grados de libertad, normalmente n - 1, y el número de decimales. Pocos grados de libertad dan colas más pesadas y valores más extremos; por encima de 30, la distribución t es casi idéntica a la normal. Hay un resumen gráfico opcional.
Última revisión:
Idea clave
Random T Data genera valores de la distribución t, una distribución simétrica con forma de campana y colas más pesadas que la normal, definida por sus grados de libertad, para simular estadísticos t y estudios con muestras pequeñas.
En esta página
¿Qué es Random T Data?
Random T Data genera valores de la distribución t, una distribución simétrica con forma de campana, similar a la distribución normal pero con colas más pesadas, controlada por un parámetro de grados de libertad. A medida que aumentan los grados de libertad, la distribución t converge a la normal estándar. Se usa ampliamente para simular estadísticos de pruebas t y modelar la incertidumbre en estudios con muestras pequeñas.
Definición sencilla:Genera valores aleatorios de la distribución t, una curva de campana con colas más pesadas que la normal, ideal para simulaciones con muestras pequeñas y para validar pruebas t.
¿Cuándo usar Random T Data?
- Úselo para validar pruebas t y cálculos de intervalos de confianza con propiedades de distribución conocidas.
- Úselo para simulaciones de análisis de potencia que determinen tamaños de muestra adecuados para estudios con pruebas t.
- Úselo en demostraciones educativas de cómo la distribución t se aproxima a la normalidad a medida que crece el tamaño de muestra.
Pautas para el uso correcto de Random T Data
- Defina los grados de libertad según el tamaño de muestra de su estudio (normalmente n − 1).
- Con muchos grados de libertad (> 30), la distribución t es casi idéntica a la distribución normal.
Alternativas: cuándo no usar Random T Data
- Para simulaciones con muestras grandes en las que la normalidad es adecuada, use Random Normal Data
- Para simulaciones de comparación de varianzas, use Random F Data
Ejemplo de Random T Data
Los pasos para generar Random T Data son los siguientes:
- Para generar Random T Data, debe completar las opciones necesarias.
- Ahora se analizan los datos en Zometric Statistical Software en https://statsai.zometric.com/.
- Para encontrar Random T Data, elija Statistical module> Random Data > Random T Data
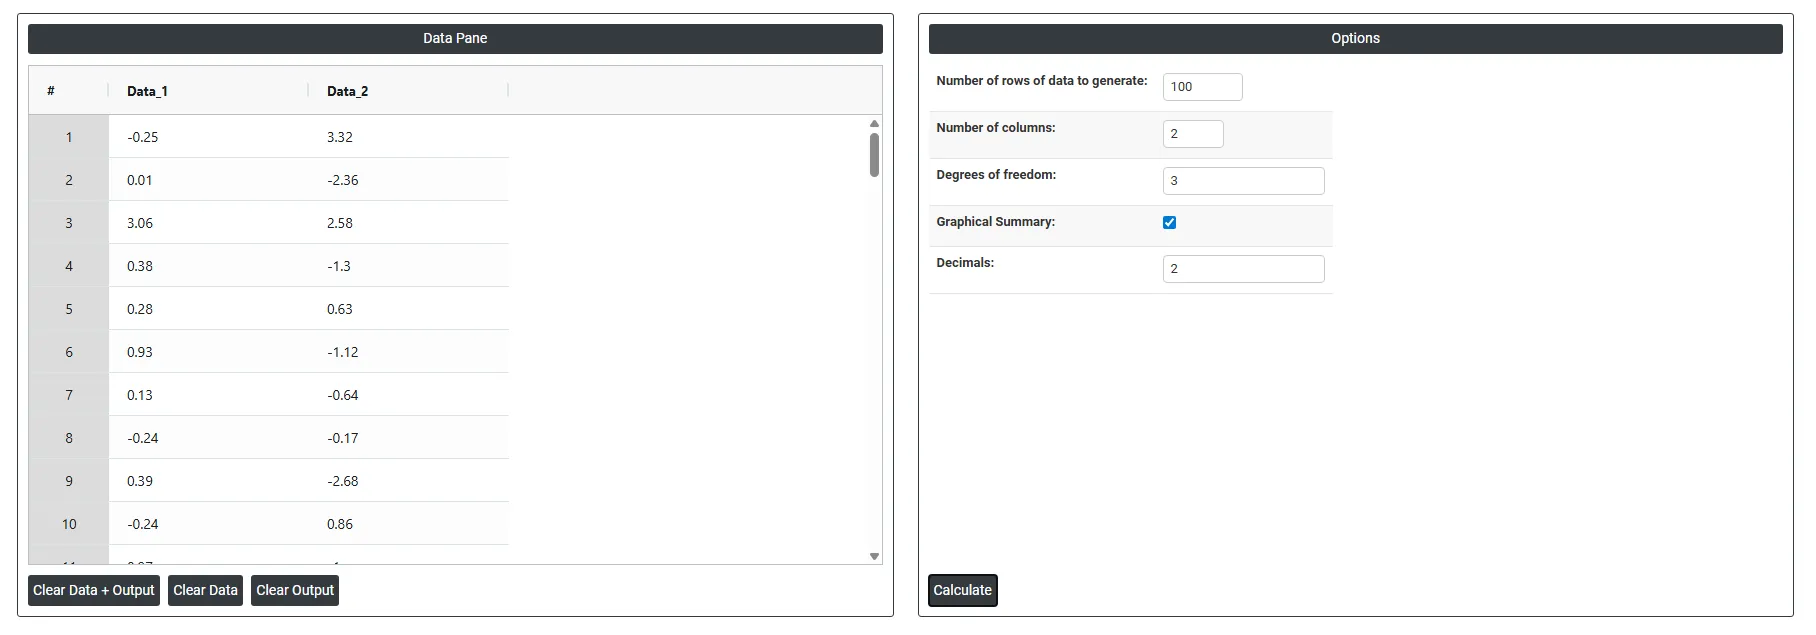
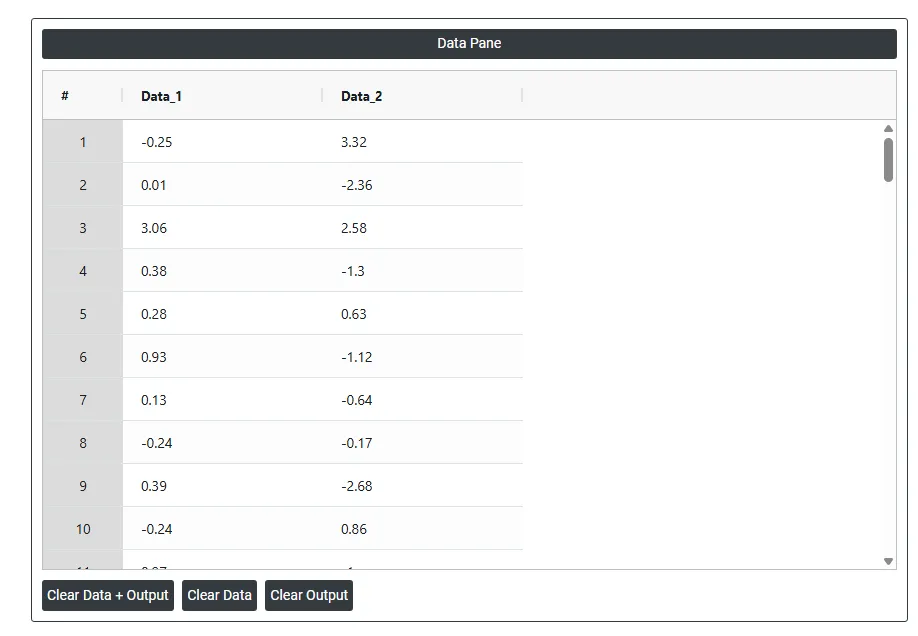
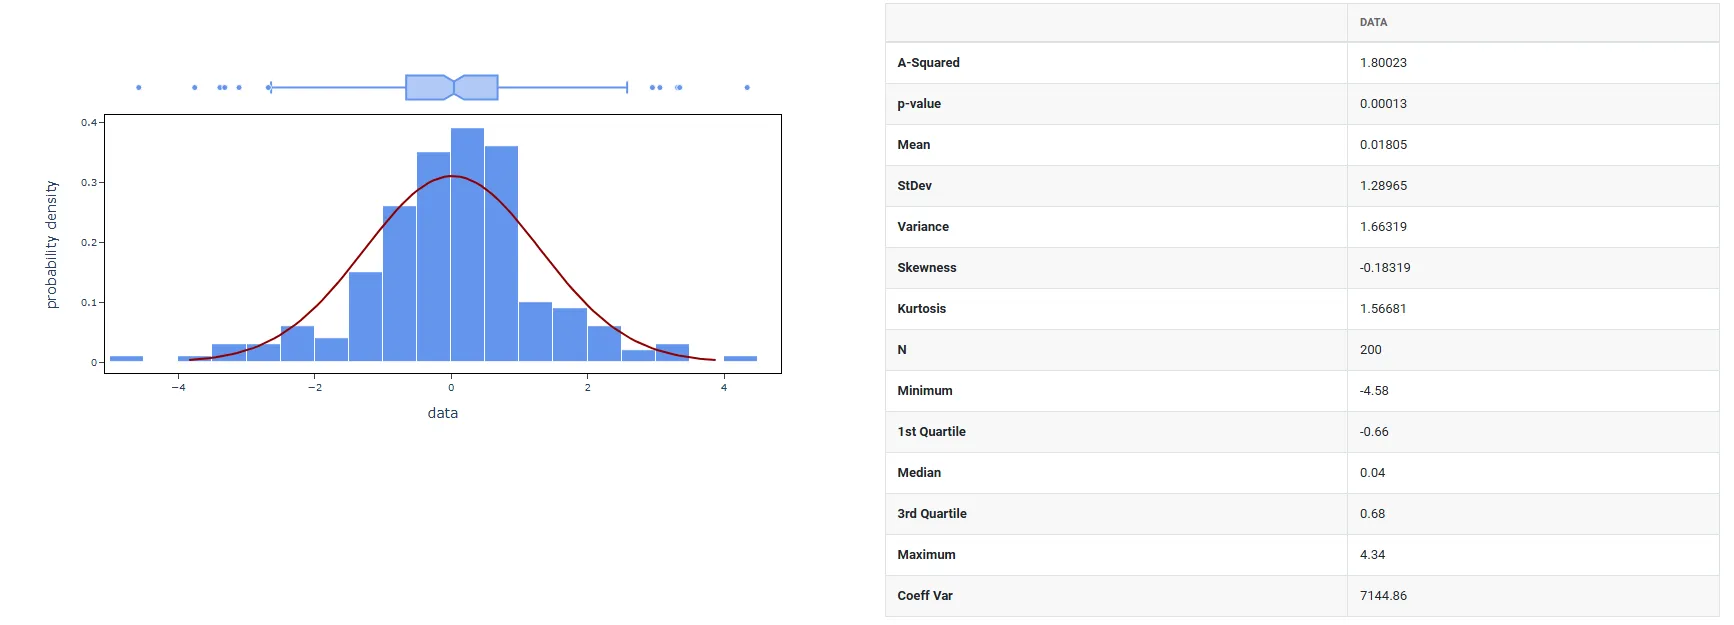
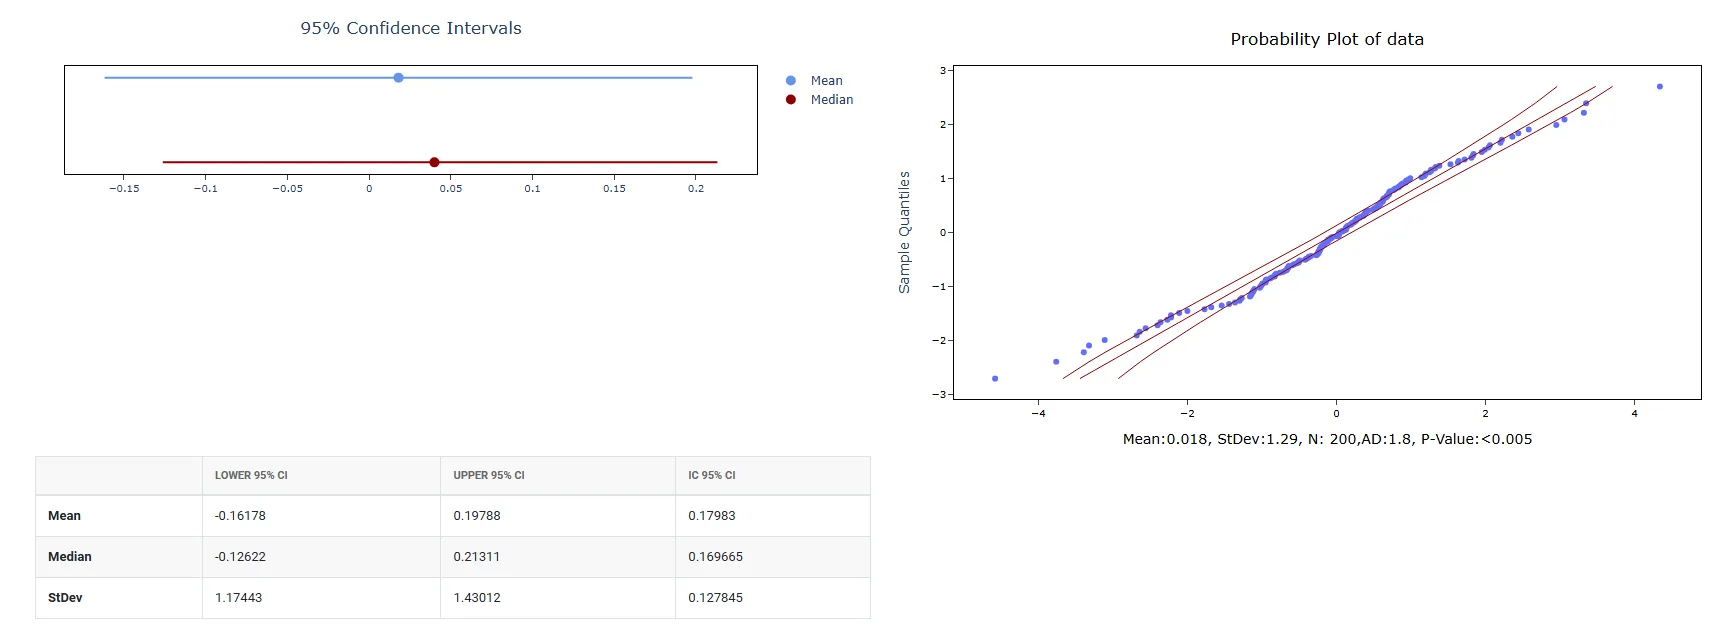
4. Tras usar la herramienta indicada, se obtiene la siguiente salida:
Cómo usar Random T Data
La guía es la siguiente:
- Inicie sesión en Zometric Statistical Software en https://statsai.zometric.com/
- En la página de inicio, elija Statistical Tool> Random Data>Random T Data.
- A continuación, debe completar las opciones necesarias.
- Por último, haga clic en calculate en la parte inferior de la página para obtener los resultados deseados.
En el tablero de Random T Data, la ventana está dividida en dos partes.
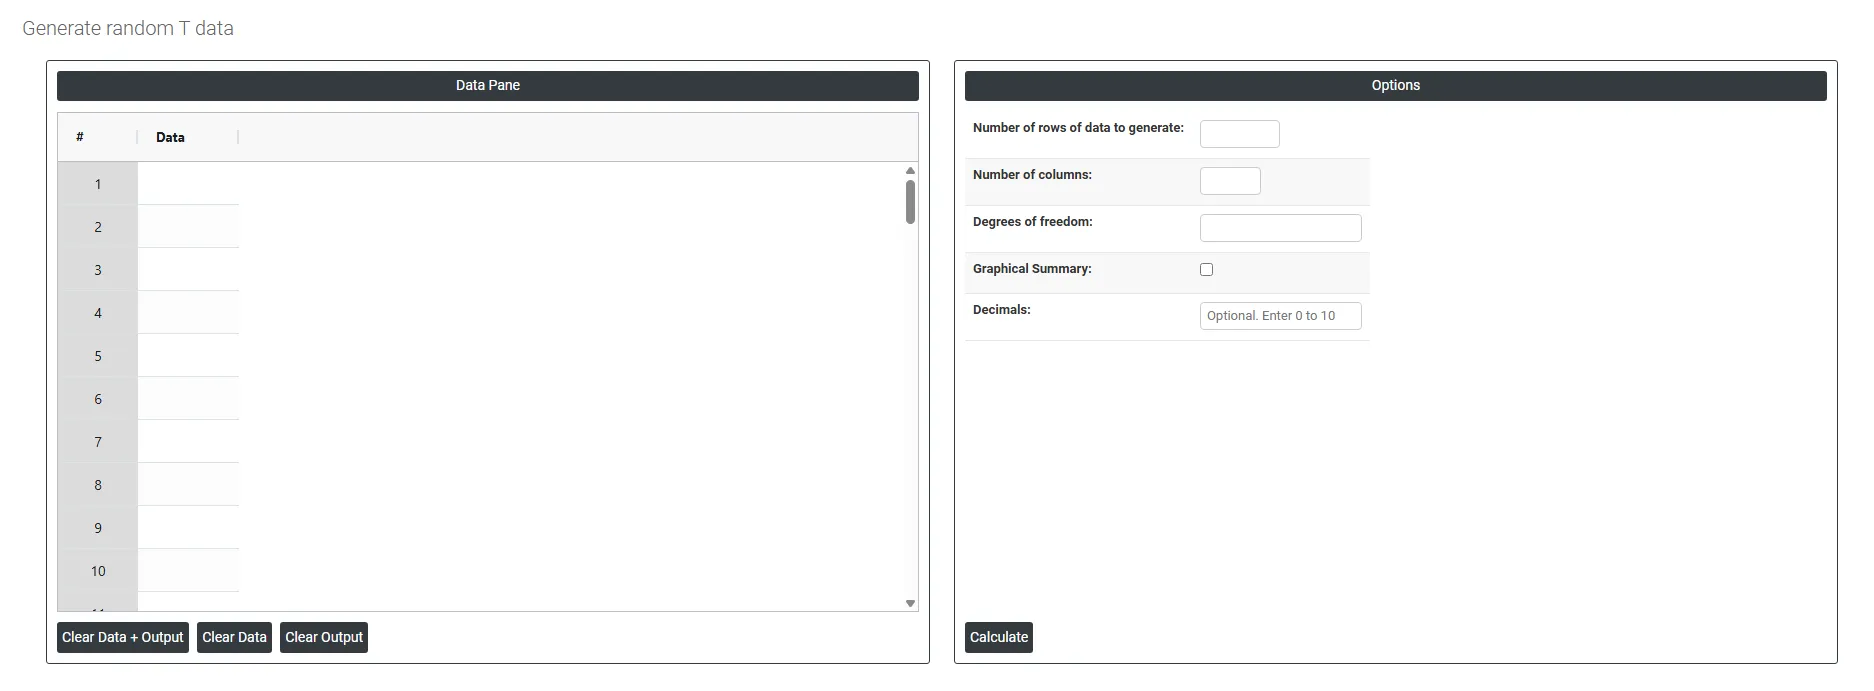
En la parte izquierda se encuentra el panel de datos (Data Pane). En el Data Pane, cada fila contiene datos aleatorios generados. Los datos se generarán después de completar las opciones necesarias.
En la parte derecha hay numerosas opciones, como las siguientes:
- Number of rows of data to generate: Especifica cuántos puntos de datos aleatorios se generan. Por ejemplo, si introduce 10, se producirán exactamente 10 filas de valores aleatorios, todas visibles en el panel de datos.
- Number of columns: Especifica cuántas variables (columnas) tendrá cada fila. Por ejemplo, si introduce 3, se producirán 3 columnas de datos generados aleatoriamente, una junto a otra, en el panel de datos.
- Degrees of freedom: Determina la forma de la distribución t usada para generar los datos aleatorios. Con pocos grados de libertad (como 1 o 2), la distribución tiene colas más pesadas, lo que significa que aparecerán más valores extremos en los datos generados. A medida que aumentan los grados de libertad, la distribución t se aproxima gradualmente a la forma de una distribución normal. Por ejemplo, si introduce 30, se generarán datos aleatorios de una distribución t con 30 grados de libertad, que producen valores muy parecidos a los de datos con distribución normal.
- Graphical summary: Cuando se selecciona, todos los valores generados se combinan y se resumen: un histograma con una curva normal ajustada y una gráfica de caja, estadísticos de resumen, una prueba de normalidad de Anderson-Darling, una gráfica de probabilidad e intervalos de confianza del 95% para la media, la mediana y la desviación estándar. Es un resultado visual basado en los datos que se acaban de crear.
- Decimals: Controla el número de decimales de los propios valores aleatorios generados. Por ejemplo, si lo establece en 2, cada número generado se redondeará a 2 decimales, como 47.83 o 52.16. Si lo establece en 0, se producen solo números enteros.
Preguntas frecuentes
¿Qué es la distribución t?
La distribución t es una distribución simétrica con forma de campana, similar a la normal pero con colas más pesadas, controlada por un parámetro de grados de libertad. A medida que aumentan los grados de libertad, converge a la distribución normal estándar. Se usa ampliamente para simular estadísticos de pruebas t y modelar la incertidumbre en estudios con muestras pequeñas.
¿Qué grados de libertad se deben usar para datos aleatorios t?
Defina los grados de libertad según el tamaño de muestra de su estudio, normalmente n - 1. Valores bajos, como 1 o 2, dan colas más pesadas y valores más extremos. Con muchos grados de libertad, por encima de 30, la distribución t es casi idéntica a la normal, por lo que para simulaciones con muestras grandes puede usarse en su lugar Random Normal Data.
¿Cuándo conviene generar datos aleatorios t?
Úselos para validar pruebas t y cálculos de intervalos de confianza con propiedades de distribución conocidas, en simulaciones de análisis de potencia para hallar tamaños de muestra adecuados en estudios con pruebas t, y para enseñar cómo la distribución t se aproxima a la normalidad a medida que crece el tamaño de muestra. Para simulaciones de comparación de varianzas, use en su lugar Random F Data.