
Recursos adicionais do bioensaio logístico de 4 parâmetros (4PL)
Este complemento do Método Logístico de Quatro Parâmetros adiciona a configuração de termo de erro da ANOVA / IC. O modo Sequential (padrão) dá a cada teste F o resíduo do seu próprio modelo aninhado; o Pure Error usa o resíduo do modelo saturado nos três testes F de validade (Regressão, Não paralelismo, Falta de ajuste) e no IC da potência, como o software conforme o EP 5.3. O Pure Error exige alguma replicação. Os parâmetros da curva e a estimativa da potência não mudam.
Última revisão
Conclusão principal
A opção de termo de erro do bioensaio logístico de 4 parâmetros define se os testes F de validade e o intervalo de confiança da potência usam resíduos aninhados sequenciais ou um único erro puro, como no EP 5.3.
Nesta página
Bioensaio: Método Logístico de Quatro Parâmetros
Recurso adicionado: termo de erro opcional da ANOVA / intervalo de confiança ("Sequential" vs. "Pure Error")
O que foi adicionado
O Método Logístico de Quatro Parâmetros ganha o mesmo tipo de convenção opcional de termo de erro já adicionada aos métodos de Linhas Paralelas e de Razão de Inclinações, adaptada à estrutura de modelo próprio deste método. Ela controla qual estimativa de variância alimenta, em conjunto, os três testes F de validade e o intervalo de confiança da potência (e não apenas o intervalo de confiança, como nos dois métodos lineares), refletindo a forma como a ANOVA deste método é estruturada. Os parâmetros da curva ajustada e a estimativa pontual da potência não são afetados em nenhum dos casos.
Contexto regulatório e estatístico
Um ensaio logístico de quatro parâmetros (4PL) ajusta uma curva sigmoide, governada por uma assíntota superior, uma assíntota inferior, um fator de inclinação e um ponto de inflexão, à resposta de cada preparação em função do logaritmo da dose. Três modelos aninhados são comparados para construir os testes de validade: um modelo nulo (reta horizontal), um modelo em que todas as preparações compartilham uma única forma de curva (apenas o ponto de inflexão pode diferir, o que gera a estimativa de potência) e uma curva totalmente separada, ajustada de forma independente a cada preparação.
Como nos demais métodos de bioensaio, o software comercial em conformidade com o Capítulo 5.3 da Farmacopeia Europeia (Ph. Eur.), "Statistical Analysis of Results of Biological Assays and Tests", costuma construir os três testes F de validade e o intervalo de confiança da potência a partir de um único termo de variância de erro compartilhado, a sua convenção de "ANOVA de erro puro" (Pure-error ANOVA). O padrão já existente nesta ferramenta, em vez disso, dá a cada teste F o seu próprio termo de erro, mais adequado ao contexto local.
A matemática
Convenção A: "Sequential" (o padrão já existente nesta ferramenta). Cada um dos três testes F é construído a partir do par específico de modelos aninhados que ele compara, usando como denominador a variância residual dessa própria comparação:
F(Regressão) = QM(explicado pela curva compartilhada vs. reta horizontal) / QM(resíduo do ajuste da curva compartilhada)
F(Não paralelismo) = QM(explicado pelas curvas separadas vs. curva compartilhada) / QM(resíduo do ajuste das curvas separadas)
F(Falta de ajuste) = QM(explicado pelo ajuste saturado vs. curvas separadas) / QM(resíduo do ajuste saturado, ou seja, erro puro)
e o intervalo de confiança da potência usa, da mesma forma, o resíduo do próprio modelo de curva compartilhada, incorporando qualquer quantidade pequena e não significativa de não paralelismo.
Convenção B: "Pure Error" (a nova opção; a "Pure-error ANOVA" do EP 5.3). Os três testes F e o intervalo de confiança da potência passam a compartilhar um único denominador: o resíduo do ajuste totalmente saturado, com uma curva por preparação/grupo de dose:
F(qualquer teste) = QM(explicado pela comparação desse teste) / QM(erro puro, do ajuste saturado), com o mesmo denominador todas as vezes
Raciocínio: por que duas convenções e quando usar cada uma
As duas convenções respondem a perguntas ligeiramente diferentes, exatamente como nos dois métodos lineares: a convenção sequencial permite julgar a significância de cada teste em relação à variabilidade específica dessa comparação, enquanto a convenção de erro puro faz a todos os testes a mesma pergunta de fundo ("como esse desvio se compara ao ruído puro das réplicas, sem nada mais incorporado?") e, além disso, vincula o intervalo de confiança da potência a essa mesma estimativa de erro, a mais estreita possível.
Para um ensaio válido e bem ajustado, a diferença entre as duas costuma ser pequena. Ela fica mais perceptível quando há uma quantidade modesta e não significativa de não paralelismo ou de falta de ajuste, pois a convenção sequencial incorpora essa variabilidade extra ao termo de erro do teste correspondente (e do intervalo da potência), enquanto a convenção de erro puro a exclui deliberadamente em todos os casos.
Como nos demais métodos, selecionar "Pure Error" destina-se principalmente a conciliar resultados com software comercial em conformidade com o EP 5.3 ou com um método legado validado, baseado na sua convenção de Pure-error ANOVA. O padrão sequencial da ferramenta continua sendo uma escolha plenamente válida quando não há necessidade dessa comparação externa.
O que muda na saída e o que não muda
Afetados:
- Valor F e valor-p dos três testes de validade (Regressão, Não paralelismo, Falta de ajuste)
- Uma nova coluna "Error Term" na tabela ANOVA, que identifica a convenção e os graus de liberdade usados
- Lower CL e Upper CL do intervalo de confiança da potência, e uma nova coluna "CI Error Term"
Não afetados:
- Os parâmetros da curva ajustada (assíntota superior/inferior, fator de inclinação, ponto de inflexão) de cada preparação
- A razão de potência relativa estimada
- A equação do modelo ajustado exibida para cada preparação
Onde encontrar este recurso
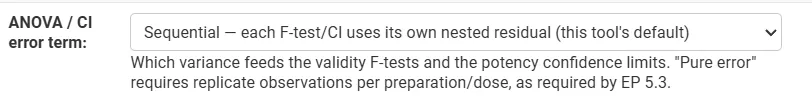
No formulário de entrada da ferramenta Método Logístico de Quatro Parâmetros, o campo rotulado "ANOVA / CI error term" oferece a escolha entre "Sequential — each F-test/CI uses its own nested residual (this tool's default)" e "Pure error — single saturated-model residual for all F-tests and the CI (EP 5.3 default)". A opção de erro puro exige que o modelo saturado (um ajuste por preparação/grupo de dose) tenha pelo menos um grau de liberdade residual, ou seja, alguma replicação nos dados.
Verificação com dados de referência publicados
Esta opção foi verificada com um ensaio sorológico publicado de antitoxina tetânica, que compara uma preparação padrão e uma preparação de soro de teste ao longo de dez diluições seriadas de fator dois, com duas réplicas por dose.
Fonte: Farmacopeia Europeia, 5ª edição (2005), Capítulo 5.3, exemplo prático 5.4.1.a, conforme reproduzido no relatório de exemplo publicado do PLA 3.0 da Stegmann Systems (Document-3567, "PLA_3.0.7_Example_Parallel-Logistic_Quantitative_Response_Assay_Standard_Report.pdf")
Métrica | Publicado (PLA/EP 5.3) | Calculado (opção Pure Error) |
F da regressão (gl=3) | 9785.4821 | 9788.5262 |
F do não paralelismo (gl=3) | 0.48912 | 0.4884 |
F da falta de ajuste (gl=12) | 0.62266 | 0.6216 |
Razão de potência | 1.45886 | 1.45880 (arredondado: 1.4588) |
Potência estimada da amostra (UI/ml) | 0.58354 | 0.5835 |
IC de 95% (potência da amostra, UI/ml) | 0.55511 – 0.61343 | 0.5544 – 0.6127 |
Os parâmetros de forma da curva (assíntota superior/inferior, fator de inclinação, pontos de inflexão) e a estimativa pontual da potência coincidiram quase exatamente com o relatório publicado nas duas convenções, o que confirma que o ajuste em si não é afetado por esta opção, como pretendido. Os valores F e o intervalo de confiança calculados com a opção de erro puro ficam próximos dos valores publicados, com uma pequena diferença residual (visível principalmente no intervalo de confiança) atribuível ao fato de o relatório publicado arredondar seus valores intermediários para três casas decimais antes do cálculo final. O padrão sequencial da ferramenta, como esperado, não se destina a coincidir com esse relatório de "Pure-error ANOVA" e foi verificado separadamente quanto à sua consistência interna.
Referências
- European Pharmacopoeia (Ph. Eur.), Chapter 5.3 — "Statistical Analysis of Results of Biological Assays and Tests" (5ª edição, 2005, e edições sucessivas).
- United States Pharmacopeia, General Chapter <111> — "Design and Analysis of Biological Assays".
- Stegmann Systems GmbH, exemplo prático publicado do PLA 3.0: "PLA_3.0.7_Example_Parallel-Logistic_Quantitative_Response_Assay_Standard_Report.pdf" — https://www.bioassay.de/fileadmin/user_upload/Webseiten-Landingpages/Bioassay.de/Analytical_methodes/Experiments/Parallel_logistic_potency_assays__3PL__4PL__5PL_/PLA_3.0.7_Example_Parallel-Logistic_Quantitative_Response_Assay_Standard_Report.pdf
Perguntas frequentes
O que é um bioensaio logístico de quatro parâmetros (4PL)?
Um ensaio 4PL ajusta uma curva sigmoide, definida por uma assíntota superior, uma assíntota inferior, um fator de inclinação e um ponto de inflexão, à resposta de cada preparação em função do logaritmo da dose. Os testes de validade comparam um modelo de reta horizontal, um modelo de forma compartilhada em que apenas o ponto de inflexão difere (o que fornece a estimativa de potência) e curvas totalmente separadas para cada preparação.
Qual é a diferença entre a ANOVA sequencial e a de erro puro em um ensaio 4PL?
Na convenção sequencial, cada teste F usa o resíduo dos modelos aninhados específicos que ele compara, e o intervalo da potência usa o resíduo da curva compartilhada. Na convenção de erro puro, os três testes F e o intervalo da potência compartilham um único denominador: o resíduo do ajuste totalmente saturado. A curva ajustada e a estimativa de potência são as mesmas nas duas convenções.
Quando usar a opção de erro puro em um ensaio 4PL?
Use o erro puro principalmente para conciliar resultados com software conforme o EP 5.3 ou com um método legado validado, baseado na sua convenção de ANOVA de erro puro. Em um ensaio válido e bem ajustado, as duas convenções costumam diferir pouco. A diferença aumenta quando há uma quantidade modesta e não significativa de não paralelismo ou de falta de ajuste. Nos demais casos, o padrão sequencial continua válido.
Como selecionar o termo de erro no Zometric Statistical Software?
No formulário de entrada do Método Logístico de Quatro Parâmetros, use o campo ANOVA / CI error term para escolher Sequential (o padrão) ou Pure error. A opção de erro puro exige que o modelo saturado tenha pelo menos um grau de liberdade residual, ou seja, que haja alguma replicação nos dados.