
Capacidade de processo automatizada
A capacidade de processo automatizada elimina a verificação manual de normalidade. Ela executa o teste de Anderson-Darling: com valor-p igual ou acima do limite (padrão 0.1), calcula Pp, Ppl, Ppu e Ppk normais; abaixo dele, ajusta distribuições não normais candidatas por máxima verossimilhança, escolhe a de melhor ajuste e usa o método do escore z. A saída mostra o caminho seguido, um histograma ajustado, os índices e o PPM esperado e observado.
Última revisão
Conclusão principal
A capacidade de processo automatizada testa a normalidade com Anderson-Darling e calcula Pp e Ppk automaticamente, pelo modelo normal ou pela distribuição não normal de melhor ajuste, documentando o caminho seguido.
Nesta página
Finalidade
A capacidade de processo automatizada elimina a etapa manual de primeiro testar a normalidade e depois escolher separadamente entre um modelo de capacidade normal ou não normal. A ferramenta executa por conta própria o teste de normalidade de Anderson-Darling e encaminha automaticamente o cálculo para os índices de capacidade normal padrão quando os dados passam no teste, ou para uma distribuição não normal de melhor ajuste (selecionada na biblioteca de distribuições candidatas do aplicativo) quando não passam, gerando um único relatório com a decisão de encaminhamento documentada no topo.
Principais recursos
- Executa o teste de normalidade de Anderson-Darling automaticamente, sem exigir uma etapa separada de verificação de normalidade.
- Seleciona automaticamente a distribuição não normal candidata de melhor ajuste quando a premissa de normalidade é rejeitada, usando a mesma biblioteca de ajuste de distribuições das outras ferramentas de capacidade não normal do aplicativo.
- Limite de valor-p de normalidade configurável, para que o usuário ajuste o quão conservadora é a opção padrão pelo caminho normal.
- Informa na própria saída qual caminho foi seguido (normal ou não normal, e qual distribuição), de modo que a decisão de encaminhamento seja transparente e auditável.
- Aceita uma coluna Factor opcional e um modo “Compare selected columns as separate groups”, de forma coerente com as outras ferramentas de capacidade do aplicativo.
Métodos estatísticos
A normalidade é avaliada com o teste de Anderson-Darling (anderson() do scipy contra uma referência normal), usando a correção padrão para amostras pequenas AD = A²·(1 + 0.75/n + 2.25/n²), com o valor-p obtido das aproximações empíricas por partes de D'Agostino–Stephens para a estatística AD corrigida.
Regra de encaminhamento: se o valor-p de Anderson-Darling for maior ou igual ao limite de valor-p de normalidade (padrão 0.1), a ferramenta trata os dados como normais: estima σ_overall pelo método da amplitude móvel (MRbar/d2, ou uma variante da mediana das amplitudes móveis) e, a partir dela, calcula os índices de desempenho padrão baseados em z: Pp, Ppl, Ppu e Ppk. Se o valor-p ficar abaixo do limite, a ferramenta ajusta, por máxima verossimilhança, cada distribuição não normal candidata aceita pelo aplicativo (Weibull, Weibull de 3 parâmetros, exponencial, exponencial de 2 parâmetros, gama, logística, log-logística, lognormal e as distribuições de valor extremo mínimo e máximo), classifica-as pela qualidade do ajuste e seleciona automaticamente a de melhor ajuste.
No caminho não normal, a FDA (função de distribuição acumulada) da distribuição selecionada é avaliada em LSL e USL para obter as probabilidades de cauda p_lsl e p_usl, que são então convertidas em escores z equivalentes da normal padrão pela inversa da FDA normal (norm.ppf), o “método do escore z”. A capacidade é então informada na escala conhecida do Cpk usando esses escores z: Pp = (z_usl − z_lsl) / 6, PPL = −norm.ppf(p_lsl) / 3, PPU = norm.ppf(p_usl) / 3, Ppk = min(PPL, PPU). Assim, o risco real de cauda de uma distribuição assimétrica é capturado antes de ser expresso nas mesmas unidades semelhantes ao Cpk usadas em todo o aplicativo, em vez de aplicar indevidamente um escore Z normal bruto a dados não normais.
Os valores de PPM (partes por milhão) são informados de duas maneiras: PPM “esperado”, obtido das probabilidades de cauda da distribuição ajustada além de cada limite de especificação, e PPM “observado”, obtido simplesmente contando a fração da amostra bruta que de fato fica fora dos limites de especificação.
Campos de entrada e opções
Campo | Descrição |
Choose columns | A(s) coluna(s) de resposta a analisar. |
Factor | Opcional. Compara a capacidade entre grupos quando os dados são uma única coluna de resposta (Response) mais uma coluna Factor. |
Compare selected columns as separate groups | Quando 2 ou mais colunas são selecionadas, executa a capacidade separadamente para cada uma e as compara lado a lado. |
LSL / USL | Limites inferior e superior de especificação, aplicados a todas as colunas selecionadas. |
Normality p-value threshold | Padrão 0.1. Se o valor-p de Anderson-Darling for igual ou superior a esse limite, a capacidade é calculada supondo normalidade; abaixo dele, a distribuição não normal de melhor ajuste é selecionada automaticamente e usada no lugar. |
Download as Excel | Opcional. Exporta o relatório para uma pasta de trabalho do Excel. |
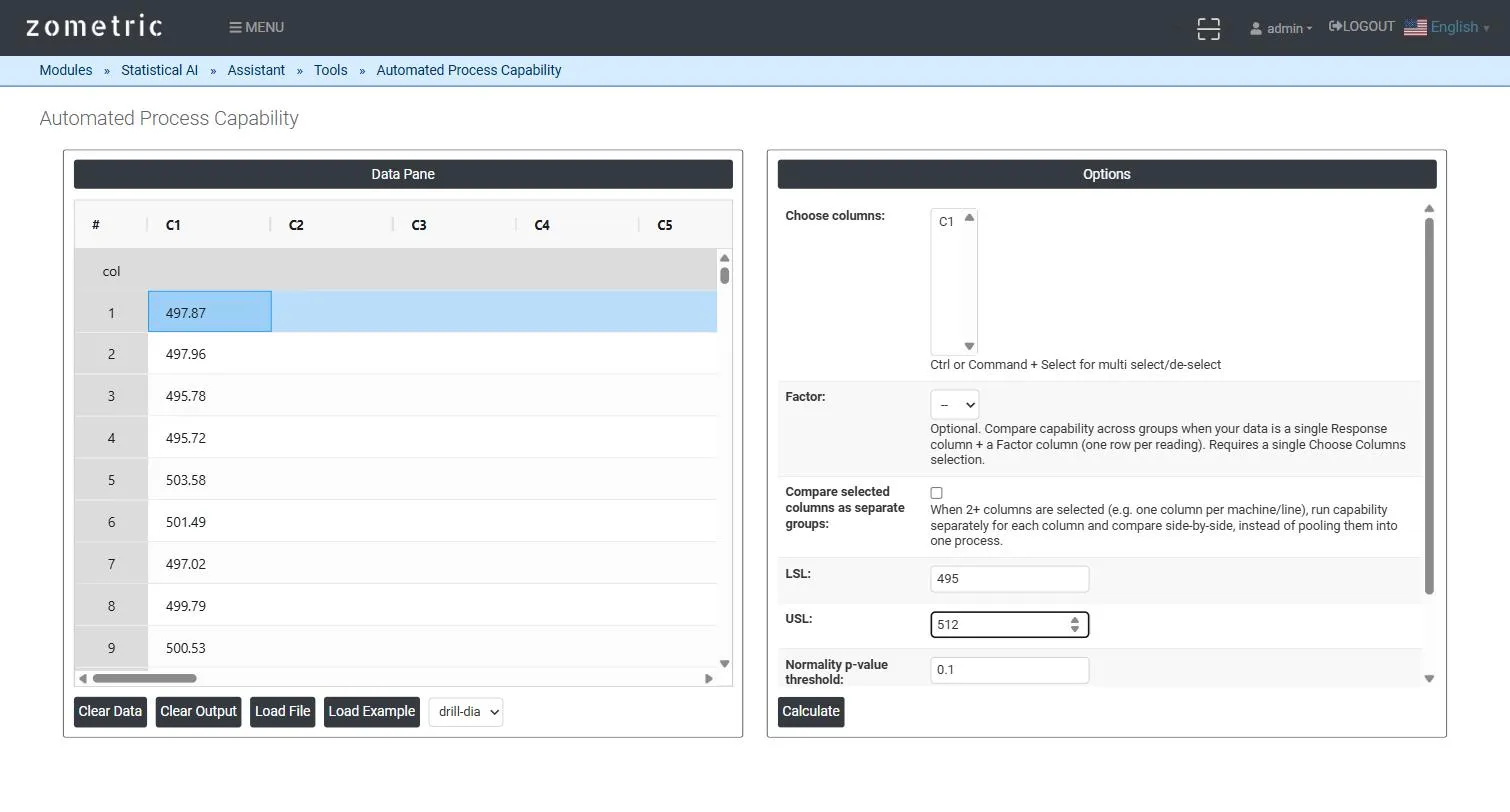
Figura 1 — Data pane com 60 leituras de peso de enchimento coladas em C1, LSL/USL e Normality p-value threshold preenchidos no painel Options.
Descrição da saída
- Resultado do teste de normalidade — a estatística e o valor-p de Anderson-Darling e o caminho seguido (normal ou a distribuição não normal específica selecionada automaticamente).
- Histograma da distribuição ajustada — histograma da amostra com a curva de densidade ajustada e as linhas de referência LSL/USL sobrepostas.
- Tabela de parâmetros da distribuição — LSL, USL, média da amostra, tamanho amostral e os parâmetros de forma/escala (ou equivalentes) da distribuição ajustada.
- Índices de capacidade — Pp, Ppl, Ppu e Ppk calculados a partir da distribuição selecionada.
- Tabelas de PPM — PPM esperado (das caudas da distribuição ajustada) e PPM observado (da amostra bruta), cada um dividido em PPM < LSL, PPM > USL e PPM Total.
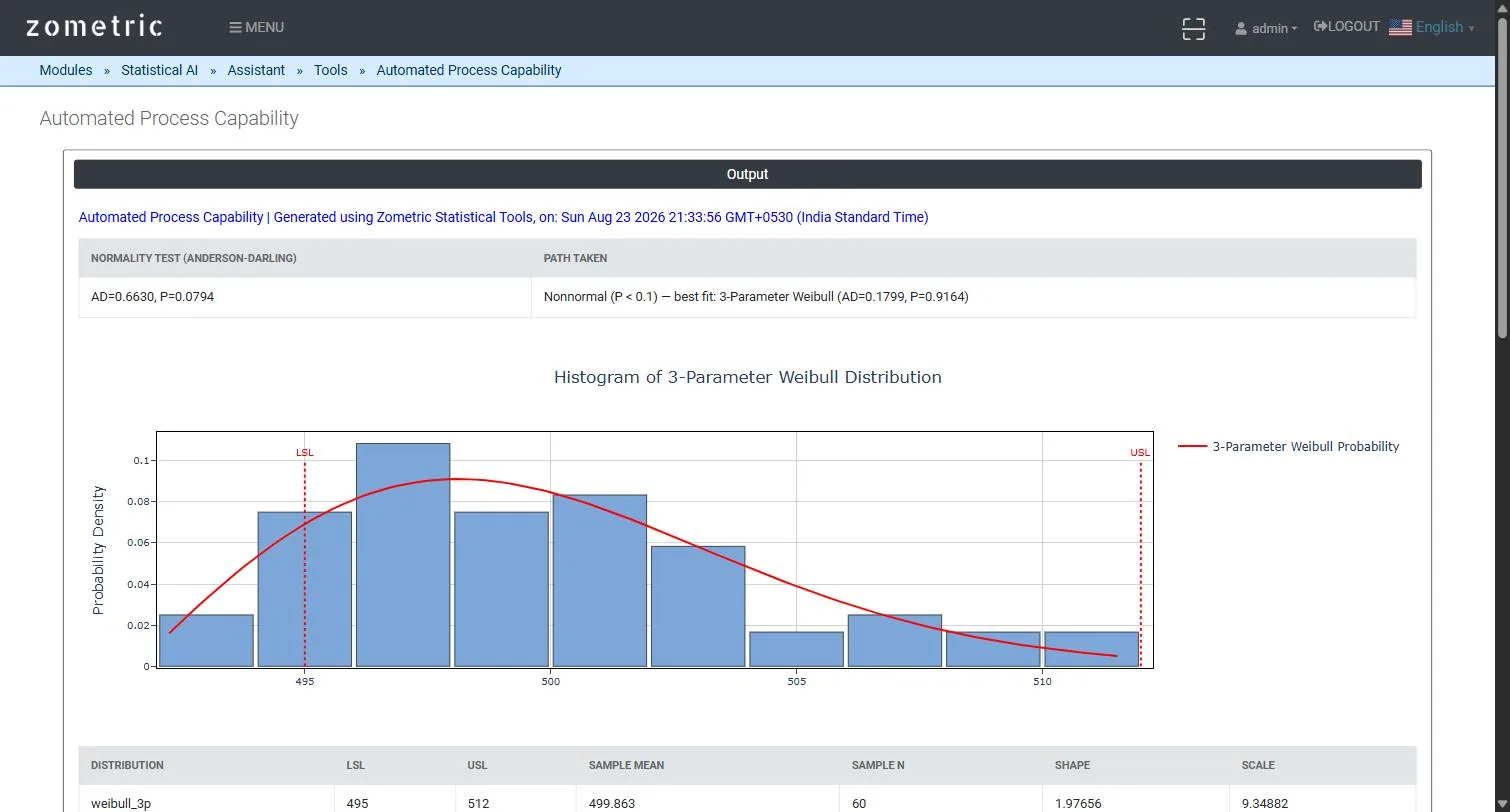
Figura 2 — Parâmetros da distribuição e os índices Pp/Ppl/Ppu/Ppk resultantes, com as tabelas de PPM esperado e observado.
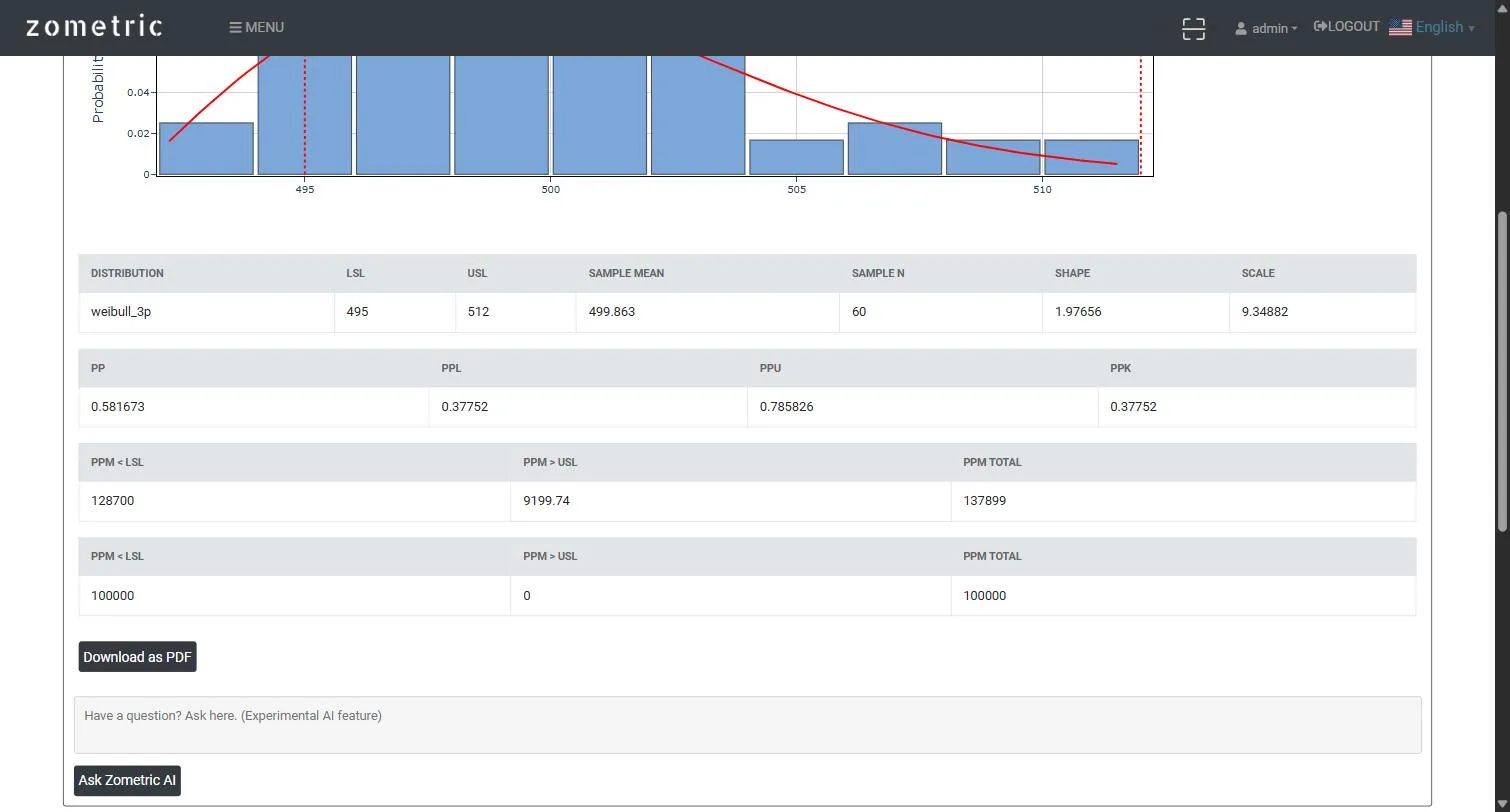
Figura 3 — Decisão de encaminhamento automático (resultado de Anderson-Darling e caminho seguido) com o histograma da distribuição ajustada.
Exemplo prático
Uma linha de envase enche frascos de um produto de limpeza viscoso; o peso de enchimento (g) é medido em 60 frascos retirados ao longo de um turno (coluna C1), com LSL = 495 g e USL = 512 g. Com o limite padrão de 0.1, o teste de Anderson-Darling retorna AD = 0.6630, P = 0.0794, abaixo do limite, de modo que a ferramenta encaminha automaticamente para o caminho não normal e seleciona um ajuste de Weibull de 3 parâmetros (AD = 0.1799, P = 0.9164) como a distribuição de melhor ajuste, informando Ppk = 0.378 a partir das probabilidades de cauda da Weibull ajustada, e não de uma premissa de distribuição normal (enganosa).
Perguntas frequentes
O que faz a capacidade de processo automatizada?
Ela executa o teste de normalidade de Anderson-Darling nos dados e encaminha automaticamente o cálculo de capacidade: para os índices de capacidade normal padrão, se os dados passarem, ou para a distribuição não normal de melhor ajuste, se não passarem. Um único relatório mostra o resultado da normalidade, o caminho seguido e a distribuição usada, de modo que a decisão de encaminhamento seja transparente e auditável.
Como a ferramenta decide entre capacidade normal e não normal?
Se o valor-p de Anderson-Darling for maior ou igual ao Normality p-value threshold, cujo padrão é 0.1, os dados são tratados como normais. Se ficar abaixo do limite, a ferramenta ajusta distribuições candidatas, como Weibull, Weibull de 3 parâmetros, gama, lognormal e outras, por máxima verossimilhança, classifica-as pela qualidade do ajuste e seleciona a melhor.
Como o Ppk é calculado para dados não normais?
A FDA da distribuição selecionada fornece as probabilidades de cauda além de LSL e USL, que são convertidas em escores z equivalentes da normal padrão. Em seguida, PPL = -z(p_lsl)/3, PPU = z(p_usl)/3 e Ppk = min(PPL, PPU). Isso captura o risco real de cauda de uma distribuição assimétrica e mantém os resultados na conhecida escala semelhante ao Cpk.
Como executar a capacidade automatizada no Zometric Statistical Software?
Cole os dados, escolha a coluna ou as colunas de resposta, opcionalmente uma Factor ou a opção de comparar colunas como grupos separados, e insira LSL e USL. Defina o Normality p-value threshold (padrão 0.1). O relatório mostra a decisão de encaminhamento, o histograma ajustado, os parâmetros da distribuição, os índices de capacidade e as tabelas de PPM, e pode ser exportado para o Excel.