
Teste qui-quadrado de independência (tabulação cruzada)
O teste qui-quadrado de independência avalia se duas variáveis categóricas estão associadas, a partir de uma tabela de contagens de dupla entrada resumida ou de registros brutos. Compara as contagens observadas com as esperadas sob independência usando o qui-quadrado de Pearson e o da razão de verossimilhanças com (r − 1)(c − 1) graus de liberdade. As contribuições e os resíduos ajustados mostram quais células explicam o resultado. As contagens esperadas não podem ser muito pequenas.
Última revisão
Conclusão principal
O teste qui-quadrado de independência verifica se duas variáveis categóricas estão relacionadas, por exemplo se a proporção de tipos de defeito depende do turno, do fornecedor ou da linha, e mostra quais células explicam a associação.
Nesta página
Finalidade
O teste qui-quadrado de independência verifica se duas variáveis categóricas estão relacionadas, por exemplo se a proporção de tipos de defeito depende do turno, do fornecedor ou da linha. Insira uma tabela de contagens já resumidas, ou os registros brutos com uma linha por unidade, e a ferramenta testa a associação e mostra quais células a explicam.
Principais recursos
- Tabela de dupla entrada resumida (uma coluna por categoria de coluna, uma linha por categoria de linha) ou dados categóricos brutos com frequências opcionais.
- Testes qui-quadrado de Pearson e da razão de verossimilhanças.
- Tabelas opcionais de contagens esperadas, contribuições para o qui-quadrado, resíduos brutos, padronizados e ajustados, e porcentagens por linha, por coluna e do total.
- Interpretação guiada opcional: relatório-resumo com perfis percentuais e gráficos de % de diferença, relatório de diagnóstico e relatório de avaliação (report card).
- Data Options: selecione um subconjunto das linhas antes da análise.
Métodos estatísticos
Para uma tabela r × c de contagens observadas O, com totais de linha Rᵢ, totais de coluna Cⱼ e total geral N, a contagem esperada sob independência é Eᵢⱼ = Rᵢ·Cⱼ / N. A estatística de Pearson é χ² = Σ (O − E)² / E, e a estatística da razão de verossimilhanças é G² = 2 Σ O·ln(O / E). Ambas são comparadas com uma distribuição qui-quadrado com (r − 1)(c − 1) graus de liberdade. Um valor-p pequeno indica que as variáveis de linha e de coluna estão associadas: a composição das colunas não é a mesma em todas as linhas.
A contribuição de cada célula (O − E)² / E mostra de onde vem a associação. O resíduo bruto é O − E, o resíduo padronizado é (O − E) / √E e o resíduo ajustado é (O − E) / √(E(1 − Rᵢ/N)(1 − Cⱼ/N)), que é aproximadamente normal padrão: valores além de cerca de ±2 marcam células que diferem claramente da independência. Com dados brutos, a ferramenta primeiro faz a tabulação cruzada das duas colunas, somando a coluna de frequências se houver uma; células em branco são deixadas de fora. Uma linha ou coluna com total zero deve ser removida. O valor-p é confiável quando as contagens esperadas não são muito pequenas; a interpretação guiada verifica isso.
Campos de entrada e opções
Campo | Descrição |
Data | Summarized data in a two-way table (padrão) ou Raw data (categorical variables). |
Columns (one per column-category) | Layout de tabela: duas ou mais colunas numéricas, cada uma com as contagens de uma categoria da variável de coluna, uma linha por categoria de linha. Obrigatório. |
Row labels | Layout de tabela, opcional: uma coluna que nomeia cada categoria de linha; em branco, usa Row 1, Row 2, … |
Rows / Columns / Frequencies (optional) | Layout bruto: as duas colunas categóricas e uma coluna opcional de contagens para cada registro. |
Statistics | Expected cell counts e Each cell's contribution to chi-square (marcadas por padrão); Raw residuals, Standardized residuals, Adjusted residuals, Row percents, Column percents, Total percents. |
Data Options: Subset (optional) | Exclude matching rows (padrão) ou Include only matching rows, por números de linha e/ou uma condição. |
Show guided interpretation | Acrescenta Summary, Diagnostic e Report Card em linguagem simples; Difference between the % defectives with practical value é uma entrada opcional para ele. |
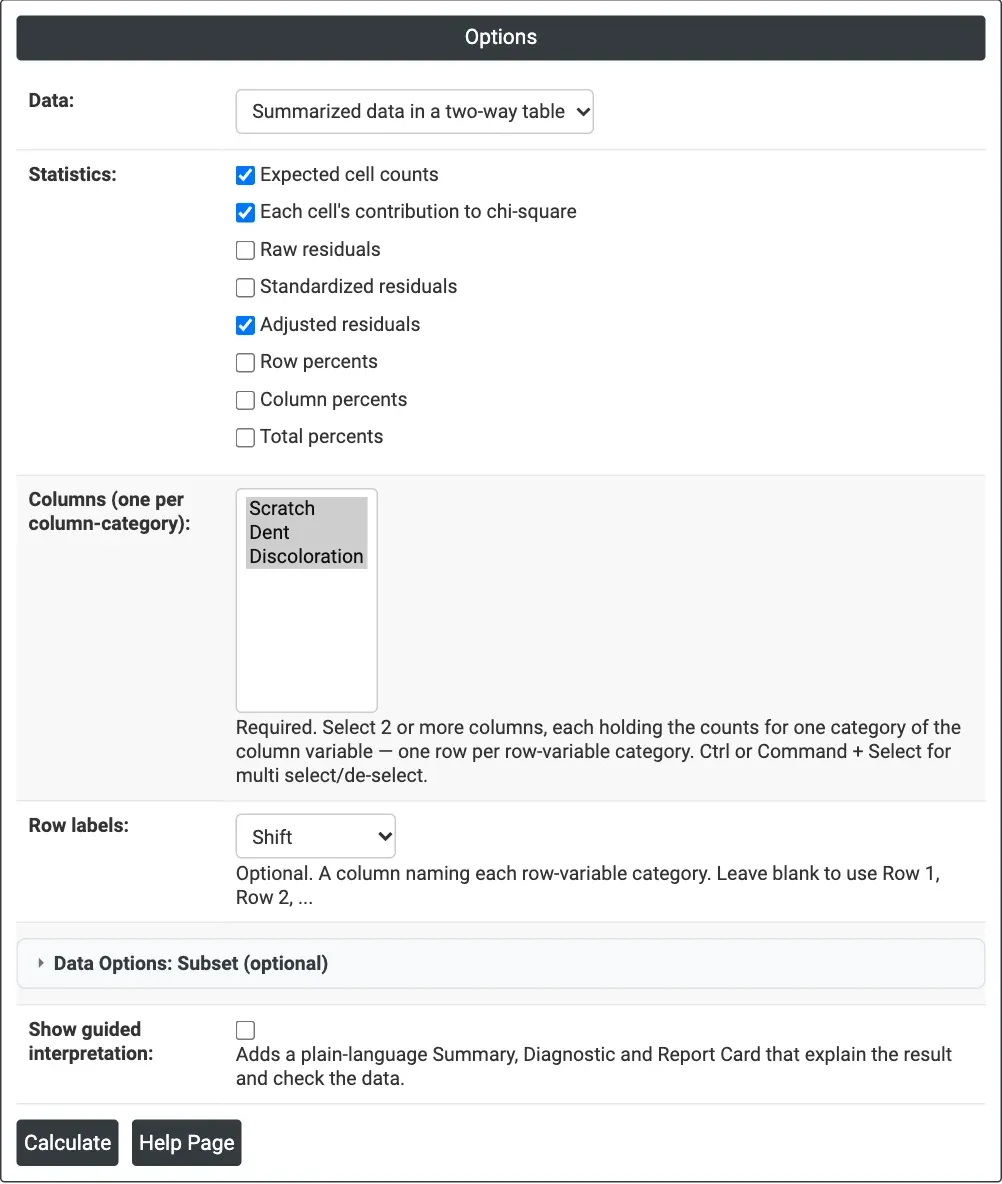
Figura 1 — Opções do exemplo de tipo de defeito: uma tabela resumida com as contagens de Scratch, Dent e Discoloration como colunas e Shift como rótulos de linha, com resíduos ajustados marcados.
Descrição da saída
- Observed Counts — a tabela com os totais de linha e de coluna (All).
- Expected Counts e Contribution to Chi-Square — quando marcados.
- Chi-Square Tests — Chi-Sq, DF e P-Value dos testes de Pearson e da razão de verossimilhanças.
- Raw Residuals, Standardized Residuals, Adjusted Residuals, Row Percents, Column Percents e Total Percents — quando marcados.
- Summary Report, Diagnostic Report e Report Card — com a interpretação guiada.
- Exportação em PDF por meio de Download.
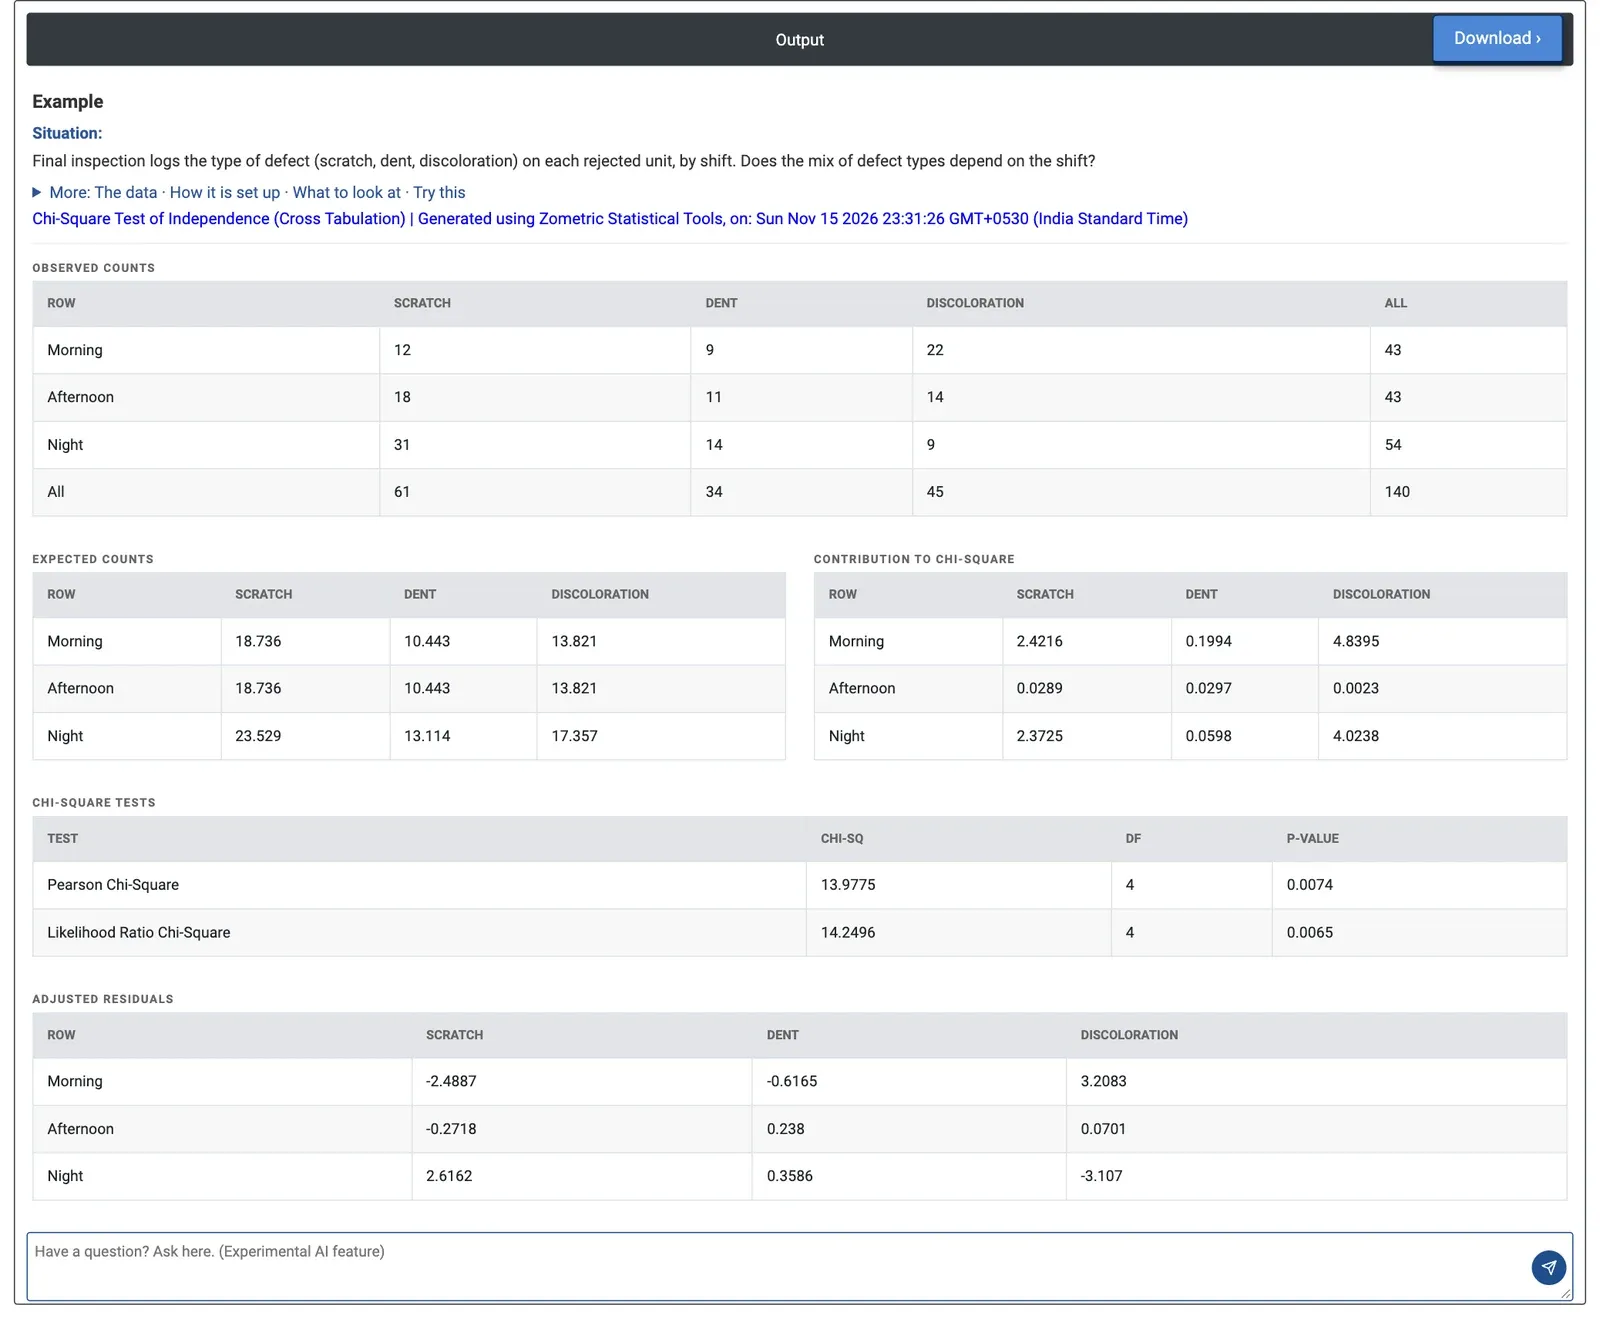
Figura 2 — Tipo de defeito por turno: qui-quadrado de Pearson de 13.98 com 4 DF, p = 0.0074; os resíduos ajustados apontam descoloração no turno da manhã e arranhões no turno da noite.
Exemplo prático
A inspeção final registra o tipo de defeito de cada unidade rejeitada, por turno: 140 rejeitadas no total. A equipe de qualidade quer saber se a proporção de tipos de defeito depende do turno. Ela insere as contagens como uma tabela com uma coluna por tipo de defeito (Scratch, Dent, Discoloration) e Shift como rótulos de linha, e marca Adjusted residuals além das estatísticas padrão.
A composição dos defeitos de fato depende do turno: qui-quadrado de Pearson de 13.98 com 4 DF, p = 0.0074 (razão de verossimilhanças 14.25, p = 0.0065). As contribuições mostram onde: descoloração no turno da manhã (4.84; 22 observadas contra 13.8 esperadas) e no turno da noite (4.02; 9 contra 17.4), depois arranhões nos turnos da manhã (2.42; 12 contra 18.7) e da noite (2.37; 31 contra 23.5). O turno da tarde acompanha a composição geral, e os amassados estão distribuídos de forma homogênea.
Os resíduos ajustados confirmam: 3.21 para a descoloração da manhã e 2.62 para os arranhões da noite estão bem além de 2. A equipe investiga o que muda no início do dia (por exemplo, aquecimento ou um lote de tinta diferente) para a descoloração, e o manuseio e a iluminação no turno da noite para os arranhões. Todas as contagens esperadas estão acima de 10, portanto o valor-p é confiável.
Perguntas frequentes
Como a contagem esperada é calculada em um teste qui-quadrado de independência?
Sob independência, a contagem esperada de uma célula é o total da sua linha vezes o total da sua coluna dividido pelo total geral, E = R x C / N. A estatística de Pearson soma (O − E)² / E sobre todas as células e é comparada com uma distribuição qui-quadrado com (r − 1)(c − 1) graus de liberdade, em que r e c são os números de linhas e de colunas.
Como interpretar um teste qui-quadrado de independência?
Um valor-p pequeno indica que as variáveis de linha e de coluna estão associadas: a composição das colunas não é a mesma em todas as linhas. Para ver de onde vem a associação, observe a contribuição de cada célula (O − E)² / E e os resíduos ajustados, que são aproximadamente normais padrão; valores além de cerca de ±2 marcam células que diferem claramente da independência.
Que formato de dados o teste exige?
No Zometric Statistical Software, você pode inserir uma tabela de dupla entrada resumida, com uma coluna numérica por categoria de coluna e uma linha por categoria de linha, ou dados brutos com duas colunas categóricas e uma coluna opcional de frequências. Com dados brutos, a ferramenta primeiro faz a tabulação cruzada das duas colunas. Uma linha ou coluna com total zero deve ser removida.
Quando o valor-p do teste qui-quadrado é confiável?
O valor-p é confiável quando as contagens esperadas não são muito pequenas, e a interpretação guiada opcional verifica isso. No exemplo prático de tipo de defeito por turno, todas as contagens esperadas estavam acima de 10, portanto o valor-p de Pearson de 0.0074 com 4 graus de liberdade era confiável.