
Agrupamento K-Médias (K-Means)
O Cluster K-Means agrupa observações de duas ou mais variáveis numéricas em K agrupamentos definidos por você, pelo método de Lloyd com centros iniciais k-means++ e várias partidas aleatórias. Padronize variáveis medidas em unidades diferentes. Use-o quando espera um número conhecido de grupos. A saída inclui a partição final, os centroides, o agrupamento e a distância de cada observação e a porcentagem de variação explicada.
Última revisão
Conclusão principal
O agrupamento K-Médias divide as observações em um número fixo de grupos (K), de modo que as de cada grupo sejam o mais parecidas possível nas variáveis escolhidas, por exemplo para classificar lotes, peças ou fornecedores em tipos.
Nesta página
Finalidade
O Cluster K-Means divide as observações em um número fixo de grupos (K), de modo que as observações de cada grupo sejam o mais parecidas possível nas variáveis que você escolher. Use-o quando espera um número conhecido de grupos, por exemplo para classificar lotes de material, peças ou fornecedores em tipos a partir de várias propriedades medidas, ou para verificar se um rótulo que você já usa (classe, linha, turno) aparece de alguma forma nas medições.
Principais recursos
- Agrupa observações de duas ou mais variáveis numéricas em K agrupamentos definidos por você.
- Padronização opcional, para que uma variável medida em unidades grandes não domine o agrupamento.
- Vários pontos de partida aleatórios; a melhor solução (menor dispersão dentro dos agrupamentos) é mantida, e os mesmos dados sempre dão o mesmo resultado.
- Informa a partição final (tamanho, soma de quadrados dentro do agrupamento, distância média e máxima ao centroide), o centroide de cada agrupamento nas unidades originais, o agrupamento de cada observação e a porcentagem da variação total explicada pelos agrupamentos.
- Diagrama de dispersão das duas primeiras variáveis selecionadas, colorido por agrupamento.
Métodos estatísticos
As linhas com valor ausente ou não numérico em qualquer variável selecionada são descartadas. Quando Standardize variables está marcado, cada variável é convertida em z = (x − média) / s, usando o desvio padrão amostral s, de modo que toda variável tenha média 0 e desvio padrão 1 antes do agrupamento.
O algoritmo K-means (método de Lloyd) atribui cada observação ao centro de agrupamento mais próximo pela distância euclidiana, recalcula cada centro como a média de seus membros e repete até que as atribuições deixem de mudar. Os centros iniciais são escolhidos pela regra k-means++. Como o resultado pode depender da partida, o algoritmo é executado tantas vezes quanto Number of random starts e é mantida a execução com a menor soma de quadrados dentro dos agrupamentos. Uma semente aleatória fixa é usada, de modo que os resultados se repetem exatamente.
A porcentagem de variação explicada pelos agrupamentos é (SQ total − SQ dentro dos agrupamentos) / SQ total × 100, em que SQ total é a soma dos quadrados das distâncias de todas as observações à média geral e SQ dentro dos agrupamentos é a soma dos quadrados das distâncias de cada observação ao centro do seu próprio agrupamento. Ambas são medidas nos dados como agrupados (padronizados quando essa opção está marcada). Um valor maior significa grupos mais distintos e compactos, mas ele sempre aumenta com K, portanto compare-o entre valores de K com cuidado. Os centroides são convertidos de volta às unidades originais para o relatório. A partição final informa, para cada agrupamento, o número de observações, a soma de quadrados dentro do agrupamento e a distância média e máxima de seus membros ao centroide; essas distâncias, e a distância de cada observação na tabela de pertencimento, são distâncias euclidianas nas unidades agrupadas (padronizadas quando essa opção está marcada), como no Minitab.
Campos de entrada e opções
Campo | Descrição |
Variables | Duas ou mais colunas numéricas para agrupar. Ctrl ou Command + clique para selecionar várias. |
Number of clusters (K) | Quantos grupos formar. Padrão 3; mínimo 2. São necessárias ao menos K observações completas. |
Standardize variables | Marcado por padrão. Coloca todas as variáveis na mesma escala (média 0, desvio padrão 1) antes do agrupamento. Desmarque somente quando todas as variáveis tiverem as mesmas unidades e você quiser que as de maior dispersão tenham mais peso. |
Number of random starts | Quantos pontos de partida testar; o melhor resultado é mantido. Padrão 10, de 1 a 100. |
Title | Título exibido no gráfico e na saída. Padrão Cluster K-Means. |
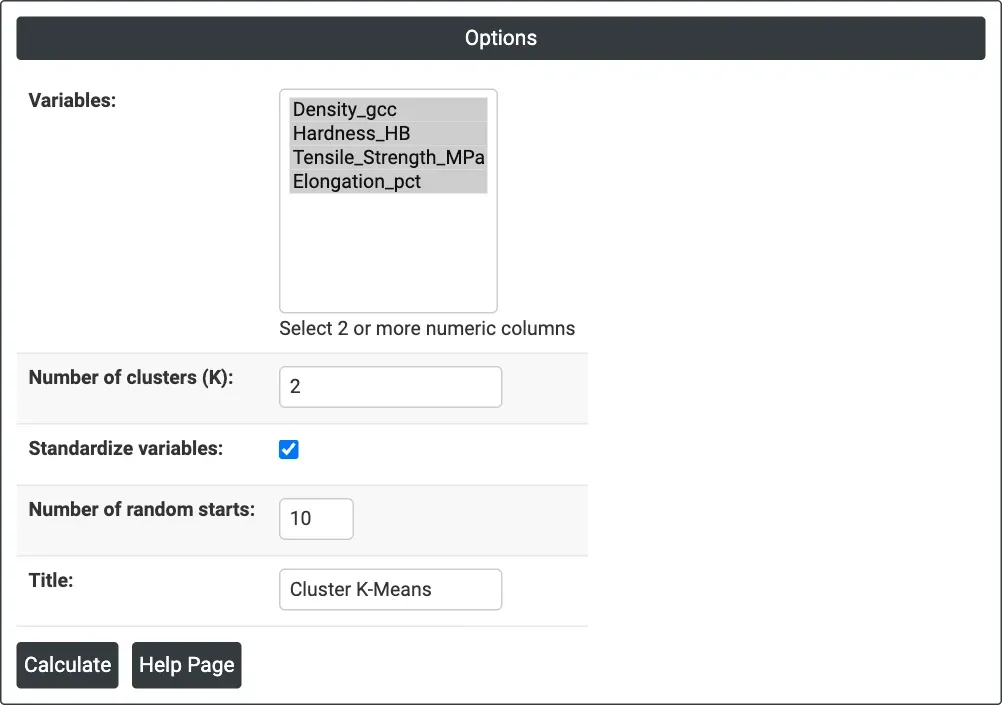
Figura 1 — Opções para o exemplo: as quatro colunas de propriedades, K = 2, padronizado, 10 partidas aleatórias.
Descrição da saída
- Cluster K-Means plot — diagrama de dispersão da primeira variável selecionada (x) contra a segunda (y), com cada ponto colorido pelo seu agrupamento.
- % variation explained by clusters — a parcela da variação total que está entre os agrupamentos, e não dentro deles.
- Final Partition — para cada agrupamento: Number of observations, Within cluster sum of squares, Average distance from centroid e Maximum distance from centroid.
- Cluster Centroids — para cada agrupamento, seu número N de observações e a média de cada variável nas unidades originais.
- Cluster Membership — cada observação (pela linha da planilha), seu agrupamento e sua distância ao centroide desse agrupamento.
- Exportação em PDF por meio de Download.
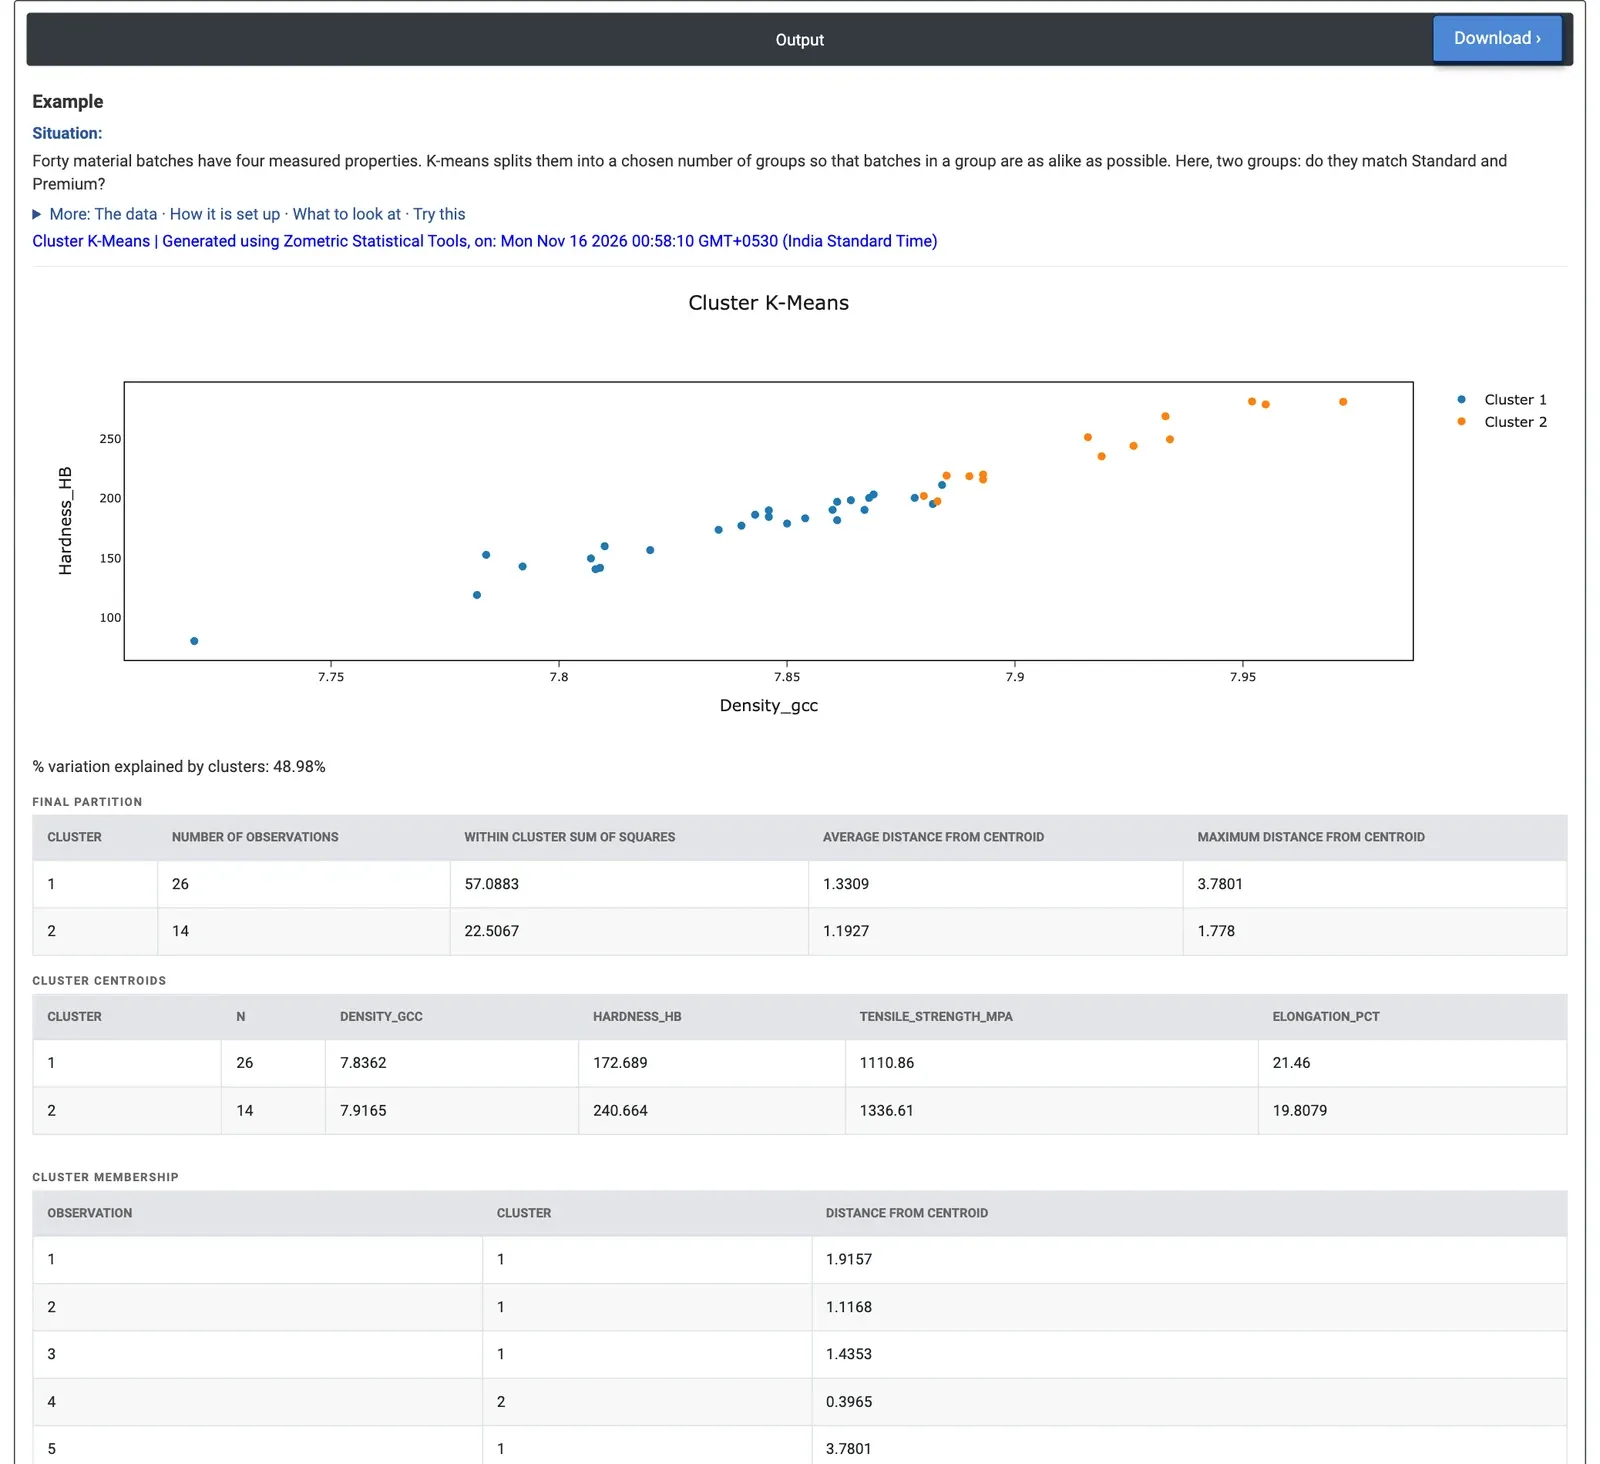
Figura 2 — Dois agrupamentos de 40 lotes de material: o Cluster 2 (14 lotes) é mais duro e mais resistente; os agrupamentos explicam 48.98% da variação. A partição final, os centroides e o início da tabela de pertencimento aparecem após o gráfico.
Exemplo prático
Um laboratório de materiais tem 40 lotes, cada um medido quanto a densidade (g/cc), dureza (HB), resistência à tração (MPa) e alongamento (%). Os lotes são vendidos como Standard ou Premium, 20 de cada. O laboratório quer saber se as medições sozinhas formam dois grupos naturais e se esses grupos coincidem com o tipo de lote. Ele seleciona as quatro colunas de propriedades, define Number of clusters (K) = 2, mantém Standardize variables marcado (a resistência à tração, na casa das centenas, dominaria o resultado caso contrário) e mantém 10 partidas aleatórias.
Os agrupamentos explicam 48.98% da variação. O Cluster 2 reúne 14 lotes mais duros e mais resistentes (médias de 240.7 HB e 1,336.6 MPa) e um pouco menos dúcteis (19.8% de alongamento); o Cluster 1 reúne 26 lotes com médias de 172.7 HB, 1,110.9 MPa e 21.5% de alongamento. Os centroides de densidade diferem pouco (7.92 contra 7.84 g/cc). Na partição final, o Cluster 2 é o grupo mais compacto (distância média ao centroide de 1.19 contra 1.33 unidades padronizadas); o membro mais distante do Cluster 1, a linha 5, está a 3.78 unidades de seu centroide, um lote atípico que vale a pena verificar. Comparando com a coluna do tipo de lote, o Cluster 2 contém 11 lotes Premium e 3 Standard, e o Cluster 1 contém 17 Standard e 9 Premium, de modo que 28 dos 40 lotes ficam no agrupamento que corresponde ao seu tipo.
Para o laboratório, isso significa que os lotes mais resistentes formam um grupo nítido, mas muitos lotes Premium não são mais duros nem mais resistentes que os Standard: o rótulo não é totalmente sustentado pelas propriedades. Com K = 3, a variação explicada sobe para 69.66% e um grupo macio e fraco de 9 lotes (138.2 HB, 995.9 MPa) se separa de um grupo intermediário de 23 e de um grupo superior de 8. Desmarcar Standardize variables muda a divisão para 19 e 21 lotes, porque a resistência à tração passa então a ter a maior parte do peso. Para construir uma regra que use os tipos conhecidos, execute a Discriminant Analysis nos mesmos dados.
Perguntas frequentes
Quando usar o agrupamento k-means?
Use-o quando espera um número conhecido de grupos e quer classificar observações, como lotes de material, peças ou fornecedores, em tipos a partir de várias propriedades medidas. Ele também é útil para verificar se um rótulo que você já usa, como classe, linha ou turno, aparece de alguma forma nas medições.
Deve-se padronizar as variáveis antes do k-means?
A padronização converte cada variável para média 0 e desvio padrão 1, de modo que uma variável medida em unidades grandes não domine o agrupamento. Ela vem marcada por padrão. Desmarque-a somente quando todas as variáveis tiverem as mesmas unidades e você quiser que as de maior dispersão tenham mais peso; no exemplo prático, desmarcá-la mudou a divisão porque a resistência à tração passou a ter a maior parte do peso.
Como escolher o número de agrupamentos K?
A saída informa a porcentagem da variação total explicada pelos agrupamentos; um valor maior significa grupos mais distintos e compactos. Ele sempre aumenta com K, portanto compare-o entre valores de K com cuidado. No exemplo, dois agrupamentos explicaram 48.98% da variação e três agrupamentos, 69.66%, com a separação de um grupo macio e fraco de 9 lotes.
Qual é a diferença entre k-means e análise discriminante?
O k-means encontra grupos apenas a partir das medições, sem usar rótulos conhecidos. No exemplo, os dois agrupamentos coincidiram com o rótulo Standard ou Premium em apenas 28 dos 40 lotes. Para construir uma regra que use os tipos conhecidos para separar os grupos, execute a Discriminant Analysis nos mesmos dados.