
Análise de correspondência simples
A análise de correspondência simples usa dados categóricos brutos ou uma tabela de contingência e plota as categorias de linha e de coluna em um mapa. Ela informa um teste qui-quadrado de associação, uma tabela de inércia que mostra quanto cada componente explica e tabelas de contribuição de linhas e colunas. Cada variável precisa de pelo menos 2 categorias. Use-a para ler o padrão de uma tabela cruzada grande, como tipos de defeito por máquina.
Última revisão
Conclusão principal
A análise de correspondência simples transforma uma tabela de contagens de dupla entrada em um mapa em que categorias de linha e de coluna que ocorrem juntas mais do que o acaso sugeriria ficam próximas.
Nesta página
Finalidade
A análise de correspondência simples transforma uma tabela de contagens de dupla entrada em um mapa. As categorias de linha e de coluna são desenhadas como pontos, e as categorias que ocorrem juntas mais do que o acaso sugeriria ficam próximas. Use-a para ver, de relance, o padrão de uma tabela cruzada grande: quais tipos de defeito acompanham quais máquinas, quais categorias de reclamação acompanham quais produtos ou quais atributos os clientes associam a quais marcas.
Principais recursos
- Aceita dados brutos (uma linha por item com duas colunas categóricas) ou uma tabela de contingência já resumida em contagens.
- Teste qui-quadrado de associação entre as variáveis de linha e de coluna.
- Tabela de inércia que mostra quanto da associação cada componente (eixo do mapa) explica.
- Tabelas de contribuição de linhas e colunas: qualidade, massa, inércia, coordenadas, correlações ao quadrado e contribuições para o número de componentes escolhido.
- Cinco gráficos: gráfico simétrico de linhas e colunas, somente linhas, somente colunas e gráficos assimétricos de linhas ou de colunas.
Métodos estatísticos
Com a entrada Categorical variables, a ferramenta cruza a variável de linha com a variável de coluna, ignorando as linhas com valor ausente. Com a entrada Columns of a contingency table, cada coluna selecionada contém as contagens de uma categoria de coluna e cada linha é uma categoria de linha; linhas ou colunas cujo total é zero são descartadas. Cada variável precisa de pelo menos 2 categorias.
As contagens são divididas pelo total geral n para obter as proporções P, com as massas de linha r (totais de linha de P) e as massas de coluna c (totais de coluna). A matriz de resíduos padronizados S = Dr^−½ (P − r cᵀ) Dc^−½ é decomposta por decomposição em valores singulares. Cada valor singular d gera um componente com inércia d², e o número de componentes é o menor entre (linhas − 1) e (colunas − 1). A inércia total é igual à estatística qui-quadrado dividida por n, e a ferramenta informa qui-quadrado = n × inércia total com (linhas − 1)(colunas − 1) graus de liberdade e o seu valor-p. Um valor-p pequeno significa que linhas e colunas estão associadas, de modo que o mapa mostra um padrão real.
As coordenadas principais das linhas são Dr^−½ U D e as das colunas, Dc^−½ V D. Nas tabelas de contribuição, Mass é a participação da categoria na contagem total, Inert a sua participação na inércia total, Corr o cosseno ao quadrado (quão bem um componente mostra o ponto), Qual a soma de Corr nos componentes informados e Contr a parcela da inércia de um componente que o ponto responde. Os gráficos simétricos usam coordenadas principais para os dois conjuntos de pontos; um gráfico assimétrico de linhas mostra as linhas em coordenadas principais e as colunas em coordenadas padrão (principais divididas por d), e um gráfico assimétrico de colunas faz o inverso.
Campos de entrada e opções
Campo | Descrição |
Input data | Categorical variables (padrão): uma linha por item. Columns of a contingency table: contagens já resumidas. Os campos abaixo mudam conforme essa escolha. |
Row variable / Column variable | Na entrada Categorical variables: as duas colunas categóricas a cruzar. Ambas são obrigatórias e devem ser diferentes. |
Contingency table columns | Na entrada de tabela de contingência: duas ou mais colunas, cada uma com as contagens de uma categoria de coluna, uma linha por categoria de linha. |
Row names | Na entrada de tabela de contingência, opcional: uma coluna que nomeia cada linha da tabela. Em branco, usa Row 1, Row 2 e assim por diante. |
Column names | Na entrada de tabela de contingência, opcional: uma coluna que lista um nome por coluna da tabela selecionada, na mesma ordem. Em branco, usa os cabeçalhos das colunas. |
Number of components | Para quantos componentes informar Coord, Corr e Contr nas tabelas de contribuição. O padrão é 2; de 1 a 20, limitado ao número de componentes disponíveis. |
Symmetric plot showing rows and columns | Marcada por padrão. Linhas e colunas em um só mapa, ambas em coordenadas principais. |
Symmetric plot showing rows only / columns only | Desmarcada por padrão. O mesmo mapa com apenas um conjunto de pontos. |
Asymmetric row plot / Asymmetric column plot | Desmarcada por padrão. Linhas em coordenadas principais e colunas em coordenadas padrão, ou o inverso. |
Title | Título exibido nos gráficos. O padrão é Simple Correspondence Analysis. |
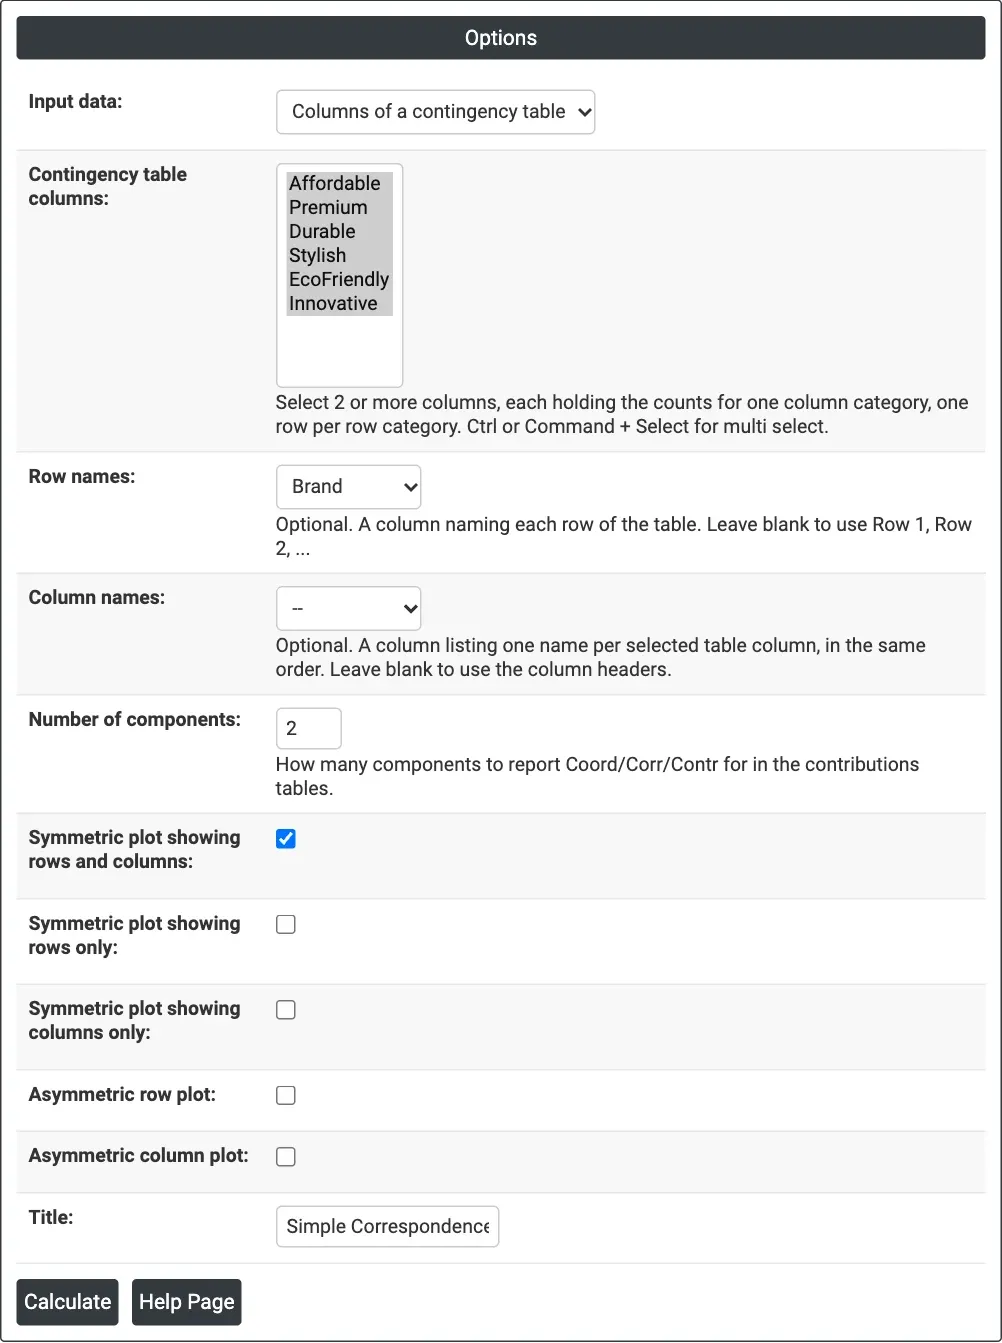
Figura 1 — Opções do exemplo de percepção de marca: entrada de tabela de contingência com seis colunas de atributos e Brand como nomes das linhas.
Descrição da saída
- Symmetric Plot, Row Plot, Column Plot, Asymmetric Row Plot, Asymmetric Column Plot — os gráficos marcados, com Component 1 e Component 2 como eixos e o percentual de inércia que cada um explica nos títulos dos eixos.
- Contingency Table — exibida na entrada de tabela de contingência: a tabela como foi analisada.
- Chi-square, DF e P-value — o teste de associação entre linhas e colunas.
- Analysis of Contingency Table — inércia, proporção e proporção acumulada de cada eixo, com um histograma em texto, e a inércia total.
- Row Contributions e Column Contributions — ID, Name, Qual, Mass, Inert e Coord, Corr e Contr de cada componente informado.
- Exportação em PDF por meio de Download.
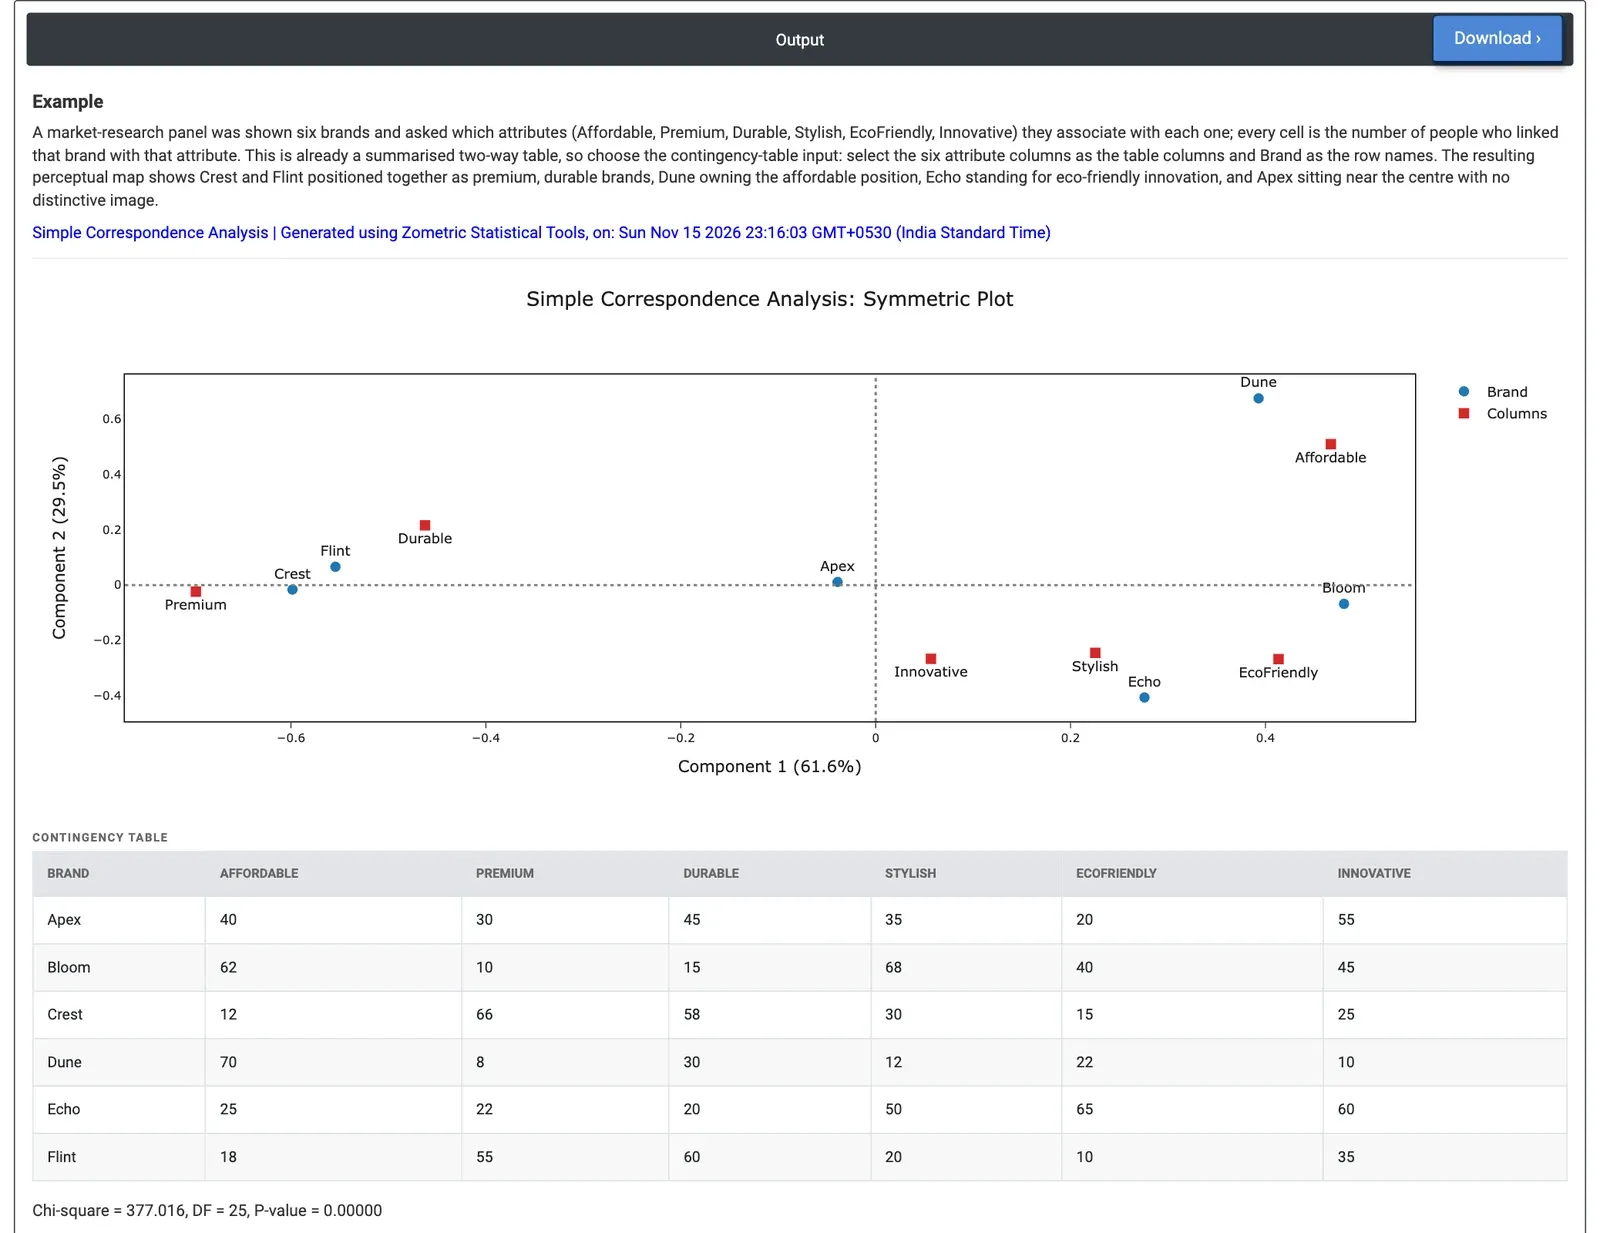
Figura 2 — Gráfico simétrico de seis marcas e seis atributos: Crest e Flint ficam com Premium e Durable, Dune com Affordable, Echo perto de EcoFriendly; qui-quadrado 377.0 com 25 DF.
Exemplo prático
Um painel de pesquisa de mercado viu seis marcas (Apex, Bloom, Crest, Dune, Echo e Flint) e foi perguntado a quais de seis atributos associa cada uma: Affordable, Premium, Durable, Stylish, EcoFriendly e Innovative. Cada célula contém o número de pessoas que associaram aquela marca àquele atributo. A equipe de marketing quer ver a posição de cada marca. Como os dados já são uma tabela de contagens, ela define Input data = Columns of a contingency table, seleciona as seis colunas de atributos como Contingency table columns e escolhe Brand como Row names, mantendo o gráfico simétrico de linhas e colunas.
O qui-quadrado é 377.016 com 25 graus de liberdade (p < 0.00001); portanto, a imagem de marca difere claramente entre as marcas. O Component 1 responde por 61.6% da inércia e o Component 2 por 29.5%, de modo que o mapa bidimensional mostra 91.1% do padrão. O Component 1 vai de Premium (−0.698) e Durable (−0.462) à esquerda até Affordable (0.467) e EcoFriendly (0.414) à direita. Crest (−0.599) e Flint (−0.554) ficam do lado premium e durável e são representadas quase perfeitamente nesse eixo (Corr 0.94 e 0.98). Dune fica no alto do Component 2 (0.674), ao lado de Affordable, e responde por 62.2% da inércia desse componente. Echo (0.276, −0.406) fica perto de EcoFriendly, Stylish e Innovative, e Bloom (0.481) tende a Stylish e Affordable.
Apex fica perto do centro (−0.039, 0.011), com qualidade de apenas 0.038: seu perfil é próximo da média de todas as marcas, de modo que ela não tem uma imagem distintiva. Para a equipe, Crest e Flint disputam a mesma posição premium e durável, Dune domina a posição de preço acessível e Apex é a marca que precisa de uma mensagem mais clara.
Perguntas frequentes
Para que serve a análise de correspondência?
Serve para ver, de relance, o padrão de uma tabela cruzada grande, por exemplo quais tipos de defeito acompanham quais máquinas, quais categorias de reclamação acompanham quais produtos ou quais atributos os clientes associam a quais marcas. As categorias de linha e de coluna são desenhadas como pontos, e as categorias que ocorrem juntas mais do que o acaso ficam próximas.
O que é inércia na análise de correspondência?
A inércia mede a associação na tabela. Cada componente, ou eixo do mapa, tem uma inércia igual ao seu valor singular ao quadrado, e a inércia total é igual à estatística qui-quadrado dividida pelo total geral n. A tabela de inércia mostra a proporção que cada componente explica; no exemplo das marcas, os dois primeiros componentes mostraram 91.1% do padrão.
Como interpretar qualidade, massa e contribuição?
Mass é a participação da categoria na contagem total, Inert a sua participação na inércia total, Corr o quão bem um componente mostra o ponto, Qual a soma de Corr nos componentes informados e Contr a parcela da inércia de um componente que o ponto responde. Um ponto perto do centro com baixa qualidade, como Apex no exemplo, tem um perfil próximo da média.
Qual é a diferença entre gráficos simétricos e assimétricos?
Um gráfico simétrico mostra linhas e colunas juntas, ambas em coordenadas principais, e vem marcado por padrão. Um gráfico assimétrico de linhas mostra as linhas em coordenadas principais e as colunas em coordenadas padrão (principais divididas pelo valor singular), e um gráfico assimétrico de colunas faz o inverso. Também estão disponíveis gráficos somente de linhas ou somente de colunas.