
Estatística descritiva (tabelas)
Escolha variáveis numéricas e variáveis opcionais de agrupamento em linhas e colunas e, em seguida, selecione entre nove estatísticas: N, média, erro padrão da média, desvio padrão, mínimo, primeiro quartil, mediana, terceiro quartil e máximo. Valores ausentes ficam de fora. Use para comparar subgrupos, como pesos de enchimento por enchedora e turno. Ela descreve os dados e não testa se as diferenças são reais.
Última revisão
Conclusão principal
A Estatística Descritiva (Tabelas) resume uma ou mais colunas numéricas em uma única tabela, detalhada por até duas colunas de agrupamento, para comparar muitos subgrupos lado a lado antes de aprofundar a análise.
Nesta página
Finalidade
A Estatística Descritiva (Tabelas) resume uma ou mais colunas numéricas em uma única tabela, detalhada por até duas colunas de agrupamento: uma ao longo do lado da tabela e outra na parte superior. Para cada variável, você escolhe quais estatísticas mostrar: contagem, média, erro padrão da média, desvio padrão, mínimo, quartis, mediana e máximo. Use-a para colocar muitos subgrupos lado a lado antes de decidir onde aprofundar a análise, por exemplo, pesos de enchimento por enchedora e turno, tempos de ciclo por linha e produto, ou resultados de ensaio por fornecedor e lote. Ela descreve os dados; não testa se as diferenças são reais.
Principais recursos
- Várias variáveis numéricas em uma só tabela, cada uma com seu próprio bloco de estatísticas.
- Detalhamento por uma variável de linha, uma variável de coluna ou ambas: os grupos da variável de linha ficam ao longo da tabela e os da variável de coluna na parte superior, como no Minitab.
- Nove estatísticas para escolher; N, Mean, Standard deviation, Minimum, Median e Maximum vêm marcadas por padrão.
- Valores ausentes em uma variável ficam de fora das estatísticas dessa variável.
- Exportação em PDF por meio de Download.
Métodos estatísticos
Os dados são divididos pelos níveis da variável de linha e da variável de coluna (quando informadas), e as estatísticas são calculadas separadamente dentro de cada grupo e para cada variável, depois que os valores ausentes e não numéricos são descartados. Os grupos aparecem na ordem classificada dos valores de agrupamento. Sem variável de agrupamento, a tabela tem uma linha para a coluna inteira.
N é o número de valores não ausentes. Média x̄ = Σx / N. O desvio padrão s usa o divisor N − 1: s = √(Σ(x − x̄)² / (N − 1)). SE of mean = s / √N, a incerteza da média do grupo. Minimum, Median e Maximum são o menor valor, o valor do meio e o maior valor. O primeiro e o terceiro quartis são os percentis 25 e 75, obtidos por interpolação linear entre os valores ordenados na posição 1 + (N − 1)·p, de modo que podem diferir ligeiramente de softwares que usam a regra (N + 1)·p. Com grupos pequenos (menos de cerca de 10 valores), o desvio padrão e os quartis são aproximados; portanto, interprete-os com cuidado.
Campos de entrada e opções
Campo | Descrição |
Variables | Obrigatório. Uma ou mais colunas numéricas a resumir (mantenha Ctrl ou Cmd pressionado para selecionar várias). |
For rows (optional) | Coluna de agrupamento. Cada um de seus níveis recebe suas próprias linhas na tabela. |
For columns (optional) | Segunda coluna de agrupamento. Seus níveis se tornam as colunas da tabela, uma por nível; cada linha então contém uma estatística de uma variável (para cada nível da variável de linha, quando definida). |
N / Mean / SE of mean / Standard deviation / Minimum / First quartile / Median / Third quartile / Maximum | Estatísticas a mostrar para cada variável. Marcadas por padrão: N, Mean, Standard deviation, Minimum, Median e Maximum. Pelo menos uma deve estar marcada. |
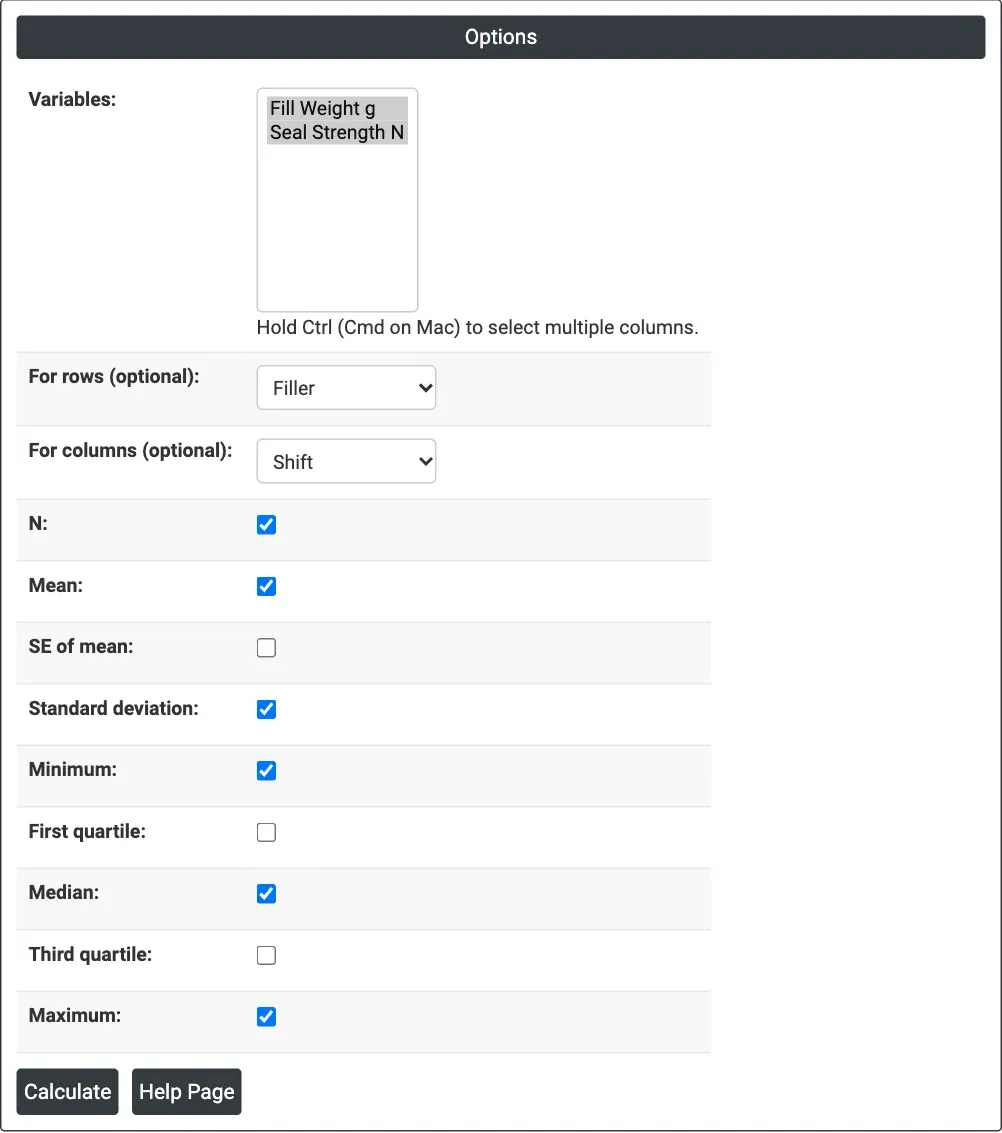
Figura 1 — Fill Weight g e Seal Strength N resumidos por Filler (linhas) e Shift (colunas) com as estatísticas padrão.
Descrição da saída
- Statistics table — com uma variável de coluna (com o cabeçalho “Rows: <row variable>; Columns: <column variable>”): primeiro o nível da variável de linha, Variable e Statistic, depois uma coluna por nível da variável de coluna. Sem ela: uma linha por grupo da variável de linha (ou uma única linha no total), depois uma coluna por variável e estatística, nomeada Variable_Statistic, p. ex. Fill Weight g_Mean, Seal Strength N_StDev (Q1, Q3 e SE Mean para as estatísticas opcionais).
- Exportação em PDF por meio de Download.
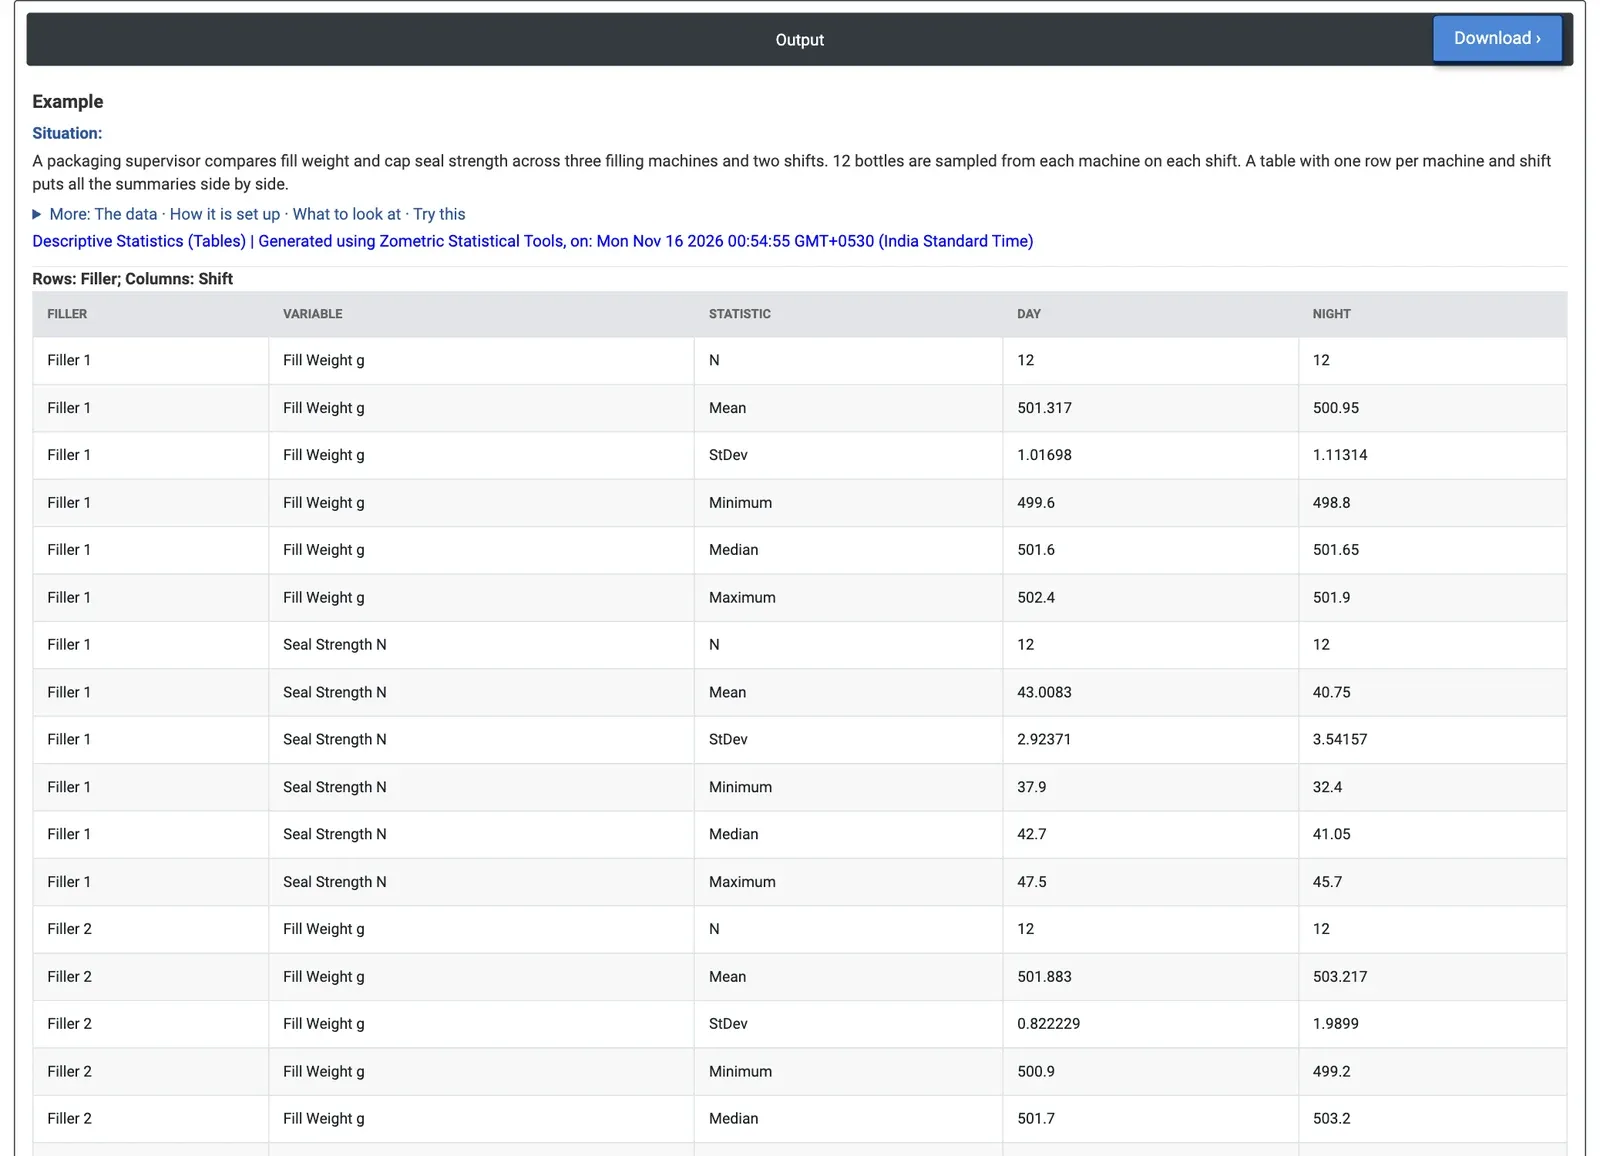
Figura 2 — Enchedoras ao longo do lado e turnos na parte superior: a resistência da vedação é menor no turno da noite (Night) para as três enchedoras, e a Filler 2 no turno da noite (Night) enche mais pesado e com maior variabilidade.
Exemplo prático
Um supervisor de embalagem compara três máquinas de enchimento em dois turnos. São amostradas doze garrafas de cada enchedora em cada turno (72 no total), e o peso de enchimento (g) e a resistência da vedação da tampa (N) de cada garrafa são medidos. O supervisor seleciona Variables = Fill Weight g e Seal Strength N, For rows = Filler e For columns = Shift, e mantém as estatísticas padrão.
A resistência da vedação é menor no turno da noite (Night) para todas as enchedoras: médias de 40.75, 38.93 e 38.66 N à noite contra 43.01, 43.38 e 43.23 N de dia. O padrão é o mesmo nas três máquinas, o que aponta para algo no turno (equipe, lote de tampas, ajuste de torque) e não para uma máquina isolada. O peso de enchimento conta outra história: a Filler 2 no turno da noite (Night) opera mais pesada (média de 503.22 g) e é a mais variável (desvio padrão de 1.99 g, amplitude de 499.2 a 506.2 g), enquanto a Filler 3 opera mais leve nos dois turnos (499.67 e 499.61 g).
Para uma visão por turno, definir For rows = Shift sem variável de coluna e marcar First quartile e Third quartile dá médias de resistência da vedação de 43.21 N de dia e 39.44 N à noite, com a metade central das garrafas da noite entre 37.15 e 41.18 N. A tabela mostra onde olhar; para verificar se as diferenças de turno e de enchedora são maiores que o acaso, o supervisor executa uma ANOVA de dois fatores em Seal Strength N, com Filler e Shift como fatores.
Perguntas frequentes
Quando usar tabelas de estatística descritiva?
Use-as para colocar muitos subgrupos lado a lado antes de decidir onde aprofundar a análise, por exemplo, pesos de enchimento por enchedora e turno, tempos de ciclo por linha e produto, ou resultados de ensaio por fornecedor e lote. Uma variável de agrupamento fica ao longo do lado da tabela e uma segunda pode ficar na parte superior.
Como os quartis são calculados?
O primeiro e o terceiro quartis são os percentis 25 e 75, obtidos por interpolação linear entre os valores ordenados na posição 1 + (N − 1)·p, de modo que podem diferir ligeiramente de softwares que usam a regra (N + 1)·p. Com grupos pequenos, de menos de cerca de 10 valores, o desvio padrão e os quartis são aproximados; portanto, interprete-os com cuidado.
Uma tabela de estatística descritiva testa se os grupos diferem?
Não. Ela descreve os dados, mas não testa se as diferenças são reais. No exemplo prático, a tabela mostrou menor resistência da vedação no turno da noite para as três enchedoras; para verificar se as diferenças de turno e de enchedora eram maiores que o acaso, o supervisor executou uma ANOVA de dois fatores.
Como configurar a tabela no Zometric Statistical Software?
Selecione uma ou mais Variables numéricas, opcionalmente uma coluna For rows e uma coluna For columns, e marque as estatísticas a mostrar. N, Mean, Standard deviation, Minimum, Median e Maximum vêm marcadas por padrão, e pelo menos uma deve estar marcada. O desvio padrão usa o divisor N − 1, e os valores ausentes ficam de fora.