
Análise discriminante (LDA/QDA)
Forneça itens com grupo conhecido e preditores numéricos. A análise discriminante linear pressupõe preditores normais multivariados com matriz de covariância comum; a quadrática admite uma por grupo. As probabilidades a priori podem ser iguais, proporcionais ou definidas pelo usuário. A saída inclui matrizes de confusão, acurácia geral e por validação cruzada leave-one-out e funções de classificação lineares para pontuar novos itens. Use-a para verificar se uma classe pode ser distinguida pelos dados de inspeção.
Última revisão
Conclusão principal
A análise discriminante constrói uma regra que atribui itens a grupos conhecidos a partir de valores medidos, encontrando a combinação de medições que melhor separa os grupos e informando quantos itens ela classifica corretamente.
Nesta página
Finalidade
A Discriminant Analysis constrói uma regra que atribui itens a grupos conhecidos a partir de valores medidos. Você fornece itens cujo grupo é conhecido (por exemplo, lotes Standard e Premium, peças boas e ruins, ou fornecedores) e as medições feitas neles; ela encontra a combinação de medições que melhor separa os grupos e mostra quantos itens a regra classifica corretamente. Use-a para verificar se uma classe ou um tipo pode ser distinguido pelos dados de inspeção, ou para construir uma regra para classificar novos itens.
Principais recursos
- Funções discriminantes lineares ou quadráticas para dois ou mais grupos.
- Probabilidades a priori iguais para todos os grupos, proporcionais aos tamanhos dos grupos ou definidas por você.
- Matriz de confusão do grupo real contra o grupo previsto, com a porcentagem geral classificada corretamente.
- Validação cruzada leave-one-out para uma estimativa mais justa de como a regra funcionará em novos itens.
- Funções de classificação lineares (constante e um coeficiente por preditor para cada grupo) para pontuar novos itens.
Métodos estatísticos
As linhas com grupo ausente ou com preditor ausente ou não numérico são descartadas. A resposta é tratada como um rótulo de texto, e os grupos são listados em ordem alfabética ou numérica. Deve haver ao menos 2 grupos e mais linhas do que o número de preditores mais o número de grupos.
A análise discriminante linear pressupõe que os preditores seguem uma distribuição normal multivariada em cada grupo, com a mesma matriz de covariância. Ela estima a média de cada grupo x̄g e uma matriz de covariância combinada dentro dos grupos S, e atribui a cada grupo uma pontuação Lg(x) = x̄gᵀ S⁻¹ x − ½ x̄gᵀ S⁻¹ x̄g + ln(pg), em que pg é a probabilidade a priori do grupo. Um item é atribuído ao grupo com a maior pontuação. A tabela Linear Discriminant (Classification) Functions lista, para cada grupo, a constante (−½ x̄gᵀ S⁻¹ x̄g + ln pg) e os coeficientes S⁻¹ x̄g. A análise discriminante quadrática abandona a premissa de covariâncias iguais e estima uma matriz de covariância separada para cada grupo, gerando fronteiras curvas; ela exige mais dados por grupo e não tem funções de classificação simples.
As probabilidades a priori são 1/k para k grupos por padrão. As priors proporcionais usam a parcela de cada grupo nos dados, o que favorece os grupos maiores. A acurácia de ressubstituição classifica os mesmos itens a partir dos quais a regra foi construída e é otimista. A validação cruzada leave-one-out remove cada item em sequência, constrói a regra com os restantes e classifica o item removido, de modo que é um guia melhor para a acurácia em novos itens.
Campos de entrada e opções
Campo | Descrição |
Response (grouping variable) | Obrigatório. Coluna categórica com o grupo conhecido de cada item. |
Predictors | Uma ou mais colunas numéricas usadas para separar os grupos. |
Discriminant function | Linear (padrão; matriz de covariância comum) ou Quadratic (uma matriz de covariância por grupo). |
Prior probabilities | All groups equal (padrão), Proportional to group sizes in the data ou User-specified. |
Custom priors | Usado somente quando Prior probabilities é User-specified. Um valor por grupo, separados por vírgula ou espaço, na ordem alfabética ou numérica dos grupos; todos positivos e somando 1, ex.: 0.2, 0.5, 0.3. |
Cross-validate (leave-one-out) | Marcado por padrão. Adiciona a acurácia por validação cruzada e a matriz de confusão correspondente. |
Title | Título da análise. Padrão Discriminant Analysis. |
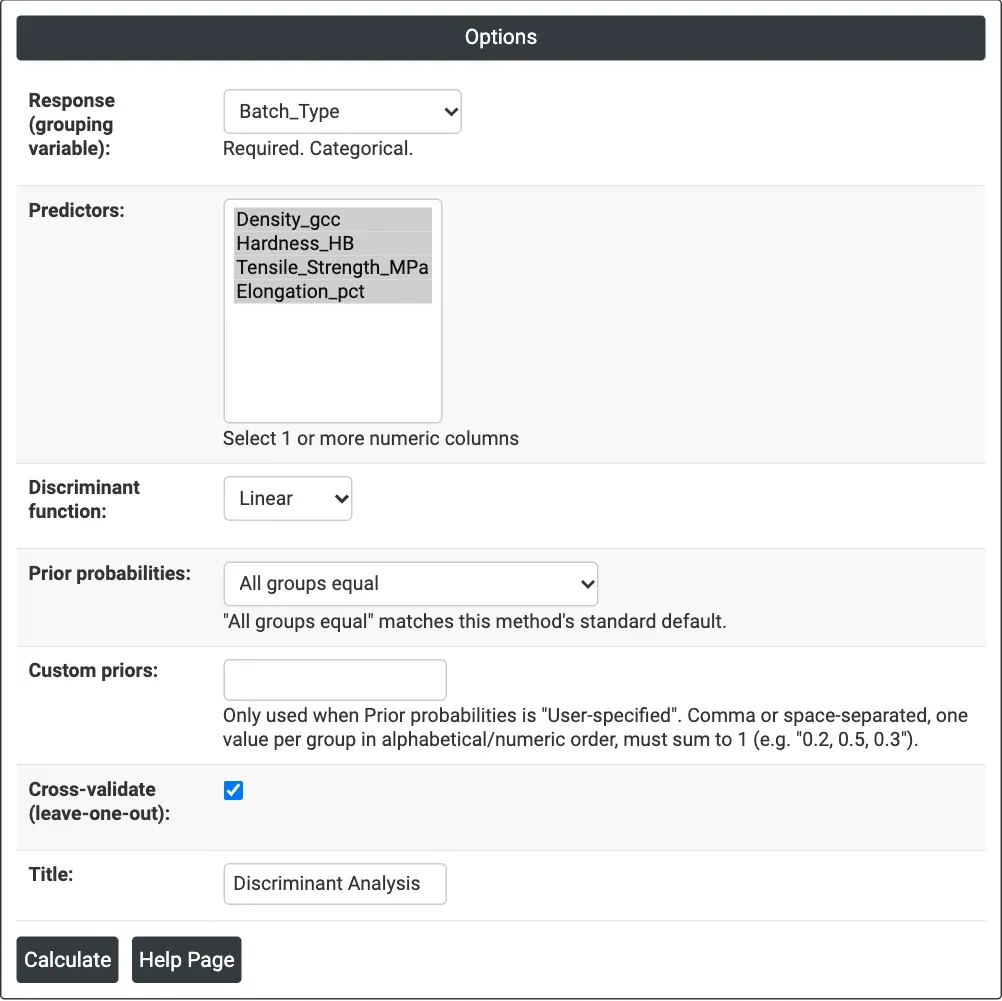
Figura 1 — Opções para o exemplo: Batch_Type como resposta, quatro colunas de propriedades como preditores, função linear, priors iguais, validação cruzada leave-one-out.
Descrição da saída
- Summary line — N usado, acurácia de ressubstituição e, quando marcada, acurácia por validação cruzada (leave-one-out).
- Prior Probabilities — a prior usada para cada grupo.
- Confusion Matrix (Resubstitution) — grupo real nas linhas, grupo previsto nas colunas.
- Confusion Matrix (Cross-Validated) — o mesmo com as previsões leave-one-out.
- Linear Discriminant (Classification) Functions — somente para função linear: a constante e o coeficiente de cada preditor para cada grupo. Um novo item vai para o grupo cuja função dá o maior valor.
- Exportação em PDF por meio de Download.
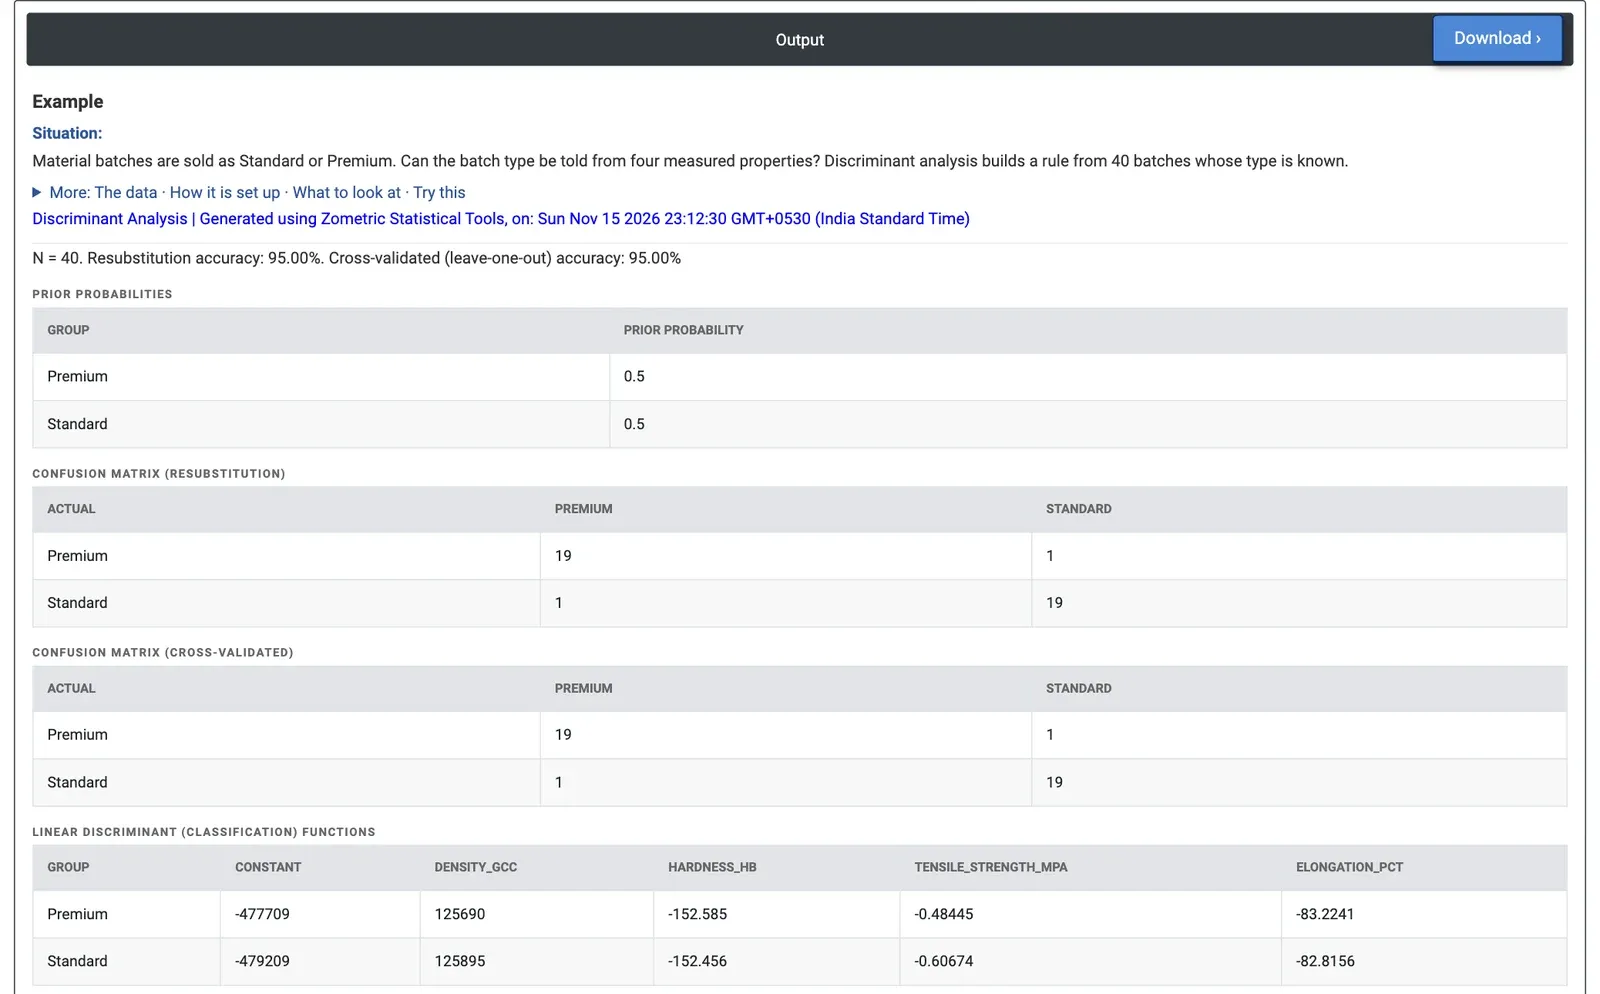
Figura 2 — Resultados para 40 lotes: 95% classificados corretamente, tanto nos dados quanto com validação cruzada leave-one-out; um lote de cada tipo é classificado incorretamente.
Exemplo prático
Uma fábrica de materiais vende lotes como Standard ou Premium. O engenheiro da qualidade quer saber se o tipo do lote pode ser distinguido por quatro medições de rotina: densidade (g/cc), dureza (HB), resistência à tração (MPa) e alongamento (%). O engenheiro usa 40 lotes cujo tipo é conhecido, 20 de cada, e define Response (grouping variable) = Batch_Type, as quatro propriedades como Predictors, Discriminant function = Linear, Prior probabilities = All groups equal e Cross-validate marcado.
A regra classifica corretamente 38 dos 40 lotes: 95.00% nos dados e 95.00% com validação cruzada leave-one-out, portanto ela não está apenas se ajustando aos 40 lotes com os quais foi construída. Em cada tipo, 19 de 20 estão corretos. Os dois lotes classificados incorretamente são a linha 3 (Standard, 197.4 HB, 1,210.8 MPa) e a linha 27 (Premium, 202.3 HB, 1,209.7 MPa): eles ficam entre as médias dos grupos (Premium 212.9 HB e 1,253.6 MPa, Standard 180.1 HB e 1,126.2 MPa) e vale a pena verificá-los. As funções de classificação dão a cada novo lote uma pontuação Premium e uma pontuação Standard a partir de suas quatro medições, e o lote é atribuído ao tipo com a maior pontuação.
A densidade importa mais do que sua pequena dispersão sugere: a média Premium é 7.878 g/cc contra 7.850 para Standard, e, com a densidade removida dos preditores, a acurácia cai para 82.5% (75.0% por validação cruzada). Uma função quadrática se sai pior aqui, com 92.5% nos dados e 85.0% por validação cruzada, porque estima mais parâmetros a partir de apenas 20 lotes por grupo. Para o engenheiro, a regra linear com as quatro propriedades é boa o suficiente para sinalizar lotes cujo rótulo não corresponde às suas medições. Em comparação com o agrupamento dos mesmos dados sem os rótulos (o Cluster K-Means coincide com os tipos em 28 de 40), conhecer os grupos dá uma separação muito mais clara.
Perguntas frequentes
Qual é a diferença entre análise discriminante linear e quadrática?
A análise discriminante linear pressupõe que os preditores são normais multivariados em cada grupo, com a mesma matriz de covariância, e fornece funções de classificação lineares. A análise discriminante quadrática estima uma matriz de covariância separada para cada grupo, gerando fronteiras curvas, mas exige mais dados por grupo e não tem funções de classificação simples. No exemplo, a quadrática se saiu pior, com apenas 20 lotes por grupo.
Por que usar a validação cruzada leave-one-out?
A acurácia de ressubstituição classifica os mesmos itens a partir dos quais a regra foi construída, portanto é otimista. A validação cruzada leave-one-out remove cada item em sequência, constrói a regra com os restantes e classifica o item removido, o que dá um guia melhor para a acurácia em novos itens. No exemplo, ambas foram de 95%, de modo que a regra não estava apenas se ajustando aos seus próprios dados.
Como as probabilidades a priori afetam a análise discriminante?
Por padrão, cada um dos k grupos recebe uma prior de 1/k. As priors proporcionais usam a parcela de cada grupo nos dados, o que favorece os grupos maiores. As priors definidas pelo usuário devem ser positivas, informadas uma por grupo na ordem alfabética ou numérica dos grupos, e somar 1. A prior entra na pontuação de cada grupo pelo logaritmo natural da prior.
Como classificar um novo item com a análise discriminante?
Para uma função discriminante linear, o Zometric Statistical Software lista uma constante e um coeficiente por preditor para cada grupo na tabela Linear Discriminant (Classification) Functions. Calcule a pontuação do novo item com a função de cada grupo e atribua-o ao grupo cuja função dá o maior valor.