
CDF empírica
A CDF empírica ordena os valores e plota cada um em (i − 0.5) / n, como percentual, unidos em degraus. Use-a para comparar grupos além de suas médias, ler a parcela de peças abaixo de um limite ou verificar os dados em relação a uma distribuição ajustada, como a Normal ou a Weibull. Uma coluna By gera uma curva por grupo, e várias variáveis podem ser sobrepostas.
Última revisão
Conclusão principal
Uma CDF empírica plota, para cada valor de uma medição, o percentual de observações iguais ou inferiores a ele em uma curva em degraus, mostrando de uma só vez a mediana, a dispersão, as caudas e as lacunas de toda a distribuição.
Nesta página
Finalidade
A CDF empírica plota, para cada valor de uma medição, o percentual de observações iguais ou inferiores a ele. O resultado é uma curva em degraus que mostra toda a distribuição de uma vez: a mediana, a dispersão, as caudas e eventuais lacunas. Use-a para comparar dois ou mais grupos (máquinas, fornecedores, configurações) além de suas médias, para ler a parcela de peças abaixo de um limite ou para verificar os dados em relação a uma distribuição ajustada.
Principais recursos
- Uma curva em degraus por variável, ou por grupo de uma variável quando se escolhe uma coluna By.
- Várias variáveis sobrepostas em um só gráfico para uma comparação direta.
- Distribuição ajustada opcional sobreposta como uma linha tracejada: Normal, Lognormal, Weibull, Exponential, 2-Parameter Exponential, Smallest ou Largest Extreme Value, Logistic ou Loglogistic.
- Escala percentual de 0 a 100 no eixo vertical, de modo que os percentis podem ser lidos diretamente na curva.
- As linhas podem ser excluídas ou mantidas por número da linha ou por uma condição antes de plotar.
Métodos estatísticos
Para cada curva, os valores numéricos não vazios são ordenados, x₁ ≤ x₂ ≤ … ≤ xₙ, e o i-ésimo valor é plotado na posição de plotagem pᵢ = (i − 0.5) / n, exibida como percentual. Os pontos são unidos em degraus (horizontal e depois vertical), de modo que a curva sobe 100/n por cento a cada observação. O valor em que uma curva cruza 50% é a mediana desse grupo; onde cruza 90%, é o 90º percentil.
Com uma coluna By e uma única variável, as linhas são divididas pelos níveis da coluna By e cada nível recebe a sua própria curva. Com várias variáveis, cada variável recebe uma curva e a coluna By é ignorada.
Quando se escolhe uma distribuição ajustada, seus parâmetros são estimados separadamente para cada curva (cada grupo ou cada variável), como no Minitab, e cada CDF ajustada é desenhada na faixa dos seus próprios dados. A Normal usa a média e o desvio padrão da amostra; as demais distribuições usam máxima verossimilhança (Lognormal, Weibull, Exponential e Loglogistic com o limiar fixado em 0, de modo que exigem valores positivos). A legenda mostra os parâmetros ajustados de cada curva, de modo que cada grupo pode ser verificado em relação ao seu próprio modelo.
Campos de entrada e opções
Campo | Descrição |
Variables | Uma ou mais colunas numéricas. Selecione uma variável, ou várias para sobrepor as suas curvas. |
By (grouping) column | Opcional. Uma curva por nível dessa coluna. Usada apenas quando uma única variável é selecionada. |
Overlay fitted distribution | Padrão “--- (empirical only)”: sem linha ajustada. Ou uma entre Normal, Lognormal, Weibull, Exponential, 2-Parameter Exponential, Smallest Extreme Value, Largest Extreme Value, Logistic, Loglogistic. |
Title | Título do gráfico. O padrão é “Empirical CDF”. |
Data Options: Subset (optional) | Exclude matching rows (padrão) ou Include only matching rows; Row numbers (ex.: 3,7,12-15) e/ou uma Condition (ex.: Weight_kg > 100) selecionam as linhas. Não tem efeito quando ambos estão em branco. |
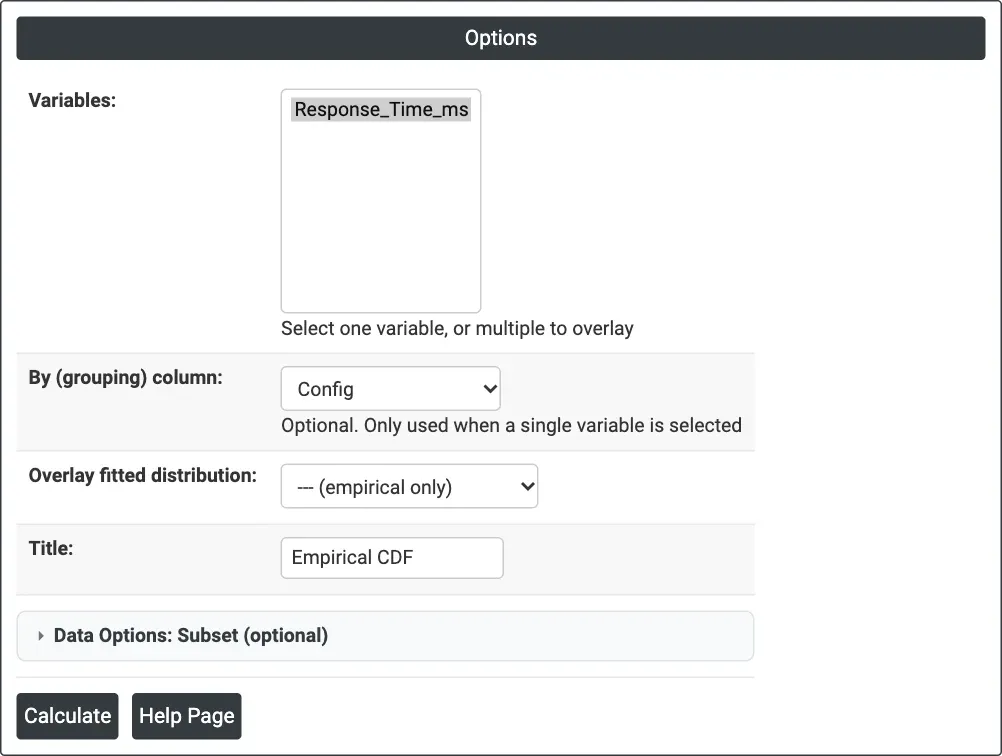
Figura 1 — Opções do exemplo: Variables = Response_Time_ms, By (grouping) column = Config, sem distribuição ajustada.
Descrição da saída
- Empirical CDF — curva em degraus do percentual contra a variável para cada grupo ou variável, com marcadores em cada observação e uma legenda que nomeia as curvas; a distribuição ajustada, se escolhida, é uma linha tracejada para cada curva, na cor da curva (preta quando há apenas uma curva), identificada com seus parâmetros.
- Exportação em PDF por meio de Download.
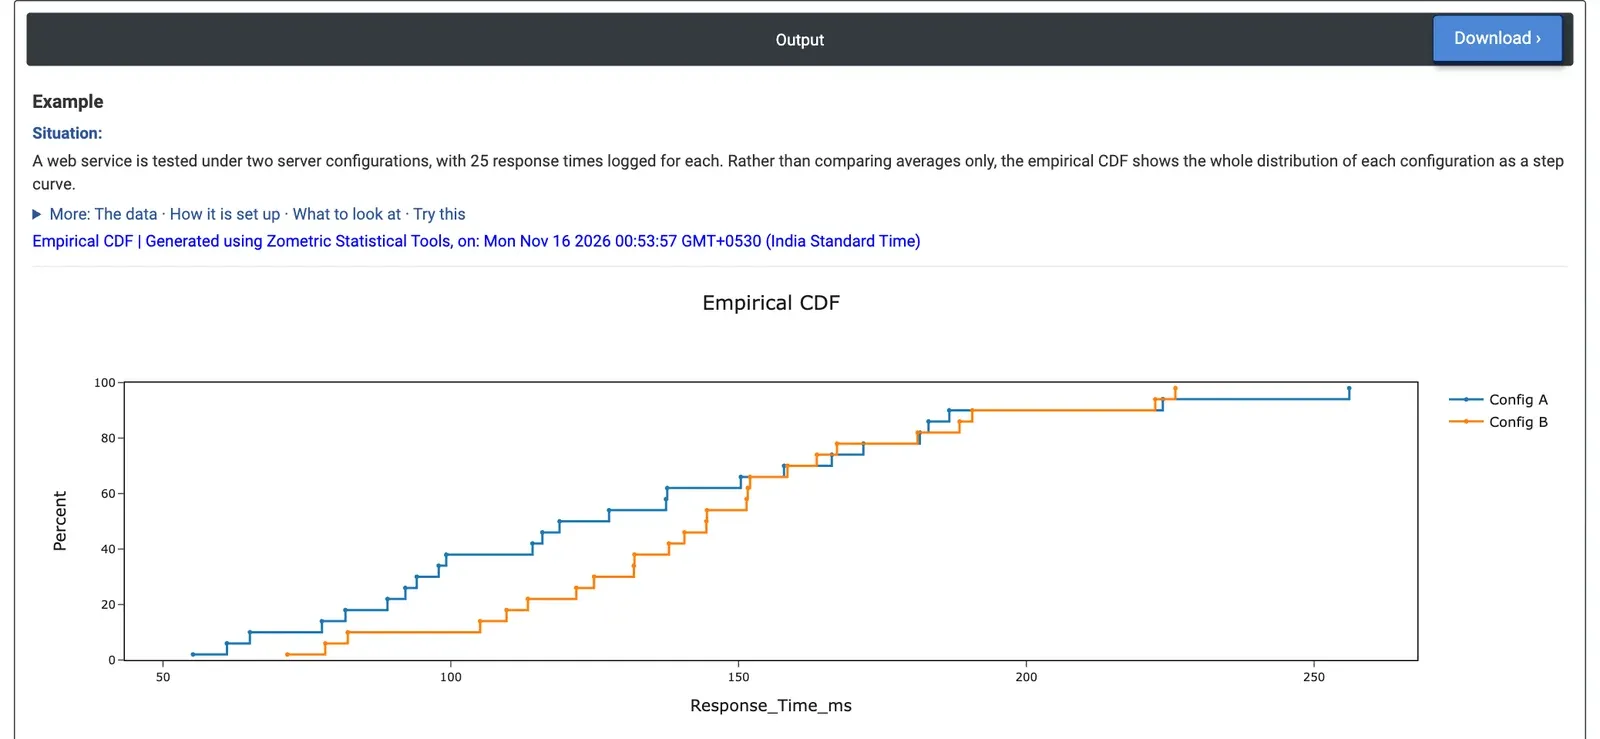
Figura 2 — CDF empírica do tempo de resposta para Config A (azul) e Config B (laranja), 25 requisições cada.
Exemplo prático
Uma equipe de TI testa um serviço web sob duas configurações de servidor e registra 25 tempos de resposta (ms) para cada uma. As médias sozinhas (129.7 ms para A, 143.6 ms para B) sugerem que A é mais rápida, mas a equipe quer saber como se compara a distribuição inteira, sobretudo as requisições lentas que os usuários percebem. Ela seleciona Response_Time_ms como a variável e Config como a coluna By, sem distribuição ajustada.
Lendo a 50%, a mediana é 118.9 ms para a Config A e 144.4 ms para a Config B: em quase toda a faixa, a curva de B fica à direita, de modo que uma requisição típica é mais lenta em B. A 150 ms, 64% das requisições de A estão concluídas, contra 56% das de B. No topo, as curvas se cruzam: a requisição mais lenta de A leva 256.1 ms, contra 225.9 ms da mais lenta de B, e a dispersão de A é maior (desvio padrão de 51.8, contra 39.7 ms). Ambas as configurações têm 92% das requisições em até 200 ms. Portanto, B é mais lenta em uma requisição típica, enquanto A tem a cauda mais longa; a escolha depende de o que importa mais para o serviço, a mediana ou o pior caso.
Escolher Normal como sobreposição adiciona uma curva normal tracejada para cada configuração, ajustada aos seus próprios 25 valores: média de 129.7 ms e desvio padrão de 51.8 ms para A, média de 143.6 ms e desvio padrão de 39.7 ms para B. Onde uma curva em degraus se afasta da sua curva tracejada, os tempos de resposta dessa configuração não são normais.
Perguntas frequentes
Como ler uma CDF empírica?
A curva sobe 100/n por cento a cada observação. Leia a 50% para achar a mediana de cada grupo e a 90% para o 90º percentil, ou leia para cima a partir de um limite para ver a parcela de valores abaixo dele. No exemplo prático, a mediana do tempo de resposta foi 118.9 ms para a Config A e 144.4 ms para a Config B.
Por que comparar grupos com uma CDF empírica em vez de médias?
As médias escondem diferenças de dispersão e de caudas. No exemplo prático, a Config A teve a menor média e a menor mediana do tempo de resposta, mas as curvas se cruzaram no topo: a requisição mais lenta de A levou 256.1 ms, contra 225.9 ms da mais lenta de B. A CDF mostra se o que difere é o caso típico ou o pior caso.
Como verificar os dados em relação a uma distribuição ajustada?
Escolha uma distribuição para sobrepor, como Normal, Lognormal, Weibull, Exponential, Logistic ou uma distribuição de valor extremo. Seus parâmetros são estimados separadamente para cada curva e desenhados como uma linha tracejada. Onde uma curva em degraus se afasta da sua curva tracejada, os dados não seguem essa distribuição. Lognormal, Weibull, Exponential e Loglogistic exigem valores positivos.
Como comparar grupos no Zometric Statistical Software?
Selecione uma única variável e uma By (grouping) column para obter uma curva em degraus por nível, ou selecione várias variáveis para sobrepor as suas curvas; nesse caso, a coluna By é ignorada. As linhas podem ser excluídas ou mantidas por número da linha ou por uma condição antes de plotar, usando Data Options.