
Modelo de efeitos mistos (Fit Mixed Effects Model)
Fit Mixed Effects Model testa fatores categóricos fixos e covariáveis enquanto estima componentes de variância de fatores aleatórios, como lotes, operadores ou dias. Use-o quando ignorar os fatores aleatórios tornaria os testes dos fatores fixos otimistas demais. Todo fator aleatório precisa de pelo menos 3 níveis. A saída inclui componentes de variância, testes F com graus de liberdade de Satterthwaite, coeficientes e um resumo do modelo com AICc e BIC.
Última revisão
Conclusão principal
Um modelo de efeitos mistos analisa uma resposta que depende de fatores fixos, cujos níveis você compara, e de fatores aleatórios amostrados de uma população, testando os fatores fixos e estimando a variância aleatória.
Nesta página
Finalidade
Fit Mixed Effects Model analisa uma resposta que depende de dois tipos de fator: fatores fixos, cujos níveis específicos você quer comparar (duas máquinas, três fornecedores, um método novo e um antigo), e fatores aleatórios, cujos níveis são uma amostra de uma população maior (lotes, amostras, operadores, dias). Ele testa os fatores fixos e estima quanta variância cada fator aleatório acrescenta. Use-o quando ignorar os fatores aleatórios tornaria os testes dos fatores fixos otimistas demais, por exemplo quando os mesmos lotes ou peças são medidos em todas as condições.
Principais recursos
- Um ou mais fatores categóricos fixos e covariáveis contínuas, com um ou mais fatores aleatórios.
- Componentes de variância de cada fator aleatório e do erro, com % do total, erro padrão, teste Z e intervalo de confiança.
- Testes F dos efeitos fixos com graus de liberdade do denominador de Satterthwaite.
- Coeficientes com graus de liberdade de Satterthwaite, testes t e intervalos de confiança.
- Resumo do modelo com S, R-sq, R-sq(adj), AICc, BIC e −2 log da verossimilhança.
- Estimação por máxima verossimilhança restrita (REML) ou por máxima verossimilhança (ML).
- Data Options: selecione um subconjunto das linhas antes da análise.
Métodos estatísticos
O modelo é y = Xβ + Σ Zᵢuᵢ + ε, em que Xβ contém os fatores fixos (codificação de soma zero −1/0/+1) e as covariáveis, cada fator aleatório i acrescenta efeitos independentes uᵢ com variância σᵢ², e os erros ε têm variância σ². Os fatores aleatórios são componentes de variância independentes (nenhuma interação é ajustada). As variâncias são estimadas por REML (padrão), que considera os graus de liberdade usados pelos efeitos fixos e fornece componentes de variância quase não viesados, ou por ML, necessária para comparar modelos com efeitos fixos diferentes por AICc ou BIC. As linhas com valor ausente são descartadas; todo fator aleatório precisa de pelo menos 3 níveis.
Dadas as estimativas de variância, os coeficientes fixos são estimativas de mínimos quadrados generalizados. Cada termo fixo é testado com uma estatística F cujos graus de liberdade do denominador vêm da aproximação de Satterthwaite, e cada coeficiente com um teste t com graus de liberdade de Satterthwaite. Os componentes de variância têm erros padrão obtidos da informação de Fisher, um teste Z unilateral Z = Var / SE Var de que o componente é zero e um intervalo de confiança calculado na escala logarítmica, de modo que nunca é negativo. Com poucos níveis de um fator aleatório, esse teste Z tem pouco poder e o intervalo é largo.
O R-sq compara os ajustes condicionais (efeitos fixos mais efeitos aleatórios previstos) com a variação total. S é a raiz quadrada da variância do erro. AICc e BIC são menores para modelos melhores; com REML, eles só comparam modelos que têm os mesmos efeitos fixos.
Campos de entrada e opções
Campo | Descrição |
Response (Y) | Coluna numérica da resposta. Obrigatório. |
Fixed factors (categorical) | Uma ou mais colunas cujos níveis específicos são de interesse direto. Obrigatório. |
Random factors (categorical) | Uma ou mais colunas cujos níveis são uma amostra aleatória de uma população maior (ex.: Field, Batch, Operator), modeladas como componentes de variância independentes. Obrigatório. |
Covariates (continuous) | Colunas numéricas opcionais, incluídas apenas como efeitos principais fixos. |
Confidence level | Padrão 95. |
Estimation method | Restricted maximum likelihood (REML), o padrão, ou Maximum likelihood (ML). |
Data Options: Subset (optional) | Exclude matching rows (padrão) ou Include only matching rows, por números de linha e/ou uma condição. |
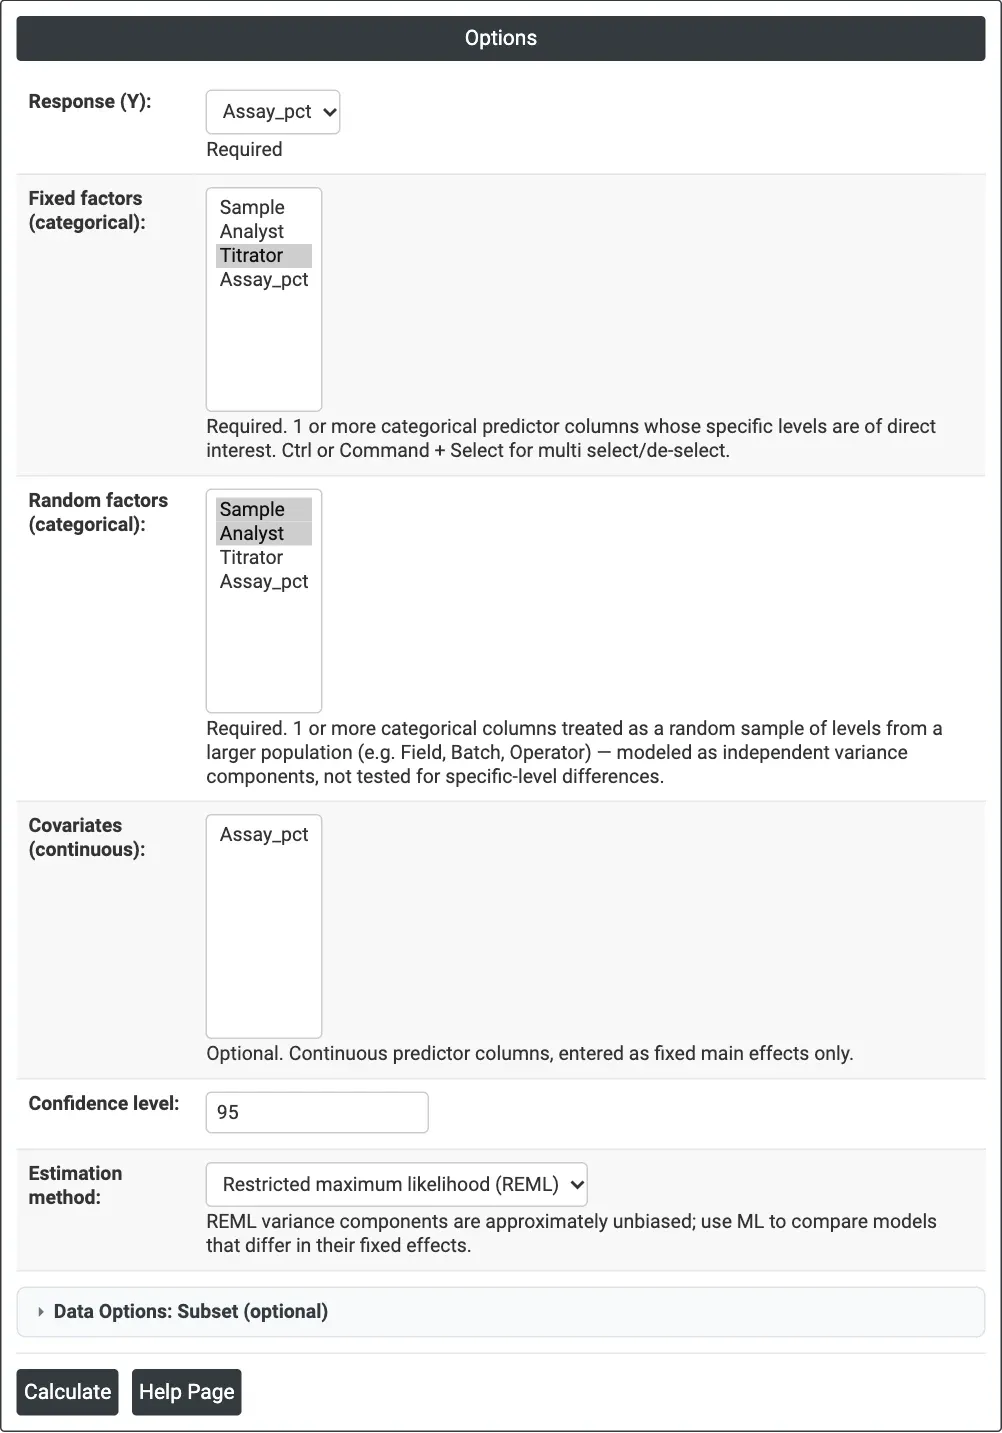
Figura 1 — Opções do exemplo dos tituladores: Assay_pct como resposta, Titrator como fator fixo, Sample e Analyst como fatores aleatórios, REML.
Descrição da saída
- Method — o método de estimação da variância e o método dos graus de liberdade para os efeitos fixos.
- Variance Components — Var, % of Total, SE Var, Z-Value, P-Value e intervalo de confiança de cada fator aleatório, do erro e do total.
- Tests of Fixed Effects — DF Num, DF Den, F-Value e P-Value de cada fator fixo e covariável.
- Model Summary — S, R-sq, R-sq(adj), AICc, BIC e −2 log da verossimilhança.
- Coefficients — Coef, SE Coef, DF, T-Value, P-Value e intervalo de confiança.
- Um aviso é exibido se o otimizador não convergiu totalmente.
- Exportação em PDF por meio de Download.
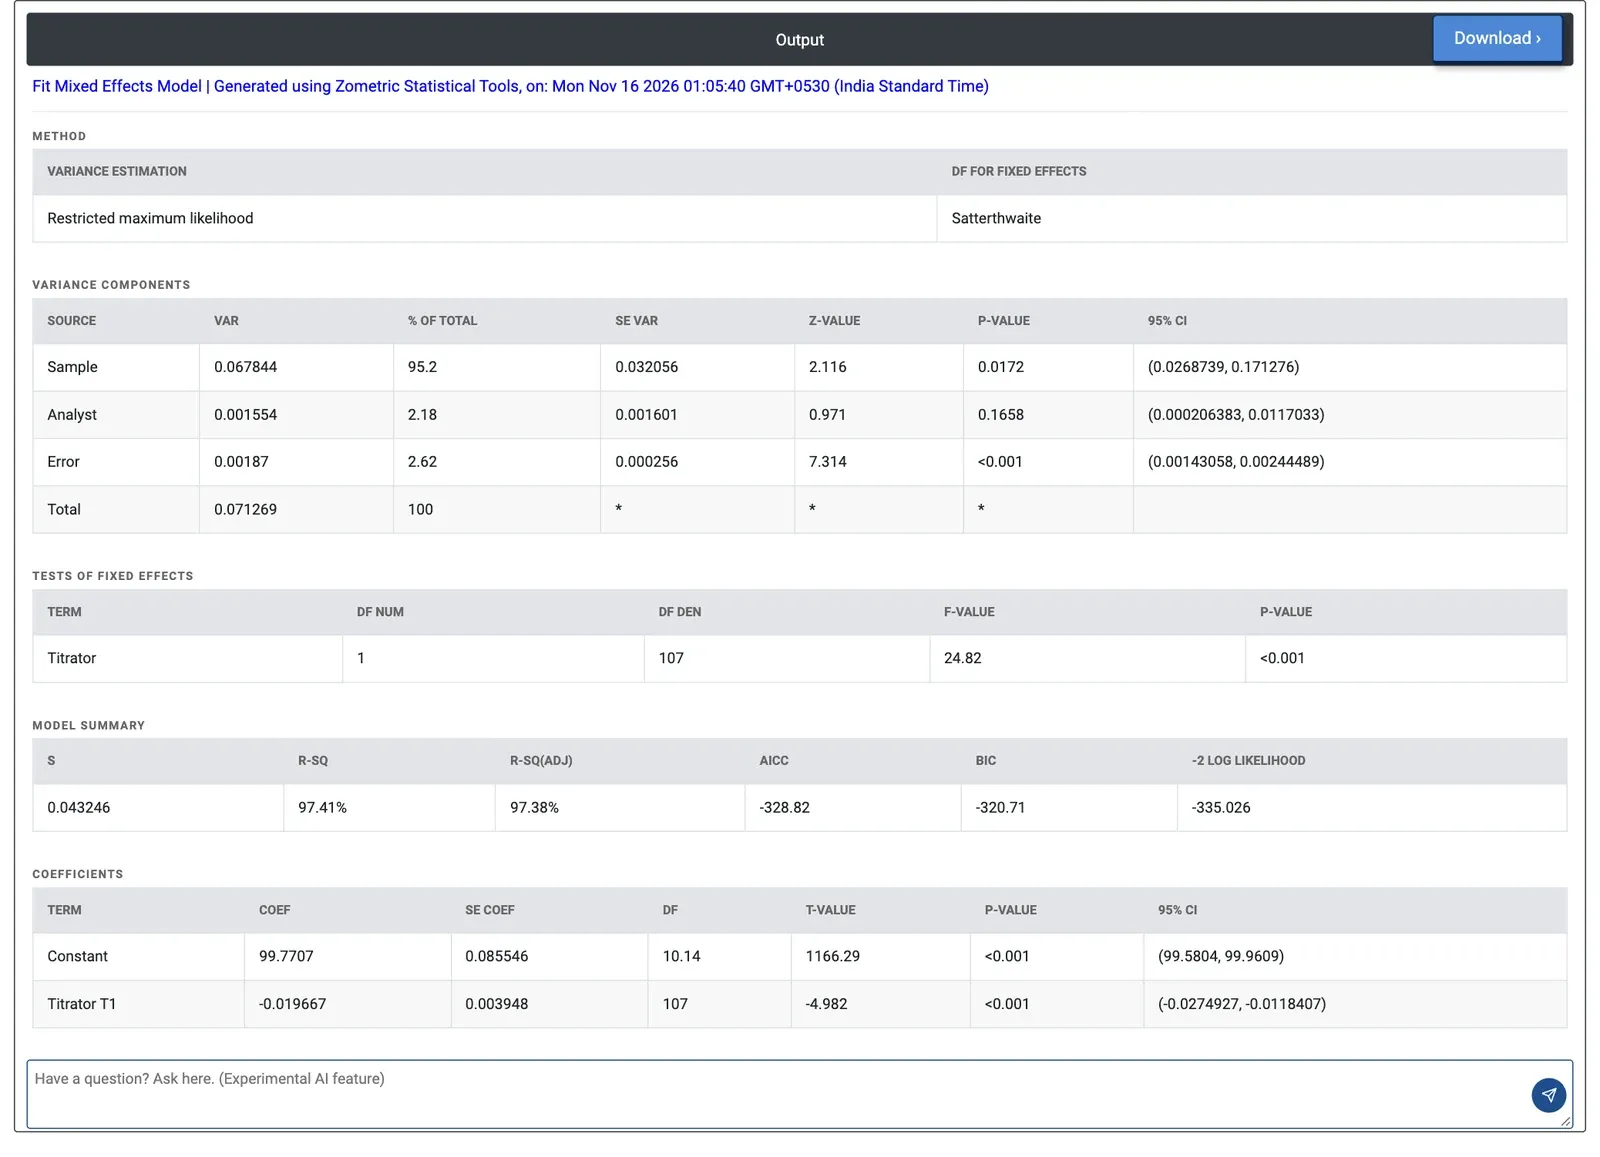
Figura 2 — Modelo misto dos resultados do ensaio: as amostras respondem por 95.2% da variância e os dois tituladores diferem (F = 24.82, p < 0.001).
Exemplo prático
Um laboratório de barrilha mede a pureza do produto (Assay_pct) em dois tituladores automáticos, T1 e T2. Dez amostras são medidas duas vezes cada por três analistas nos dois tituladores: 120 resultados. A questão é se os dois tituladores dão o mesmo resultado. Os tituladores são os dois instrumentos que o laboratório possui; portanto, Titrator é um fator fixo; as amostras e os analistas representam muitas amostras e analistas possíveis; portanto, são fatores aleatórios. O laboratório informa Assay_pct como resposta, Titrator como fator fixo e Sample e Analyst como fatores aleatórios, com REML. Load Example preenche esses dados (soda-ash-assay-expanded-grr, o mesmo estudo do exemplo de Gage R&R Study (Expanded)) e essas configurações.
Os componentes de variância mostram que as próprias amostras diferem mais: 0.0678 (95.2% do total, desvio padrão de cerca de 0.26 ponto percentual). O componente dos analistas é pequeno, 0.00155 (2.18%), e não difere significativamente de zero (p = 0.1658); o erro, a repetibilidade de um único resultado, é 0.00187 (desvio padrão 0.043).
Titrator é significativo: F = 24.82 com 1 e 107 graus de liberdade, p < 0.001. O coeficiente de T1 é −0.0197 com codificação de soma zero; portanto, T2 indica cerca de 0.039 ponto percentual a mais que T1, próximo de um desvio padrão de repetibilidade. Como cada amostra foi medida nos dois tituladores, a dispersão entre amostras não esconde essa diferença. O laboratório decide verificar a calibração dos dois tituladores com um padrão de referência.
Perguntas frequentes
Qual é a diferença entre um fator fixo e um fator aleatório?
Um fator fixo tem níveis específicos que você quer comparar, como duas máquinas, três fornecedores ou um método novo e um antigo. Um fator aleatório tem níveis que são uma amostra de uma população maior, como lotes, amostras, operadores ou dias. Um modelo de efeitos mistos testa os fatores fixos e estima quanta variância cada fator aleatório acrescenta.
Quando usar um modelo de efeitos mistos?
Use um modelo de efeitos mistos quando ignorar os fatores aleatórios tornaria os testes dos fatores fixos otimistas demais, por exemplo quando os mesmos lotes ou peças são medidos em todas as condições. No exemplo dos tituladores, dez amostras foram medidas nos dois tituladores; assim, a dispersão entre amostras não escondeu a diferença entre os tituladores.
Usar estimação por REML ou por ML em um modelo misto?
A REML, o padrão, considera os graus de liberdade usados pelos efeitos fixos e fornece componentes de variância quase não viesados. A ML é necessária para comparar modelos com efeitos fixos diferentes por AICc ou BIC. Com REML, AICc e BIC só comparam modelos que têm os mesmos efeitos fixos.
Como interpretar a tabela de componentes de variância?
Cada fator aleatório e o erro têm uma variância, sua porcentagem do total, um erro padrão, um teste Z unilateral de que o componente é zero e um intervalo de confiança calculado na escala logarítmica, de modo que nunca é negativo. Com poucos níveis de um fator aleatório, o teste Z tem pouco poder e o intervalo é largo.