
Ajustar modelo de regressão (Fit Regression Model)
O Fit Regression Model ajusta uma equação de regressão para uma resposta contínua usando vários preditores contínuos e categóricos. Use-o para previsão, análise de relações e projeção; respostas categóricas exigem regressão logística. Colete dados representativos e precisos, verifique a multicolinearidade com o VIF e valide com gráficos de resíduos. Os testes usam somas de quadrados Adjusted (Tipo III, o padrão) ou Sequential (Tipo I), com intervalos de confiança de 95% por padrão.
Última revisão
Conclusão principal
O Fit Regression Model constrói uma equação que quantifica como um ou mais preditores contínuos ou categóricos influenciam uma resposta contínua, permitindo identificar as variáveis significativas e prever resultados.
Nesta página
O que é o Fit Regression Model?
O Fit Regression Model é uma ferramenta estatística usada para examinar e quantificar a relação entre uma ou mais variáveis preditoras e uma variável resposta contínua. Diferentemente do Fit Line Model, que trata apenas um único preditor, o Fit Regression Model aceita vários preditores, contínuos e categóricos, o que o torna mais versátil na análise de dados do mundo real.
Ele constrói, a partir dos seus dados, uma equação matemática que melhor descreve como os preditores influenciam, em conjunto, a resposta. Essa equação pode então ser usada para entender padrões, identificar variáveis significativas e prever resultados futuros.
Definição simples: Uma ferramenta que encontra a melhor relação matemática entre várias variáveis de entrada e uma variável de saída, para que você entenda tendências e faça previsões precisas.
Quando usar o Fit Regression Model?
Um modelo de regressão ajustado costuma ser usado quando é preciso analisar a relação entre uma ou mais variáveis independentes e uma variável dependente. É uma ferramenta útil para prever e entender o comportamento de uma variável dependente com base nos valores das variáveis independentes.
Estes são alguns cenários comuns em que um modelo de regressão ajustado pode ser útil:
- Modelagem preditiva: Se você quer prever o valor de uma variável dependente com base nos valores de uma ou mais variáveis independentes, um modelo de regressão ajustado pode ser útil. Por exemplo, você pode querer prever as vendas de um produto com base em fatores como preço, publicidade e perfil demográfico dos clientes.
- Análise de relações: Se você quer entender a relação entre uma variável dependente e uma ou mais variáveis independentes, um modelo de regressão ajustado pode ajudar. Por exemplo, você pode querer entender a relação entre renda e nível de escolaridade, ou entre hábitos de exercício e resultados de saúde.
- Projeção: Se você quer projetar valores futuros de uma variável dependente com base em dados históricos, um modelo de regressão ajustado pode ser útil. Por exemplo, você pode querer projetar as vendas futuras com base em dados históricos de vendas e em outras variáveis, como indicadores econômicos e tendências sazonais.
- Os preditores podem ser contínuos, categóricos ou uma combinação de ambos.
- Variáveis discretas podem ser tratadas como contínuas ou categóricas, dependendo do número de níveis e da finalidade da análise.
- A variável resposta deve ser contínua.
- É improvável que uma resposta categórica atenda às premissas do modelo ou produza previsões precisas.
Em geral, um modelo de regressão ajustado pode ser útil sempre que for preciso entender ou prever o comportamento de uma variável dependente com base em uma ou mais variáveis independentes.
Diretrizes para o uso correto do Fit Regression Model
- Use uma variável resposta contínua com um ou mais preditores contínuos ou categóricos; se a resposta for categórica ou de contagem, aplique o modelo logístico ou de Poisson apropriado.
- Garanta que os dados representem com exatidão a população-alvo; amostras enviesadas ou incompletas levam a resultados pouco confiáveis.
- Colete pontos de dados suficientes para obter a precisão estatística necessária e garantir um modelo de regressão estável.
- Meça todas as variáveis com a maior exatidão e precisão possíveis; erros de medição afetam diretamente a qualidade do modelo ajustado.
- Registre os dados na ordem em que são coletados para ajudar a detectar tendências ou padrões ao longo do tempo nos resíduos.
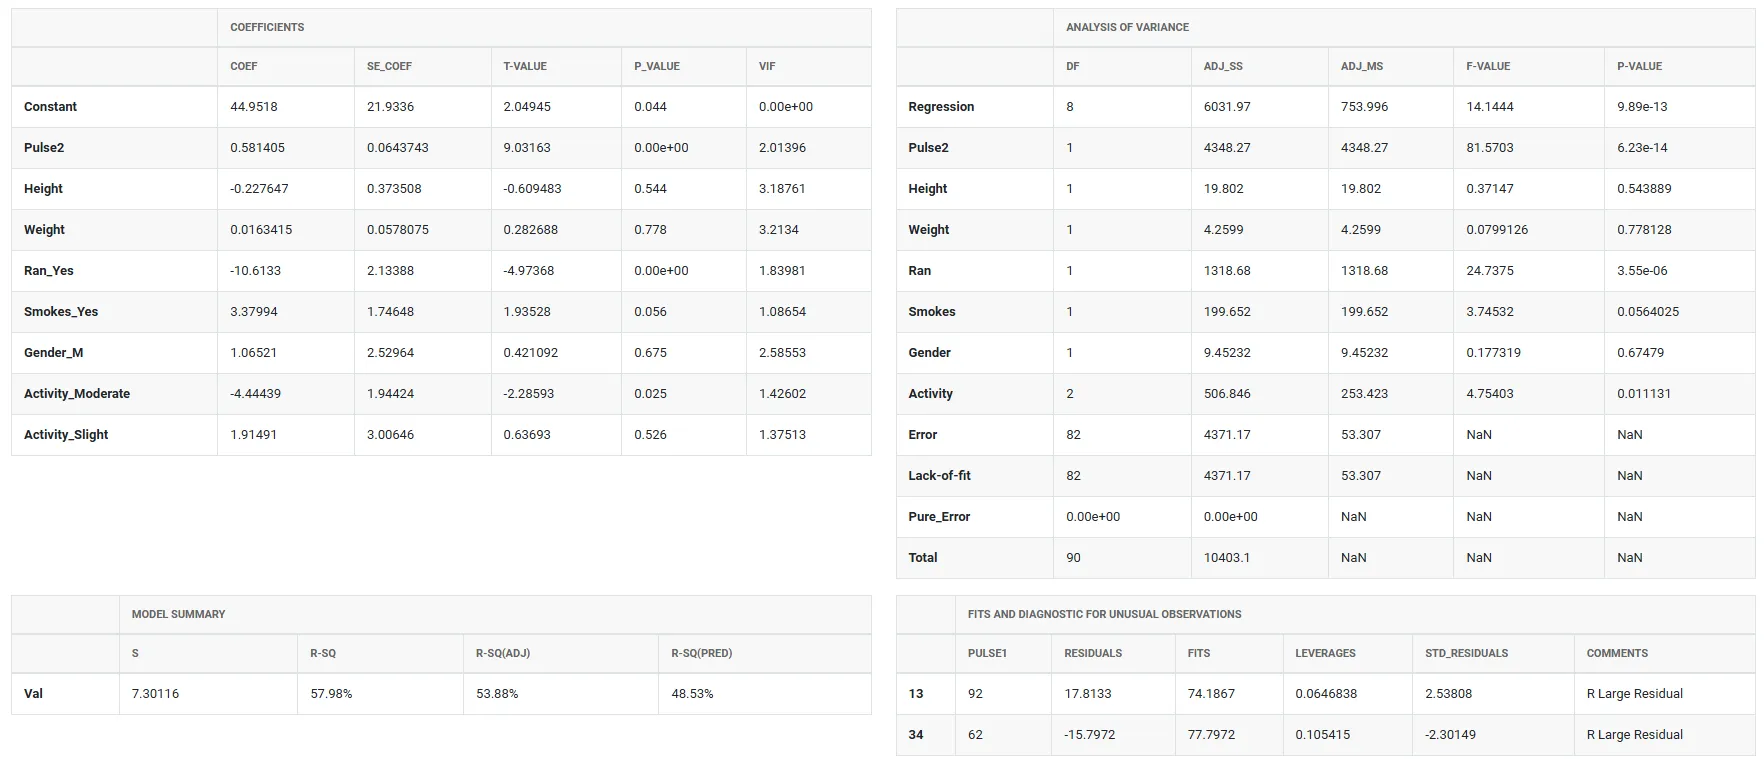
- Verifique a multicolinearidade entre os preditores: se for grave, fica difícil identificar quais preditores são realmente significativos. Use os Fatores de Inflação da Variância (VIF) na tabela Coefficients para avaliar a gravidade.
- Após o ajuste, valide o modelo usando gráficos de resíduos, estatísticas de diagnóstico e estatísticas de resumo do modelo; um modelo mal ajustado pode levar a conclusões enganosas.
Alternativas: quando não usar o Fit Regression Model
- Para visualizar a relação entre um preditor contínuo e uma resposta contínua, use um Fitted Line Plot.
- Para uma variável resposta com duas categorias, use o Fit Binary Logistic Model.
- Para variáveis resposta com três ou mais categorias com uma ordem natural, como de discordo totalmente a concordo totalmente, use a Regressão Logística Ordinal (Ordinal Logistic Regression).
- Para variáveis resposta com três ou mais categorias sem uma ordem natural, como arranhão, amassado e rasgo, use a Regressão Logística Nominal (Nominal Logistic Regression).
Exemplo de ajuste de modelo de regressão
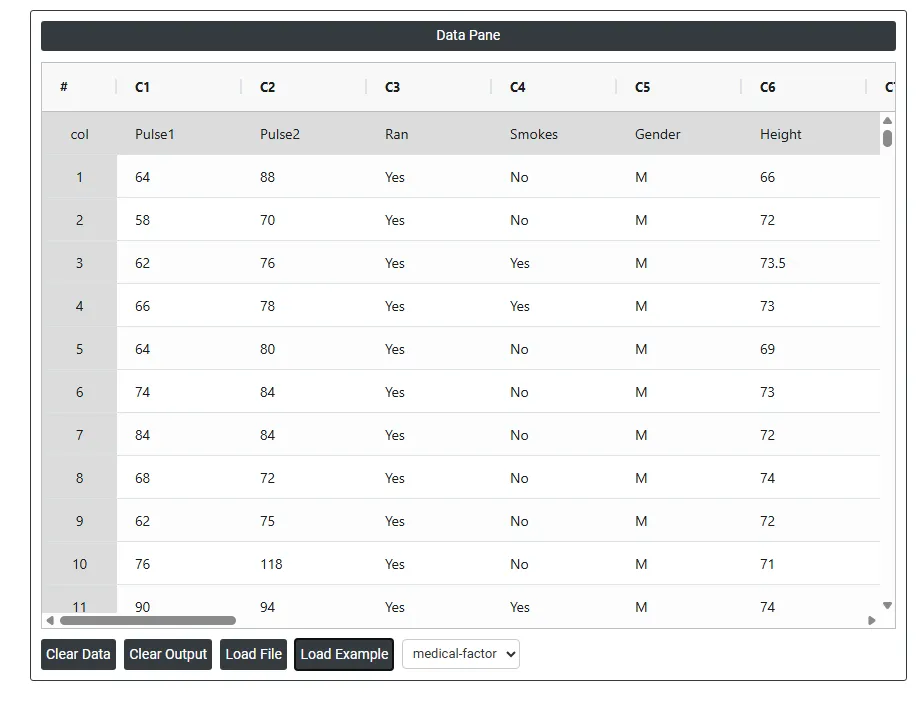
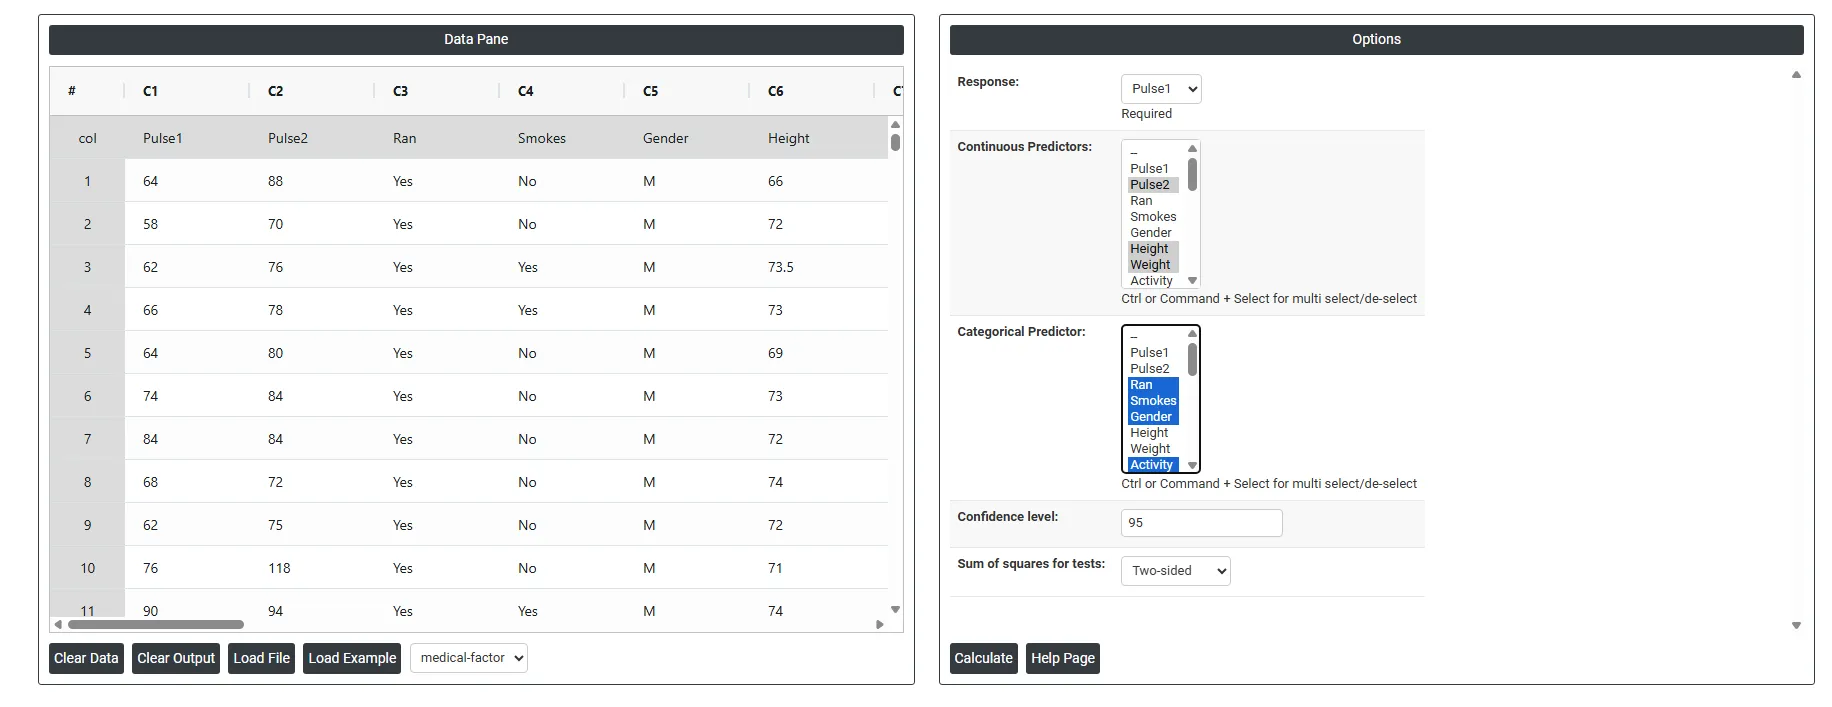
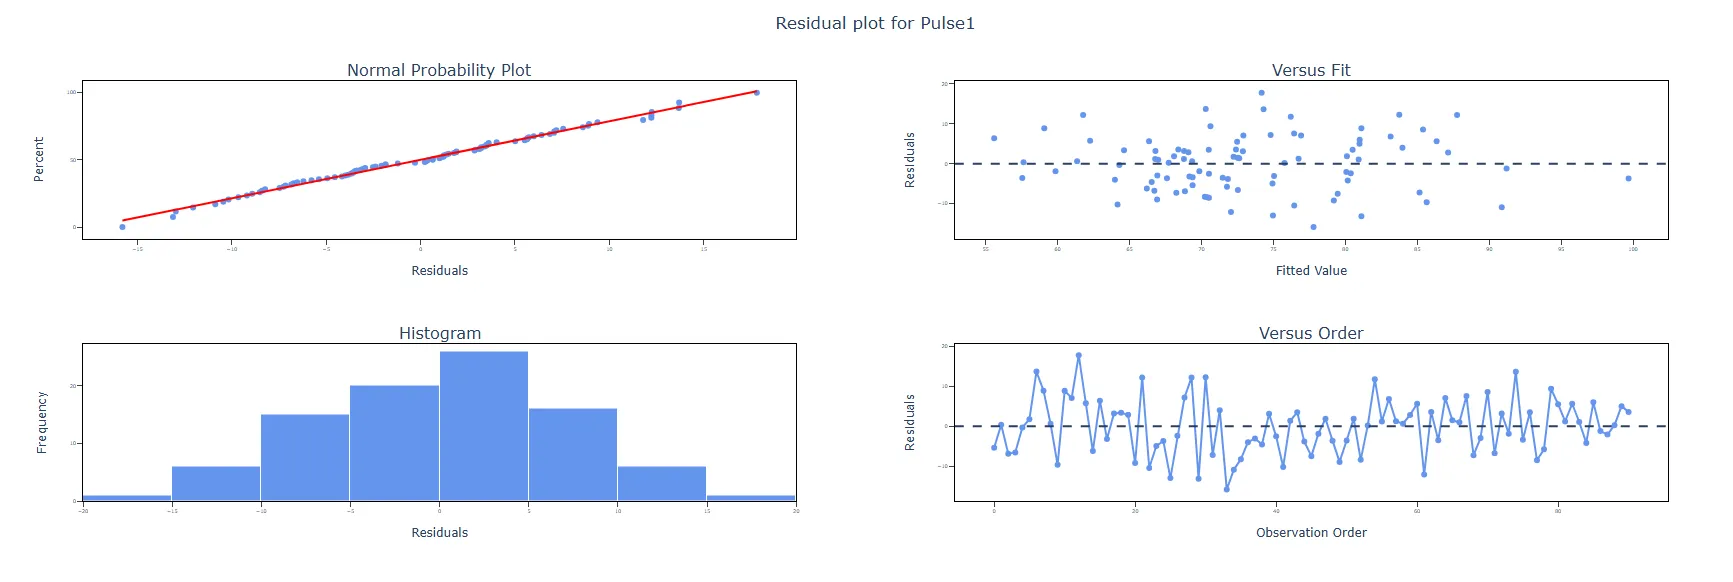
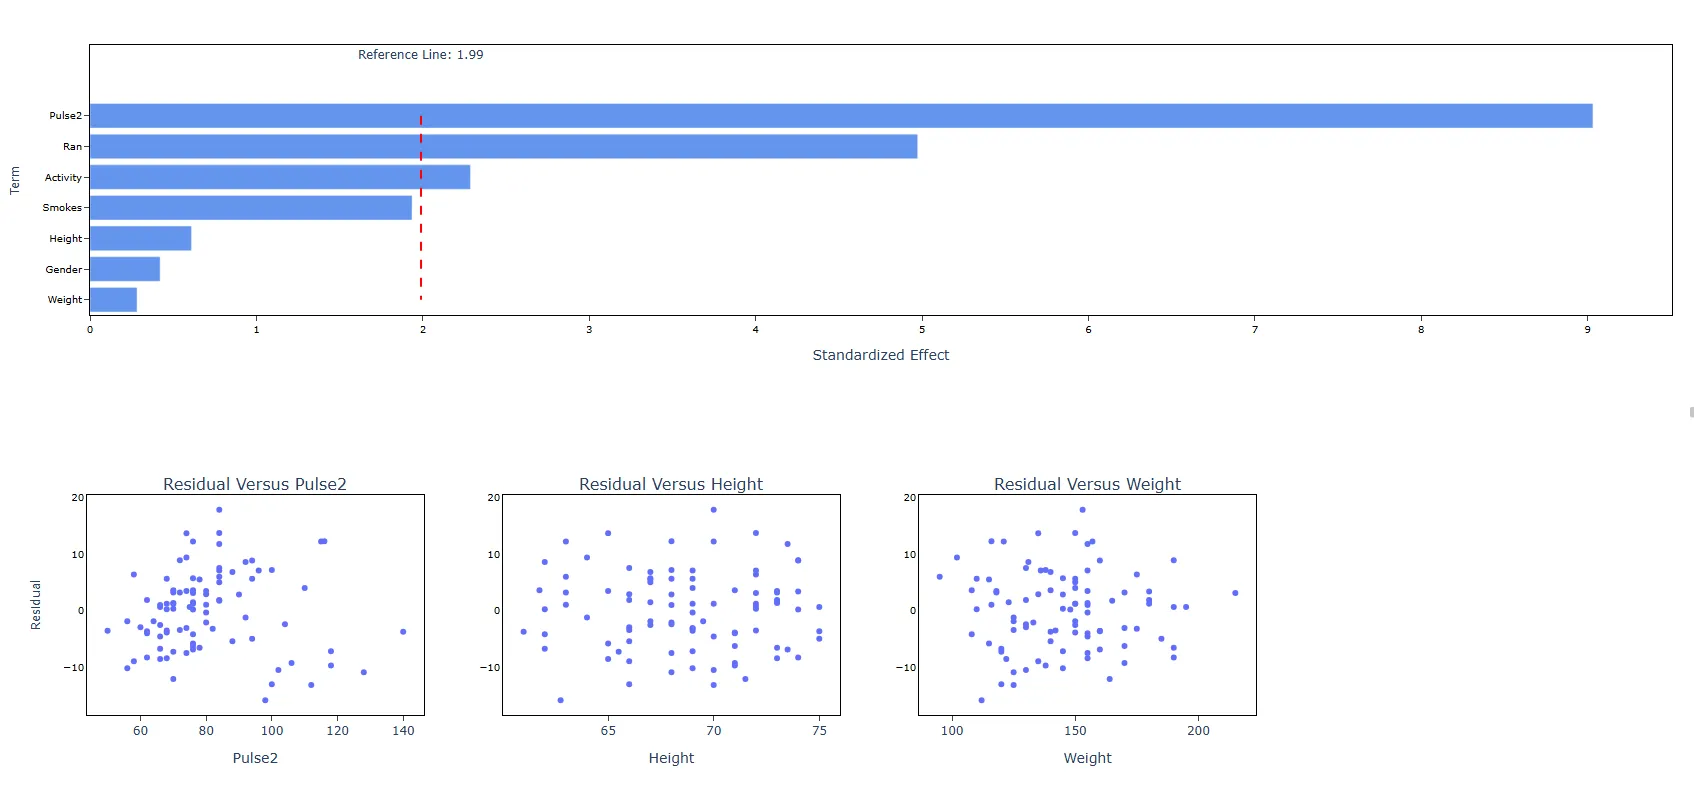
Um pesquisador médico quer estudar os efeitos de vários fatores sobre a frequência de pulso. Ele registra a altura, o peso, o sexo, a preferência quanto ao fumo, o nível de atividade e a frequência de pulso em repouso de 91 estudantes de graduação. Em seguida, divide aleatoriamente os estudantes em dois grupos. O primeiro grupo corre no lugar por um minuto, enquanto o outro fica parado. Depois, o pesquisador registra novamente as frequências de pulso dos estudantes. Os passos são os seguintes:
- Reúna os dados necessários.
- Agora analise os dados no Zometric Statistical Software em https://statsai.zometric.com/.
- Para encontrar Fit Regression Model, escolha Statistical module> Regression>Fit Regression Model.
- Dentro da ferramenta, insira os dados junto com as demais entradas, como segue:
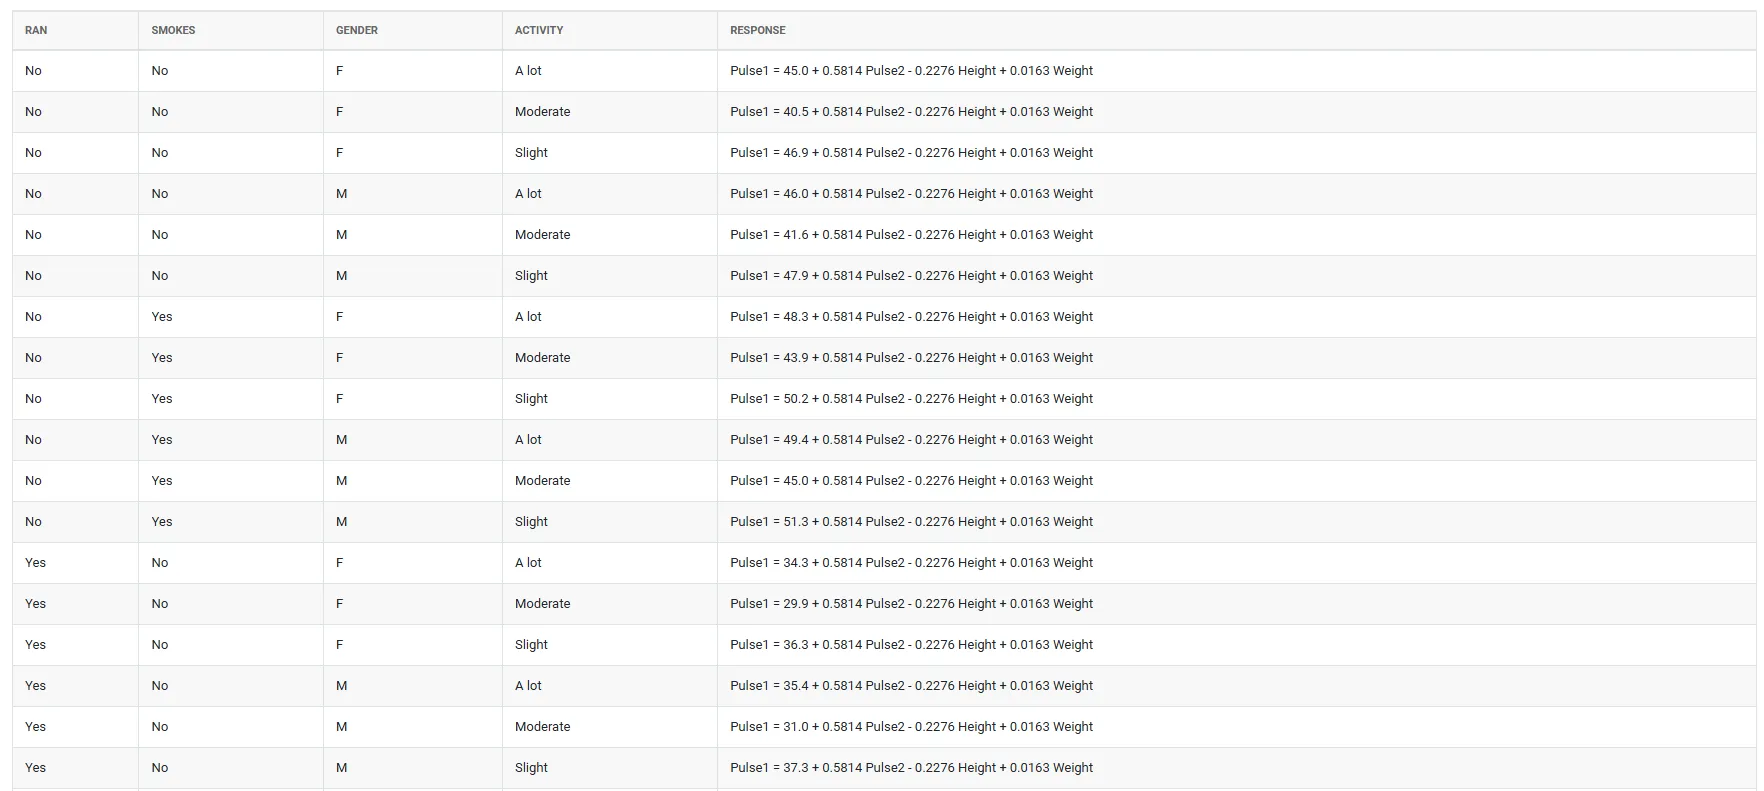
- Depois de usar a ferramenta acima, a saída obtida é a seguinte:
Como fazer o Fit Regression Model
O guia é o seguinte:
- Faça login no Zometric Statistical Software em https://statsai.zometric.com/
- Na página inicial, escolha Statistical Tool> Regression > Fit Regression Model.
- Em seguida, atualize os dados manualmente, ou copie todos os dados (Ctrl+C) de uma planilha do Excel e cole-os (Ctrl+V) aqui; ou, ainda, use a opção Load Example, que carrega os dados de exemplo.
- Em seguida, preencha as opções necessárias.
- Por fim, clique em calculate na parte inferior da página para obter os resultados desejados.
No painel (dashboard) de Fit Regression Model, a janela é dividida em duas partes.
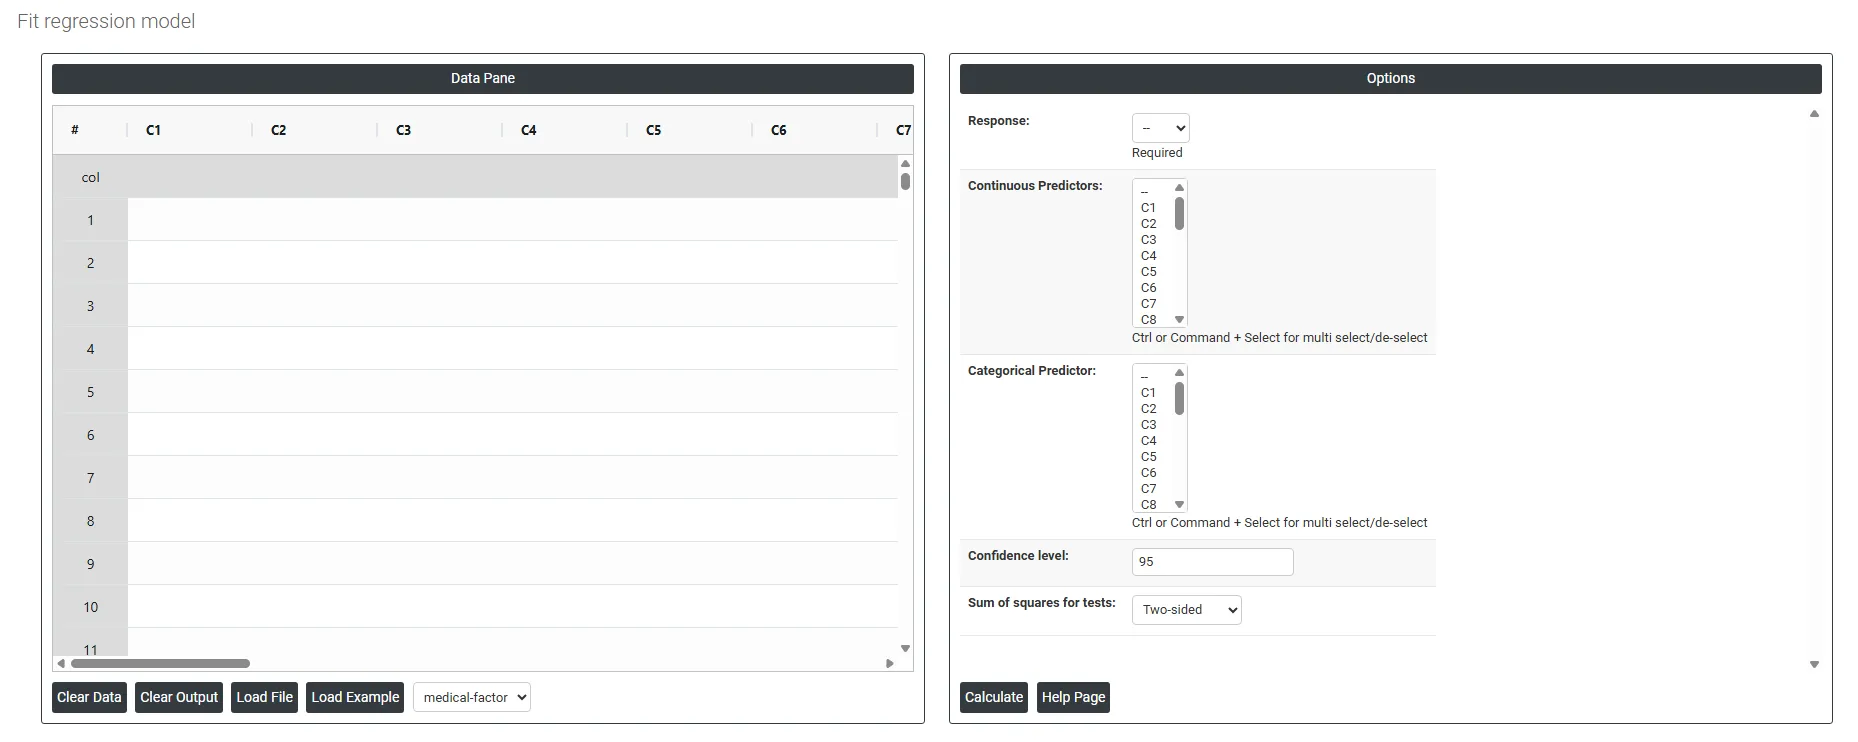
Na parte esquerda fica o painel de dados (Data Pane). No Data Pane, cada linha forma um subgrupo. Os dados podem ser inseridos manualmente, ou você pode copiar todos os dados (Ctrl+C) de uma planilha do Excel e colá-los (Ctrl+V) aqui.
Load example: Os dados de exemplo serão carregados.
Load File: É usado para carregar diretamente os dados do Excel.
Na parte direita, há várias opções, descritas a seguir:
- Response: Em um modelo de regressão, a variável resposta é a variável que está sendo prevista ou explicada pelas variáveis independentes, ou preditores. Também é conhecida como variável dependente ou variável-alvo. A variável resposta é aquela que o modelo de regressão tenta estimar ou prever com base nos valores das variáveis independentes.
- Continuous Predictors: Em um modelo de regressão, um preditor contínuo é uma variável que assume valores contínuos ou numéricos e é usada para prever ou explicar a variação na variável resposta. Os preditores contínuos podem assumir qualquer valor dentro de uma faixa ou intervalo e podem ter casas decimais ou frações.
- Categorical Predictors: Na análise de regressão, os preditores categóricos são variáveis que assumem um número limitado de valores discretos, frequentemente chamados de categorias ou níveis. Essas variáveis também são conhecidas como variáveis qualitativas ou nominais, em oposição às variáveis quantitativas ou numéricas.
- Confidence level: Na análise de regressão, o nível de confiança é uma medida da precisão e da exatidão dos coeficientes estimados do modelo de regressão. Especificamente, o nível de confiança é a proporção, a longo prazo, de intervalos de confiança, calculados da mesma forma a partir de amostras repetidas, que conteriam o verdadeiro valor populacional de um coeficiente. O nível de confiança costuma ser expresso em porcentagem, e um valor comum é 95%. Isso significa que, se o mesmo modelo de regressão fosse estimado repetidamente com diferentes amostras de dados, cerca de 95% dos intervalos de confiança resultantes conteriam o verdadeiro valor desse coeficiente.
- Sum of squares for tests:
- Adjusted (Type III): A soma de quadrados de cada termo é a redução na soma de quadrados do erro quando esse termo é adicionado a um modelo que já contém todos os demais termos; assim, seu teste não depende da ordem em que os termos são inseridos. Este é o padrão e geralmente é o preferido. Sequential (Type I): A soma de quadrados de cada termo é a redução na soma de quadrados do erro quando o termo é adicionado ao modelo na ordem em que foi inserido; assim, o teste de um termo depende dos termos inseridos antes dele.
Perguntas frequentes
O que é o Fit Regression Model?
O Fit Regression Model examina e quantifica a relação entre uma ou mais variáveis preditoras e uma variável resposta contínua. Ele constrói uma equação que melhor descreve como os preditores, em conjunto, influenciam a resposta, a qual pode ser usada para entender padrões, identificar variáveis significativas e prever resultados futuros. Os preditores podem ser contínuos, categóricos ou uma combinação de ambos.
Qual é a diferença entre o Fit Regression Model e o Fit Line Model?
O Fit Line Model trata apenas um único preditor, enquanto o Fit Regression Model aceita vários preditores, contínuos e categóricos. Para visualizar a relação entre um preditor contínuo e uma resposta contínua, um gráfico de reta ajustada é a escolha mais simples; para vários preditores, use o Fit Regression Model.
Quando não usar o Fit Regression Model?
A resposta deve ser contínua. Para uma resposta com duas categorias, use o Fit Binary Logistic Model. Para três ou mais categorias com uma ordem natural, como de discordo totalmente a concordo totalmente, use a Regressão Logística Ordinal (Ordinal Logistic Regression). Para três ou mais categorias sem uma ordem natural, como arranhão, amassado e rasgo, use a Regressão Logística Nominal (Nominal Logistic Regression).
Como verificar a multicolinearidade em um modelo de regressão?
Use os Fatores de Inflação da Variância (VIF) na tabela Coefficients para avaliar a gravidade da multicolinearidade entre os preditores. Se for grave, fica difícil identificar quais preditores são realmente significativos. Após o ajuste, valide também o modelo com gráficos de resíduos, estatísticas de diagnóstico e estatísticas de resumo do modelo, pois um modelo mal ajustado pode levar a conclusões enganosas.