
Modelo linear geral (GLM)
O modelo linear geral ajusta fatores categóricos fixos, interações de dois fatores opcionais e covariáveis contínuas por mínimos quadrados, com somas de quadrados ajustadas (Tipo III) ou sequenciais. Use-o quando a ANOVA de um fator não bastar ou os dados forem desbalanceados. Pressupõe erros independentes, normais e de variância constante. A saída inclui a tabela ANOVA, médias de mínimos quadrados, coeficientes com VIF, comparações múltiplas e gráficos de resíduos.
Última revisão
Conclusão principal
Um modelo linear geral (GLM) executa uma análise de variância com um ou mais fatores categóricos, suas interações de dois fatores e covariáveis contínuas em um único modelo, incluindo dados desbalanceados e ANOVA de dois fatores.
Nesta página
Finalidade
O General Linear Model (GLM) executa uma análise de variância com um ou mais fatores categóricos, suas interações de dois fatores e covariáveis contínuas em um único modelo. Use-o quando uma ANOVA de um fator não for suficiente: por exemplo, quando o rendimento pode depender da máquina, do operador, da combinação dos dois e também de uma condição medida, como a temperatura, ou quando os dados são desbalanceados. Ele também cobre a ANOVA de dois fatores clássica.
Principais recursos
- Qualquer número de fatores categóricos fixos, com todas as interações de dois fatores sob demanda.
- Covariáveis contínuas inseridas como efeitos principais (análise de covariância).
- Somas de quadrados ajustadas (Tipo III) ou sequenciais (Tipo I); testes corretos para dados desbalanceados.
- Médias de mínimos quadrados para cada fator, ajustadas para os demais termos.
- Comparações múltiplas das médias de mínimos quadrados de um fator por Tukey, Fisher, Bonferroni, Sidak ou Dunnett (contra um controle), com letras de agrupamento e um gráfico de intervalos das diferenças.
- Coeficientes com VIF, resumo do modelo com R-sq(pred), observações incomuns e quatro gráficos de resíduos.
- Data Options: selecione um subconjunto das linhas antes da análise.
Métodos estatísticos
O modelo é ajustado por mínimos quadrados ordinários. Os fatores usam codificação de soma zero (−1, 0, +1); assim, cada coeficiente é o desvio de um nível em relação à média geral, e o teste Tipo III de um efeito principal calcula a média sobre os níveis dos demais fatores. As linhas com valor ausente em qualquer coluna selecionada são descartadas. Cada termo é testado com F = Adj MS(termo) / MS(Erro), com seus próprios graus de liberdade e os do erro; com somas de quadrados sequenciais, cada termo é testado após os termos que o precedem. A linha Total é a soma de quadrados total em relação à média, à qual as somas de quadrados ajustadas não precisam totalizar com dados desbalanceados.
S = √MS(Erro). R-sq(pred) = 1 − PRESS / SS Total, em que PRESS é a soma dos quadrados dos erros de predição leave-one-out (excluindo uma observação por vez). Uma média de mínimos quadrados é a predição do modelo para um nível de fator, com os demais fatores promediados sobre seus níveis e as covariáveis em sua média; ao contrário das médias brutas, ela não é distorcida por tamanhos de grupo desiguais nem por diferenças nas covariáveis.
As comparações usam a diferença entre médias de mínimos quadrados, com seu erro padrão obtido da matriz de covariância dos coeficientes. Tukey usa a distribuição da amplitude studentizada para todos os pares; Fisher usa testes t individuais; Bonferroni e Sidak ajustam o valor crítico de t para o número de pares; Dunnett compara cada nível com um controle usando a distribuição t multivariada. Um intervalo que não contém zero, ou médias que não compartilham uma letra de agrupamento, indicam uma diferença significativa. Resíduos padronizados além de ±2 são sinalizados com R, e alavancagens acima de 3p/n são sinalizadas com X. O modelo pressupõe erros independentes, normalmente distribuídos e de variância constante: verifique os gráficos de resíduos.
Campos de entrada e opções
Campo | Descrição |
Response (Y) | Coluna numérica de resposta. Obrigatório. |
Factors (categorical) | Uma ou mais colunas de preditores categóricos. Obrigatório. |
Covariates (continuous) | Colunas numéricas opcionais, inseridas apenas como efeitos principais (sem interações com os fatores). |
Include all 2-way factor interactions | Marcada por padrão: adiciona todas as interações de dois fatores. |
Confidence level | Padrão 95; usado nas comparações. |
Comparison procedure | None (default), Tukey, Fisher, Bonferroni, Sidak or Dunnett (vs. a control level). |
Comparison factor | Qual fator terá suas médias de mínimos quadrados comparadas; obrigatório se um procedimento for escolhido. |
Control group level (Dunnett) | Nível de controle para Dunnett; em branco, usa o primeiro nível. |
Grouping information / Interval plot for differences of means | Marcada por padrão: tabela de letras de agrupamento e gráfico dos intervalos de comparação. |
Sum of squares for tests | Adjusted (Type III, default) or Sequential (Type I). |
Residual versus fit graph / Residual versus order graph / Histogram / Probability plot | Gráficos de resíduos; todos marcados por padrão. |
Data Options: Subset (optional) | Exclude matching rows (default) or Include only matching rows, por números de linha (ex.: 3,7,12-15) e/ou por uma condição (ex.: Temperature_C > 185). |
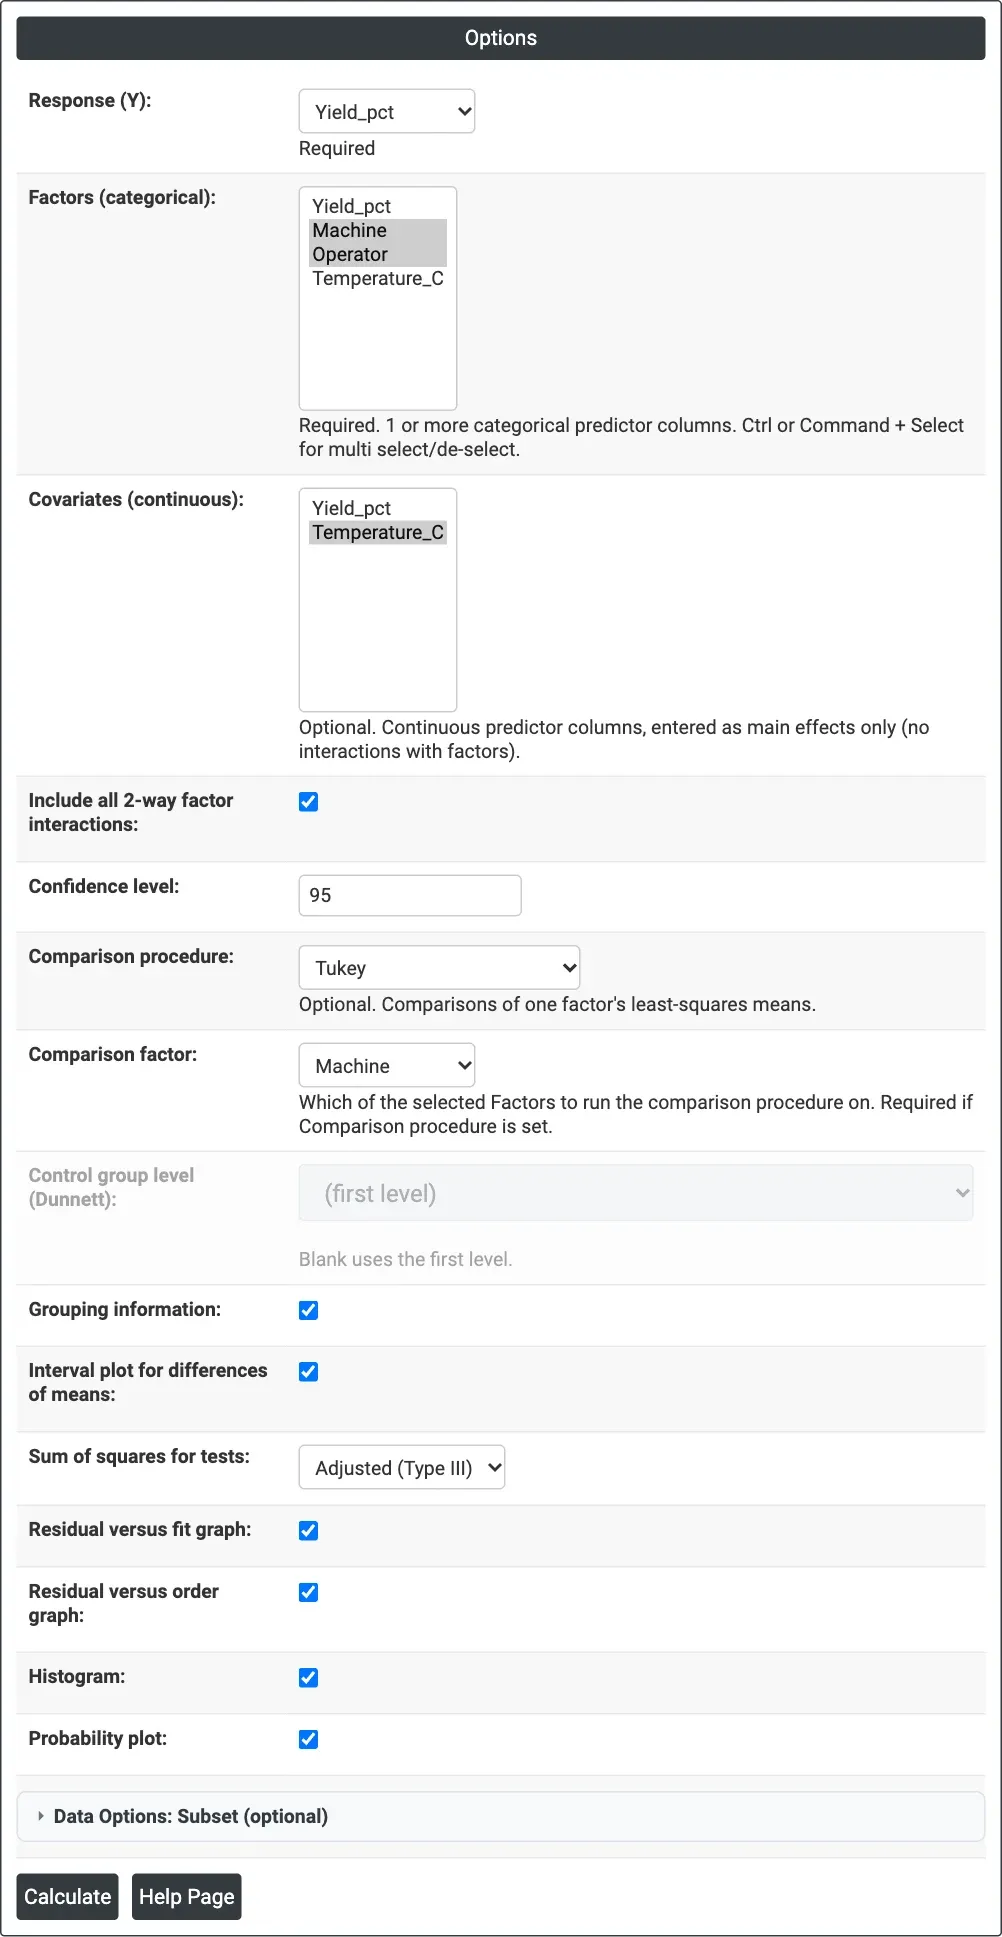
Figura 1 — Opções do exemplo de rendimento: Yield_pct com os fatores Machine e Operator, sua interação, a covariável Temperature_C e comparações de Tukey entre as máquinas.
Descrição da saída
- Method — codificação dos fatores e tipo de somas de quadrados.
- Factor Information — tipo, número de níveis e valores dos níveis de cada fator.
- Analysis of Variance — DF, Adj SS (ou Seq SS), Adj MS, F-Value e P-Value de cada termo, do erro e do total.
- Model Summary — S, R-sq, R-sq(adj) e R-sq(pred).
- Least-Squares Means — N e média de mínimos quadrados (LS mean) de cada nível de cada fator.
- Coefficients — Coef, SE Coef, T-Value, P-Value e VIF.
- Fits and Diagnostics for Unusual Observations — exibido apenas quando há observações incomuns.
- Grouping Information, Simultaneous (or Individual) Tests for Differences of Means e o gráfico de intervalos — quando um procedimento de comparação é escolhido.
- Versus Fit, Versus Order, Residuals Histogram e Probability Plot.
- Exportação em PDF por meio de Download.
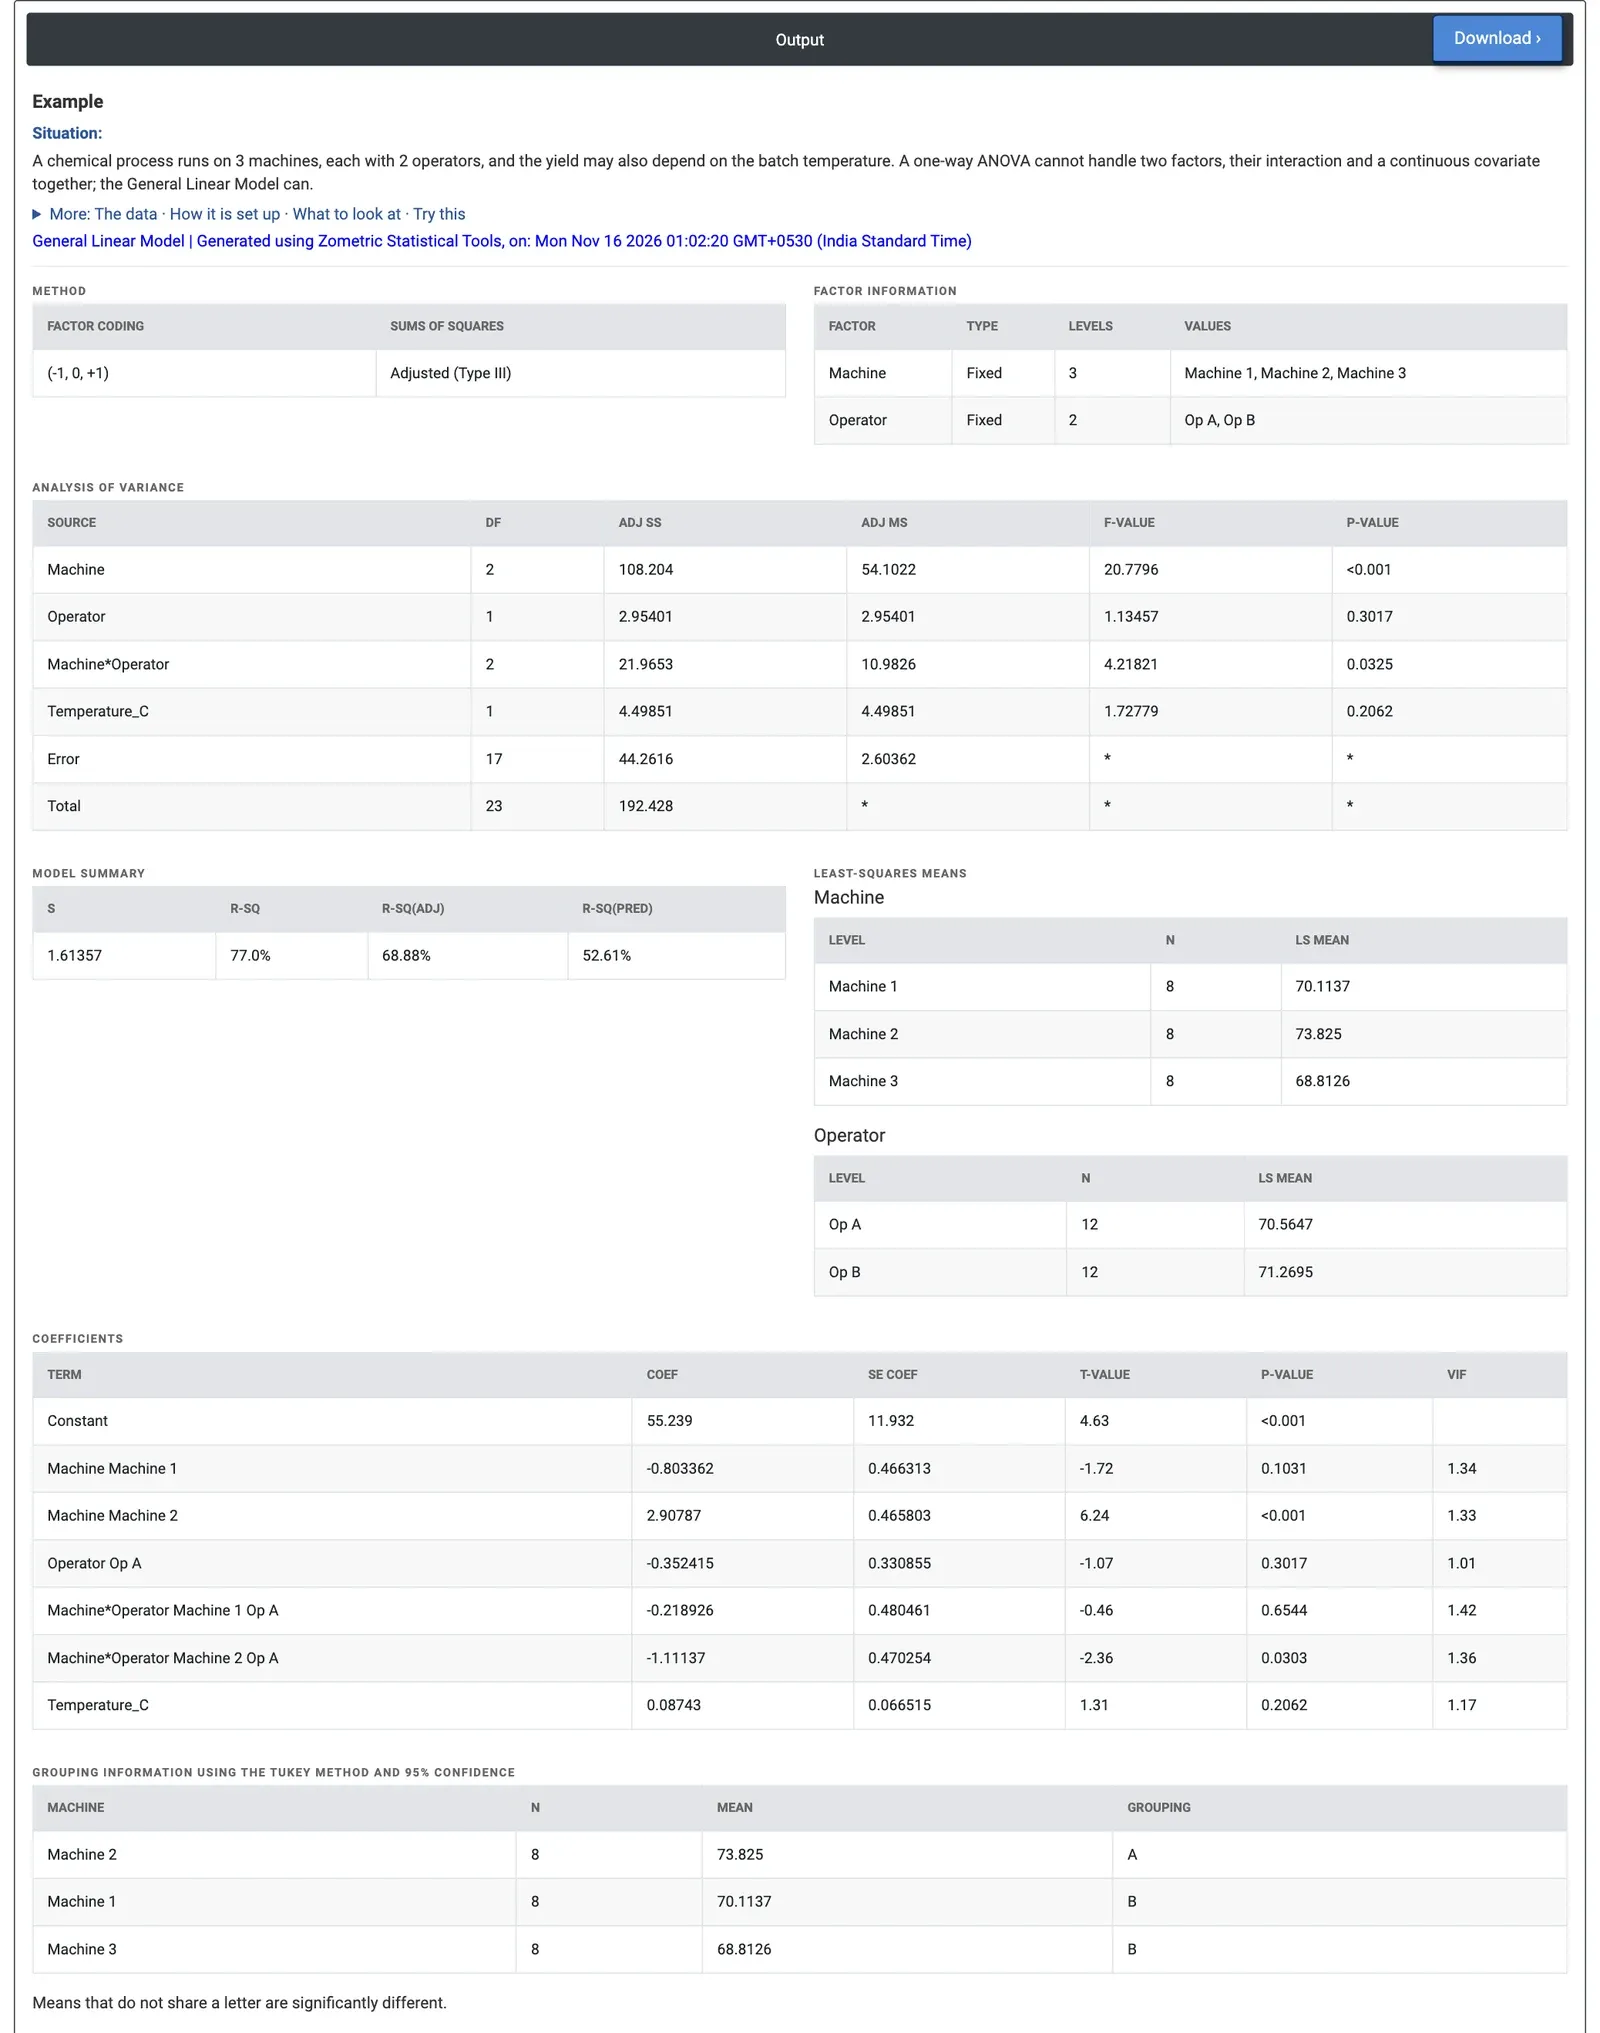
Figura 2 — Resultados do GLM para o rendimento: Machine é significativa (p < 0.001), assim como a interação Machine*Operator (p = 0.0325); a Machine 2 tem a maior média de mínimos quadrados, 73.83%.
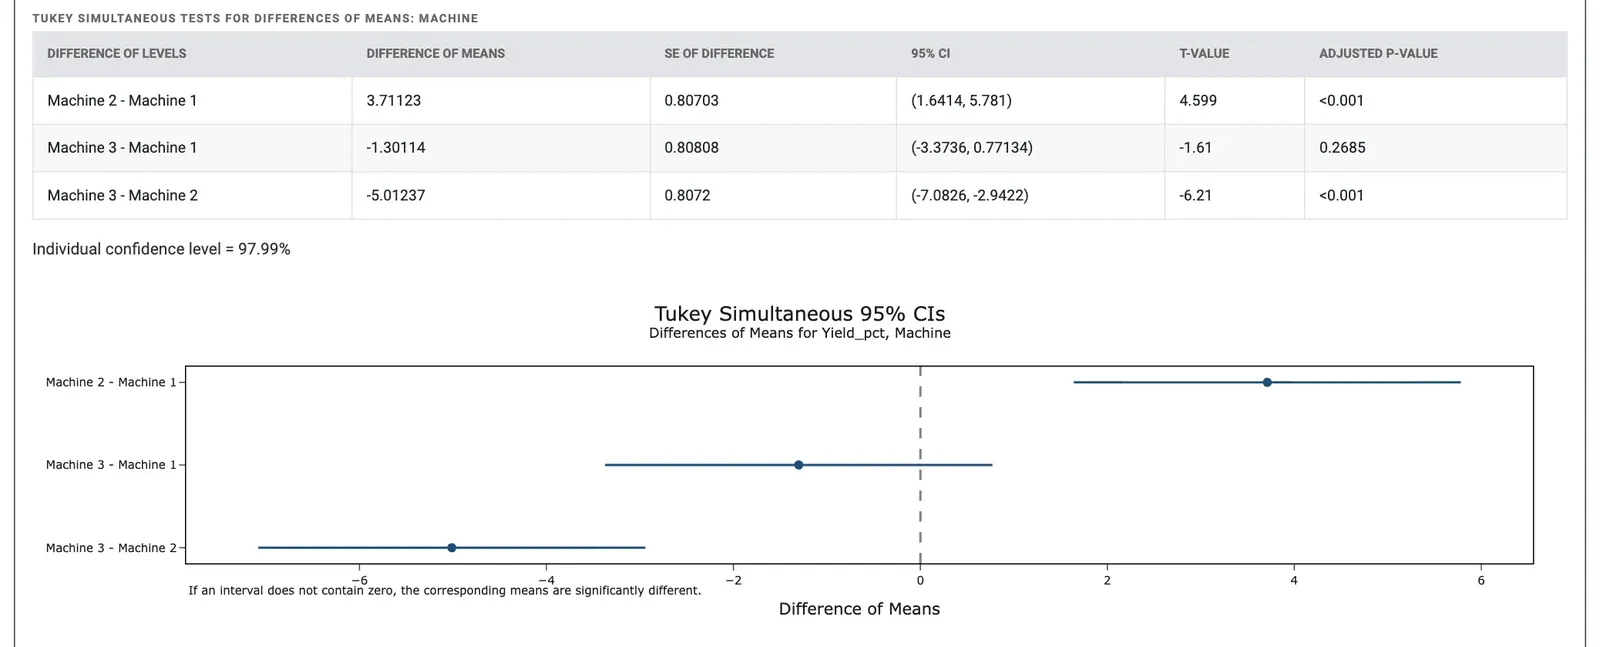
Figura 3 — Comparações de Tukey entre as máquinas: a Machine 2 difere das outras duas; o intervalo de Machine 3 − Machine 1 contém zero.
Exemplo prático
Um processo químico opera em três máquinas, cada uma com dois operadores (Op A e Op B), e o rendimento do lote também pode depender da temperatura do lote (170 a 190 °C). São 24 lotes, quatro para cada máquina e operador. O engenheiro seleciona Yield_pct como resposta, Machine e Operator como fatores com sua interação, Temperature_C como covariável e solicita comparações de Tukey entre as máquinas.
As máquinas diferem claramente (F = 20.78, p < 0.001). A interação Machine*Operator também é significativa (F = 4.22, p = 0.0325): o Op B obtém mais das Machines 1 e 2, mas menos da Machine 3. O operador isoladamente (p = 0.3017) e a temperatura (p = 0.2062) não têm efeito significativo na faixa estudada. O modelo explica 77.0% da variação (R-sq(adj) de 68.88%), com S = 1.61 ponto percentual; o R-sq(pred) é menor, 52.61%, de modo que as predições para novos lotes serão menos precisas do que o ajuste sugere.
As médias de mínimos quadrados são 73.83% para a Machine 2, 70.11% para a Machine 1 e 68.81% para a Machine 3. O método de Tukey coloca a Machine 2 sozinha no grupo A: ela rende 3.71 pontos a mais que a Machine 1 (IC de 95% de 1.64 a 5.78) e 5.01 a mais que a Machine 3, ambos com p ajustado < 0.001, enquanto as Machines 1 e 3 não diferem (p ajustado = 0.2685). O engenheiro estuda o que é diferente na Machine 2 e, por causa da interação, examina a combinação de operadores na Machine 3 antes de padronizar o método.
Perguntas frequentes
Quando usar um modelo linear geral em vez de ANOVA de um fator?
Use um modelo linear geral quando uma ANOVA de um fator não for suficiente, por exemplo quando o rendimento pode depender da máquina, do operador, da combinação dos dois e de uma condição medida, como a temperatura, ou quando os dados são desbalanceados. Ele trata vários fatores categóricos, interações de dois fatores e covariáveis contínuas em um único modelo, e também cobre a ANOVA de dois fatores clássica.
O que são médias de mínimos quadrados em um GLM?
Uma média de mínimos quadrados é a predição do modelo para um nível de fator, com os demais fatores promediados sobre seus níveis e as covariáveis mantidas em sua média. Ao contrário das médias brutas, ela não é distorcida por tamanhos de grupo desiguais nem por diferenças nas covariáveis. As comparações múltiplas no GLM comparam essas médias de mínimos quadrados entre os níveis de um fator.
Qual método de comparações múltiplas usar em um GLM?
Tukey compara todos os pares usando a distribuição da amplitude studentizada; Fisher usa testes t individuais; Bonferroni e Sidak ajustam o valor crítico de t para o número de pares; Dunnett compara cada nível com um controle. Um intervalo que não contém zero, ou médias que não compartilham uma letra de agrupamento, indicam uma diferença significativa.
Quais são as premissas de um modelo linear geral?
O modelo pressupõe erros independentes, normalmente distribuídos e de variância constante, que você verifica com os gráficos de resíduos: resíduos versus ajustados, versus ordem, histograma e gráfico de probabilidade. Resíduos padronizados além de mais ou menos 2 são sinalizados com R, e observações com alavancagem acima de 3p/n são sinalizadas com X como incomuns.