
Identificação de distribuição individual
A identificação de distribuição individual ajusta várias distribuições de probabilidade aos seus dados simultaneamente e avalia qual delas oferece o melhor ajuste estatístico. Em vez de pressupor normalidade, a ferramenta testa uma ampla gama de distribuições, incluindo Weibull, Lognormal, Exponencial, Logística, Gama e outras, e as classifica pela qualidade com que descrevem a forma e o comportamento dos seus dados.
Última revisão
Conclusão principal
A identificação de distribuição individual ajusta várias distribuições de probabilidade aos seus dados simultaneamente e avalia qual delas oferece o melhor ajuste estatístico.
Nesta página
- O que é a identificação de distribuição individual?
- Quando usar a identificação de distribuição individual?
- Diretrizes para o uso correto da identificação de distribuição individual
- Alternativas: quando não usar a identificação de distribuição individual
- Exemplo de identificação de distribuição individual
- Como fazer a identificação de distribuição individual
O que é a identificação de distribuição individual?
A identificação de distribuição individual ajusta várias distribuições de probabilidade aos seus dados simultaneamente e avalia qual delas oferece o melhor ajuste estatístico. Em vez de pressupor normalidade, a ferramenta testa uma ampla gama de distribuições, incluindo Weibull, Lognormal, Exponencial, Logística, Gama e outras, e as classifica pela qualidade com que descrevem a forma e o comportamento dos seus dados.
Isso é essencial para a análise de capacidade de dados não normais, em que o uso da distribuição errada produz estimativas imprecisas de Pp, Ppk, ou Cp, Cpk e previsões enganosas da taxa de defeitos.
Definição simples: Uma ferramenta que testa os seus dados contra muitas distribuições estatísticas diferentes e informa qual se ajusta melhor, para que você possa executar uma análise de capacidade precisa mesmo quando os dados não seguem uma distribuição normal.
Quando usar a identificação de distribuição individual?
- Use quando os seus dados não passam em um teste de normalidade e você precisa identificar a distribuição correta antes de executar a análise de capacidade.
- Use ao trabalhar com dados de processo inerentemente assimétricos , como tempos de ciclo, tempos de falha, concentrações químicas ou tamanhos de partículas.
- Use antes de aplicar a análise de capacidade não normal para garantir que a distribuição selecionada represente com exatidão o comportamento do processo.
- Use quando a transformação Box-Cox não é apropriada , por exemplo, quando os dados contêm zeros ou valores negativos.
Diretrizes para o uso correto da identificação de distribuição individual
- Colete pelo menos 50 a 100 pontos de dados para que o ajuste de distribuição seja confiável: amostras pequenas não fornecem informação suficiente para distinguir entre as distribuições.
- Use estatísticas de aderência (Anderson-Darling) e gráficos de probabilidade em conjunto ao selecionar a melhor distribuição; não se baseie apenas no valor-p.
- Selecione uma distribuição que faça sentido físico para o processo : uma distribuição com a menor estatística AD, mas sem base física, pode não ser a melhor escolha.
- Garanta que os dados venham de um processo estável e sob controle antes de ajustar distribuições: o ajuste de distribuições a dados de um processo instável produz resultados sem significado.
- Considere usar a transformação de Johnson ou Box-Cox como alternativa quando nenhuma distribuição padrão se ajustar bem.
Alternativas: quando não usar a identificação de distribuição individual
- Se os dados já foram confirmados como normais, prossiga diretamente com a Normal Capability Analysis padrão: a identificação de distribuição é desnecessária.
- Se você só precisa verificar a normalidade sem explorar outras distribuições, use um simples Normality Test
- Se os dados têm limites físicos claros ou um tipo de distribuição conhecido, especifique essa distribuição diretamente na análise de capacidade em vez de testar todas as opções.
Exemplo de identificação de distribuição individual
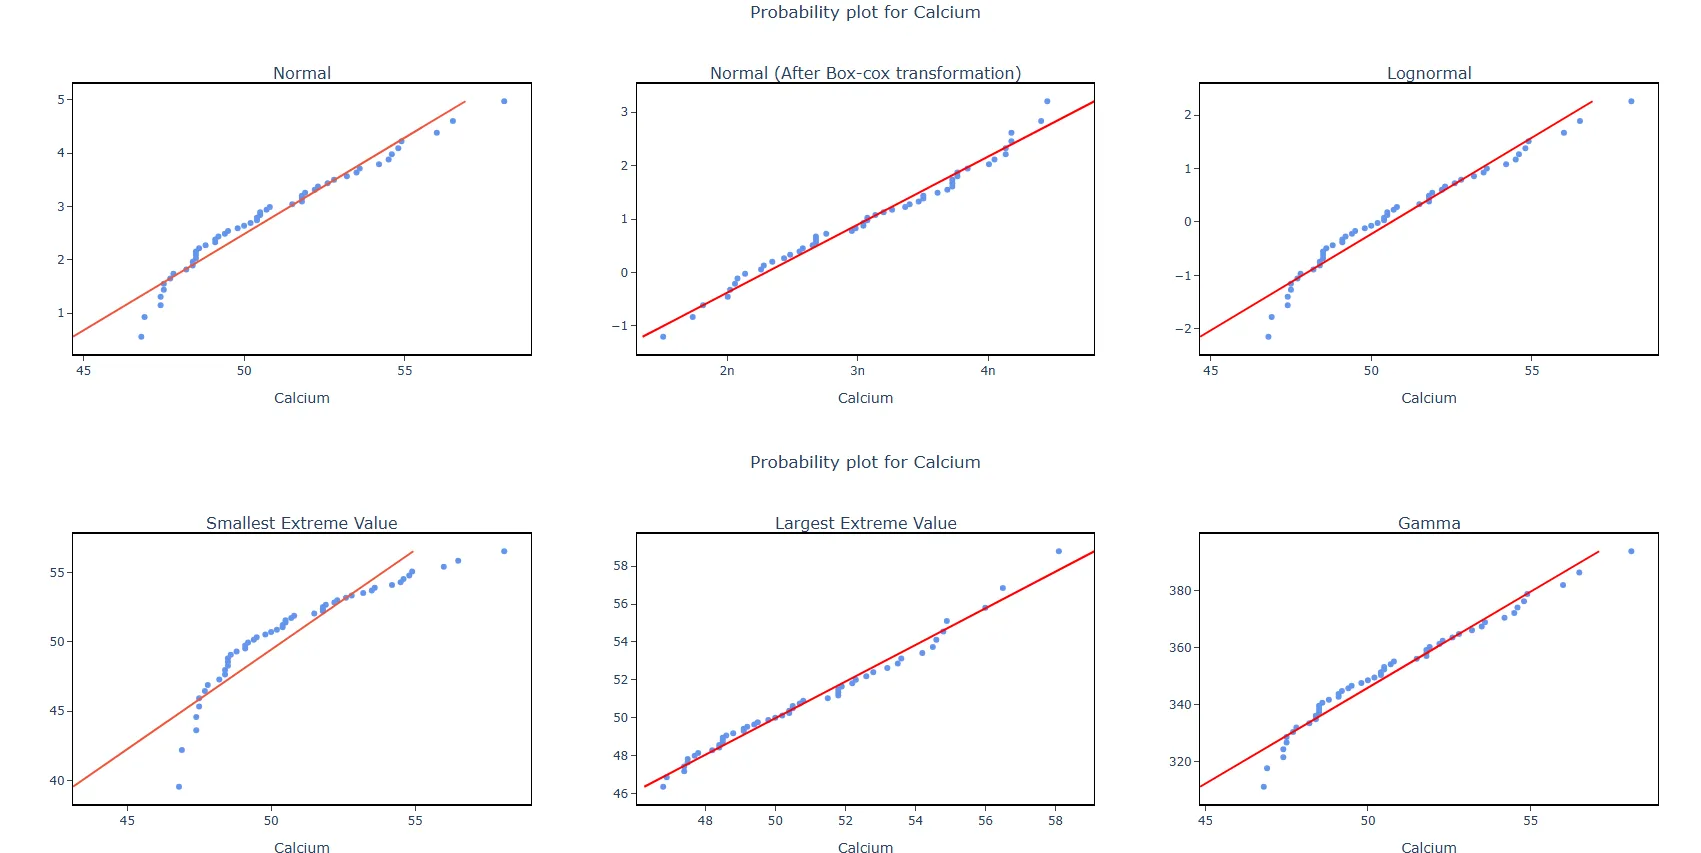
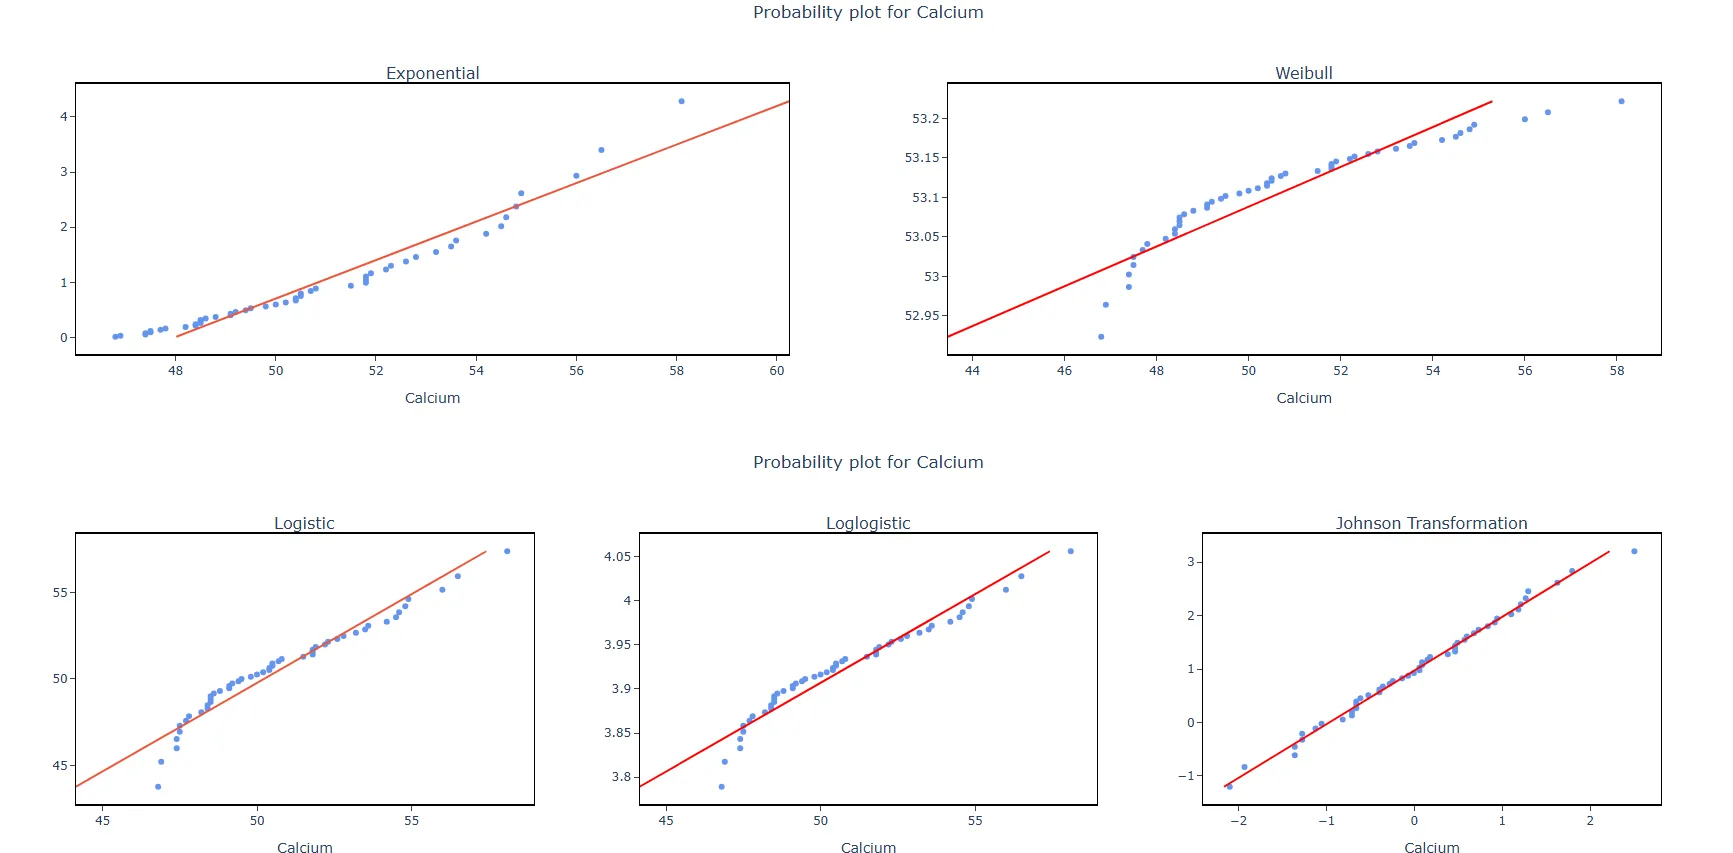
Um engenheiro coleta uma amostra aleatória de cápsulas e registra o teor de cálcio de cada uma. Para determinar a distribuição de dados de melhor ajuste, ele realiza uma identificação de distribuição individual. O teste segue estes passos:
- Reúna os dados necessários.
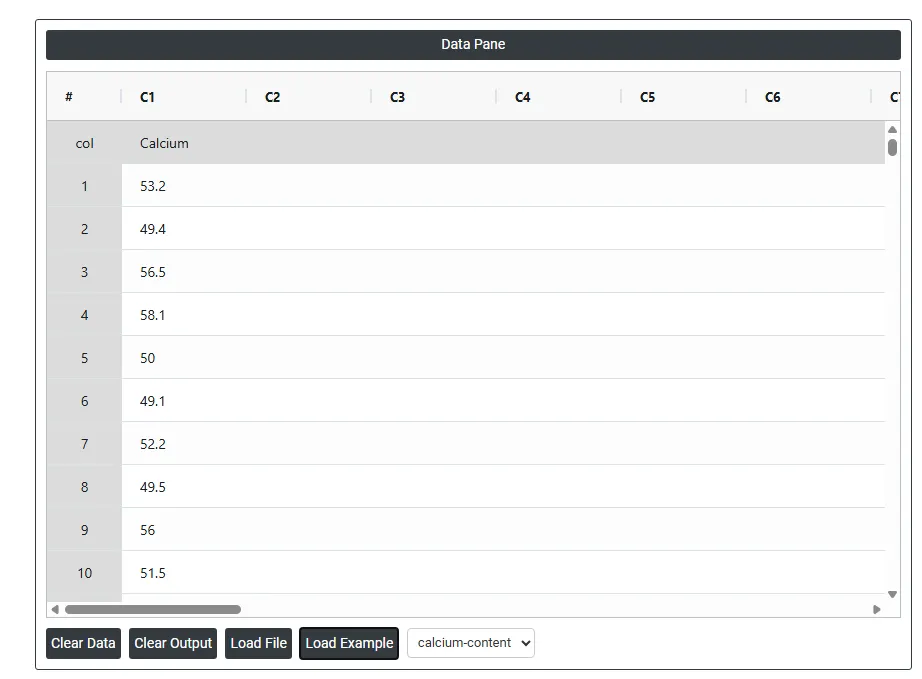
- Agora analise os dados no Zometric Statistical Software em https://statsai.zometric.com/.
- Para encontrar Individual Distribution Identification, escolha Statistical module> Hypothesis Test> Individual Distribution Identification.
- Dentro da ferramenta, insira os dados junto com as demais entradas, como segue:
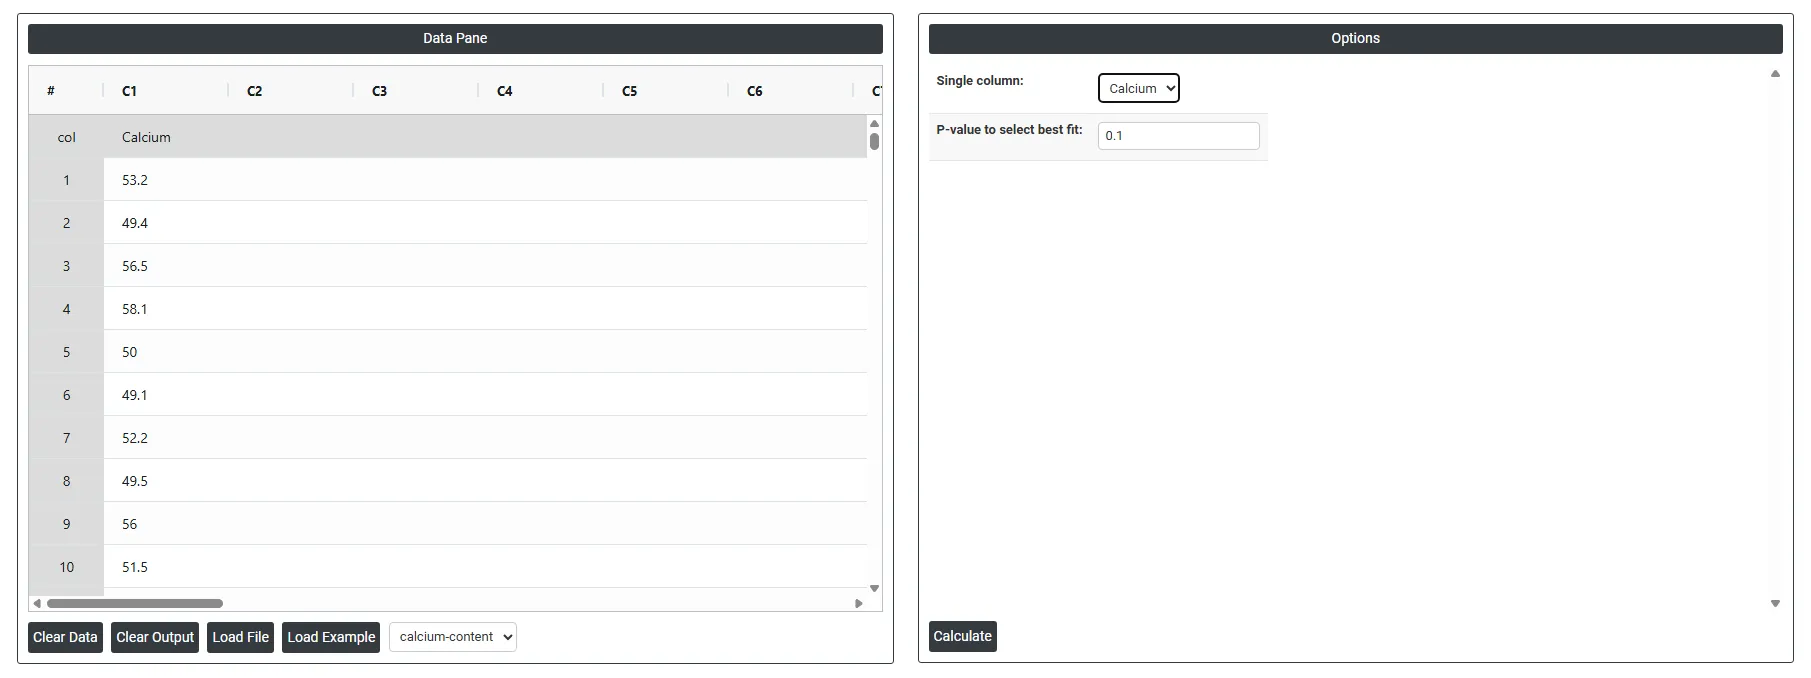
5. Depois de usar a ferramenta acima, a saída obtida é a seguinte:
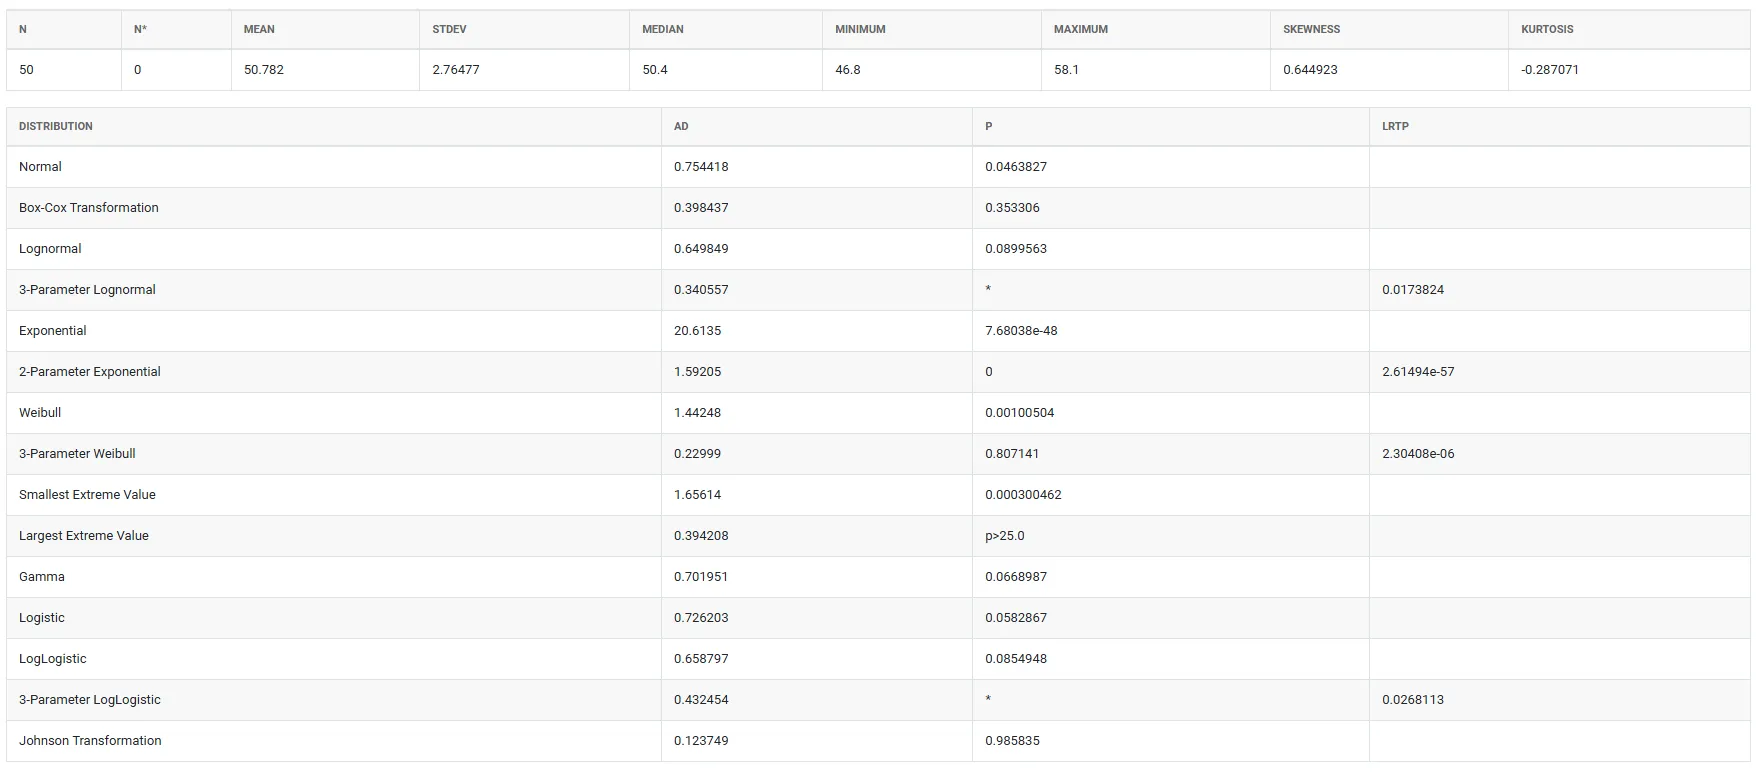
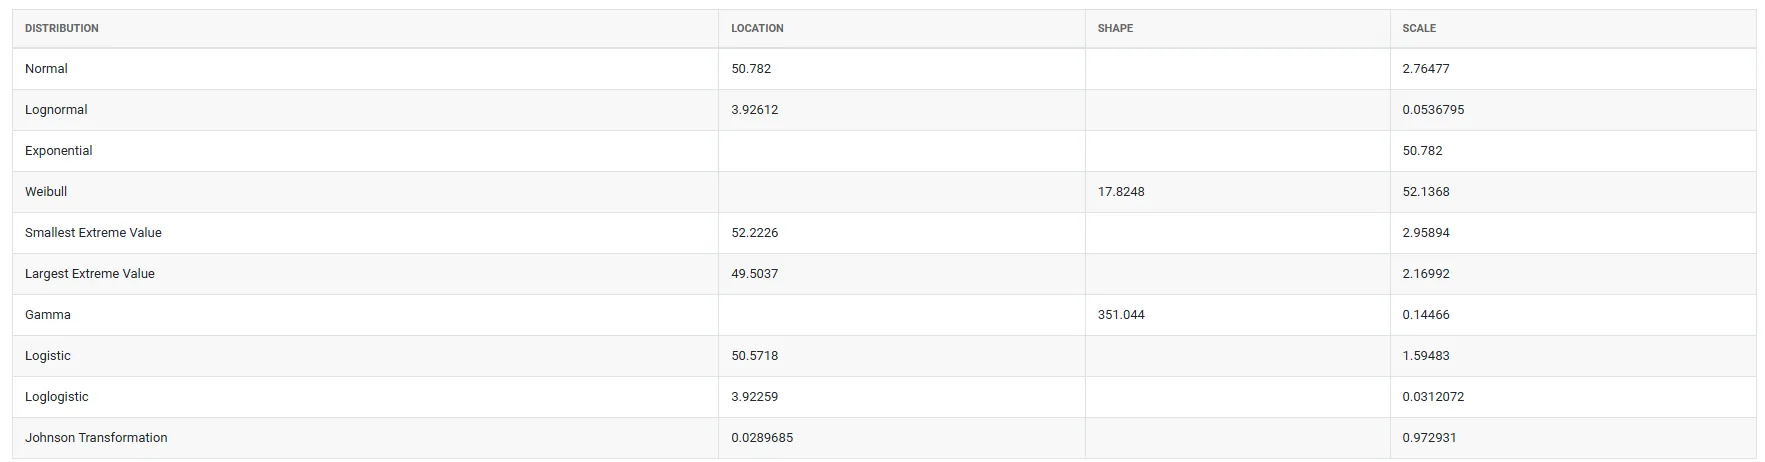
Como fazer a identificação de distribuição individual
O guia é o seguinte:
- Faça login no Zometric Statistical Software em https://statsai.zometric.com/
- Na página inicial, escolha Statistical Tool> Hypothesis Test >Individual Distribution Identification .
- Em seguida, atualize os dados manualmente ou copie todos os dados (Ctrl+C) de uma planilha do Excel e cole-os (Ctrl+V) aqui.
- Preencha as opções necessárias.
- Por fim, clique em calculate na parte inferior da página para obter os resultados desejados.
No painel (dashboard) de Individual Distribution Identification, a janela é dividida em duas partes.
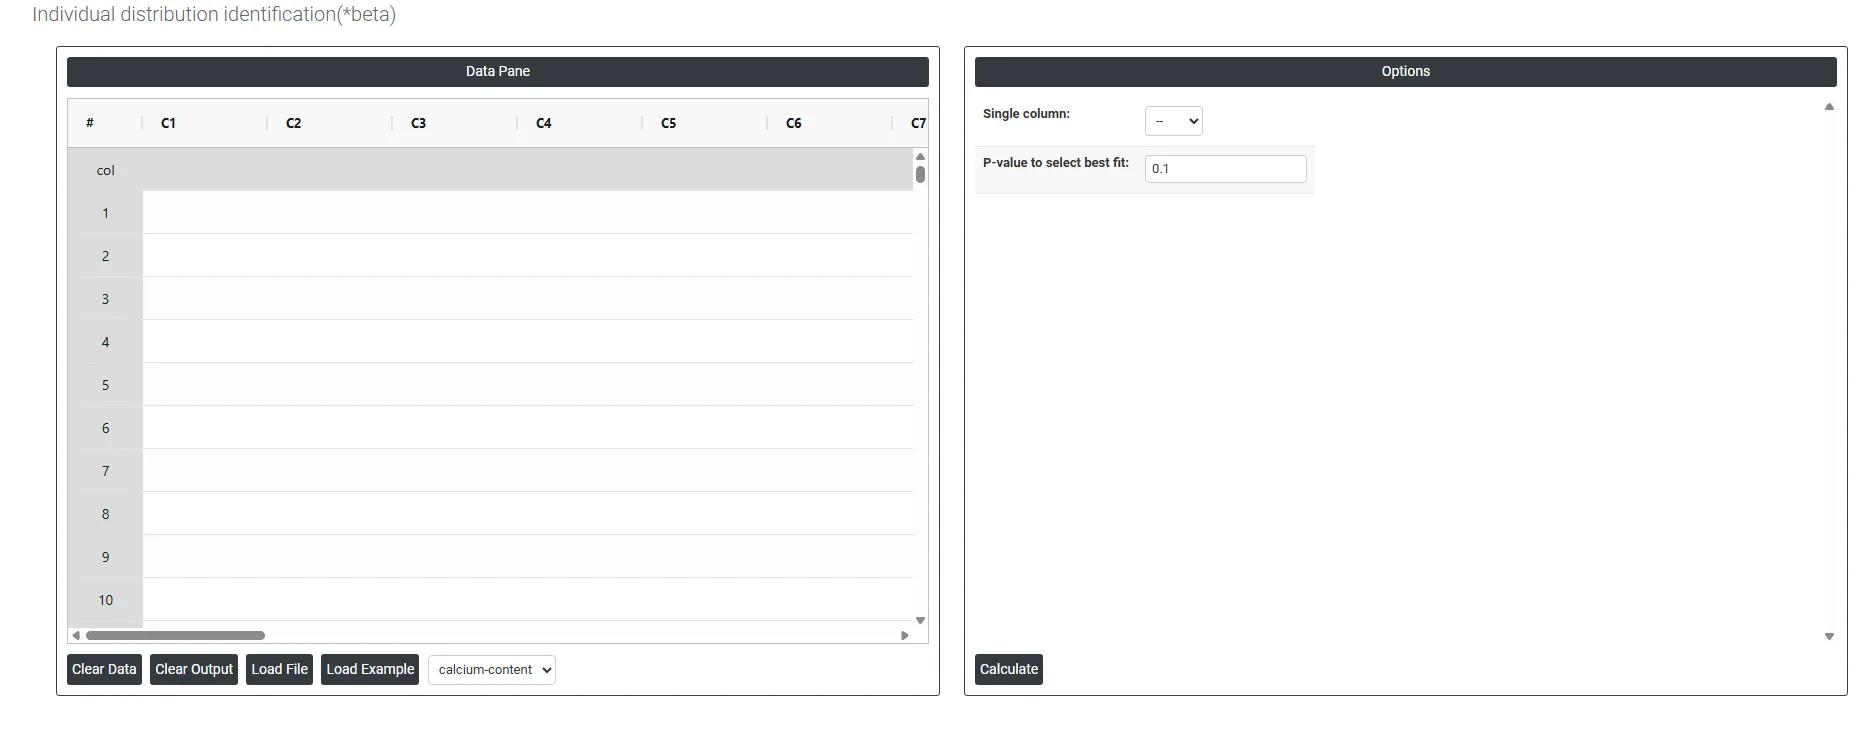
Na parte esquerda fica o painel de dados (Data Pane). No Data Pane, cada linha forma um subgrupo. Os dados podem ser inseridos manualmente, ou você pode copiar todos os dados (Ctrl+C) de uma planilha do Excel e colá-los (Ctrl+V) aqui.
Load example: Os dados de exemplo serão carregados.
Load File: É usado para carregar diretamente os dados do Excel.
Na parte direita, há várias opções, descritas a seguir:
- Single Column: Selecione a coluna que contém os dados contínuos aos quais você quer ajustar distribuições, por exemplo, medições como teores de cálcio, tempos de ciclo, resistência à tração ou tamanhos de partículas. A ferramenta tomará todos os valores dessa coluna e os testará simultaneamente contra várias distribuições de probabilidade para determinar qual descreve melhor a forma e o comportamento dos seus dados. Só é possível selecionar uma coluna por vez, pois cada variável é avaliada de forma independente.
- P-Value to Select Best Fit: Define o limiar de significância usado para determinar quais distribuições oferecem um ajuste aceitável aos seus dados. O padrão é 0.05, o que significa que qualquer distribuição cujo valor-p de aderência de Anderson-Darling seja maior que 0.05 é considerada um ajuste estatisticamente aceitável: não há evidência suficiente para rejeitar essa distribuição como modelo dos seus dados. Como interpretar o valor-p neste contexto:
- Valor-p > 0.05 : a distribuição se ajusta aos dados de forma aceitável. Quanto maior o valor-p, mais forte a evidência de que a distribuição é uma boa correspondência.
- Valor-p ≤ 0.05 : a distribuição não se ajusta bem aos dados e não deve ser usada na análise de capacidade nem em modelagem posterior.
- Quando várias distribuições produzem valores-p aceitáveis, escolha aquela com o maior valor-p como candidata principal, mas sempre combine isso com uma revisão visual do gráfico de probabilidade e considere se a distribuição selecionada faz sentido físico para o seu processo. Uma distribuição que se ajusta estatisticamente, mas não tem base lógica para o seu tipo de dado, deve ser questionada antes do uso.
Perguntas frequentes
O que é a identificação de distribuição individual?
A identificação de distribuição individual ajusta várias distribuições de probabilidade aos seus dados de uma só vez, incluindo Weibull, lognormal, exponencial, logística e gama, e as classifica pela qualidade com que descrevem os dados. É essencial para a análise de capacidade de dados não normais, porque o uso da distribuição errada produz estimativas imprecisas de Pp, Ppk, Cp ou Cpk e previsões enganosas da taxa de defeitos.
Quando usar a identificação de distribuição individual?
Use-a quando os dados não passam em um teste de normalidade e você precisa da distribuição correta antes da análise de capacidade, quando os dados de processo são inerentemente assimétricos, como tempos de ciclo, tempos de falha, concentrações químicas ou tamanhos de partículas, e quando uma transformação Box-Cox não é apropriada, por exemplo, porque os dados contêm zeros ou valores negativos.
Como escolher a distribuição de melhor ajuste?
Uma distribuição cujo valor-p de Anderson-Darling esteja acima do limiar, 0.05 por padrão, é um ajuste aceitável; igual ou abaixo dele, a distribuição não deve ser usada. Quando várias se ajustam, tome a de maior valor-p como candidata principal, mas examine também o gráfico de probabilidade e verifique se a distribuição faz sentido físico para o processo.
De quantos pontos de dados você precisa para a identificação de distribuição?
Colete pelo menos 50 a 100 pontos de dados, pois amostras pequenas não fornecem informação suficiente para distinguir entre as distribuições. Os dados também devem vir de um processo estável e sob controle, já que o ajuste de distribuições a dados de um processo instável produz resultados sem significado.