
Capacidade de processo de múltiplas variáveis
O Multiple Variables Process Capability avalia duas ou mais colunas, como cavidades, máquinas ou linhas, contra um LSL/USL compartilhado e um Target opcional. Use-o para encontrar o processo de pior desempenho sem comparar relatórios separados. Assume-se que toda variável é Normal, sem teste de normalidade por variável. A saída é uma tabela de comparação com N, Mean, StDev, Pp, Ppk, Cpm e PPM, mais um histograma por variável.
Última revisão
Conclusão principal
A capacidade de processo de múltiplas variáveis compara vários processos paralelos, como cavidades de molde, máquinas ou linhas, com uma especificação compartilhada em uma única tabela de Pp, Ppk e Cpm, para mostrar qual é o pior.
Nesta página
Finalidade
O Multiple Variables Process Capability responde a uma pergunta específica e comum que as ferramentas de capacidade já existentes no aplicativo só conseguiam responder de forma indireta: quando a mesma característica é medida em várias variáveis paralelas — diferentes cavidades de um molde de injeção, diferentes máquinas, diferentes linhas — contra uma única especificação compartilhada, qual delas é a pior? Em vez de executar N relatórios de capacidade separados e compará-los a olho, esta ferramenta produz UMA tabela de comparação unificada, lado a lado, e um único conjunto de histogramas, de modo que os índices da família Cp/Cpk de cada variável fiquem na mesma tabela.
Principais recursos
- Selecione quaisquer 2 ou mais colunas e obtenha uma única tabela de comparação agregada, em vez de N relatórios empilhados.
- Um único par LSL/USL é aplicado de modo uniforme a todas as variáveis selecionadas, de forma que a comparação seja sempre justa, contra a mesma especificação.
- Um Target compartilhado opcional acrescenta à mesma tabela de comparação o índice Cpm de cada variável.
- Histogramas por variável com os limites de especificação compartilhados sobrepostos, ao lado da tabela agregada.
- Multiplicador de tolerância K-sigma configurável, coerente com as demais ferramentas de capacidade do aplicativo.
Métodos estatísticos
Cada variável/coluna selecionada é tratada como um processo independente e passa pelo mesmo mecanismo de capacidade Normal usado no caminho Normal da ferramenta Automated Process Capability. Para cada uma, σ_overall é estimado pelo método da amplitude móvel (MRbar/d2, ou mediana das amplitudes móveis), e calcula-se a família padrão de índices de desempenho baseados em z: Pp = (USL − LSL) / (K·σ), Ppu = (USL − x̄) / ((K/2)·σ), Ppl = (x̄ − LSL) / ((K/2)·σ), Ppk = min(Ppu, Ppl), com K = 6 por padrão. Aqui, toda variável sempre assume Normalidade — esta ferramenta não tem teste de normalidade por variável nem roteamento para dados não normais.
Quando um Target compartilhado é informado, o Cpm é calculado adicionalmente por variável: Cpm = (USL − LSL) / (K·√(mean((x − Target)²))), penalizando uma variável cuja média esteja fora do alvo mesmo que sua dispersão, isoladamente, parecesse capaz.
Como toda variável é avaliada contra o mesmo LSL/USL (e o mesmo Target, quando informado), os valores resultantes de Ppk e Cpm são diretamente comparáveis entre as variáveis — a variável com o menor Ppk (ou Cpm) na tabela de comparação é a de pior desempenho em relação à especificação compartilhada.
O PPM Expected é calculado a partir da probabilidade de cauda da distribuição Normal ajustada além de cada limite de especificação para aquela variável; o PPM Observed é a fração empírica da própria amostra da variável que cai fora dos limites de especificação — permitindo ao usuário identificar casos em que os dois discordam (sinal de que a premissa de distribuição Normal pode não valer para aquela variável em particular).
Campos de entrada e opções
Campo | Descrição |
Process variables | Obrigatório. Selecione 2 ou mais colunas para comparar — cada coluna é tratada como o seu próprio processo. |
LSL / USL | Aplicados a todas as variáveis selecionadas. |
Target | Opcional. Acrescenta à tabela de comparação o índice Cpm de cada variável. |
Tolerance (K) | Multiplicador aplicado ao sigma ao formar a faixa de tolerância da capacidade; padrão 6. |
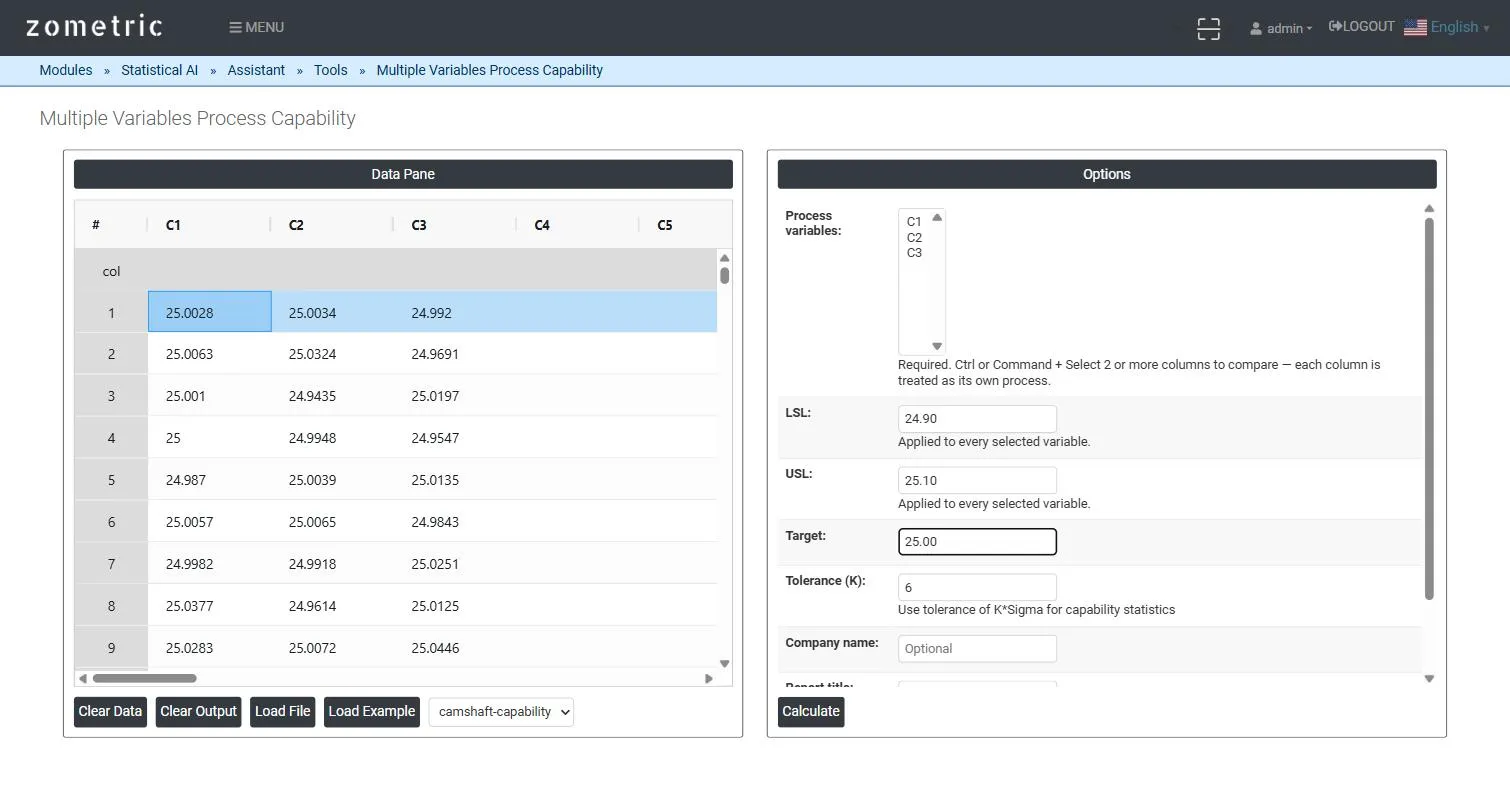
Figura 1 — Data pane com leituras do diâmetro do furo de 3 cavidades em C1–C3, as três selecionadas como Process variables, com LSL/USL/Target compartilhados.
Descrição da saída
- Comparison table — uma linha por variável selecionada, com N, Mean, StDev, Pp, Ppl, Ppu, Ppk, Cpm (quando Target é informado), PPM Expected e PPM Observed, todos contra os mesmos limites de especificação compartilhados.
- Per-variable histogram — a distribuição própria de cada variável com as linhas de referência LSL/Target/USL compartilhadas e uma curva Normal ajustada.
- Exportação em PDF do relatório de comparação completo por meio de Download as PDF.
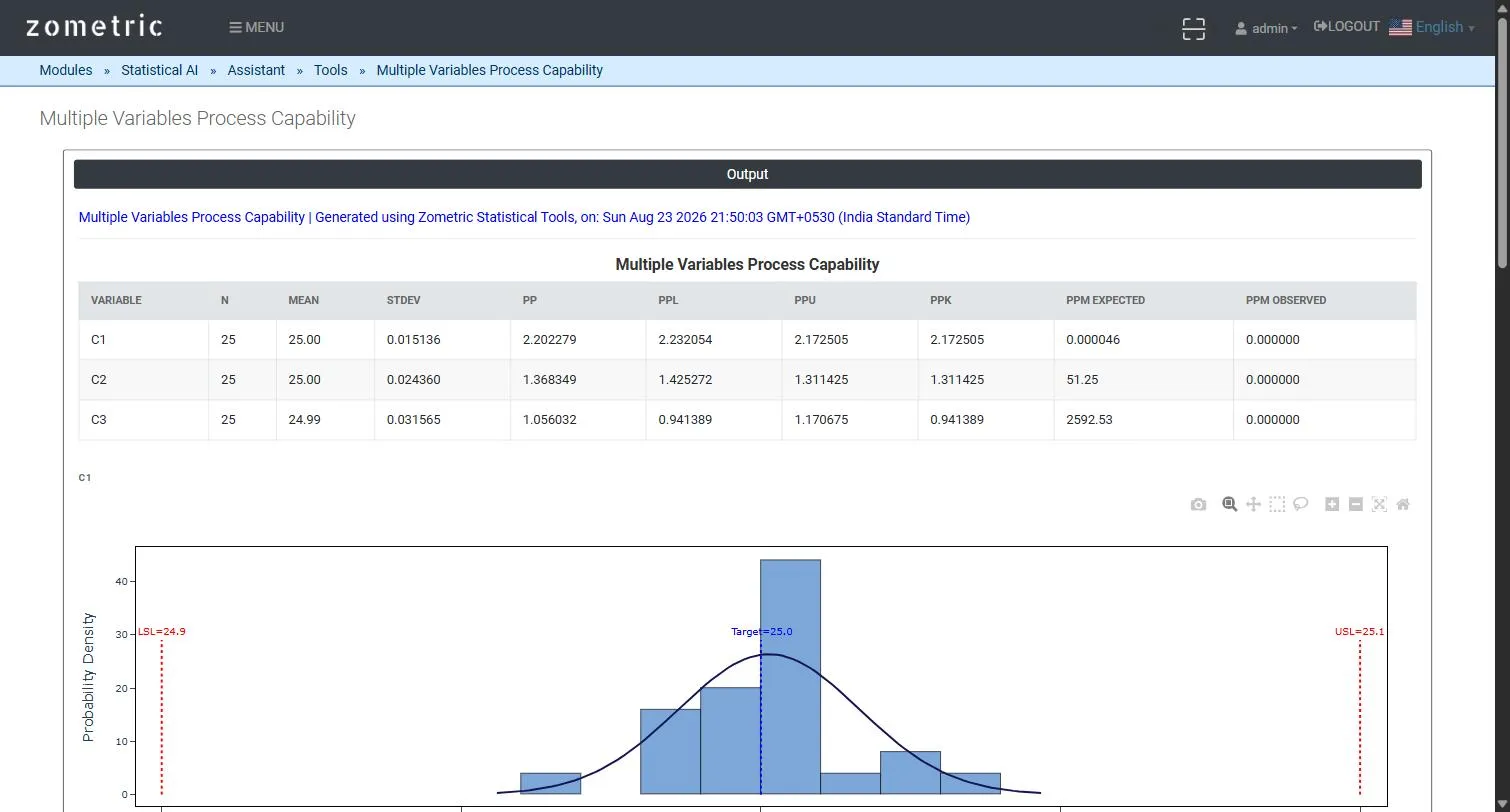
Figura 2 — A tabela de comparação unificada (N, Mean, StDev, Pp, Ppl, Ppu, Ppk, Cpm, PPM Expected, PPM Observed por variável) com o histograma da primeira variável.
Exemplo prático
Uma ferramenta de moldagem por injeção tem 3 cavidades que produzem a mesma peça; o diâmetro do furo (mm) é medido em 25 peças de cada cavidade (C1 = Cavidade 1, C2 = Cavidade 2, C3 = Cavidade 3), contra LSL = 24.90, USL = 25.10 e Target = 25.00 compartilhados. A tabela de comparação mostra a Cavidade 1 com a menor dispersão (Ppk ≈ 2.17, Cpm ≈ 2.24) e a Cavidade 3 visivelmente pior (Ppk ≈ 0.94) — sinalizando de imediato a Cavidade 3 como a que precisa de atenção, sem ter de executar e comparar manualmente três relatórios separados.
Perguntas frequentes
O que é a capacidade de processo de múltiplas variáveis?
É uma análise de capacidade que compara a mesma característica medida em várias variáveis paralelas, como diferentes cavidades de molde, máquinas ou linhas, contra uma única especificação compartilhada. Em vez de relatórios separados, produz uma tabela de comparação lado a lado com os valores de Pp, Ppl, Ppu, Ppk, Cpm e PPM, de modo que a variável de pior desempenho seja fácil de identificar.
Como identificar o pior processo em um estudo de capacidade de múltiplas variáveis?
Como toda variável é avaliada contra os mesmos LSL, USL e Target, os valores de Ppk e Cpm são diretamente comparáveis. A variável com o menor Ppk, ou o menor Cpm quando um Target é informado, é a de pior desempenho em relação à especificação compartilhada e deve ser investigada primeiro.
A capacidade de processo de múltiplas variáveis pressupõe normalidade?
Sim. Toda variável é analisada com um cálculo de capacidade Normal, e não há teste de normalidade por variável nem roteamento para dados não normais. Comparar o PPM Expected, obtido da cauda Normal ajustada, com o PPM Observed, a fração real fora da especificação, ajuda a identificar variáveis em que os dois discordam, sinal de que a premissa Normal pode não valer.
O que o Cpm acrescenta à comparação?
Quando um Target compartilhado é informado, o Cpm é calculado para cada variável como (USL - LSL) dividido por K vezes a raiz do desvio quadrático médio em relação ao Target. Ele penaliza uma variável cuja média esteja fora do alvo, mesmo que sua dispersão, isoladamente, parecesse capaz.