
Capacidade de processo de múltiplas variáveis (não normal)
Esta ferramenta compara a capacidade de duas ou mais colunas com uma única especificação quando os dados são assimétricos, como tamanho de partícula, planicidade ou impureza. Ajusta a cada coluna um modelo escolhido entre quinze, incluindo Weibull, Lognormal, Box-Cox e Johnson, usando o método Z-Score ou ISO. Cada coluna precisa de pelo menos 4 valores. A saída é uma tabela de Pp, PPL, PPU, Ppk e PPM, além de histogramas.
Última revisão
Conclusão principal
A capacidade de processo de múltiplas variáveis (não normal) compara vários processos com uma mesma especificação quando os dados não são normais, ajustando a mesma distribuição a cada um e listando Pp, Ppk e PPM lado a lado.
Nesta página
Finalidade
A capacidade de processo de múltiplas variáveis (não normal) compara a capacidade de vários processos, linhas, máquinas ou cavidades com uma mesma especificação quando os dados não são normalmente distribuídos. Ela ajusta a mesma distribuição a cada coluna separadamente e coloca Pp, PPL, PPU, Ppk e as partes por milhão esperadas e observadas fora da especificação lado a lado em uma única tabela, com um histograma para cada coluna. Use-a para características assimétricas, como tamanho de partícula, planicidade, batimento ou impureza, em que um Ppk baseado na normal avalia mal a cauda, e você quer ordenar os processos.
Principais recursos
- Duas ou mais colunas, cada uma tratada como um processo próprio e ajustada de forma independente.
- Quinze modelos: Weibull, Exponential, Logistic, Loglogistic, Largest and Smallest Extreme Value, 2-Parameter Exponential, 3-Parameter Weibull, Gamma, Lognormal, 3-Parameter Lognormal, 3-Parameter LogLogistic, transformações Box-Cox e Johnson e uma Mixed Distribution (ISO 22514-2).
- Método Z-Score ou de percentis ISO para os índices.
- Especificações unilaterais ou bilaterais aplicadas a todas as colunas.
- Tabela de comparação com Pp, PPL, PPU, Ppk, PPM Expected e PPM Observed, e um histograma de cada coluna com os limites de especificação e a curva ajustada.
Métodos estatísticos
Para cada coluna, a distribuição escolhida é ajustada por máxima verossimilhança (Weibull, Gamma e Exponential com o limiar fixado em 0; os modelos de 3 parâmetros o estimam). A Lognormal usa a média e o desvio padrão dos dados em log. Box-Cox e Johnson transformam os dados para a normal e trabalham na escala transformada; a Mixed Distribution ajusta uma mistura de distribuições normais, com o número de componentes escolhido pelo BIC, a menos que seja fixado. Cada coluna precisa de pelo menos 4 valores.
Método Z-Score (padrão): as probabilidades ajustadas além de cada limite são convertidas em escores normais, Z_USL = Φ⁻¹(F(USL)) e Z_LSL = Φ⁻¹(F(LSL)), em que F é a distribuição acumulada ajustada. Então PPU = Z_USL / 3, PPL = −Z_LSL / 3, Pp = (Z_USL − Z_LSL) / 6 e Ppk = min(PPL, PPU). Método ISO: os índices usam os percentis ajustados X₀.₁₃₅, X₅₀ e X₉₉.₈₆₅ (os pontos que cobrem a mesma parcela de ±3σ de uma normal): Pp = (USL − LSL) / (X₉₉.₈₆₅ − X₀.₁₃₅), PPL = (X₅₀ − LSL) / (X₅₀ − X₀.₁₃₅), PPU = (USL − X₅₀) / (X₉₉.₈₆₅ − X₅₀). Com apenas um limite, o Pp não é informado e o Ppk é o índice unilateral.
PPM Expected é a parcela ajustada da população além dos limites, vezes 1,000,000; PPM Observed é a parcela dos valores da amostra além deles. São índices globais (de longo prazo), calculados com todos os dados. Eles só são tão bons quanto a distribuição: o mesmo modelo é aplicado a todas as colunas, então verifique o ajuste de cada uma (por exemplo, com a Identificação de Distribuição Individual) antes de comparar as colunas.
Campos de entrada e opções
Campo | Descrição |
Process variables | Obrigatório. Duas ou mais colunas numéricas a comparar; cada uma é ajustada por conta própria. |
Fit distribution | Obrigatório. Um dos quinze modelos listados acima (padrão Weibull), aplicado a todas as colunas. |
Mixture components | Somente para Mixed Distribution (ISO 22514-2): Auto (selecionado pelo BIC, padrão) ou de 2 a 6 componentes. |
Method of analysis | Z-Score (padrão) ou ISO. |
LSL / USL | Limites de especificação aplicados a todas as colunas; pelo menos um é obrigatório, e o LSL deve ser menor que o USL. |
Company name / Report title | Texto opcional para o relatório; título padrão Multiple Variables Process Capability (Nonnormal). |
Data Options: Subset (optional) | Exclude matching rows (padrão) ou Include only matching rows, por números de linha (ex.: 3,7,12-15) e/ou uma condição. |
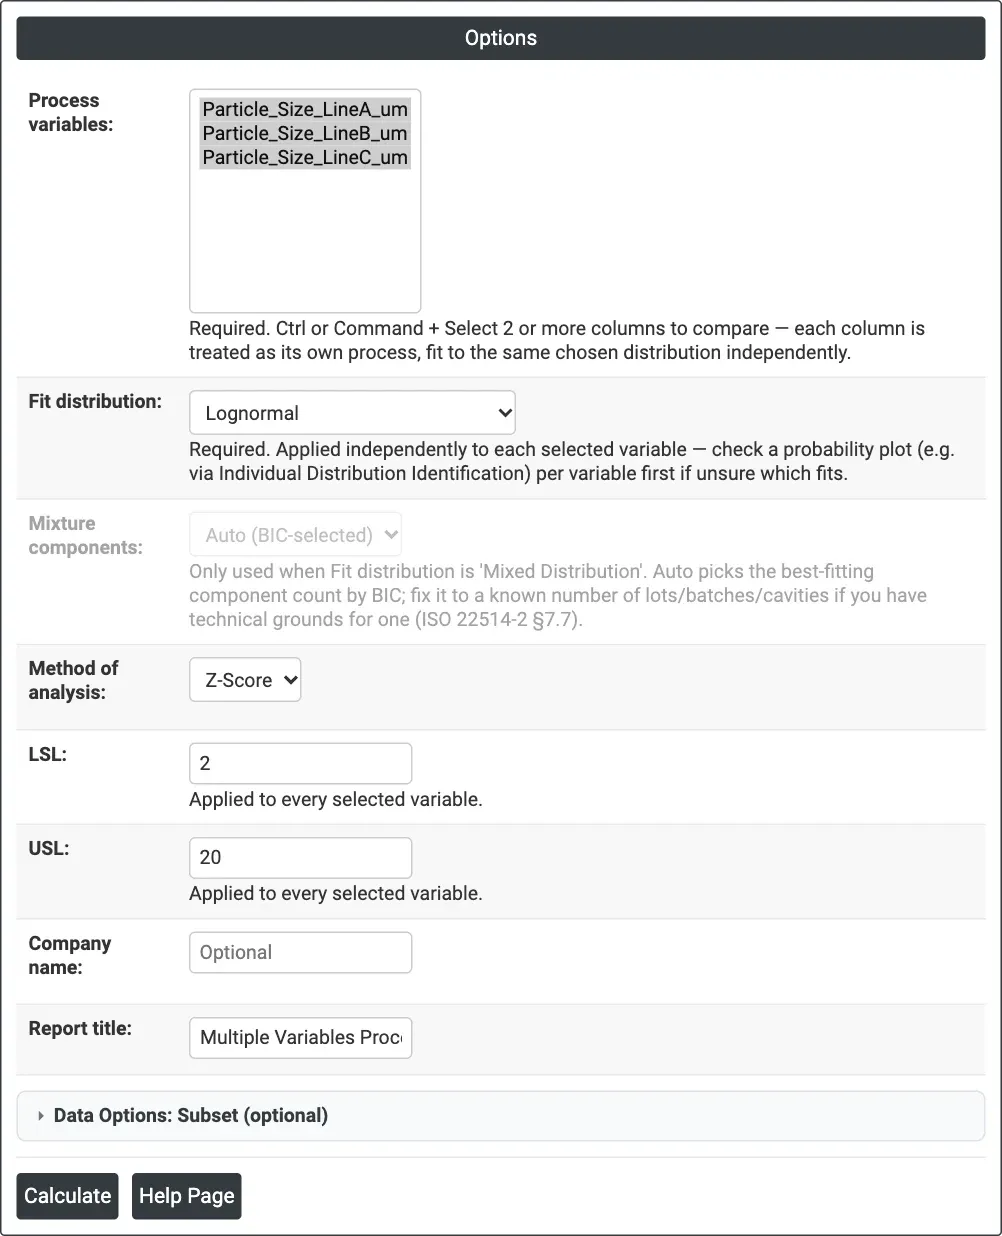
Figura 1 — Opções do exemplo: tamanho de partícula de três linhas, Lognormal, método Z-Score, LSL 2 µm e USL 20 µm.
Descrição da saída
- Multiple Variables Process Capability (Nonnormal) — uma linha por coluna: Variable, N, Distribution, Pp, PPL, PPU, Ppk, PPM Expected e PPM Observed.
- Histogram of <distribution> Distribution — um por coluna, sob o nome da coluna, com o LSL e o USL e a curva de densidade ajustada.
- Exportação em PDF por meio de Download.
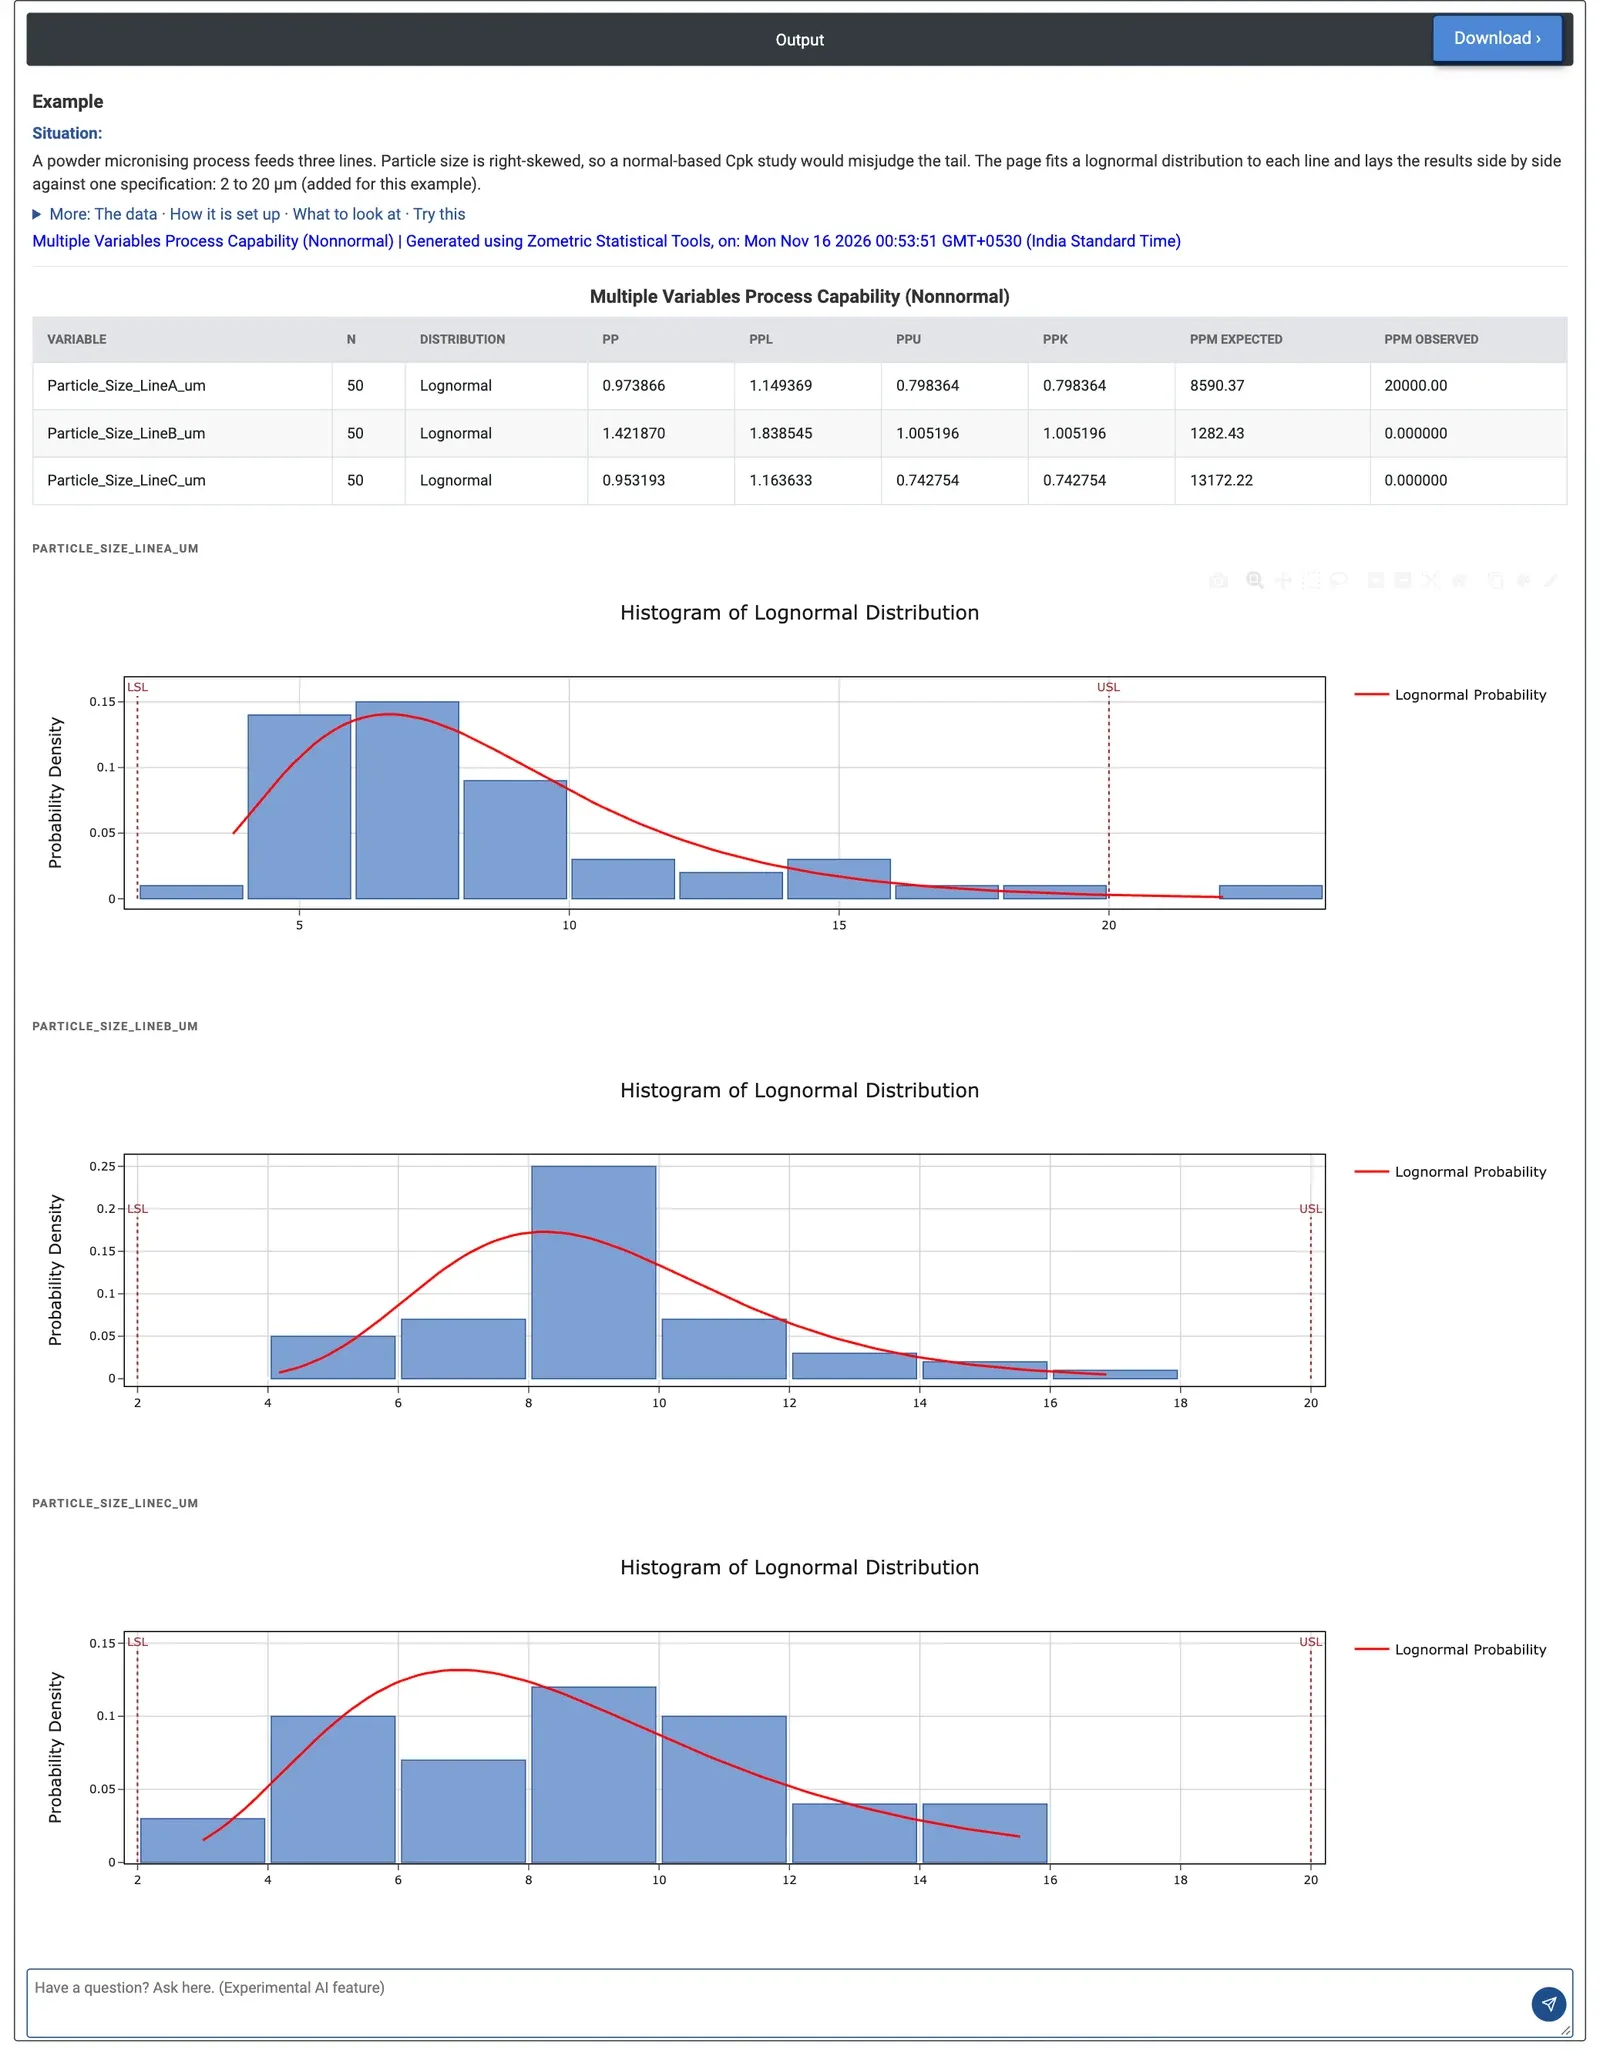
Figura 2 — Tabela de comparação e histogramas lognormais das três linhas: Ppk 0.798 na linha A, 1.005 na linha B e 0.743 na linha C, com PPU abaixo de PPL em todas as linhas; somente a linha A tem uma amostra acima do USL.
Exemplo prático
Um processo de micronização de pó alimenta três linhas, e o tamanho de partícula é assimétrico à direita (mediana de cerca de 7 a 9 µm, com uma cauda longa em direção às partículas grossas). O engenheiro de processos quer comparar as linhas com uma especificação de 2 a 20 µm, usando 50 amostras de cada uma. Process variables = Particle_Size_LineA_um, Particle_Size_LineB_um e Particle_Size_LineC_um, Fit distribution = Lognormal, Method of analysis = Z-Score, LSL = 2, USL = 20.
A linha A tem Ppk 0.798 e 8,590 PPM esperados fora da especificação; uma amostra (22.11 µm) já está acima de 20 µm, de modo que 20,000 PPM são observados. A linha B é a melhor, com Ppk 1.005 e 1,282 PPM esperados, mas ainda abaixo da meta usual de 1.33. A linha C é a mais arriscada, com Ppk 0.743 e 13,172 PPM esperados. Em todas as linhas o PPU é menor que o PPL: o risco são as partículas grossas acima de 20 µm, e não as finas abaixo de 2 µm; portanto, o trabalho de melhoria deve visar a cauda grossa, começando pela linha C. Os histogramas mostram o mesmo quadro: cada curva ajustada tem sua cauda longa em direção ao USL e, na linha A, uma barra fica além dele.
O modelo importa. Com o método ISO, os valores de Ppk caem para 0.694, 1.008 e 0.619, com a mesma ordenação. Com um ajuste Weibull, o PPL passa a ser o menor índice em todas as linhas e a ordenação muda (Ppk 0.641, 0.948 e 0.798, com a linha A agora a pior). As estatísticas de Anderson-Darling calculadas separadamente a partir desta página favorecem a lognormal nas linhas A e B (0.79 contra 2.17 e 0.63 contra 1.34), mas a Weibull na linha C (0.20 contra 0.55); portanto, as linhas devem ser verificadas uma a uma antes de a ordenação ser usada para decisões.
Perguntas frequentes
Quando usar a análise de capacidade não normal para múltiplas variáveis?
Use-a para comparar e ordenar a capacidade de vários processos, linhas, máquinas ou cavidades com uma mesma especificação quando os dados não são normalmente distribuídos. Exemplos típicos são características assimétricas, como tamanho de partícula, planicidade, batimento ou impureza, em que um Ppk baseado na normal avalia mal a cauda da distribuição.
Qual é a diferença entre os métodos Z-Score e ISO?
O método Z-Score converte as probabilidades ajustadas além de cada limite em escores normais e divide por 3 para obter PPU e PPL. O método ISO usa os percentis ajustados 0.135, 50 e 99.865 no lugar da dispersão de ±3 sigma da normal. Os dois podem dar valores de Ppk diferentes, como mostra o exemplo prático, embora a ordenação possa permanecer a mesma.
Por que a escolha da distribuição importa na capacidade não normal?
Os índices só são tão bons quanto a distribuição ajustada, e o mesmo modelo é aplicado a todas as colunas. No exemplo prático, passar da Lognormal para a Weibull mudou qual índice era o menor e mudou a ordenação das linhas. Verifique o ajuste de cada coluna, por exemplo com a Identificação de Distribuição Individual, antes de compará-las.
Qual é a diferença entre PPM Expected e PPM Observed?
PPM Expected é a parcela da população, segundo a distribuição ajustada, além dos limites de especificação, vezes 1,000,000. PPM Observed é a parcela dos valores reais da amostra além dos limites. Ambos são medidas globais, de longo prazo, calculadas a partir de todos os dados de cada coluna.