
Regressão logística nominal
A regressão logística nominal é uma ferramenta estatística usada para analisar a relação entre uma ou mais variáveis preditoras e uma variável de resposta categórica com três ou mais categorias não ordenadas, como arranhão, amassado ou rasgo. Ela prevê a probabilidade de ocorrência de cada categoria com base nos valores dos preditores.
Última revisão
Conclusão principal
A regressão logística nominal é uma ferramenta estatística usada para analisar a relação entre uma ou mais variáveis preditoras e uma variável de resposta categórica com três ou mais categorias não ordenadas.
Nesta página
O que é a regressão logística nominal?
A regressão logística nominal é uma ferramenta estatística usada para analisar a relação entre uma ou mais variáveis preditoras e uma variável de resposta categórica com três ou mais categorias não ordenadas , como arranhão, amassado ou rasgo. Ela prevê a probabilidade de ocorrência de cada categoria com base nos valores dos preditores.
Quando usar a regressão logística nominal?
Variáveis preditoras
- Os preditores podem ser contínuos, categóricos ou uma mistura dos dois
- Variáveis discretas podem ser tratadas como contínuas ou categóricas, dependendo do número de níveis e do objetivo da análise
- Apenas um preditor contínuo com resposta contínua → use o gráfico de linha ajustada
- Vários preditores com resposta contínua → use Ajustar modelo de regressão
Variável de resposta
- A resposta deve ter três ou mais categorias sem ordem natural (ex.: cor, tipo de material, tipo de defeito)
- Se a resposta for contínua → use Ajustar modelo de regressão
- Se a resposta tiver duas categorias (aprovado/reprovado) → use Ajustar modelo logístico binário
- Se a resposta tiver categorias ordenadas (baixo/médio/alto) → use a regressão logística ordinal
Diretrizes para o uso correto da regressão logística nominal
- A variável de resposta deve ter três ou mais categorias não ordenadas; se as categorias tiverem uma ordem natural, use a regressão logística ordinal.
- Os preditores podem ser contínuos ou categóricos; verifique se cada variável está classificada corretamente antes de executar a análise.
- Garanta que os dados representem com precisão a população-alvo; dados enviesados ou incompletos produzirão previsões pouco confiáveis.
- Colete pontos de dados suficientes por categoria : poucas observações em qualquer categoria tornam o modelo instável e as previsões não confiáveis.
- Meça todas as variáveis com a maior exatidão possível; erros nos dados de entrada reduzem diretamente a exatidão das probabilidades previstas.
- Registre os dados na ordem em que são coletados para ajudar a identificar padrões temporais que possam afetar os resultados.
- Depois do ajuste, valide o modelo usando estatísticas de qualidade do ajuste e diagnósticos de resíduos; um modelo mal ajustado produz previsões de categoria enganosas.
- Verifique se nenhuma categoria tem observações de menos : categorias raras reduzem a confiabilidade do modelo e podem causar problemas de estimação.
Alternativas: quando não usar a regressão logística nominal
- Se a variável de resposta for contínua, use Ajustar modelo de regressão .
- Se você tem apenas um preditor contínuo com resposta contínua, use o gráfico de linha ajustada .
- Se a resposta tem duas categorias (ex.: aprovado/reprovado), use Ajustar modelo logístico binário .
- Se as categorias da resposta têm uma ordem natural (ex.: baixo/médio/alto), use a regressão logística ordinal .
- Se você tem um preditor categórico com resposta contínua, use a ANOVA de um fator .
Exemplo de regressão logística nominal
Para avaliar a eficácia de diferentes métodos de ensino, um administrador escolar reúne dados de 30 alunos, registrando a disciplina favorita de cada aluno e o método de ensino usado em sua sala de aula. Como a variável de resposta, a preferência por disciplina (matemática, ciências ou língua portuguesa), é categórica e sem ordem inerente, o administrador aplica a regressão logística nominal. Essa análise ajuda a explorar como a idade dos alunos (de 10 a 13 anos) e o tipo de método de ensino (demonstração ou explicação) se associam às preferências por disciplina. As etapas são as seguintes:
- Coletou os dados necessários.
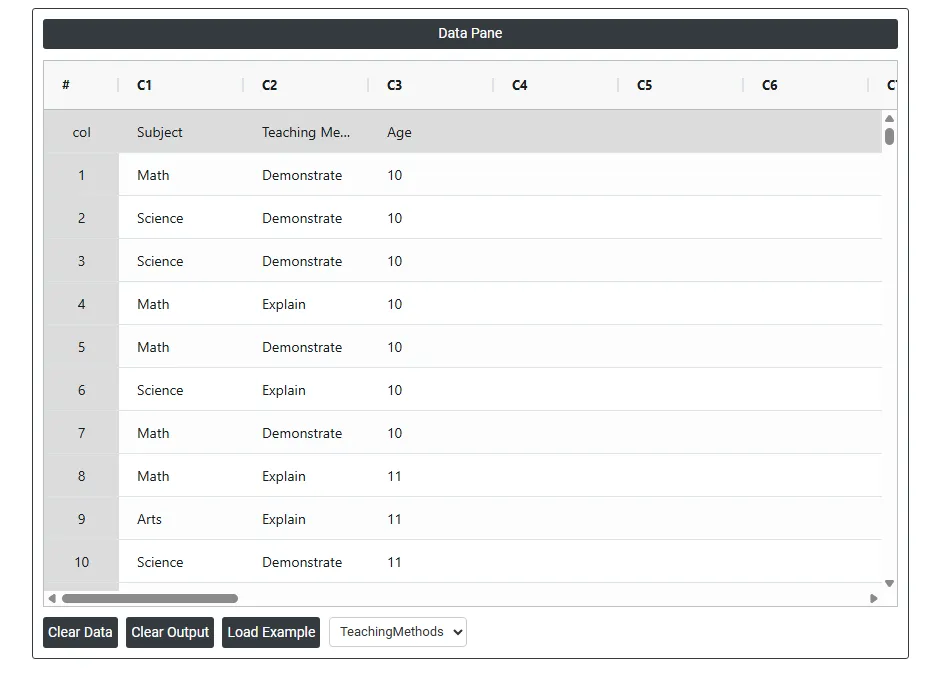
- Em seguida, analise os dados no Zometric Statistical Software em https://statsai.zometric.com/.
- Para encontrar a regressão logística nominal, escolha Statistical module> Regression>Nominal Logistic Regression.
- Na ferramenta, insira os dados e as demais entradas da seguinte forma:
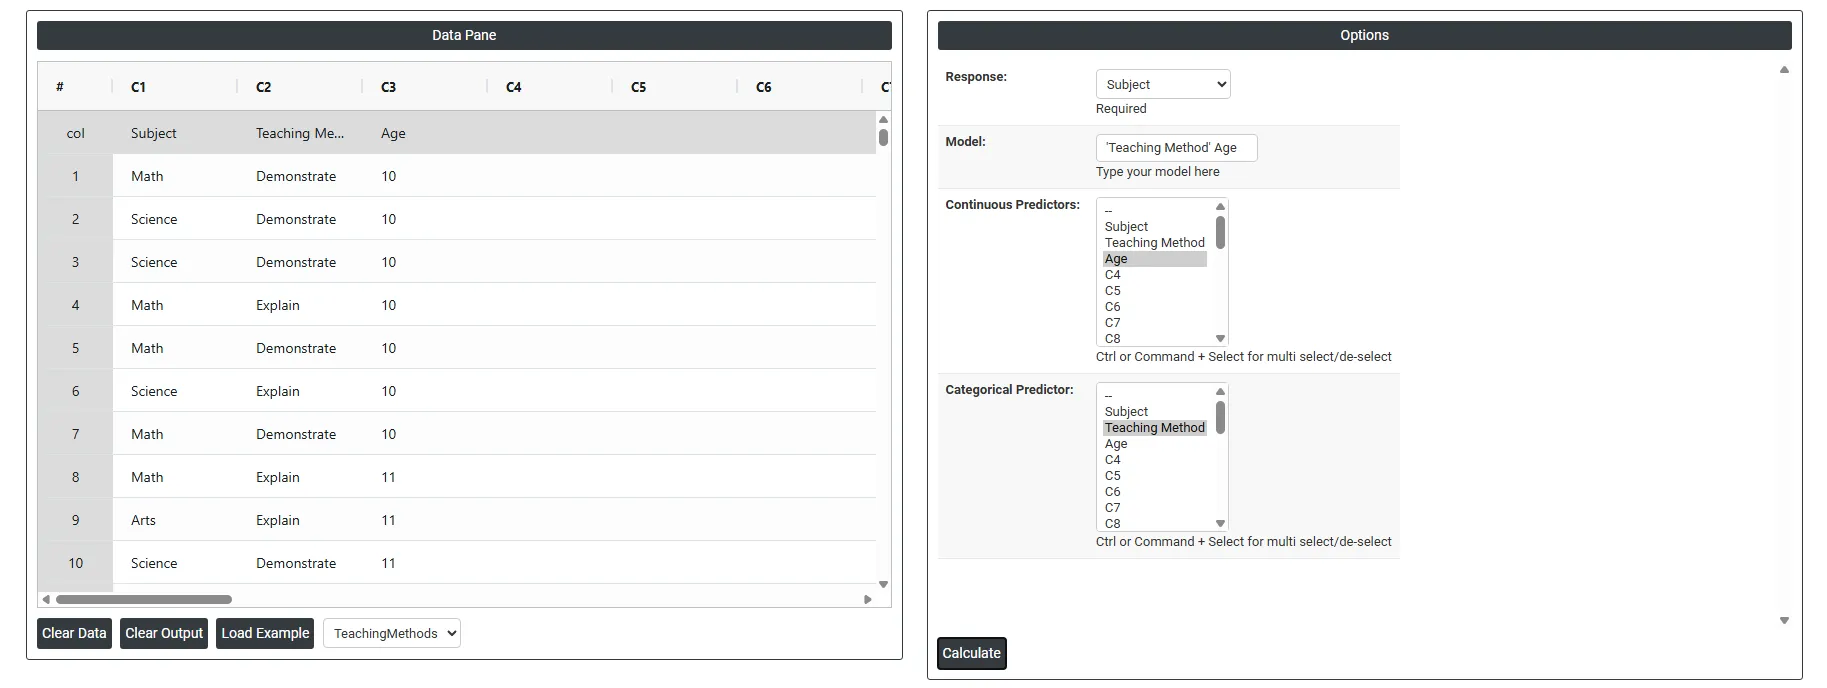
5. Depois de usar a ferramenta mencionada acima, obtém-se a saída a seguir
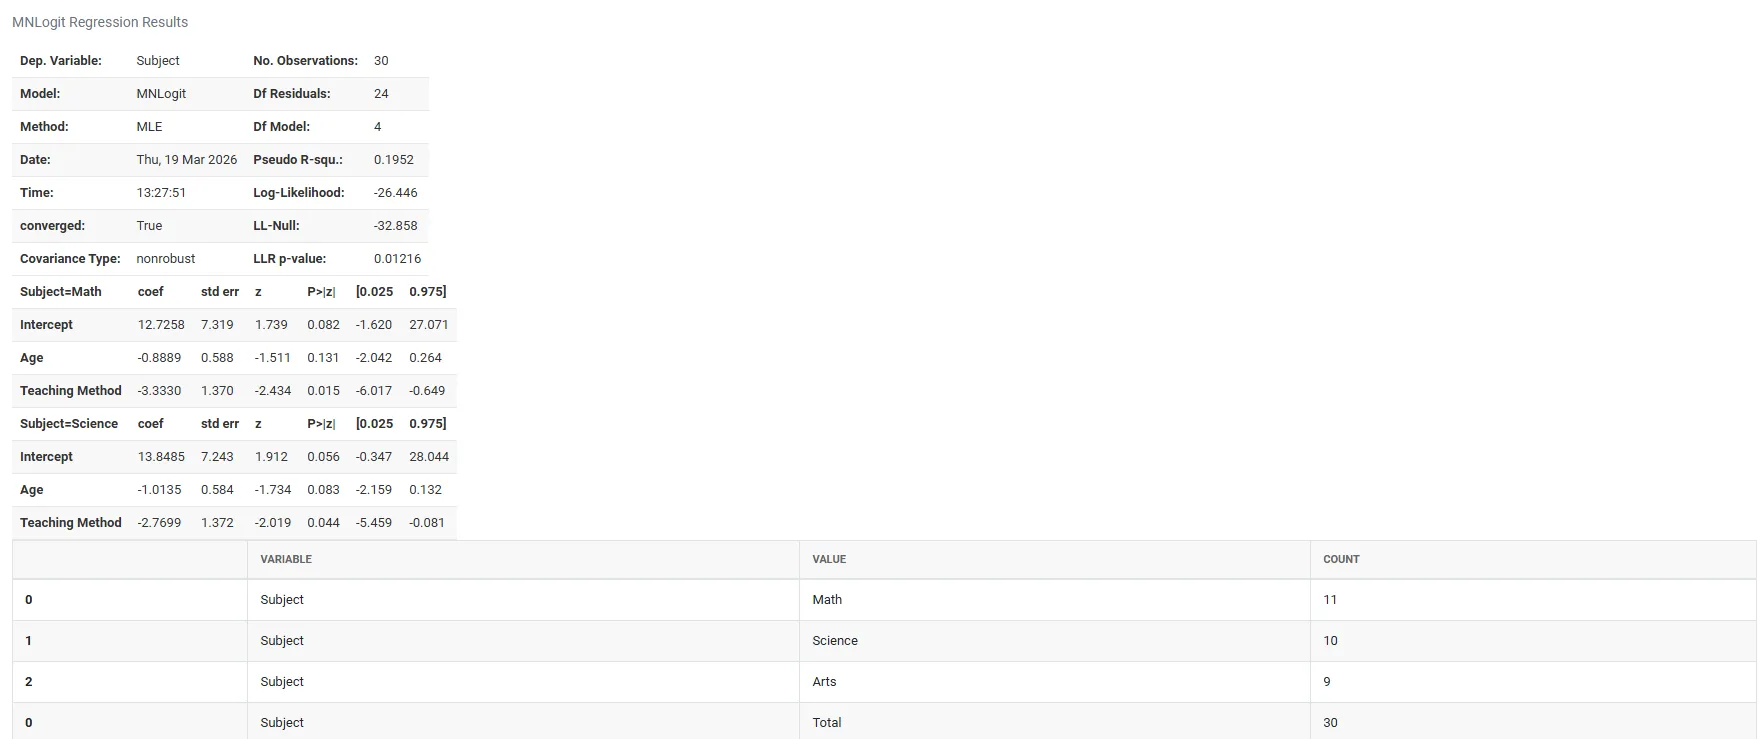
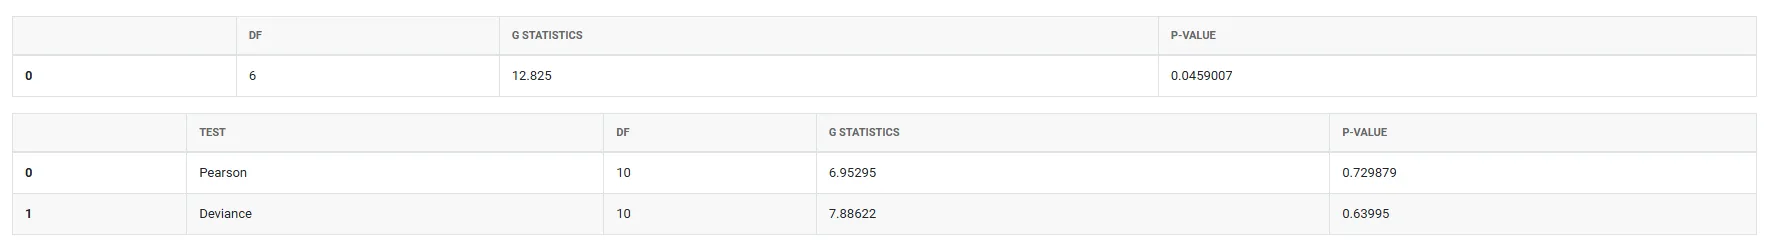
Como fazer a regressão logística nominal
O guia é o seguinte:
- Faça login no Zometric Statistical Software em https://statsai.zometric.com/
- Na página inicial, escolha Statistical Tool> Regression > Nominal Logistic Regression.
- Em seguida, atualize os dados manualmente ou copie todos os dados (Ctrl+C) de uma planilha do Excel e cole-os (Ctrl+V); outra opção é Load Example, que carrega os dados de exemplo.
- Em seguida, preencha as opções necessárias.
- Por fim, clique em calculate na parte inferior da página para obter os resultados desejados.
No painel (dashboard) da regressão logística nominal, a janela é dividida em duas partes.
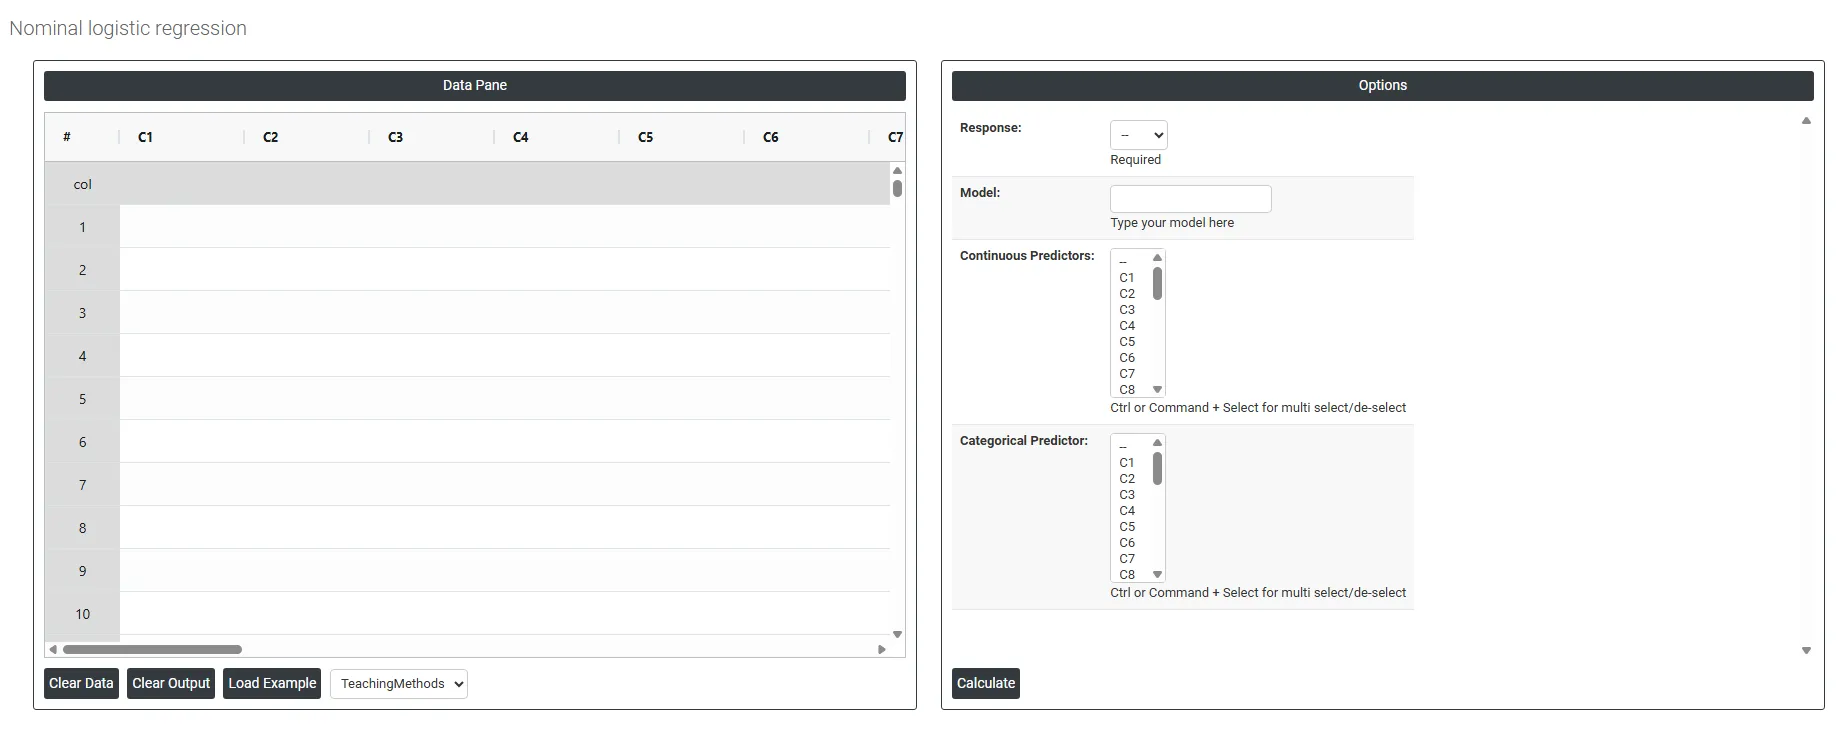
Na parte esquerda fica o painel de dados (Data Pane). No Data Pane, cada linha forma um subgrupo. Os dados podem ser inseridos manualmente, ou você pode copiar todos os dados (Ctrl+C) de uma planilha do Excel e colá-los (Ctrl+V) aqui.
Load example: Os dados de exemplo serão carregados.
Load File: É usado para carregar diretamente os dados do Excel.
Na parte direita, há várias opções, descritas a seguir:
- Response: A variável de resultado que você tenta prever ou classificar; ela deve conter três ou mais categorias sem ordem natural, como tipo de defeito (arranhão, amassado, rasgo) ou forma de pagamento (dinheiro, cartão, on-line). O modelo estima a probabilidade de ocorrência de cada categoria com base nos valores dos preditores fornecidos.
- Categorical Predictor: Uma variável preditora que contém um conjunto fixo de grupos ou rótulos distintos, como tipo de máquina, turno ou material. Esses grupos não têm distância mensurável entre si. Cada categoria é tratada como um nível separado, e o modelo estima como cada grupo influencia a probabilidade de cada categoria de resposta.
- Continuous Predictor: Uma variável preditora que pode assumir qualquer valor numérico mensurável dentro de um intervalo, como temperatura, pressão ou tempo. O modelo usa esses valores para estimar como o aumento de uma unidade no preditor desloca a probabilidade de a resposta cair em cada categoria.
- Model: Define quais preditores e termos de interação são incluídos na análise. Por padrão, a análise constrói um modelo de efeitos principais com todos os preditores selecionados. Você pode personalizá-lo para incluir termos de interação (ex.: A*B) se acreditar que dois preditores influenciam conjuntamente a resposta. Escolher a estrutura de modelo certa é importante: incluir termos desnecessários acrescenta ruído, enquanto omitir termos-chave leva a previsões imprecisas.
Perguntas frequentes
O que é a regressão logística nominal?
A regressão logística nominal analisa a relação entre uma ou mais variáveis preditoras e uma resposta categórica com três ou mais categorias não ordenadas, como arranhão, amassado ou rasgo. Ela prevê a probabilidade de ocorrência de cada categoria de resposta com base nos valores dos preditores. Os preditores podem ser contínuos, categóricos ou uma mistura dos dois.
Qual é a diferença entre a regressão logística nominal e a ordinal?
A regressão logística nominal é para uma resposta com três ou mais categorias sem ordem natural, como cor, tipo de material ou tipo de defeito. Se as categorias tiverem uma ordem natural, como baixo, médio e alto, use a regressão logística ordinal. Para uma resposta de duas categorias, como aprovado/reprovado, use a regressão logística binária.
Quais são os requisitos da regressão logística nominal?
A resposta deve ter três ou mais categorias não ordenadas, e cada categoria precisa de observações suficientes, pois categorias raras tornam o modelo instável e podem causar problemas de estimação. Os dados devem representar a população-alvo, ser medidos com exatidão e ser registrados na ordem de coleta. Depois do ajuste, valide o modelo com estatísticas de qualidade do ajuste e diagnósticos de resíduos.
Como executar a regressão logística nominal no Zometric Statistical Software?
Escolha Statistical Tool > Regression > Nominal Logistic Regression e insira ou cole os dados. Selecione Response, os Categorical e Continuous Predictors, se houver, e defina o Model, que por padrão é um modelo de efeitos principais e pode incluir termos de interação como A*B. Depois, clique em Calculate para obter os resultados.