
Capacidade de processo não normal
Use a capacidade de processo não normal para dados contínuos assimétricos ou que seguem uma distribuição como Weibull, exponencial, gama ou lognormal. Colete pelo menos 100 pontos de dados de um processo estável e confirme que a distribuição se ajusta. Informe LSL e USL e escolha o método Z-score ou o método de percentis da ISO 22514. A saída inclui os índices de capacidade e a porcentagem prevista da saída fora da especificação.
Última revisão
Conclusão principal
A capacidade de processo não normal avalia se um processo gera saída dentro dos limites de especificação quando seus dados não têm distribuição normal, ajustando uma distribuição adequada, como Weibull ou lognormal.
Nesta página
- O que é capacidade de processo não normal?
- Quando usar a capacidade de processo não normal?
- Diretrizes para o uso correto da capacidade de processo não normal
- Alternativas: quando não usar a capacidade de processo não normal
- Exemplo de capacidade de processo não normal
- Como usar a capacidade de processo não normal
O que é capacidade de processo não normal?
A capacidade de processo não normal é um método usado para avaliar a capacidade de um processo de gerar saídas dentro dos limites especificados quando os dados se desviam de uma distribuição normal. Essa análise é essencial quando os dados apresentam características como assimetria, outliers ou seguem uma distribuição diferente da curva normal em forma de sino. Ao escolher o modelo de distribuição não normal correto, a análise avalia o quanto os resultados do processo atendem aos requisitos do cliente, mede o desempenho global do processo e prevê a porcentagem de saídas que provavelmente ficarão fora da faixa aceitável. Essa abordagem ajuda a determinar se o processo consegue atender de forma confiável aos padrões desejados, mesmo quando a distribuição dos dados não é normal.
Em termos simples, é uma forma de garantir que um processo funcione bem, mesmo quando os dados não têm o aspecto que esperamos.
Quando usar a capacidade de processo não normal?
A capacidade de processo não normal deve ser usada quando os dados analisados não seguem uma distribuição normal, ou seja, não têm a típica curva em forma de sino, simétrica e centrada na média. Estas são algumas situações em que você usaria a capacidade de processo não normal:
- Dados assimétricos: Se os dados são assimétricos à esquerda ou à direita, ou seja, a maioria dos valores se concentra de um lado, uma análise de capacidade de processo não normal é mais apropriada.
- Presença de outliers: Se os dados têm valores extremos que não se encaixam no padrão geral, eles podem distorcer uma distribuição normal. Investigue-os primeiro; se forem uma parte genuína de um processo de cauda longa, uma distribuição não normal pode modelar a cauda melhor do que a distribuição normal.
- Distribuições não simétricas: Quando os dados mostram um padrão que não é simétrico (ex.: distribuições lognormal ou exponencial), a capacidade de processo não normal ajuda a fornecer uma avaliação mais precisa.
- Vários picos: Se os dados têm mais de um pico (distribuição bimodal ou multimodal), eles não seguem uma distribuição normal; isso geralmente significa que os dados vêm de mais de um fluxo de processo (por exemplo, máquinas ou lotes diferentes), que devem ser separados antes de se avaliar a capacidade.
- Características do processo: Alguns processos produzem naturalmente dados não normais devido à natureza do processo ou do produto. Por exemplo, desgaste ao longo do tempo, processos em bateladas ou processos com limites inerentes podem produzir dados não normais.
Diretrizes para o uso correto da capacidade de processo não normal
- Use dados contínuos na análise; se estiver lidando com dados por atributos, aplique a Capacidade Binomial ou a Capacidade de Poisson.
- Colete pelo menos 100 pontos de dados para garantir estimativas confiáveis da capacidade do processo e uma representação precisa da variação do processo.
- Certifique-se de que o processo está estável e sob controle antes de realizar a análise de capacidade, usando ferramentas como a carta XBarra-S ou o Capability Six Pack (Dados Não Normais), se necessário.
- Os dados devem seguir de perto a distribuição não normal selecionada; use a Identificação de Distribuição Individual para encontrar o melhor ajuste e obter estimativas de capacidade precisas.
Alternativas: quando não usar a capacidade de processo não normal
- Se você não tem certeza de qual distribuição não normal se ajusta aos seus dados, use a Identificação de Distribuição Individual antes da análise.
- Para verificar o controle do processo e a adequação a uma distribuição não normal específica, use primeiro o Capability Six Pack (Dados Não Normais).
- Para estimar a variação dentro dos subgrupos e a capacidade potencial junto com a capacidade global, use a Capacidade de Processo (Distribuição Normal) para transformar os dados não normais e avaliá-los com base em uma distribuição normal.
Exemplo de capacidade de processo não normal
Um fabricante de componentes automotivos está avaliando se uma furadeira consegue atender às especificações de um componente crítico. O componente deve ficar dentro de uma faixa: limite inferior de especificação (LSL) de 22.15 e limite superior de especificação (USL) de 22.35. Para avaliar isso, o engenheiro coleta 125 amostras da máquina e realiza os seguintes passos:
- Reúna os dados necessários.
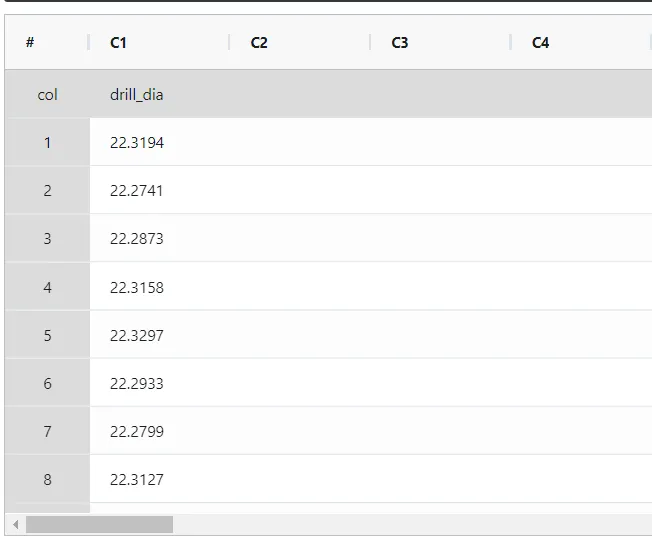
- Agora, analise os dados no Zometric Statistical Software em https://statsai.zometric.com/.
- Para encontrar a capacidade de processo não normal, escolha Statistical module> Process Capability>Non-Normal Process Capability.
- Na ferramenta, insira os dados e as demais entradas da seguinte forma:
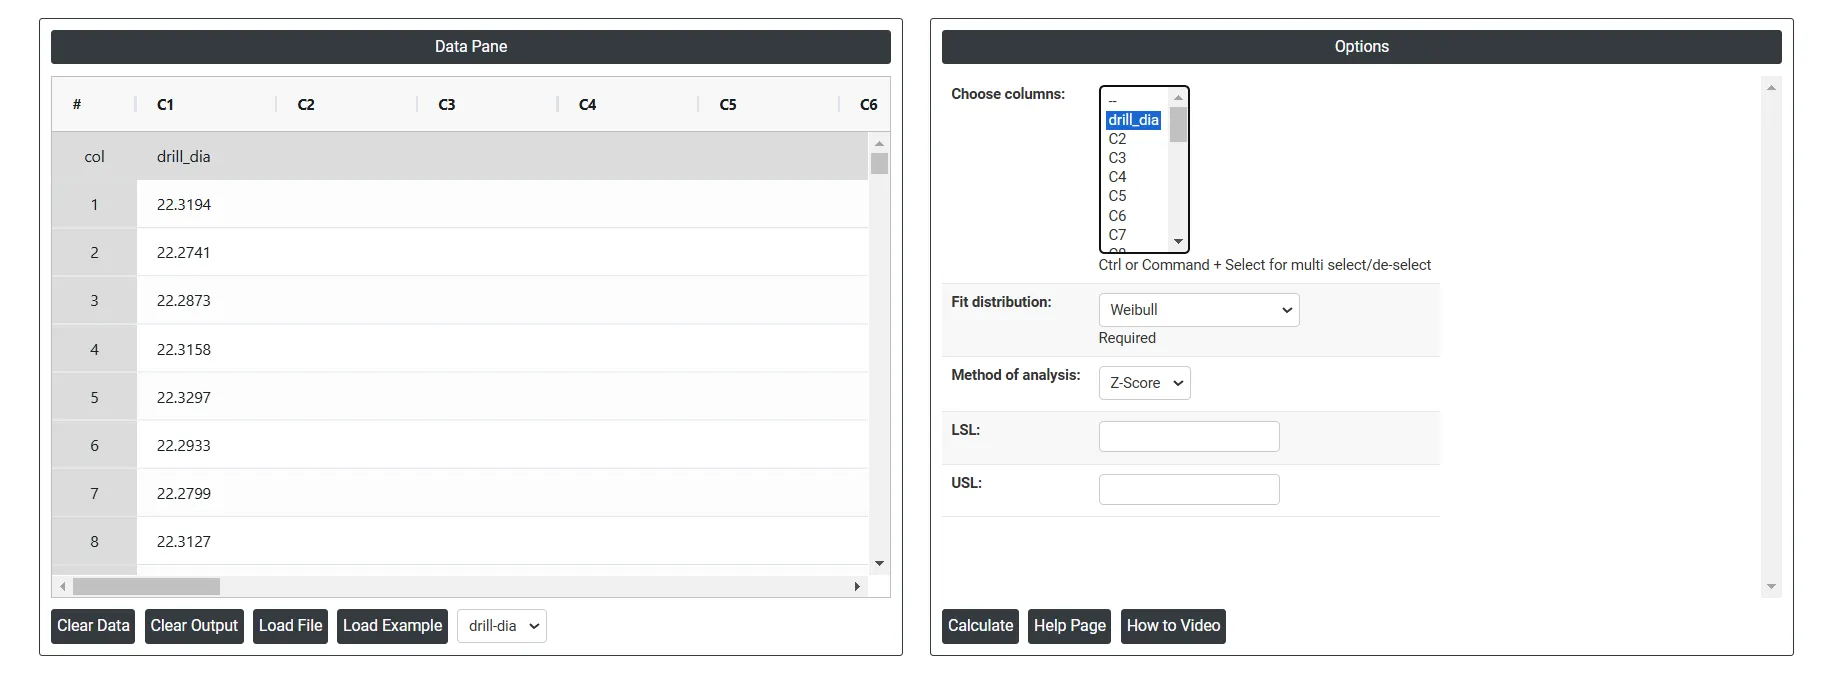
5. Depois de usar a ferramenta mencionada acima, obtém-se a saída a seguir:
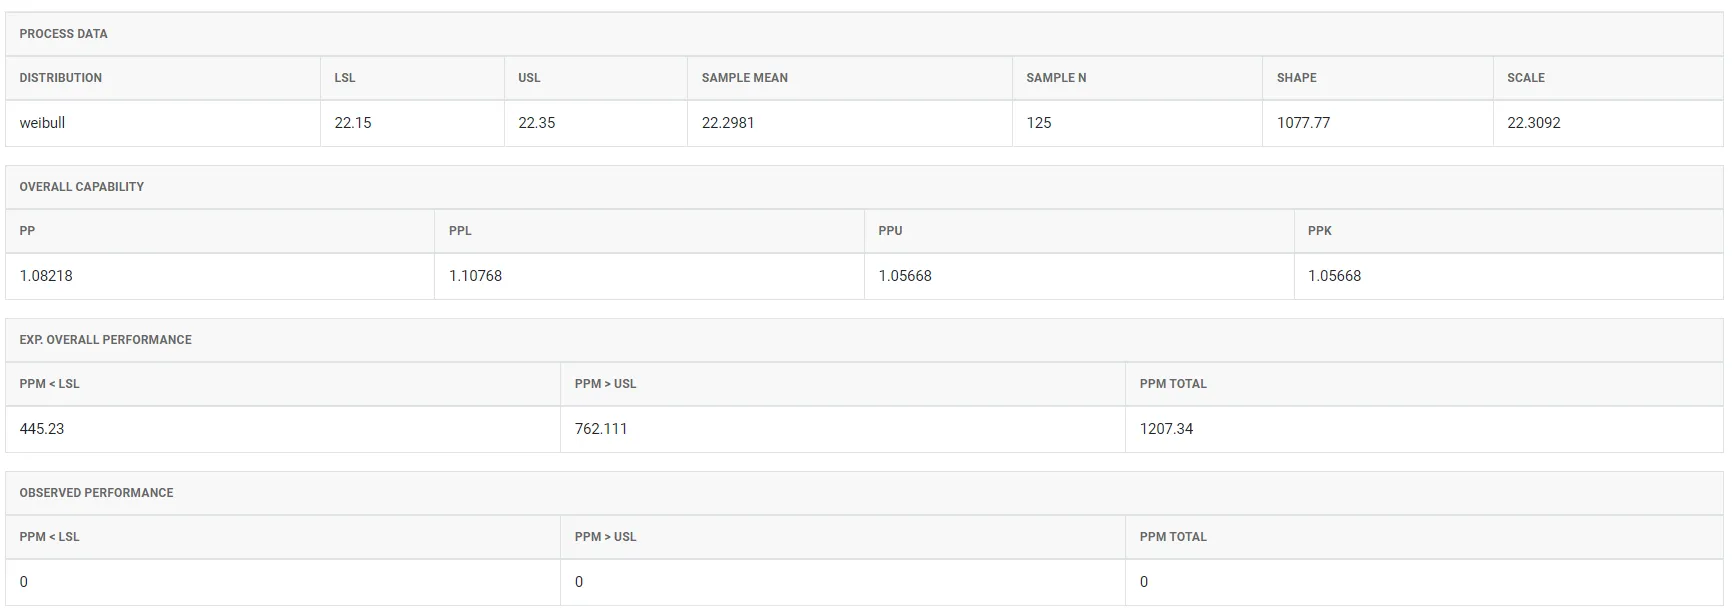
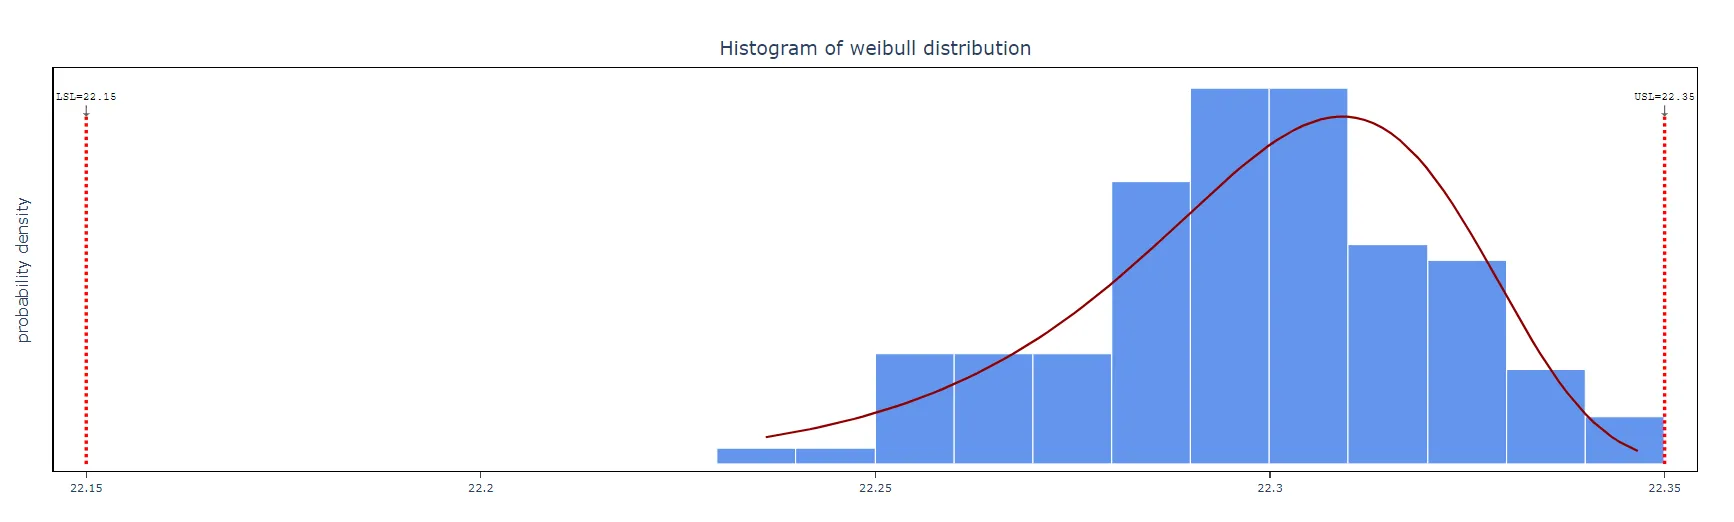
Como usar a capacidade de processo não normal
O guia é o seguinte:
- Faça login no Zometric Statistical Software em https://statsai.zometric.com/
- Na página inicial, escolha Statistical Tool> Process Capability >Non-Normal Process Capability.
- Clique em Non Normal Process Capability para acessar o painel (dashboard).
- Em seguida, atualize os dados manualmente ou copie todos os dados (Ctrl+C) de uma planilha do Excel e cole-os (Ctrl+V) aqui.
- Em seguida, você precisa selecionar a distribuição a ajustar, informar o LSL e o USL e escolher o método de análise.
- Por fim, clique em calculate na parte inferior da página para obter os resultados desejados.
No painel (dashboard) da capacidade de processo não normal, a janela é dividida em duas partes.
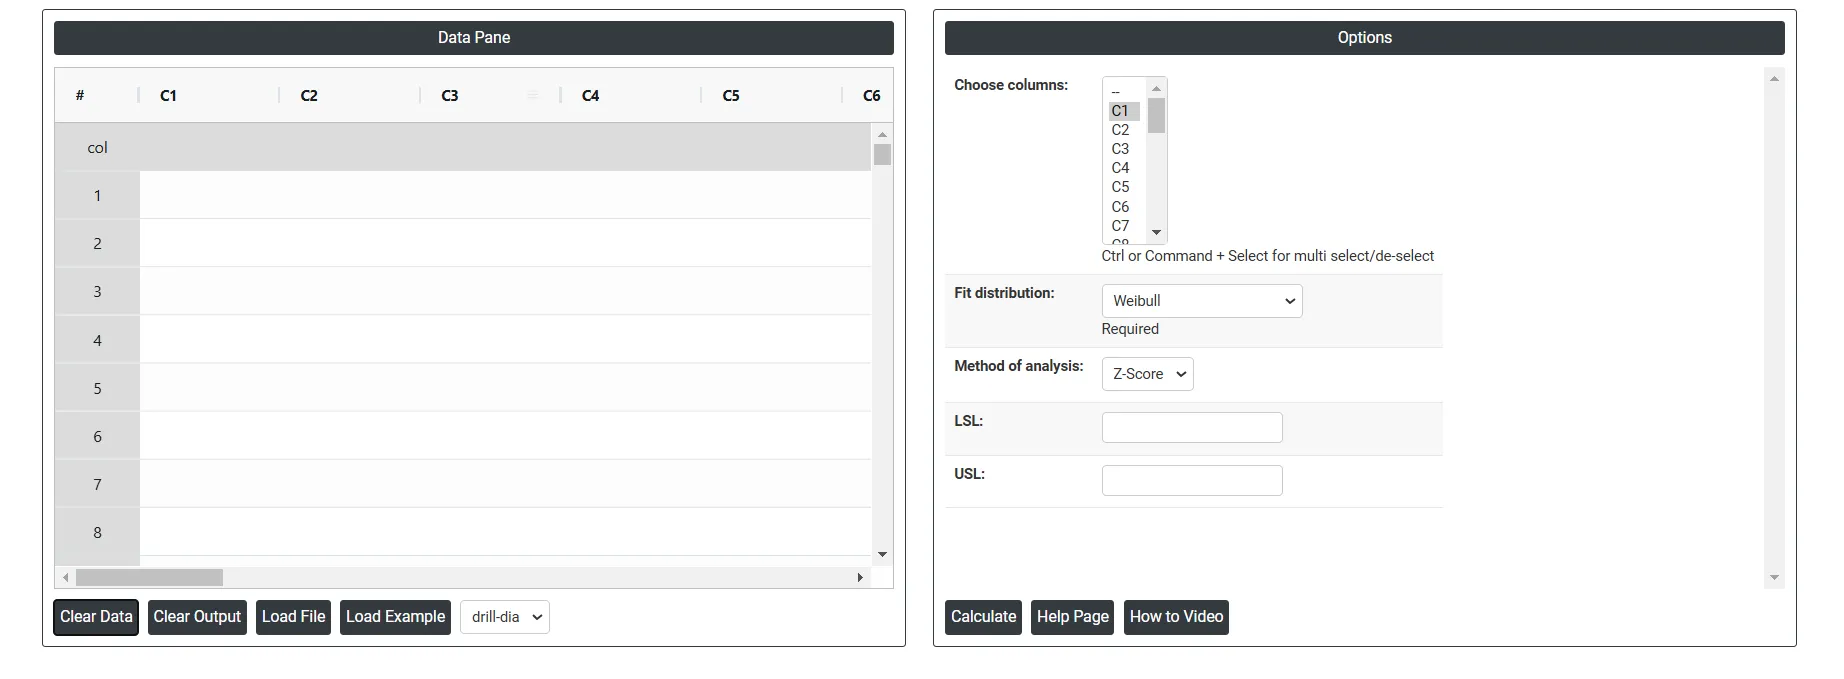
Na parte esquerda fica o painel de dados (Data Pane). No Data Pane, cada linha forma um subgrupo. Os dados podem ser inseridos manualmente, ou você pode copiar todos os dados (Ctrl+C) de uma planilha do Excel e colá-los (Ctrl+V) aqui.
Load example: Os dados de exemplo serão carregados.
Load File: É usado para carregar diretamente os dados do Excel.
Na parte direita, há várias opções, descritas a seguir:
- Fit Distribution:
- Weibull distribution: A distribuição de Weibull é um modelo estatístico flexível usado em engenharia, pesquisa médica, finanças e climatologia, particularmente para analisar dados de tempo até a falha e tratar dados de processo assimétricos. É definida por três parâmetros: forma, escala e limiar. A distribuição de Weibull de 3 parâmetros inclui os três, enquanto a versão de 2 parâmetros, que exclui o limiar, é usada somente para valores positivos. O parâmetro de forma afeta a assimetria da distribuição, o parâmetro de escala indica o ponto em que se espera que 63.2% da população tenha falhado e o parâmetro de limiar desloca a distribuição ao longo do eixo do tempo. Essa distribuição é fundamental para prever falhas, estimar ciclos de vida e entender padrões de dados complexos. Sua versatilidade se estende também ao controle da qualidade e ao gerenciamento de riscos. Exponential: A distribuição exponencial é uma distribuição de probabilidade contínua frequentemente usada na análise de capacidade de processo com dados não normais, particularmente em cenários como dados de tempo até a falha com taxa de falhas constante e tempos entre chegadas de eventos em um processo de Poisson, em que os eventos ocorrem de forma contínua e independente a uma taxa média constante. Essa distribuição é ideal para modelar o tempo até a ocorrência de um evento específico, e sua propriedade de ausência de memória a torna adequada para situações em que o passado não influencia o futuro, permitindo uma análise precisa de dados assimétricos que não seguem uma distribuição normal. Logistic: A distribuição logística tem um papel importante na análise de capacidade de processo não normal, especialmente quando os dados são simétricos, mas não normalmente distribuídos. A distribuição logística tem formato semelhante ao da distribuição normal, mas com caudas mais pesadas, ou seja, dá mais probabilidade a valores extremos. Essa característica a torna útil em certas análises de capacidade de processo em que os dados tendem a ter outliers ou uma dispersão maior do que a distribuição normal acomodaria. Loglogistic: A distribuição log-logística é usada para dados positivos e assimétricos à direita cujo logaritmo segue uma distribuição logística. É semelhante à distribuição lognormal, mas tem caudas mais pesadas, o que a torna adequada para processos em que valores grandes são mais prováveis do que uma distribuição lognormal preveria. Largest Extreme Value: A distribuição de valor extremo máximo é essencial na análise de capacidade de processo não normal quando se lida com dados voltados a valores máximos ou distribuições assimétricas à direita. Ela garante que os valores extremos sejam modelados com precisão, levando a avaliações de capacidade mais confiáveis e a decisões mais bem fundamentadas sobre o desempenho e os riscos do processo. Smallest Extreme Value: A distribuição de valor extremo mínimo (SEV) tem um papel crítico na análise de capacidade de processo não normal, especialmente quando os dados são assimétricos e não se ajustam à distribuição normal. A distribuição SEV é particularmente útil para modelar os valores mínimos de um conjunto de dados, como o menor tempo até a falha ou o elo mais fraco de uma cadeia de eventos. 2-Parameter Exponential: A distribuição exponencial de 2 parâmetros é definida por um parâmetro de escala (λ) e um parâmetro de limiar (θ). O parâmetro de limiar desloca a distribuição em θ unidades para a direita, indicando um tempo mínimo de espera antes que os eventos possam ocorrer. O parâmetro de escala controla a taxa em que os eventos ocorrem após o limiar. 3- Parameter Weibull: A distribuição de Weibull de 3 parâmetros é definida por um parâmetro de forma (β), um parâmetro de escala (η) e um parâmetro de limiar (γ). O parâmetro de forma (β) determina o comportamento da taxa de falhas, o parâmetro de escala (η) indica a vida característica e o parâmetro de limiar (γ) desloca a distribuição, representando o tempo mínimo antes de as falhas começarem. Essa distribuição é usada para modelar dados de vida com um período inicial de espera antes de os eventos poderem ocorrer, acrescentando flexibilidade para um ajuste de dados mais preciso. Gamma: A distribuição gama é uma distribuição de probabilidade contínua caracterizada por um parâmetro de forma (k ou α) e um parâmetro de escala (θ). É usada principalmente para modelar o tempo de espera até a ocorrência de um número especificado de eventos, o que a torna ideal para processos que envolvem tempos acumulados ou dados assimétricos. Lognormal: A distribuição lognormal é uma distribuição de probabilidade contínua em que o logaritmo da variável aleatória tem distribuição normal. Caracteriza-se por ser assimétrica positiva e é definida pela média (μ) e pelo desvio padrão (σ) da distribuição normal subjacente. Comumente usada em finanças, ciências da vida e análise de confiabilidade, modela dados que devem permanecer positivos e apresentar crescimento multiplicativo ou comportamento assimétrico à direita.
- LSL: É o valor mínimo aceitável para uma medição do processo. Qualquer valor abaixo desse limite indica que o produto ou processo não atende aos padrões de qualidade e é considerado defeituoso.
- USL: É o valor máximo aceitável para uma medição do processo. Qualquer valor acima desse limite também indica que o produto ou processo está fora da especificação e não atende aos requisitos de qualidade.
- Method of Analysis:
- Z-Score: O método Z-score usa a distribuição ajustada para encontrar a probabilidade de ficar além de cada limite de especificação e a converte em um valor Z normal padrão equivalente. Os índices de capacidade são então calculados a partir desses valores Z (cada índice unilateral é igual a Z dividido por 3), de modo que sejam comparáveis aos índices usados para dados normais. O método ajuda a identificar problemas de desempenho, possibilitando decisões baseadas em dados para a melhoria da qualidade.
Use este método quando:
- Os dados não seguem uma distribuição normal, o que é comum em muitos processos do mundo real.
- Você precisa de uma abordagem mais flexível, que possa acomodar várias distribuições (ex.: exponencial, lognormal).
- Você quer calcular índices de capacidade do processo (Cp, Cpk) padronizados em termos de quantos desvios padrão a média do processo está dos limites de especificação.
Vantagens:
- O método Z-score oferece uma compreensão mais clara do desempenho do processo em relação aos limites de especificação ao expressar a capacidade em desvios padrão.
- Ele permite melhores comparações entre diferentes processos ou características, mesmo quando os dados são não normais.
- ISO: O método ISO segue a norma ISO 22514 para análise de capacidade não normal. Ele calcula os índices de capacidade diretamente a partir de percentis da distribuição ajustada: os percentis 0.135 e 99.865, que correspondem a ±3 desvios padrão em uma distribuição normal, e a mediana como o centro do processo. Esse método é preferido quando se exige conformidade com normas internacionais de qualidade.
- Download as Excel: Exibe o resultado em formato Excel, que pode ser facilmente editado e recarregado para os cálculos por meio da opção load file.
Perguntas frequentes
O que é capacidade de processo não normal?
A capacidade de processo não normal avalia a capacidade de um processo de gerar saída dentro dos limites de especificação quando os dados não seguem uma distribuição normal. Ao ajustar um modelo de distribuição não normal adequado, ela avalia o desempenho global do processo e prevê a porcentagem de saída que provavelmente ficará fora da faixa aceitável.
Quando usar a análise de capacidade não normal?
Use-a quando dados contínuos são assimétricos, não simétricos ou vêm de um processo que naturalmente produz dados não normais, como desgaste ao longo do tempo ou processos com limites inerentes. Investigue primeiro os outliers e separe os dados com mais de um pico em seus fluxos de processo, como máquinas ou lotes diferentes, antes de avaliar a capacidade. Para dados por atributos, use a Capacidade Binomial ou a Capacidade de Poisson.
De quantos dados você precisa para a capacidade de processo não normal?
Colete pelo menos 100 pontos de dados para obter estimativas de capacidade confiáveis. O processo deve estar estável e sob controle antes da análise, e os dados devem seguir de perto a distribuição selecionada. Se você não tem certeza de qual distribuição se ajusta, use primeiro a Identificação de Distribuição Individual.
Qual é a diferença entre os métodos Z-score e ISO para a capacidade não normal?
O método Z-score usa a distribuição ajustada para encontrar a probabilidade além de cada limite de especificação e a converte em um valor Z normal padrão equivalente; cada índice unilateral é igual a Z dividido por 3, de modo que os índices são comparáveis aos de dados normais. O método ISO segue a ISO 22514, calculando os índices a partir dos percentis 0.135 e 99.865 da distribuição ajustada, com a mediana como o centro do processo.