
Capacidade de processo não normal
A análise de capacidade de processo não normal mede o quanto um processo atende aos seus limites de especificação quando os dados subjacentes não seguem uma distribuição normal (em forma de sino). Em vez de impor a premissa de normalidade a dados assimétricos ou incomuns, ela ajusta aos dados uma distribuição não normal reconhecida — como Weibull, Lognormal, Exponencial ou Gama — e calcula os índices de capacidade com base na forma real dessa distribuição.
Última revisão
Conclusão principal
A análise de capacidade de processo não normal mede o quanto um processo atende aos seus limites de especificação quando os dados subjacentes não seguem uma distribuição normal (em forma de sino).
Nesta página
- O que é capacidade de processo não normal?
- Quando usar a capacidade de processo não normal?
- Diretrizes para o uso correto da capacidade de processo não normal
- Alternativas: quando não usar a capacidade de processo não normal
- Exemplo de capacidade de processo não normal
- Como fazer a capacidade de processo não normal .
O que é capacidade de processo não normal?
A análise de capacidade de processo não normal mede o quanto um processo atende aos seus limites de especificação quando os dados subjacentes não seguem uma distribuição normal (em forma de sino). Em vez de impor a premissa de normalidade a dados assimétricos ou incomuns, ela ajusta aos dados uma distribuição não normal reconhecida — como Weibull, Lognormal, Exponencial ou Gama — e calcula os índices de capacidade com base na forma real dessa distribuição.
Índices de capacidade padrão, como Cp e Cpk, pressupõem normalidade. Quando essa premissa é violada, esses índices se tornam imprecisos e podem superestimar ou subestimar a capacidade real do processo. A capacidade não normal resolve isso usando o modelo distribucional correto, o que dá uma visão muito mais fiel e precisa de se o processo consegue entregar produto de forma consistente dentro da especificação.
Definições simples: uma análise de capacidade concebida para dados assimétricos ou não normais — ela ajusta aos seus dados a distribuição adequada e calcula os índices de capacidade com base nessa forma real, em vez de impor uma premissa normal incorreta.
Quando usar a capacidade de processo não normal?
- Use quando os dados do seu processo são contínuos mas não passam em um teste de normalidade — por exemplo, tempos de ciclo, medições de resistência ou concentrações químicas fortemente assimétricos.
- Use quando um gráfico de probabilidade ou teste de normalidade confirma que os seus dados seguem uma distribuição não normal específica, como Weibull, Lognormal, Exponencial ou Gama.
- Use quando aplicar a transformação de Box-Cox ou de Johnson não for adequado ou prático — por exemplo, quando os dados transformados são difíceis de interpretar nas unidades originais.
- Use quando a ferramenta de Identificação de Distribuição Individual tiver confirmado a distribuição de melhor ajuste para os seus dados.
Diretrizes para o uso correto da capacidade de processo não normal
- Execute sempre primeiro a Identificação de Distribuição Individual para determinar a distribuição de melhor ajuste antes de selecioná-la nesta análise — escolher a distribuição errada produz índices de capacidade enganosos.
- Colete pelo menos 100 pontos de dados para garantir que o ajuste da distribuição produza estimativas de parâmetros confiáveis e estáveis.
- Garanta que o processo seja estável e esteja sob controle estatístico antes de executar a análise de capacidade — um processo instável produz valores de capacidade sem significado, qualquer que seja a distribuição usada.
- Não use esta análise para dados por atributos ou de contagem — use em vez disso a capacidade binomial ou de Poisson.
- Verifique a distribuição escolhida usando estatísticas de aderência e gráficos de probabilidade — um valor-p alto e uma linha reta no gráfico de probabilidade confirmam um bom ajuste.
- Índices de capacidade como Pp, Ppk, Cp e Cpk são informados com base nos percentis da distribuição ajustada, e não em múltiplos do desvio padrão — interprete-os de acordo.
Alternativas: quando não usar a capacidade de processo não normal
- Situação
Use em vez disso
Os dados têm distribuição normal
Análise de capacidade normal (padrão)
Os dados podem ser transformados para a normalidade
Análise de capacidade com transformação de Box-Cox ou de Johnson
A distribuição é desconhecida ou incerta
Capacidade de processo não paramétrica
Os dados são do tipo aprovado/reprovado ou contagens de defeituosos
Análise de capacidade binomial
Os dados são contagens de eventos (defeitos por unidade)
Análise de capacidade de Poisson
É necessário um relatório gráfico e estatístico combinado
Capability Six Pack (Entre/Dentro)
Exemplo de capacidade de processo não normal
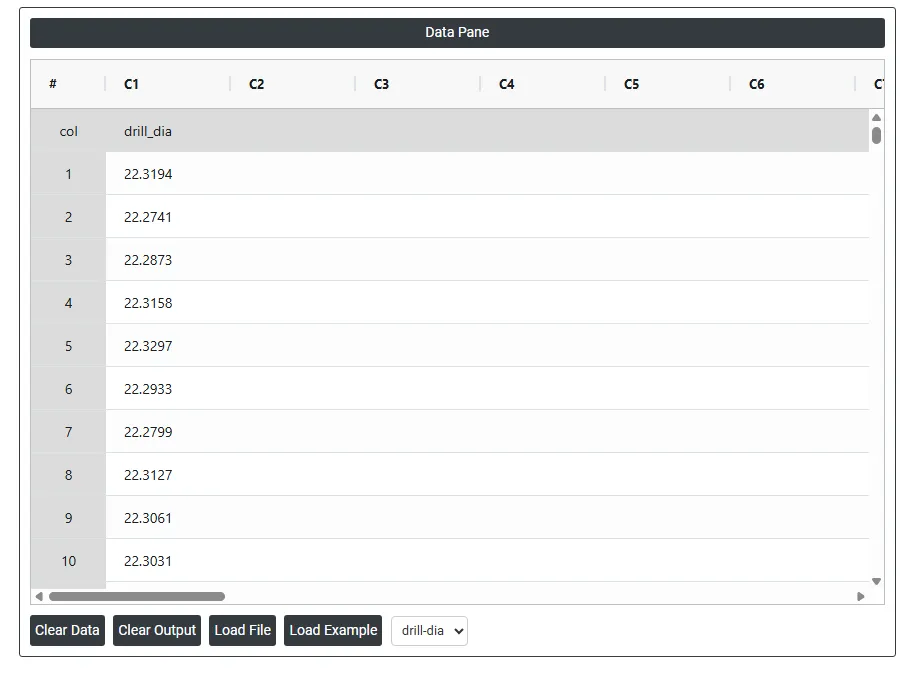
Um fabricante de componentes automotivos está desenvolvendo um componente crítico para um cliente montadora (OEM). Para garantir a qualidade, um engenheiro verifica se uma furadeira consegue atender às especificações. A peça precisa estar dentro de uma faixa: LSL (limite inferior de especificação) de 22.15 e USL (limite superior de especificação) de 22.35. O engenheiro retira 125 amostras da máquina e realiza um estudo de capacidade de máquina. Os passos a seguir:
- Reuniu os dados necessários.
- Agora, analise os dados no Zometric Statistical Software em https://statsai.zometric.com/.
- Para encontrar a Capacidade de processo não normal, escolha Statistical module> Control Chart>Non-Normal Process Capability.
- Na ferramenta, insira os dados e as demais entradas da seguinte forma:
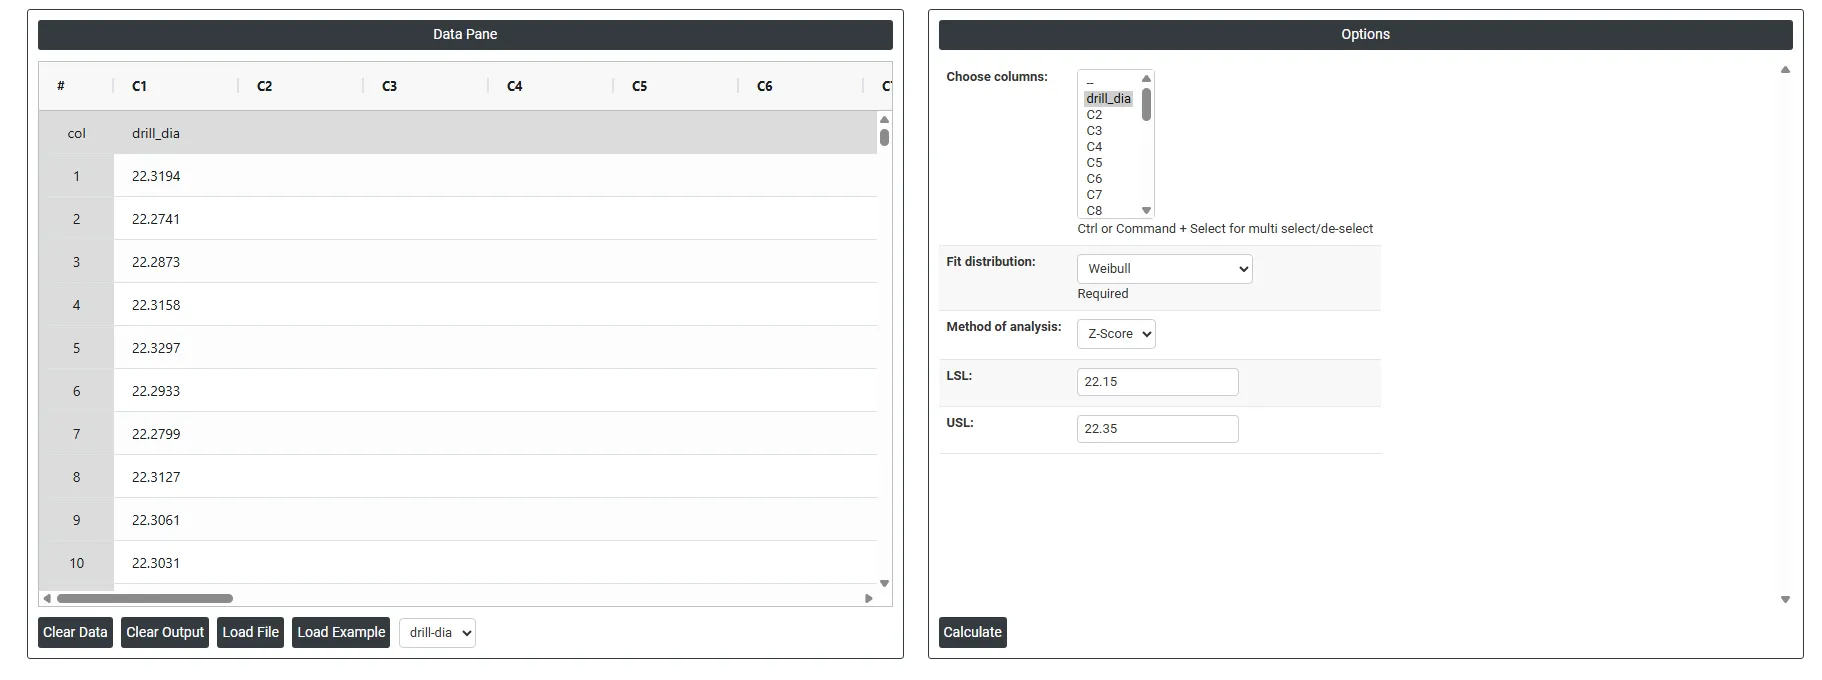
5. Depois de usar a ferramenta acima, obtém-se a seguinte saída:
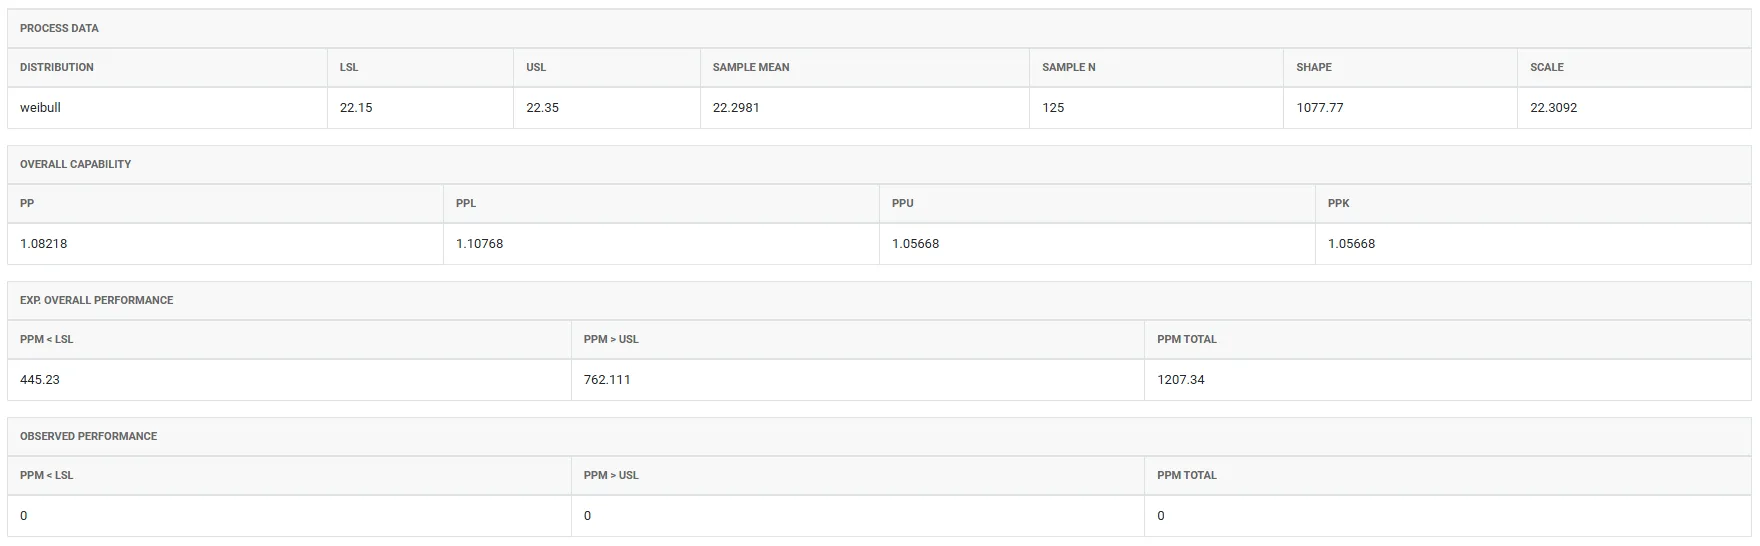
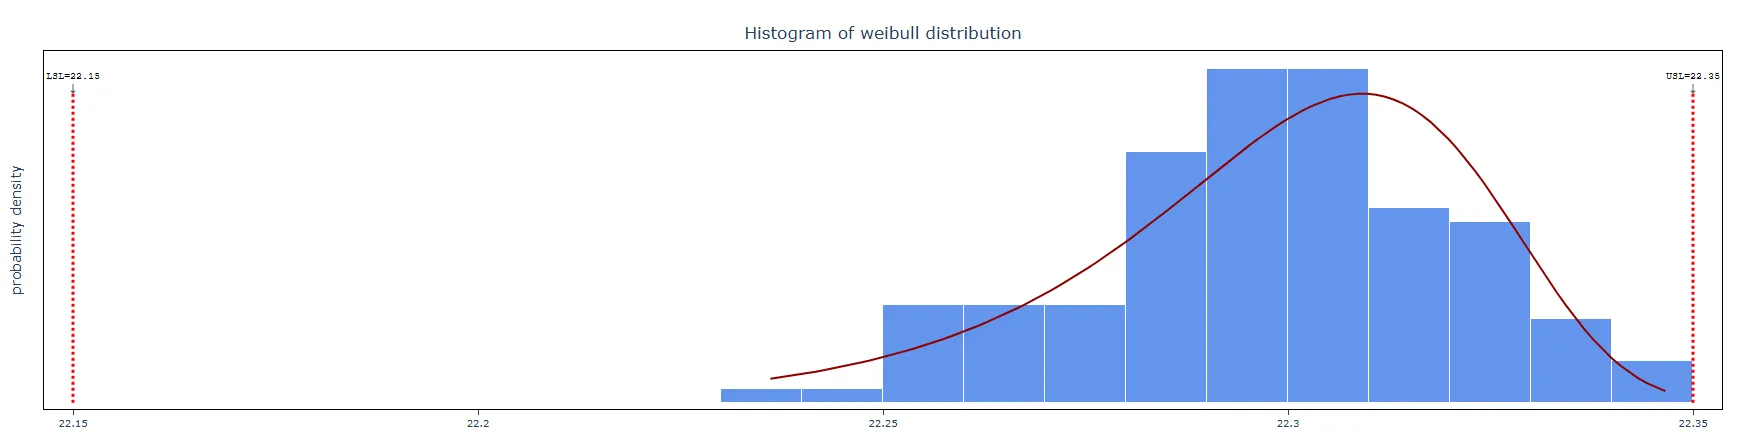
Como fazer a capacidade de processo não normal .
O guia é o seguinte:
- Faça login no Zometric Statistical Software em https://statsai.zometric.com/
- Na página inicial, escolha Statistical Tool> Control Chart>Non-Normal Process Capability .
- Em seguida, atualize os dados manualmente ou copie todos os dados (Ctrl+C) de uma planilha do Excel e cole-os (Ctrl+V) aqui.
- Preencha as opções necessárias .
- Por fim, clique em calculate na parte inferior da página para obter os resultados desejados.
No painel (dashboard) da capacidade de processo não normal, a janela é dividida em duas partes.
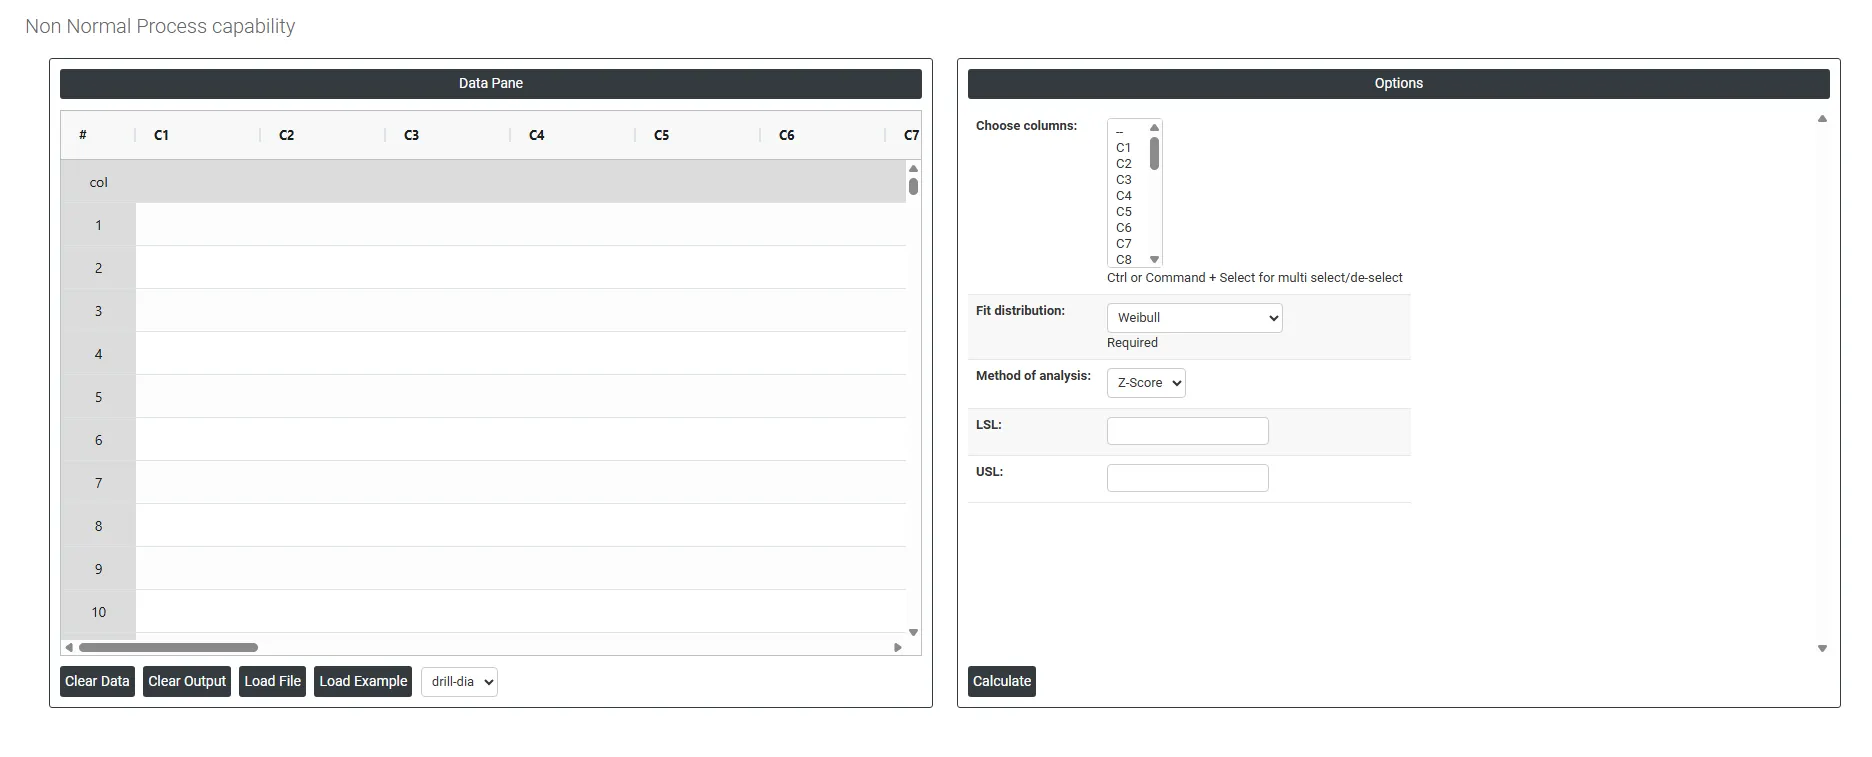
Na parte esquerda fica o painel de dados (Data Pane). No Data Pane, cada linha forma um subgrupo. Os dados podem ser inseridos manualmente, ou você pode copiar todos os dados (Ctrl+C) de uma planilha do Excel e colá-los (Ctrl+V) aqui.
Load example: Os dados de exemplo serão carregados.
Load File: É usado para carregar diretamente os dados do Excel.
Na parte direita, há várias opções, descritas a seguir:
- Choose Columns Selecione a(s) coluna(s) que contêm os seus dados de medição contínuos. Use Ctrl ou Command + clique para selecionar várias colunas de uma vez. São as medições reais do processo — como diâmetros de furos, resistências à tração ou tempos de ciclo — que serão analisadas quanto à capacidade em relação aos limites de especificação usando a distribuição não normal selecionada.
- Fit Distribution Selecione a distribuição que melhor descreve a forma dos seus dados. Esta é a configuração mais crítica da análise — os índices de capacidade são calculados com base nas propriedades matemáticas da distribuição escolhida; por isso, selecionar a errada produz resultados imprecisos. Execute sempre primeiro a Identificação de Distribuição Individual para confirmar qual distribuição se ajusta aos seus dados antes de fazer essa seleção. As opções disponíveis e seus casos de uso típicos:
- Weibull — muito usada para dados de confiabilidade, vida em fadiga e tempo até a falha. Lida bem com dados assimétricos à direita e é uma das distribuições não normais mais flexíveis e mais amplamente aplicadas.
- Exponential — usada para dados que representam o tempo entre eventos aleatórios independentes, como o tempo entre falhas de máquinas ou entre chegadas de chamadas de serviço. Pressupõe uma taxa de falhas constante.
- Logistic — de forma semelhante à da distribuição normal, mas com caudas mais pesadas. Usada quando os dados são simétricos, mas têm mais valores extremos do que a normalidade preveria.
- Loglogistic — uma distribuição assimétrica à direita usada para dados de sobrevivência e de confiabilidade, semelhante à Lognormal, mas com caudas mais pesadas. Adequada a dados de tempo até a falha ou do tipo renda.
- Largest Extreme Value — modela a distribuição do valor máximo de uma amostra. Usada quando os dados representam medições de pico, como tensão máxima, níveis de cheia ou temperaturas mais altas.
- Smallest Extreme Value — modela a distribuição do valor mínimo de uma amostra. Comumente usada para resistência mínima ou menores medições observadas.
- 2-Parameter Exponential — uma extensão da distribuição exponencial padrão que inclui um parâmetro de limiar, permitindo que a distribuição comece em um valor diferente de zero. Útil quando as medições não podem ficar abaixo de um certo valor mínimo.
- 3-Parameter Weibull — acrescenta um parâmetro de localização (limiar) à Weibull padrão, permitindo que a distribuição comece em um ponto diferente de zero. Útil quando nenhuma falha ou medição pode ocorrer abaixo de um valor mínimo conhecido.
- Gamma — uma distribuição flexível, assimétrica à direita, comumente aplicada a tempos de processo, tempos de espera, volumes de chuva e outras medições contínuas positivas com assimetria moderada.
- Lognormal — usada quando o logaritmo dos dados tem distribuição normal. Comum em concentrações químicas, tamanhos de partículas, tempos de reparo e dados financeiros, nos quais os valores são estritamente positivos e assimétricos à direita.
- Method of Analysis Determina como as estatísticas de capacidade e os limites de especificação são interpretados e informados. Há duas opções:
- Z-Score — calcula a capacidade convertendo os limites de especificação em escores Z padronizados com base nos percentis da distribuição ajustada. Isso expressa a capacidade em termos de quantos desvios padrão os limites de especificação estão do centro do processo, tornando os resultados comparáveis a índices de capacidade normais padrão, como Cp e Cpk.
- ISO — segue a metodologia da norma ISO 22514 para a análise de capacidade não normal. Esse método calcula os índices de capacidade diretamente a partir dos percentis da distribuição (especificamente os percentis 0.135 e 99.865, que correspondem aos limites de ±3 sigma em uma distribuição normal), sem converter para escores Z. É o método preferido quando se exige conformidade com normas internacionais de qualidade.
- LSL (Lower Specification Limit) O valor mínimo aceitável da medição. Qualquer ponto de dados abaixo desse valor é considerado fora da especificação. Insira o LSL definido pelo seu desenho de engenharia, requisito do cliente ou especificação do produto. Pelo menos um limite de especificação (LSL ou USL) deve ser informado — ambos podem ser inseridos se a medição tiver especificações bilaterais.
- USL (Upper Specification Limit) O valor máximo aceitável da medição. Qualquer ponto de dados acima desse valor é considerado fora da especificação. Insira o USL do seu desenho de engenharia ou da especificação do produto. Se a característica do processo tiver apenas um requisito unilateral — por exemplo, uma resistência mínima sem limite superior — só é preciso inserir o limite relevante.
Perguntas frequentes
O que é a análise de capacidade de processo não normal?
A análise de capacidade de processo não normal mede o quanto um processo atende aos seus limites de especificação quando os dados não seguem uma distribuição normal. Em vez de impor uma premissa de normalidade, ela ajusta uma distribuição reconhecida, como Weibull, Lognormal, Exponencial ou Gama, e calcula os índices de capacidade a partir da forma real dessa distribuição.
Por que não usar os Cp e Cpk padrão para dados não normais?
Cp e Cpk padrão pressupõem normalidade. Quando os dados são assimétricos ou, de outro modo, não normais, esses índices se tornam imprecisos e podem superestimar ou subestimar a capacidade real do processo. Usar o modelo distribucional correto dá uma visão mais fiel e precisa de se o processo consegue entregar produto de forma consistente dentro da especificação.
Como escolher a distribuição certa para a capacidade não normal?
Execute primeiro a Identificação de Distribuição Individual para encontrar a distribuição de melhor ajuste e depois verifique-a com estatísticas de aderência e gráficos de probabilidade; um valor-p alto e uma linha reta no gráfico de probabilidade indicam um bom ajuste. Escolher a distribuição errada produz índices de capacidade enganosos. Se nenhuma distribuição se ajustar, use a capacidade de processo não paramétrica.
Qual é a diferença entre os métodos Z-Score e ISO?
O método Z-Score converte os limites de especificação em escores Z padronizados com base nos percentis da distribuição ajustada, tornando os resultados comparáveis aos Cp e Cpk normais. O método ISO segue a ISO 22514 e calcula os índices diretamente a partir dos percentis 0.135 e 99.865 da distribuição ajustada, sendo preferido quando se exige conformidade com normas internacionais.