
Regressão não linear
A Regressão Não Linear ajusta, a uma resposta e a um preditor, uma curva cujos parâmetros não entram de forma linear. Use-a quando a física ou a química do processo determina a forma da curva. Escolha uma de sete funções embutidas ou uma definida pelo usuário e forneça valores iniciais adequados. A saída inclui estimativas dos parâmetros com erros padrão e intervalos de confiança, um gráfico de linha ajustada, uma matriz de correlação e um teste de falta de ajuste.
Última revisão
Conclusão principal
A regressão não linear ajusta uma curva cujos parâmetros entram de forma não linear, como uma aproximação exponencial de um limite, para estimar parâmetros como um valor limite ou uma constante de taxa, com intervalos de confiança.
Nesta página
Finalidade
A Regressão Não Linear ajusta, a uma resposta e a um preditor, uma curva cujos parâmetros não entram de forma linear, como uma aproximação exponencial de um limite, uma curva de saturação ou uma curva de crescimento em forma de S. Use-a quando a física ou a química do processo indica a forma da curva e você quer estimativas de seus parâmetros, como um valor limite ou uma constante de taxa, com intervalos de confiança.
Principais recursos
- Sete funções de expectativa embutidas: decaimento exponencial, crescimento exponencial, potência, logística de 3 parâmetros, Michaelis-Menten, Gompertz e quadrática.
- Função de expectativa definida pelo usuário em X com parâmetros b1, b2, …, usando + − * / ^ e exp, log, ln, log10, sqrt, abs, sin, cos, tan, arctan.
- Ajuste por Gauss-Newton, Levenberg-Marquardt ou Trust Region Reflective, com seus próprios valores iniciais, limite de iterações e tolerância.
- Estimativas dos parâmetros com erros padrão e intervalos de confiança, e sua matriz de correlação.
- Gráfico de linha ajustada com bandas de confiança e de predição opcionais.
- Teste de falta de ajuste quando o preditor tem valores repetidos.
- Coluna de pesos opcional e gráficos de resíduos.
Métodos estatísticos
A ferramenta encontra os valores dos parâmetros θ que minimizam a soma dos quadrados dos erros SSE = Σ (yᵢ − f(xᵢ, θ))², ou Σ wᵢ (yᵢ − f(xᵢ, θ))² com uma coluna de pesos. Levenberg-Marquardt (padrão) e Trust Region Reflective usam os solucionadores de mínimos quadrados do SciPy; Gauss-Newton usa redução do passo à metade e informa o número de iterações. A iteração termina quando a variação relativa do SSE e dos parâmetros fica abaixo da tolerância de convergência. As linhas com valor ausente na resposta, no preditor ou nos pesos são descartadas.
Os erros padrão vêm da aproximação linear na solução: Cov(θ) = MSE·(JᵀJ)⁻¹, em que J é a matriz das derivadas de f em relação aos parâmetros e MSE = SSE / (n − p) para p parâmetros; S = √MSE. Os intervalos de confiança são θ ± t(1−α/2, n−p)·SE. A banda de confiança da curva usa a mesma aproximação; a banda de predição soma MSE para uma única nova leitura. Esses intervalos são aproximados e deixam de ser confiáveis se os parâmetros estiverem mal determinados, o que aparece como correlações próximas de ±1 na matriz de correlação.
Quando alguns valores do preditor são repetidos, a soma dos quadrados do erro é dividida em erro puro (dispersão entre repetições) e falta de ajuste, e F = MS lack-of-fit / MS pure error testa se a curva escolhida se ajusta. Os valores iniciais importam: as funções embutidas partem de padrões fixos (por exemplo, a = 1, b = 1 para Michaelis-Menten), com c na mediana de X para as curvas logística e de Gompertz; uma função definida pelo usuário precisa de um valor inicial por parâmetro. Forneça valores próximos do que você espera, ou o ajuste pode falhar ou encontrar um mau mínimo local.
Campos de entrada e opções
Campo | Descrição |
Response (Y) / Predictor (X) | Colunas numéricas; devem ser diferentes. Obrigatório. |
Expectation function | Exponential decay y = a·exp(−b·x) (padrão), Exponential growth, Power y = a·x^b, Logistic (3-param), Michaelis-Menten y = a·x/(b + x), Gompertz, Quadratic ou User-defined expectation function. |
Expectation function (user-defined) | Exibido para a opção definida pelo usuário. Fórmula em X com parâmetros b1, b2, …, ex.: b1 * exp(-b2 * X). |
Weights (optional) | Coluna de pesos para mínimos quadrados ponderados. |
Starting values (space-separated) | Um valor por parâmetro, em ordem. Opcional para funções embutidas (os padrões são usados se estiver em branco), obrigatório para uma função definida pelo usuário. |
Confidence level | Padrão 95. |
Fitting algorithm | Gauss-Newton, Levenberg-Marquardt (padrão) ou Trust Region Reflective. |
Maximum number of iterations / Convergence tolerance | Padrões 200 e 1e-05. |
Display confidence interval on fitted curve / Display prediction interval on fitted curve | Adiciona as bandas ao gráfico de linha ajustada. Desativado por padrão. |
Histogram of residuals / Normal plot of residuals / Residuals versus fits / Residuals versus order / Four in one | Gráficos de resíduos; Four in one desenha os quatro juntos. |
Residuals versus the variables | Plota os resíduos em relação a uma coluna escolhida. |
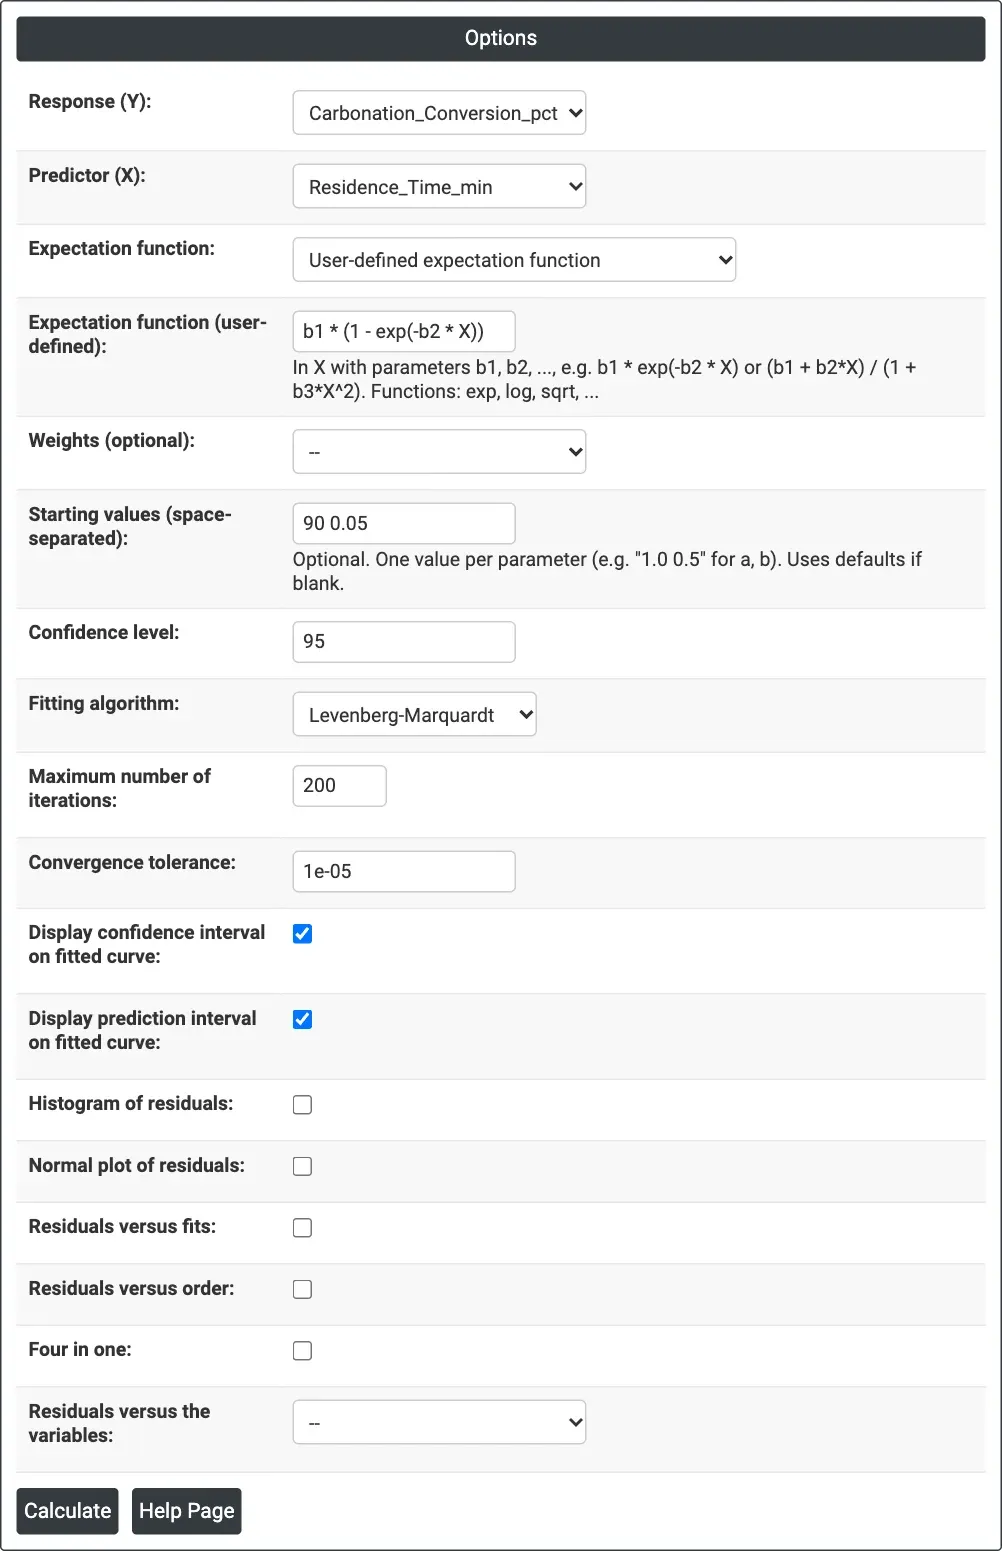
Figura 1 — Opções do exemplo de carbonatação: função definida pelo usuário b1 * (1 - exp(-b2 * X)) com valores iniciais 90 e 0.05, bandas de confiança e de predição marcadas.
Descrição da saída
- Method — algoritmo, número máximo de iterações, tolerância e, para Gauss-Newton, as iterações utilizadas.
- Starting Values for Parameters — os valores a partir dos quais o ajuste começou.
- Regression Equation — a curva ajustada com os nomes das colunas.
- Parameter Estimates — Estimate, SE Estimate e limites de confiança de cada parâmetro.
- Summary of Fit — Final SSE, DFE, MSE e S.
- Fitted Line Plot — dados, curva ajustada e bandas CI e PI opcionais.
- Correlation Matrix for Parameter Estimates.
- Lack-of-Fit — linhas de erro, falta de ajuste e erro puro com F e P, quando o preditor tem valores repetidos.
- Gráficos de resíduos, se selecionados.
- Exportação em PDF por meio de Download.
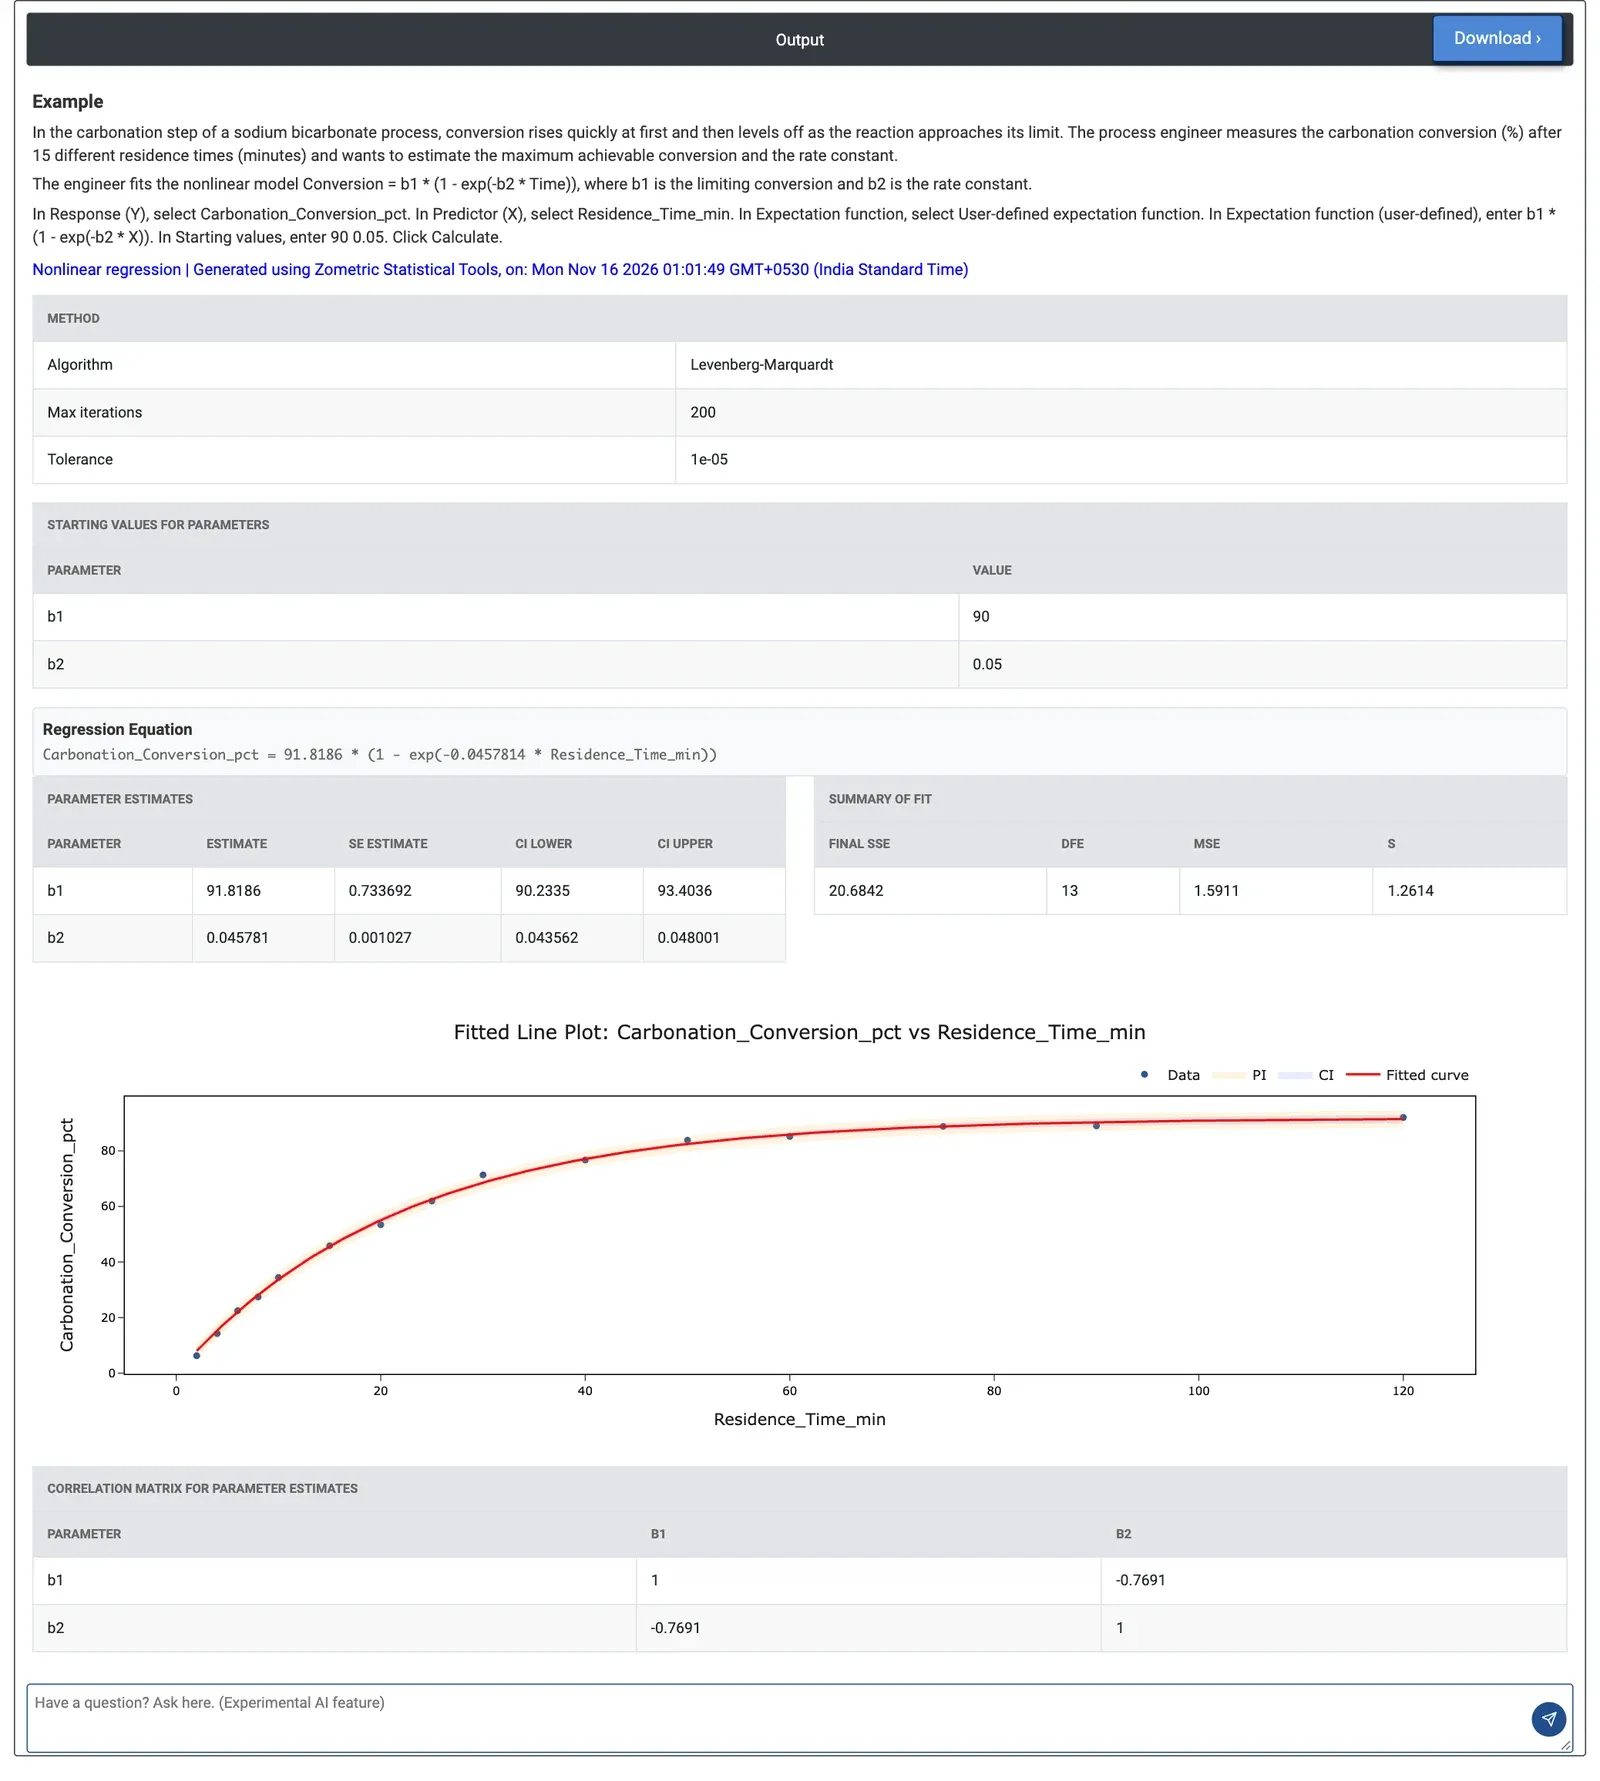
Figura 2 — Conversão na carbonatação em função do tempo de residência: conversão limite b1 = 91.82% e constante de taxa b2 = 0.0458 por minuto, S = 1.26.
Exemplo prático
Na etapa de carbonatação de um processo de bicarbonato de sódio, a conversão sobe rapidamente e depois se estabiliza. Um engenheiro de processo mede a conversão (%) em 15 tempos de residência de 2 a 120 minutos e quer a conversão limite e a constante de taxa. O engenheiro insere o modelo de primeira ordem Conversion = b1·(1 − exp(−b2·Time)) como função definida pelo usuário, fornece os valores iniciais 90 e 0.05 e marca as duas bandas.
O ajuste converge para b1 = 91.82% (IC de 95% de 90.23 a 93.40) e b2 = 0.0458 por minuto (IC de 95% de 0.0436 a 0.0480). S é 1.26 ponto percentual, pequeno em relação a uma faixa de 6 a 92%, e os pontos se situam sobre a curva em toda a sua extensão. A correlação entre b1 e b2 é −0.77: moderada, de modo que ambos os parâmetros estão bem determinados. O Gauss-Newton fornece as mesmas estimativas em 3 iterações. Sem tempos de residência repetidos, nenhum teste de falta de ajuste é exibido.
A partir da curva ajustada, 90% da conversão limite é atingida em ln(10)/b2 ≈ 50 minutos e 95% em cerca de 65 minutos; aos 30 minutos, a conversão é de apenas cerca de 69%. Tempos de residência muito além de uma hora rendem pouca conversão extra, o que ajuda o engenheiro a definir a vazão da torre.
Perguntas frequentes
O que é a regressão não linear?
A regressão não linear ajusta, a uma resposta e a um preditor, uma curva cujos parâmetros não entram de forma linear, como uma aproximação exponencial de um limite, uma curva de saturação ou uma curva de crescimento em forma de S. Ela encontra os valores dos parâmetros que minimizam a soma dos quadrados dos erros e os informa com erros padrão e intervalos de confiança.
Quando usar a regressão não linear?
Use a regressão não linear quando a física ou a química do processo indica a forma da curva e você quer estimativas de seus parâmetros, como um valor limite ou uma constante de taxa. As formas embutidas incluem decaimento e crescimento exponencial, potência, logística de 3 parâmetros, Michaelis-Menten, Gompertz e quadrática, ou você pode definir sua própria função.
Por que os valores iniciais importam na regressão não linear?
O ajuste é iterativo, portanto começa a partir de valores iniciais. As funções embutidas usam padrões fixos, enquanto uma função definida pelo usuário precisa de um valor inicial por parâmetro. Valores próximos do que você espera ajudam o ajuste a convergir; valores iniciais ruins podem fazer o ajuste falhar ou se fixar em um mau mínimo local.
Como saber se o ajuste de uma regressão não linear é confiável?
Verifique S e o quanto os pontos seguem a curva, e analise os gráficos de resíduos. Os intervalos de confiança são aproximados e deixam de ser confiáveis se os parâmetros estiverem mal determinados, o que aparece como correlações próximas de mais ou menos 1 na matriz de correlação dos parâmetros. Quando os valores do preditor são repetidos, um teste F de falta de ajuste verifica se a curva escolhida se ajusta.