
OECD
A ferramenta OECD Statistical Decision Tree é um sistema guiado de análise estatística, baseado na estrutura de decisão para selecionar e aplicar o teste estatístico correto a dados experimentais. Em vez de exigir que o usuário percorra manualmente a teoria estatística complexa, a ferramenta segue automaticamente o caminho de decisão da OECD, avaliando em cada etapa o tipo de dado, a normalidade, a homogeneidade das variâncias e o número de grupos, e aplica o teste apropriado.
Última revisão
Conclusão principal
A ferramenta OECD Statistical Decision Tree é um sistema guiado de análise estatística, baseado na estrutura de decisão para selecionar e aplicar o teste estatístico correto a dados experimentais.
Nesta página
O que é OECD?
A ferramenta OECD Statistical Decision Tree é um sistema guiado de análise estatística, baseado na estrutura de decisão para selecionar e aplicar o teste estatístico correto a dados experimentais. Em vez de exigir que o usuário percorra manualmente a teoria estatística complexa, a ferramenta segue automaticamente o caminho de decisão da OECD, avaliando em cada etapa o tipo de dado, a normalidade, a homogeneidade das variâncias e o número de grupos, e aplica o teste apropriado.
A ferramenta foi projetada para garantir que as conclusões estatísticas sejam cientificamente válidas, totalmente reprodutíveis e compatíveis com as diretrizes reconhecidas internacionalmente. Isso é particularmente crítico em toxicologia, ciência ambiental, pesquisa farmacêutica e estudos para submissão regulatória, nos quais a escolha do teste estatístico deve ser documentada, justificada e defensável em auditoria.
Definição simples: Uma ferramenta inteligente e automatizada que segue passo a passo o fluxograma de decisão estatística da OECD, avaliando o tipo de dado, a distribuição e a estrutura de grupos para selecionar e aplicar automaticamente o teste estatístico correto, de modo que você sempre obtenha um resultado válido e defensável.
Quando usar OECD?
- A abordagem do fluxograma da OECD é usada quando você precisa executar um pipeline completo de comparação estatística de uma só vez, em vez de decidir teste a teste ao longo do caminho. Em vez de parar após cada teste para descobrir o que vem a seguir, você informa de antemão as características dos dados (tipo de dado, resultado de normalidade, resultado de variância) e toda a árvore de decisão é resolvida de uma vez.
- É, sobretudo, uma estrutura de comparação : foi projetada especificamente para determinar qual teste estatístico é apropriado ao comparar grupos (2 grupos ou 3 ou mais grupos) entre si ou com um controle. Em vez de decidir teste a teste em cada etapa, você informa de antemão as características dos dados. É usada principalmente na área farmacêutica.
A ferramenta segue o fluxograma da OECD em uma sequência lógica estrita. Cada etapa produz uma decisão que determina qual ramo do caminho será seguido em seguida. Entender esse fluxo ajuda a interpretar as saídas da ferramenta e a compreender por que um determinado teste estatístico foi selecionado para os seus dados.
Etapa 1 — Avaliação do tipo de dado
O primeiro ponto de decisão determina se os seus dados são contínuos ou discretos/quantais. Essa distinção orienta todo o caminho seguinte.
Tipo de dado
Descrição e exemplos
Dados contínuos
Valores numéricos medidos que podem assumir qualquer valor dentro de uma faixa, como peso corporal, atividade enzimática, peso de órgãos, concentração ou parâmetros hematológicos. Para dados contínuos, a ferramenta passa à verificação de normalidade.
Dados discretos ou quantais
Contagens, porcentagens, proporções, postos ou resultados categóricos, como número de animais afetados, incidência de uma lesão, presença ou ausência de uma resposta ou escores de gravidade. A ferramenta passa diretamente à seleção de testes não paramétricos ou categóricos.
Etapa 2 — Verificação de normalidade (dados contínuos)
Para dados contínuos, a ferramenta verifica se os dados seguem uma distribuição normal (em forma de sino) usando os testes de normalidade selecionados. O resultado determina qual caminho estatístico será seguido.
Se a normalidade NÃO é rejeitada (p ≥ α) — os dados são normais:
→ A ferramenta segue pelo caminho paramétrico.
→ Os testes paramétricos têm maior poder estatístico e devem sempre ser usados quando a normalidade é confirmada.
Se a normalidade É rejeitada (p < α) — os dados não são normais:
→ Tenta-se uma transformação dos dados (logarítmica, raiz quadrada etc.).
→ A normalidade é verificada novamente nos dados transformados.
→ Se os dados transformados são normais → aplicam-se testes paramétricos aos dados transformados.
→ Se os dados transformados continuam não normais → a ferramenta passa ao caminho não paramétrico.
Etapa 3 — Caminho paramétrico
Uma vez confirmado que os dados são normais (ou transformados com sucesso para a normalidade), a ferramenta determina o teste paramétrico apropriado com base no número de grupos comparados.
Comparação de 2 grupos
A ferramenta verifica a homogeneidade das variâncias com o teste F para determinar se os dois grupos têm variâncias estatisticamente iguais.
Resultado da homogeneidade das variâncias
Teste estatístico aplicado
Variâncias iguais (teste F não significativo)
Aplica-se o teste t de Student. É o teste t de duas amostras padrão, que pressupõe variâncias iguais nos dois grupos.
Variâncias diferentes (teste F significativo)
Aplica-se o método de Satterthwaite (teste t de Welch). Essa variante não pressupõe variâncias iguais e ajusta os graus de liberdade de acordo.
Comparação de 3 ou mais grupos
A ferramenta verifica a homogeneidade das variâncias com o teste de Bartlett, o teste de Levene ou o teste de Brown-Forsythe.
Resultado da homogeneidade das variâncias
Teste estatístico aplicado
Variâncias iguais (não significativo)
Aplica-se a análise de variância (ANOVA). → Se a ANOVA for significativa: executa-se o teste de Dunnett para a comparação par a par de cada grupo de tratamento com o controle. → Se a ANOVA não for significativa: não é necessário nenhum teste adicional. Pare.
Variâncias diferentes (significativo)
A ferramenta passa diretamente ao teste apropriado que não pressupõe homogeneidade das variâncias.
Etapa 4 — Caminho não paramétrico
Quando os dados não podem ser normalizados, ou quando consistem em contagens, porcentagens ou postos, a ferramenta segue o caminho não paramétrico.
Situação dos dados
Teste aplicado
Resultado / acompanhamento
Dados de contagem / porcentagem / posto, ≥ 3 grupos
Teste de Kruskal-Wallis
Se significativo → teste de Dunn (post-hoc). Se não significativo → pare.
Dados de contagem / porcentagem / posto, 2 grupos
Teste U de Mann-Whitney
Comparação direta entre dois grupos independentes.
Dados categóricos ou de índices
Qui-quadrado
A seleção do teste depende da estrutura específica dos dados e do delineamento do estudo.
Diretrizes para o uso correto de OECD
- Garanta que os dados sejam inseridos de forma correta e consistente: erros de digitação na etapa de entrada se propagam por todas as decisões seguintes da árvore e podem levar à aplicação de um teste incorreto.
- Selecione as colunas de resposta com cuidado: se várias respostas forem selecionadas, cada coluna deve representar um conjunto de dados de grupo completo e independente. Se uma única resposta for selecionada, garanta que a coluna de fator identifique correta e completamente o grupo de cada observação.
- Mantenha ativos ambos os testes de normalidade, Anderson-Darling e Shapiro-Wilk (o padrão). Ter dois testes independentes confirmando a mesma conclusão de normalidade reforça a defensabilidade científica do caminho escolhido.
Alternativas: quando não usar OECD
- Se o seu estudo não exige conformidade com as diretrizes da OECD e não tem contexto regulatório, use diretamente o teste estatístico específico mais apropriado: a estrutura da árvore de decisão da OECD acrescenta uma carga estruturada que pode ser desnecessária em análises puramente exploratórias ou acadêmicas.
- Se o seu estudo exige regressão, análise de correlação ou modelagem dose-resposta em vez de uma simples comparação de grupos, use as ferramentas apropriadas de regressão ou modelagem: a ferramenta OECD foi projetada especificamente para a comparação de médias de grupos, e não para ajustar relações entre variáveis contínuas.
- Se você tem observações pareadas , por exemplo, medições antes e depois do mesmo indivíduo, use o teste t pareado ou o teste de postos sinalizados de Wilcoxon . A árvore de decisão da OECD, como implementada aqui, pressupõe grupos independentes.
- Se os dados são de natureza temporal ou longitudinal , em que as medições evoluem ao longo de vários pontos sequenciais no tempo, use ANOVA de medidas repetidas, modelos de efeitos mistos ou análise de séries temporais
- Se o objetivo analítico principal for teste de equivalência ou avaliação de não inferioridade em vez da detecção de diferenças, use procedimentos dedicados de teste de equivalência, e não a estrutura padrão de superioridade da árvore de decisão da OECD.
Exemplo de OECD
Um engenheiro químico quer comparar a dureza de quatro misturas de tinta. Seis amostras de cada mistura de tinta foram aplicadas a uma peça de metal, que depois foi curada. Em seguida, mediu-se a dureza de cada amostra. Os passos são os seguintes:
- Reúna os dados necessários.
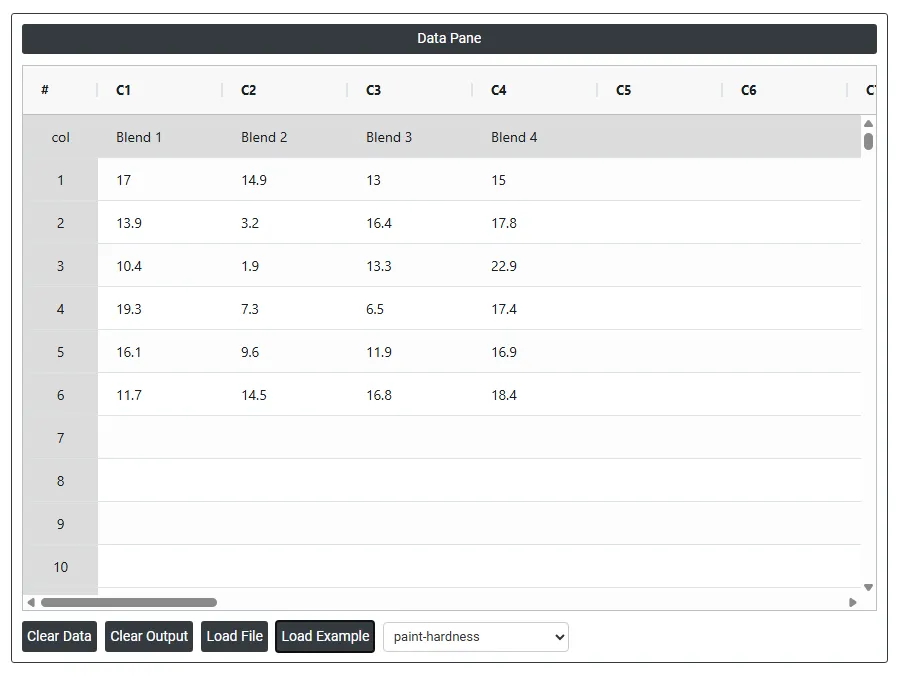
2. Agora analise os dados no Zometric Statistical Software em https://statsai.zometric.com/.
3. Para encontrar OECD, escolha Statistical module> OECD>OECD.
4. Dentro da ferramenta, insira os dados junto com as demais entradas, como segue:
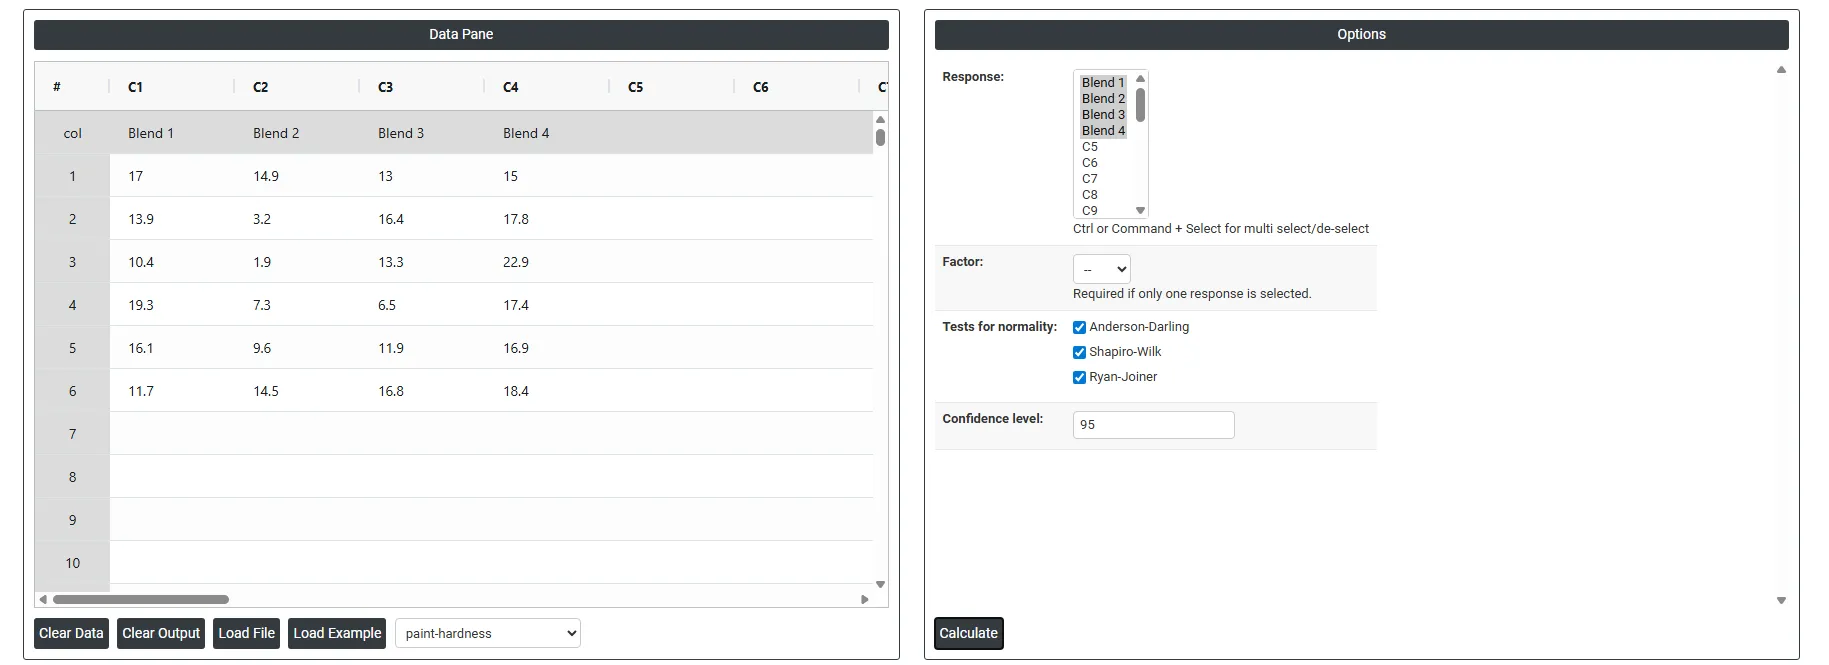
5. Depois de usar a ferramenta acima, a saída obtida é a seguinte:
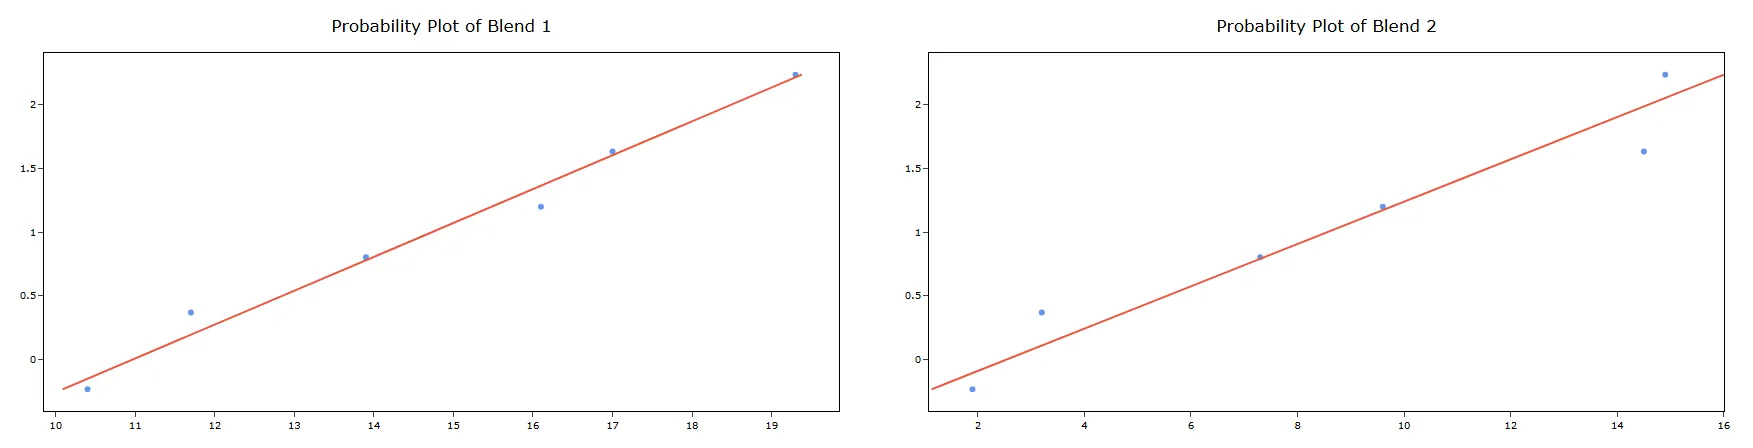
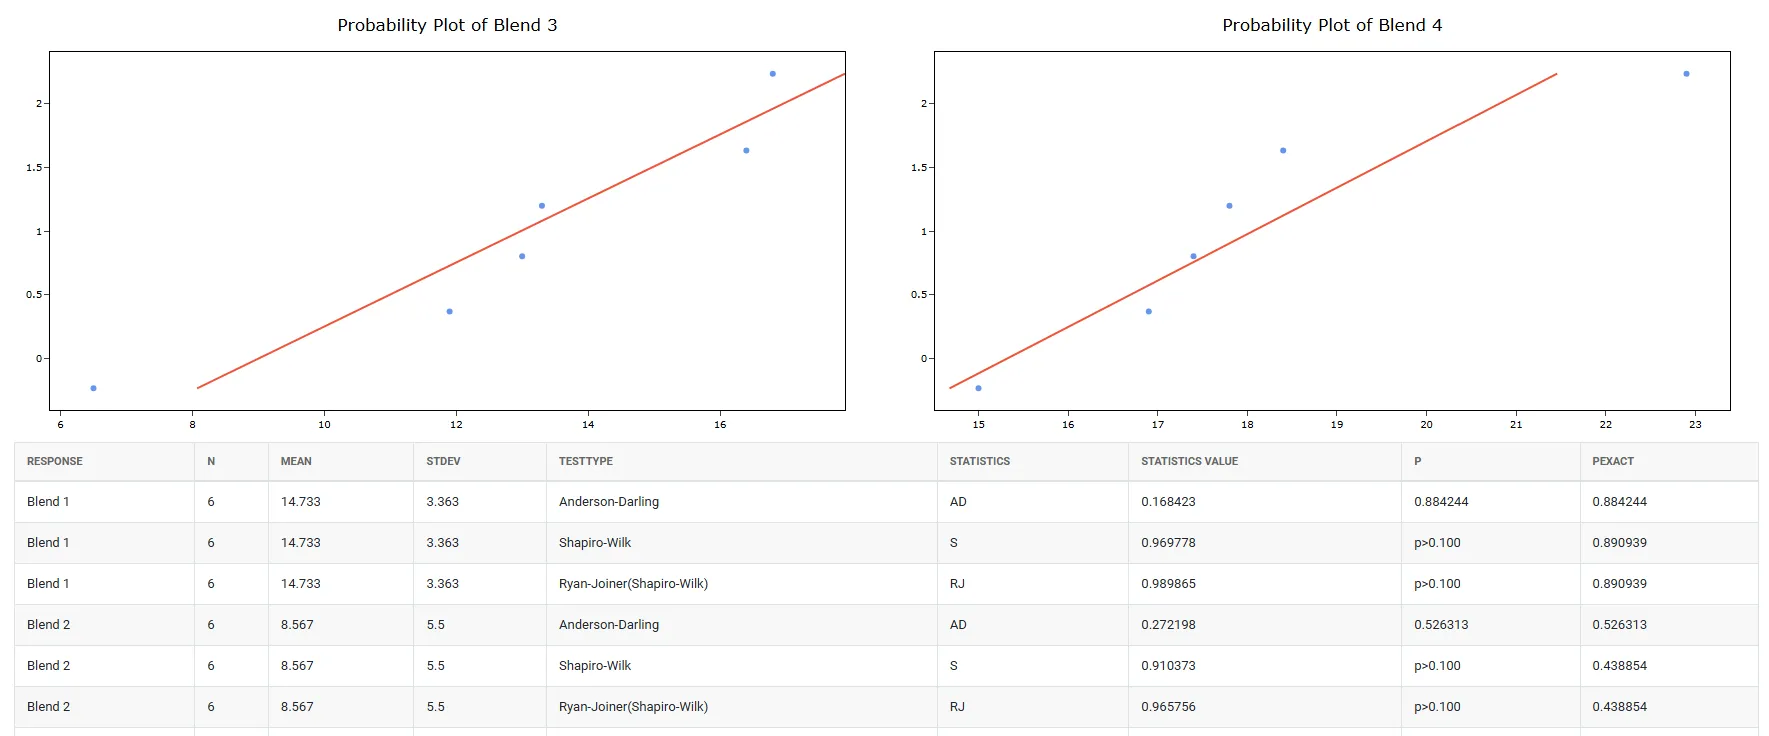
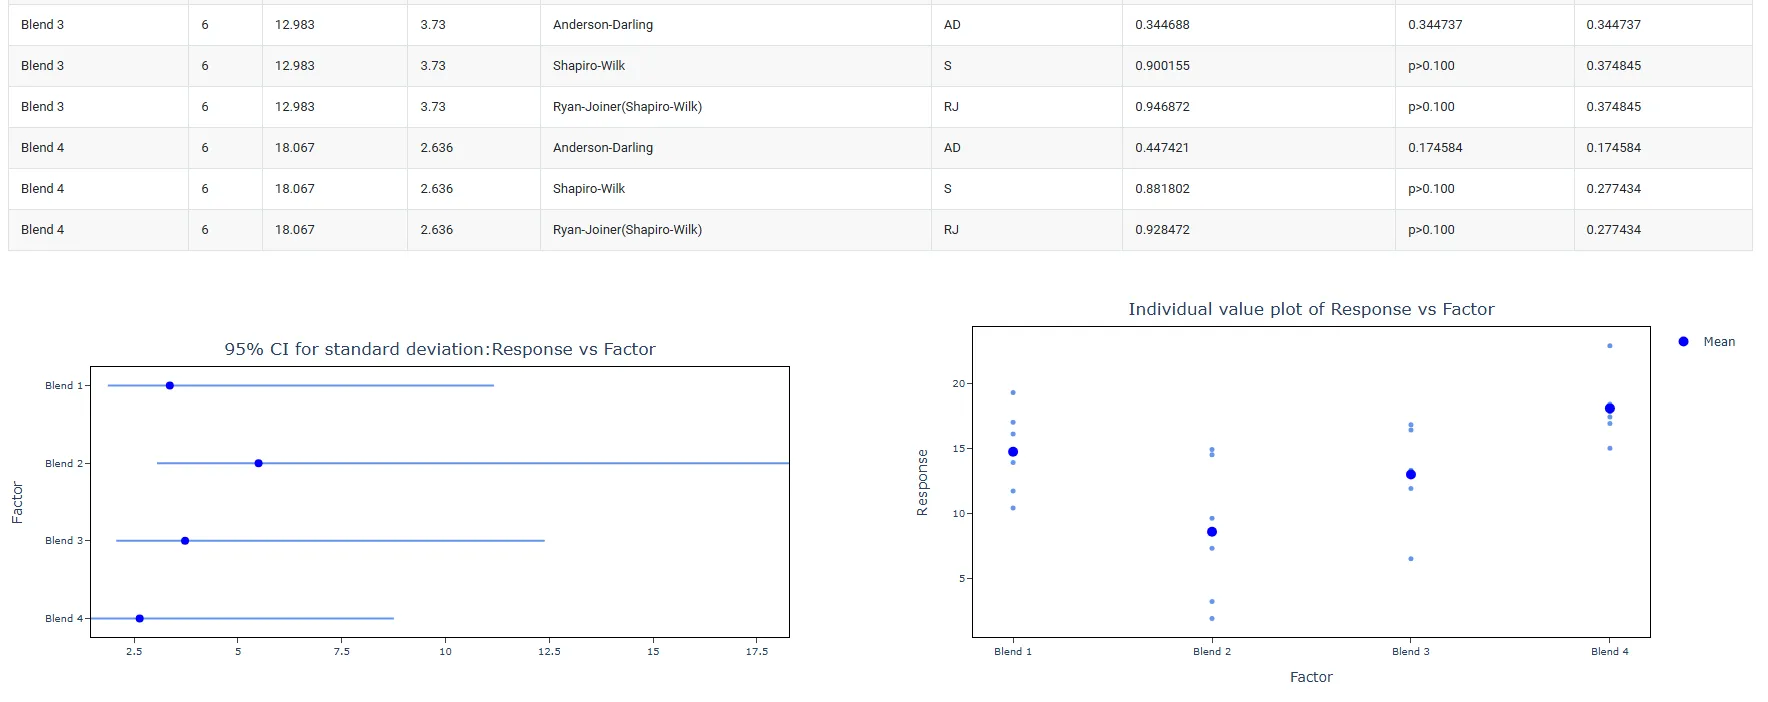
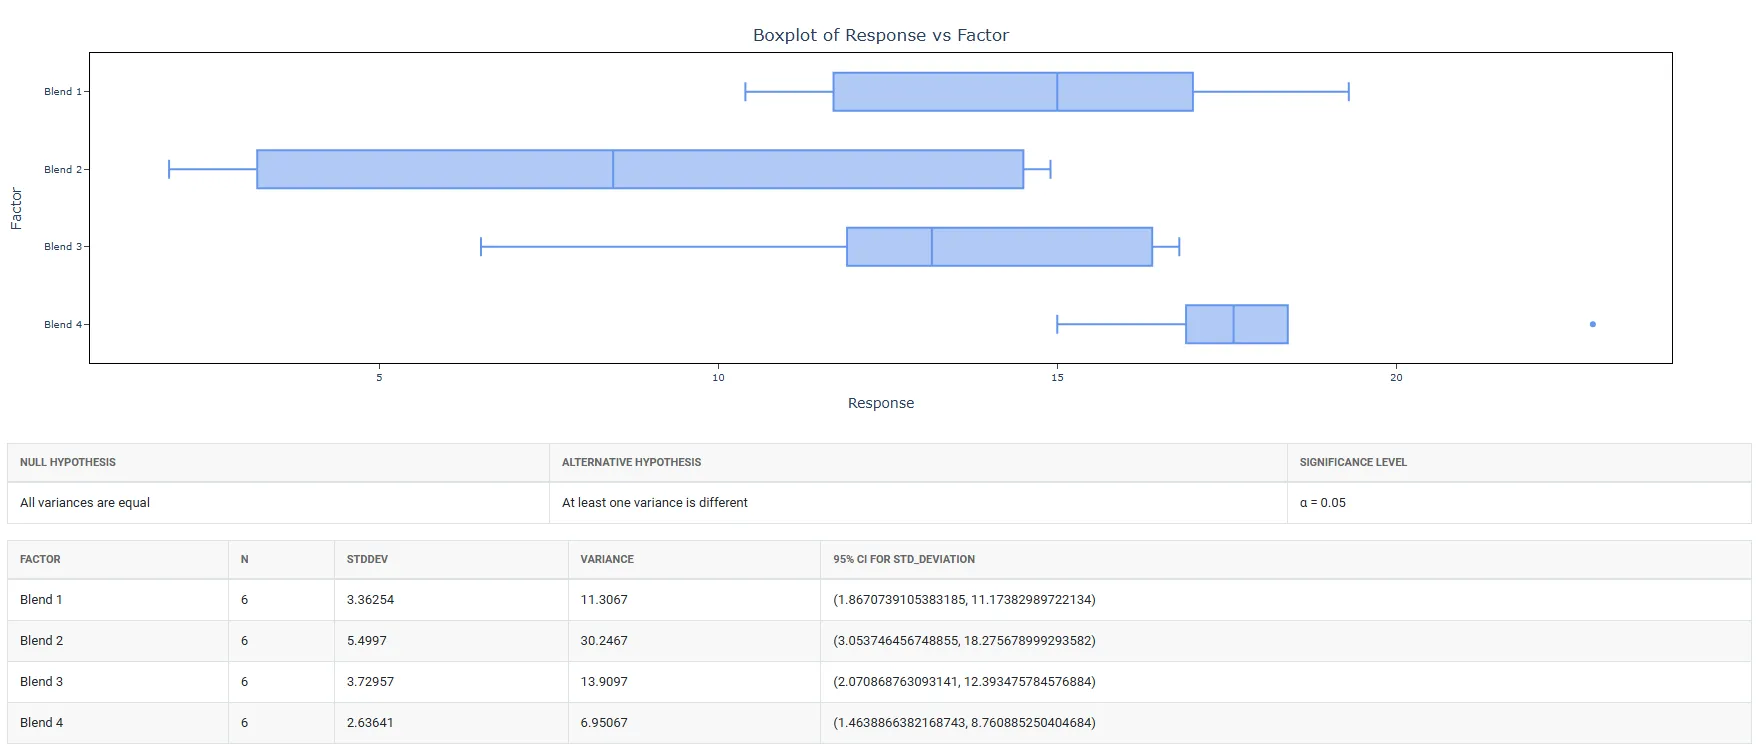
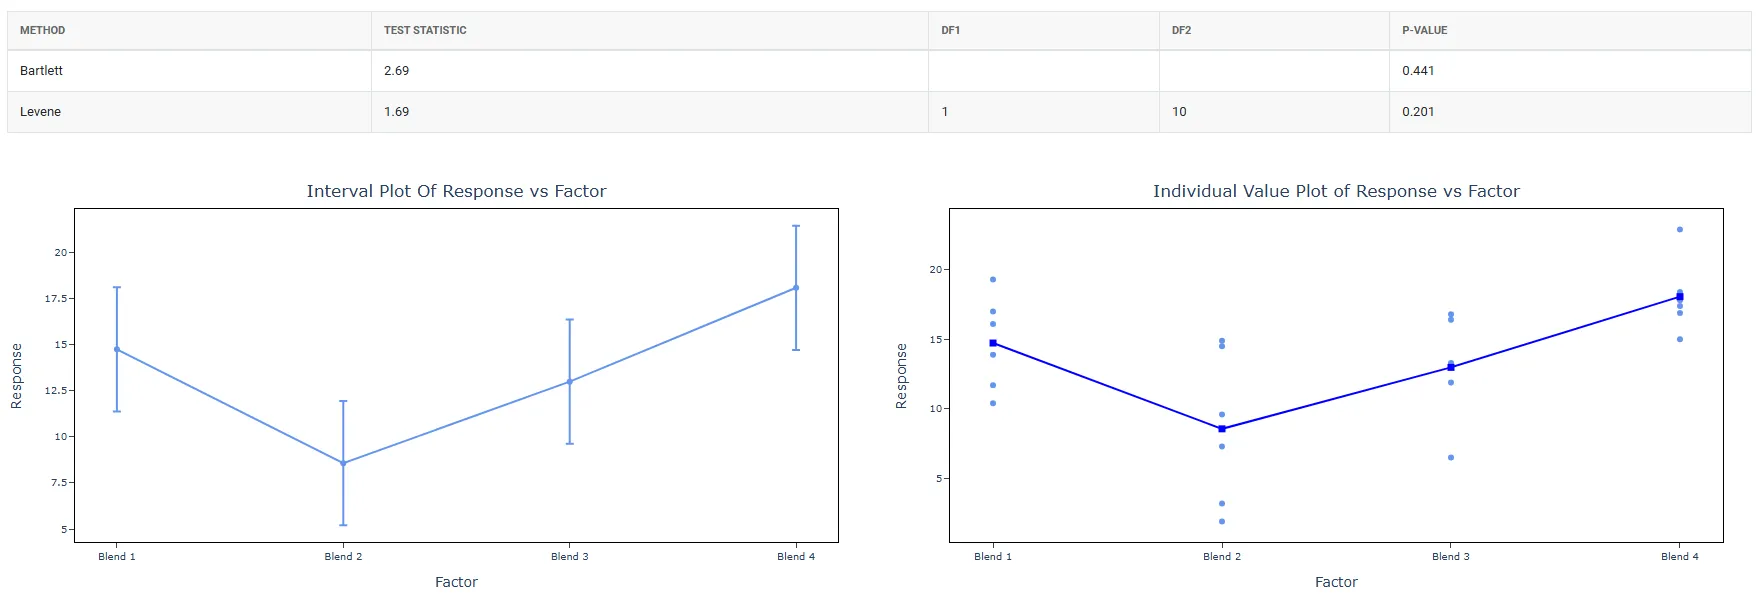
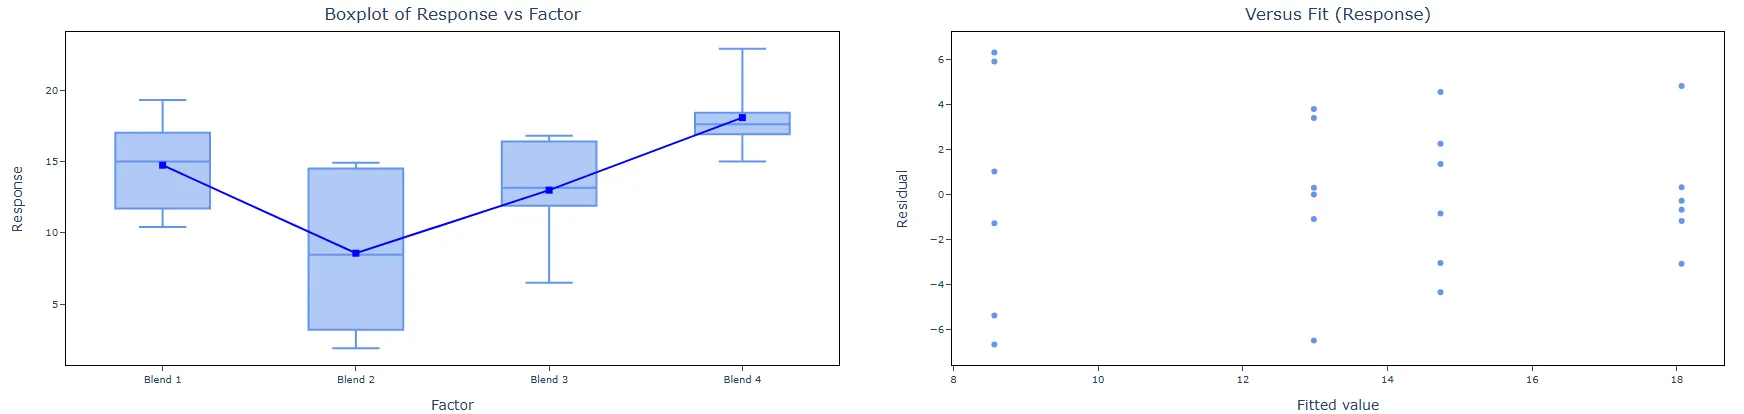
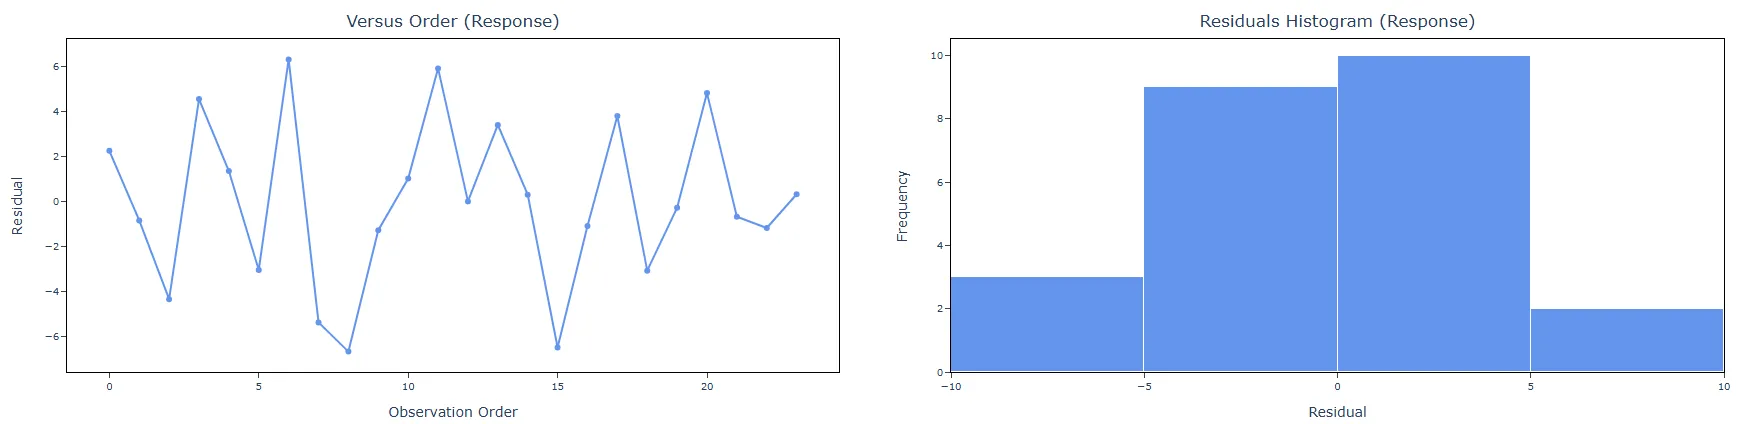
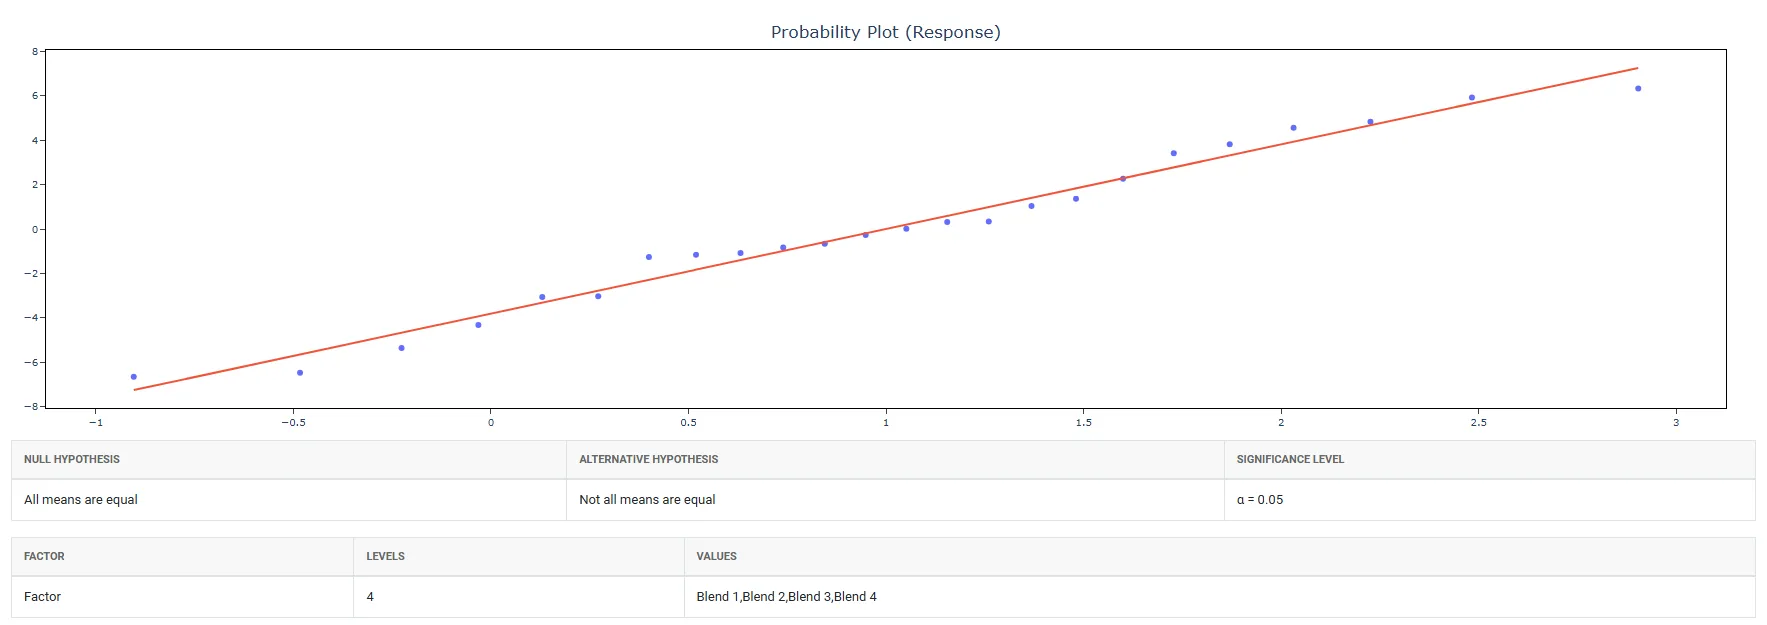
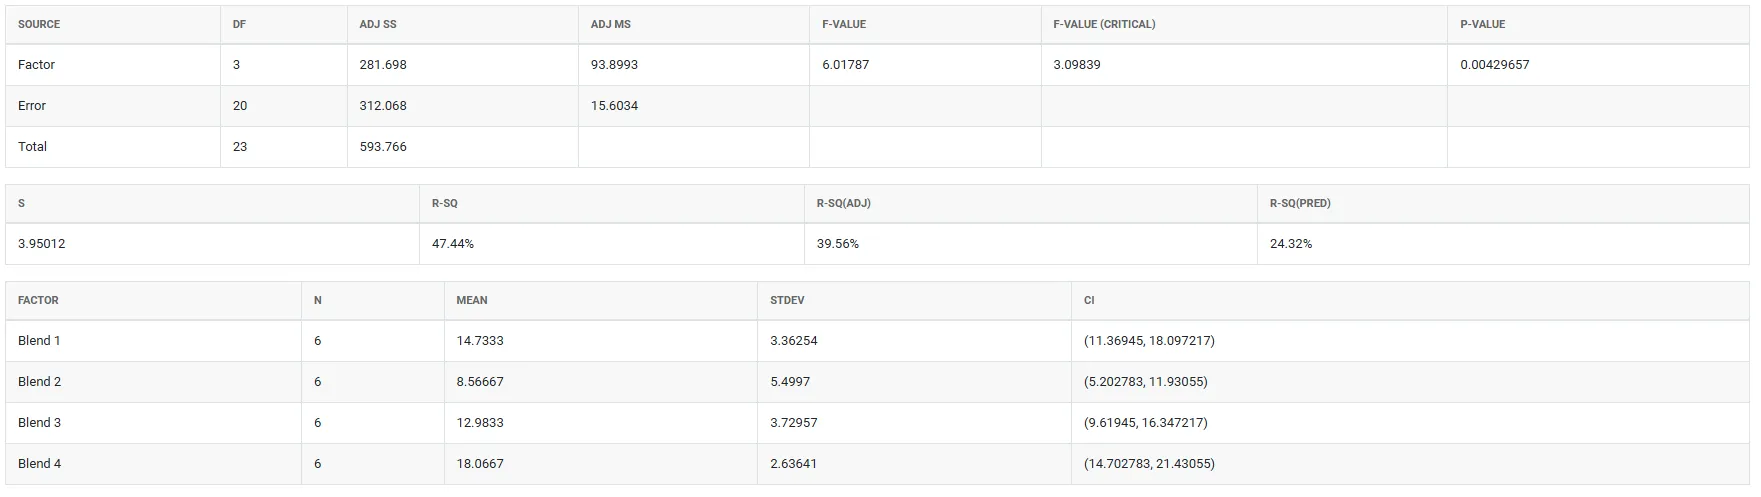
Como fazer OECD
O guia é o seguinte:
- Faça login no Zometric Statistical Software em https://statsai.zometric.com/
- Na página inicial, escolha Statistical Tool> OECD>OECD.
- Em seguida, atualize os dados manualmente, ou copie todos os dados (Ctrl+C) de uma planilha do Excel e cole-os (Ctrl+V) aqui; ou, ainda, use a opção Load Example, que carrega os dados de exemplo.
- Em seguida, preencha as opções necessárias.
- Por fim, clique em calculate na parte inferior da página para obter os resultados desejados.
No painel (dashboard) de OECD, a janela é dividida em duas partes.
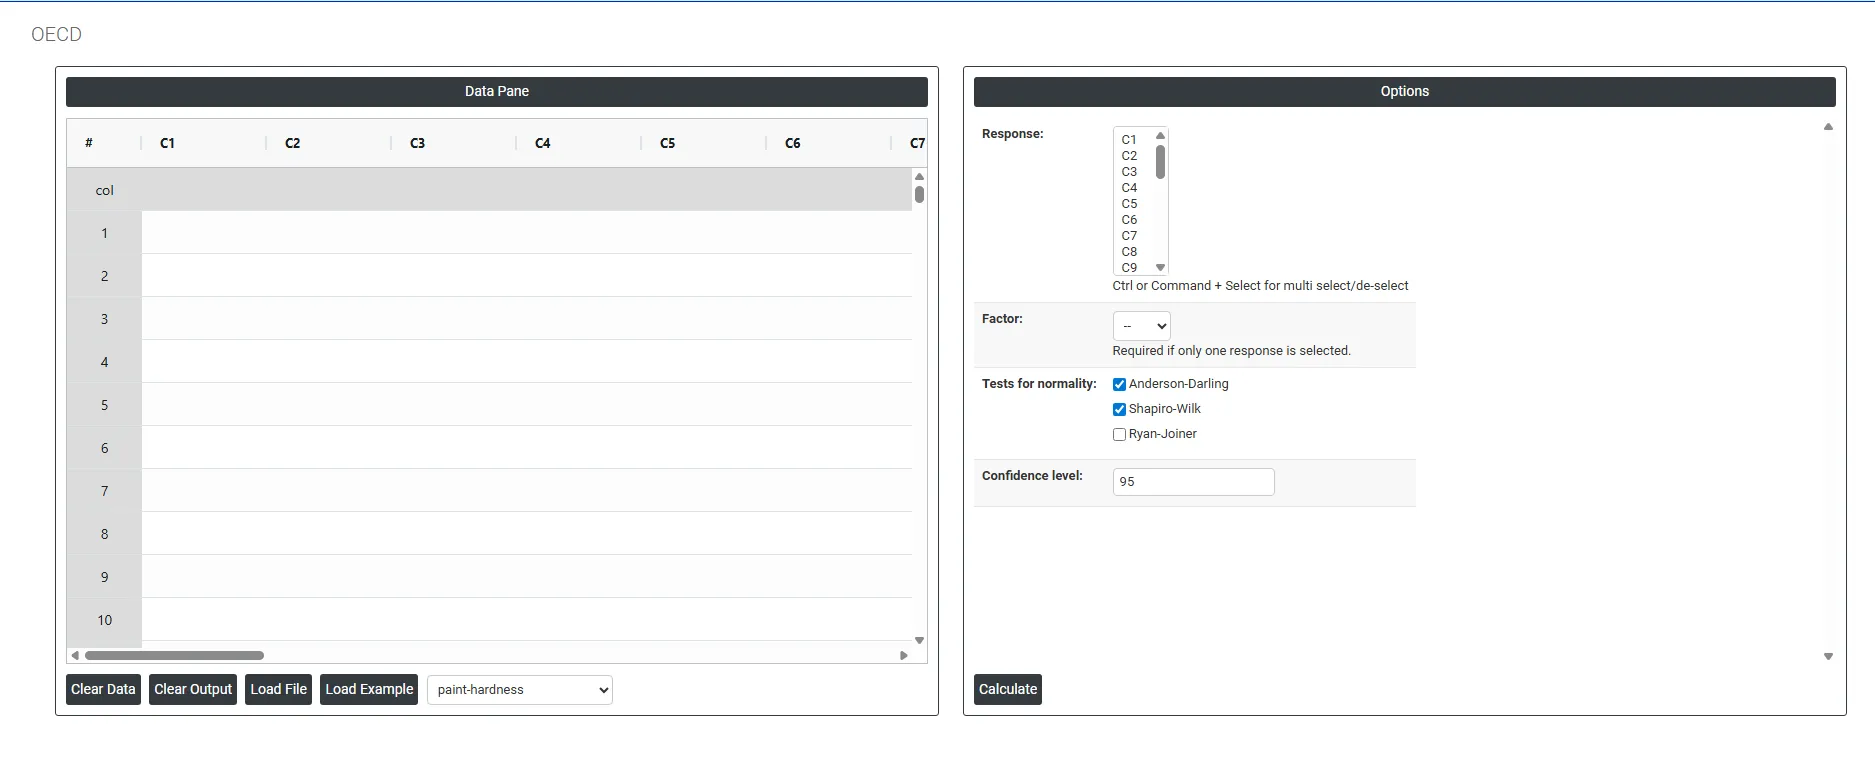
Na parte esquerda fica o painel de dados (Data Pane). No Data Pane, cada linha forma um subgrupo. Os dados podem ser inseridos manualmente, ou você pode copiar todos os dados (Ctrl+C) de uma planilha do Excel e colá-los (Ctrl+V) aqui.
Load example: Os dados de exemplo serão carregados.
Load File: É usado para carregar diretamente os dados do Excel.
Na parte direita, há várias opções, descritas a seguir:
- Response: Selecione a coluna ou as colunas que contêm as medições de resultado que você quer analisar, como peso corporal, atividade enzimática, incidência de tumores, valores hematológicos ou qualquer outro desfecho registrado entre os grupos do estudo. Use Ctrl ou Command + clique para selecionar várias colunas de resposta simultaneamente.
O número de colunas de resposta selecionadas determina diretamente se a opção Factor é obrigatória:
Seleção
Como a ferramenta se comporta
Várias respostas selecionadas
Cada coluna selecionada representa um grupo distinto. A ferramenta usa as próprias colunas para definir os grupos; não é necessária nenhuma coluna Factor adicional. As medições de cada coluna são comparadas diretamente entre si.
Uma única resposta selecionada
Todas as medições ficam empilhadas em uma coluna e é preciso selecionar uma coluna Factor separada para identificar a qual grupo cada medição pertence. Sem a coluna Factor, a ferramenta não consegue determinar quais observações pertencem a quais grupos.
⚠ Importante: Quando uma única resposta é selecionada, o campo Factor passa a ser obrigatório. A ferramenta solicitará que você selecione uma coluna Factor antes que a análise possa prosseguir.
- Factor: Selecione a coluna que identifica o grupo de cada observação. Essa coluna contém rótulos ou códigos categóricos que indicam a qual grupo experimental cada linha de dados pertence, por exemplo, Control, Low Dose, Mid Dose, High Dose, ou Group 1, Group 2, Group 3. A coluna de fator informa à ferramenta como dividir a coluna única de resposta em grupos distintos para comparação. Sem a especificação correta do fator, todas as medições seriam tratadas como pertencentes ao mesmo grupo e nenhuma comparação significativa seria possível. Este campo só é obrigatório quando exatamente uma coluna de resposta é selecionada. Quando várias colunas de resposta são selecionadas, cada coluna representa um grupo e nenhum Factor é necessário. O campo ficará esmaecido ou será ignorado quando várias respostas forem selecionadas
- Tests for Normality: Define qual teste estatístico, ou quais testes, são usados na Etapa 2 da árvore de decisão para avaliar se os dados de resposta seguem uma distribuição normal. O resultado desse teste determina se o caminho analítico paramétrico ou o não paramétrico será seguido em toda a análise. Há três testes disponíveis:
- Anderson-Darling : Um teste de normalidade omnibus poderoso, que dá ênfase especial às caudas da distribuição, isto é, aos valores extremos altos e baixos. Isso o torna especialmente sensível a desvios da normalidade nas caudas, que costumam ser as regiões de maior importância prática em dados toxicológicos e ambientais. O teste de Anderson-Darling é recomendado para uso geral em uma ampla faixa de tamanhos amostrais e é particularmente eficaz quando se espera que o comportamento das caudas difira da distribuição normal.
- Shapiro-Wilk: Amplamente considerado o teste de normalidade mais poderoso e confiável para tamanhos amostrais pequenos, tipicamente n < 50, que é a situação mais comum em estudos conforme as diretrizes da OECD, nos quais os tamanhos de grupo costumam ser de 5 a 20 animais. O teste de Shapiro-Wilk é o principal teste de normalidade citado na orientação estatística da OECD e é a escolha padrão em estatística farmacêutica e toxicológica. Recomenda-se fortemente que esse teste permaneça sempre ativo em análises de estudos regulatórios.
- Ryan-Joiner: Um teste de normalidade baseado em correlação, que avalia o quanto os dados seguem o padrão esperado de uma distribuição normal medindo a correlação entre os dados observados e os quantis normais teóricos. É conceitualmente semelhante ao teste de Shapiro-Wilk, mas usa uma abordagem computacional diferente. É menos comumente exigido em trabalhos regulatórios, mas pode ser ativado quando uma avaliação de normalidade baseada em correlação é especificamente solicitada ou preferida pela autoridade revisora.
- Quando vários testes de normalidade são selecionados, a ferramenta executa todos os testes marcados e informa todos os resultados. A decisão geral sobre a normalidade baseia-se no resultado mais conservador: se qualquer teste selecionado indicar não normalidade (p < α), os dados são tratados como não normais e o caminho não paramétrico é seguido
Confidence Level (Default: 95): Define o limiar de significância usado de forma consistente em todos os testes de hipóteses de toda a árvore de decisão, incluindo o teste de normalidade, o teste de homogeneidade das variâncias e o teste final de comparação de grupos. O valor informado representa a confiança em porcentagem, e o nível alfa (α) correspondente usado em todas as decisões é calculado como (100 − Confidence Level) ÷ 100.
Nível de confiança
Nível alfa e quando usar
95 (padrão)
Alpha = 0.05. O nível de confiança padrão para a maioria dos estudos científicos e regulatórios da OECD. Há 5% de chance de uma conclusão falso-positiva. É o nível mais comumente exigido pelas diretrizes da OECD e pelas autoridades regulatórias do mundo todo.
99
Alpha = 0.01. Um teste mais conservador exige evidências mais fortes antes de declarar um resultado significativo. Reduz os falsos positivos, mas pode deixar passar efeitos reais menores. Use quando as consequências de um falso positivo forem particularmente graves.
90
Alpha = 0.10. Um teste mais sensível detecta diferenças menores, mas aumenta o risco de conclusões falso-positivas. Só é apropriado para estudos exploratórios ou piloto, nos quais o maior receio é deixar passar um efeito real.
Perguntas frequentes
O que é a árvore de decisão estatística da OECD?
A ferramenta OECD Statistical Decision Tree é um sistema de análise guiado que seleciona e aplica o teste estatístico correto a dados experimentais. Ela segue o caminho de decisão da OECD, avaliando em cada etapa o tipo de dado, a normalidade, a homogeneidade das variâncias e o número de grupos, de modo que as conclusões sejam reprodutíveis e defensáveis. É usada em toxicologia, ciência ambiental, pesquisa farmacêutica e submissões regulatórias.
Quais testes a árvore de decisão da OECD aplica a dados normais?
Para dois grupos, um teste F verifica a variância: variâncias iguais levam ao teste t de Student e variâncias diferentes ao método de Satterthwaite (teste t de Welch). Para três ou mais grupos, o teste de Bartlett, de Levene ou de Brown-Forsythe verifica a variância; com variâncias iguais, aplica-se a ANOVA, seguida do teste de Dunnett contra o controle se a ANOVA for significativa.
O que acontece quando os dados não são normais na árvore de decisão da OECD?
Se a normalidade for rejeitada, tenta-se uma transformação, como logarítmica ou raiz quadrada, e a normalidade é verificada novamente. Se os dados transformados continuarem não normais, segue-se o caminho não paramétrico: Kruskal-Wallis com o teste post-hoc de Dunn para três ou mais grupos, o teste U de Mann-Whitney para dois grupos e qui-quadrado para dados categóricos ou de índices.
Quando não usar a árvore de decisão da OECD?
Não a use para observações pareadas, que exigem um teste t pareado ou o teste de postos sinalizados de Wilcoxon, para regressão ou modelagem dose-resposta, para dados de séries temporais ou longitudinais, nem para testes de equivalência e não inferioridade. Sem um contexto regulatório da OECD, usar diretamente o teste específico mais apropriado pode ser mais simples.