
Regressão de Poisson
A regressão de Poisson modela contagens de eventos em uma quantidade fixa de tempo, área ou produto em função de preditores contínuos e categóricos. Use-a em vez da regressão comum porque as contagens não podem ser negativas e sua dispersão cresce com a média. Pressupõe-se que a resposta siga uma distribuição de Poisson, com função de ligação log, raiz quadrada ou identidade. A saída inclui coeficientes, análise de deviance, testes de aderência e gráficos de resíduos.
Última revisão
Conclusão principal
A regressão de Poisson é um modelo linear generalizado que relaciona uma resposta de contagem, como defeitos por turno ou paradas por mês, a preditores contínuos e categóricos, ajustado por máxima verossimilhança.
Nesta página
Finalidade
A regressão de Poisson relaciona uma resposta de contagem, como defeitos por turno, paradas por mês ou falhas por painel, a preditores contínuos e categóricos. Use-a em vez da regressão comum quando a resposta for uma contagem de eventos em uma quantidade fixa de tempo, área ou produto: as contagens não podem ser negativas e sua dispersão cresce com a média, o que os mínimos quadrados não contemplam.
Principais recursos
- Preditores contínuos e categóricos, com interações e termos quadráticos a partir da lista de termos.
- Função de ligação log (padrão), raiz quadrada ou identidade.
- Seleção stepwise, por inclusão progressiva (forward) ou por eliminação regressiva (backward) de termos, com termos forçados em todos os modelos.
- Coeficientes com intervalos de confiança e VIF, equações de regressão para cada nível de um preditor categórico, resumo do modelo e testes de aderência.
- Análise de deviance por testes de Wald ou da razão de verossimilhanças (ajustada ou sequencial).
- Observações incomuns, gráficos de resíduos, gráficos de efeitos principais e de interação, gráficos de contorno e de superfície das contagens ajustadas.
- Previsão nas configurações que você informar e um otimizador de resposta.
Métodos estatísticos
Pressupõe-se que a resposta siga uma distribuição de Poisson com média μ que depende dos preditores por meio da função de ligação: com a ligação log, ln μ = b₀ + b₁x₁ + … , de modo que cada coeficiente multiplica a contagem esperada por exp(b) por unidade do seu preditor. O modelo é um modelo linear generalizado ajustado por máxima verossimilhança (mínimos quadrados reponderados iterativamente). Os preditores categóricos usam codificação (1, 0) em relação a um nível de referência, por padrão o primeiro nível na ordem de classificação. As linhas com valor ausente são descartadas; uma coluna de frequência repete linhas e uma coluna de pesos fornece pesos de variância.
A tabela de coeficientes fornece os valores z de Wald (Coef / SE Coef) e os intervalos de confiança. A análise de deviance testa cada termo: por padrão com um qui-quadrado de Wald (z² para um termo contínuo, um teste conjunto para as colunas dummy de um termo categórico); com o teste LR, pela variação da deviance quando o termo é removido do modelo completo (ajustada, Tipo III) ou adicionado em ordem (sequencial, Tipo I). R-Sq da deviance = 1 − deviance residual / deviance nula.
Os testes de aderência comparam a deviance e o qui-quadrado de Pearson com uma distribuição qui-quadrado nos graus de liberdade do erro. Um valor-p pequeno, ou uma Mean (deviance / DF) bem acima de 1, significa que as contagens variam mais do que um modelo de Poisson permite (superdispersão), e os valores-p dos termos são então pequenos demais. As observações com resíduo padronizado além de ±2 são sinalizadas com R, e aquelas com alavancagem acima de 3p/n são sinalizadas com X.
Campos de entrada e opções
Campo | Descrição |
Response | Coluna de contagens. Obrigatório. |
Continuous Predictors / Categorical Predictor | Colunas de preditores numéricos e de texto (ou codificados); pelo menos uma. Ctrl ou Command + clique para selecionar várias. |
Model terms (optional) | Lista de termos: marque os termos, ou use Add all, Interactions e Powers até a ordem escolhida em Terms through order (2 ou 3). Desmarque In model para remover um termo linear mantendo suas interações. |
Reference level (optional) | Para preditores categóricos, “Predictor Level”, separados por vírgula. Padrão: primeiro nível na ordem de classificação. |
Stepwise method | None (padrão), Stepwise, Forward selection ou Backward elimination; com Alpha to enter e Alpha to remove (0.15), regras de hierarquia, Terms in every model (E), Initial model terms (I) e Model selection details. |
Frequency (optional) / Weights (optional) | Colunas de frequências das linhas e de pesos. |
Link function | Log (padrão), Square root ou Identity. |
Confidence level / Type of confidence interval | Padrão 95, Two-sided; ou Lower bound ou Upper bound. |
Fits and diagnostics for all observations | Lista o ajuste e o resíduo de cada linha, não apenas das incomuns. |
Test for ANOVA table / Type of deviance (LR test only) | Wald test (padrão) ou LR test; para LR, Adjusted (Type III, padrão) ou Sequential (Type I). |
Residuals for diagnostics/plots | Deviance (padrão) ou Pearson. |
Histogram of residuals / Normal probability plot of residuals / Residuals versus fits / Residuals versus order / Four in one / Residuals versus the variables | Gráficos de resíduos. |
Main effects plot / Interaction plot | Contagem ajustada em função de cada preditor, com os demais mantidos em sua média ou nível de referência. |
Contour plot / Surface plot / Overlaid contour plot of fitted values | Exigem as variáveis dos eixos X1 e X2; o overlaid contour plot também exige Response low e Response high. |
Prediction / Response Optimizer | Adicione um painel para prever a contagem média (com SE e intervalo de confiança) nas configurações que você informar, ou para buscar configurações que atendam a uma meta de contagem. |
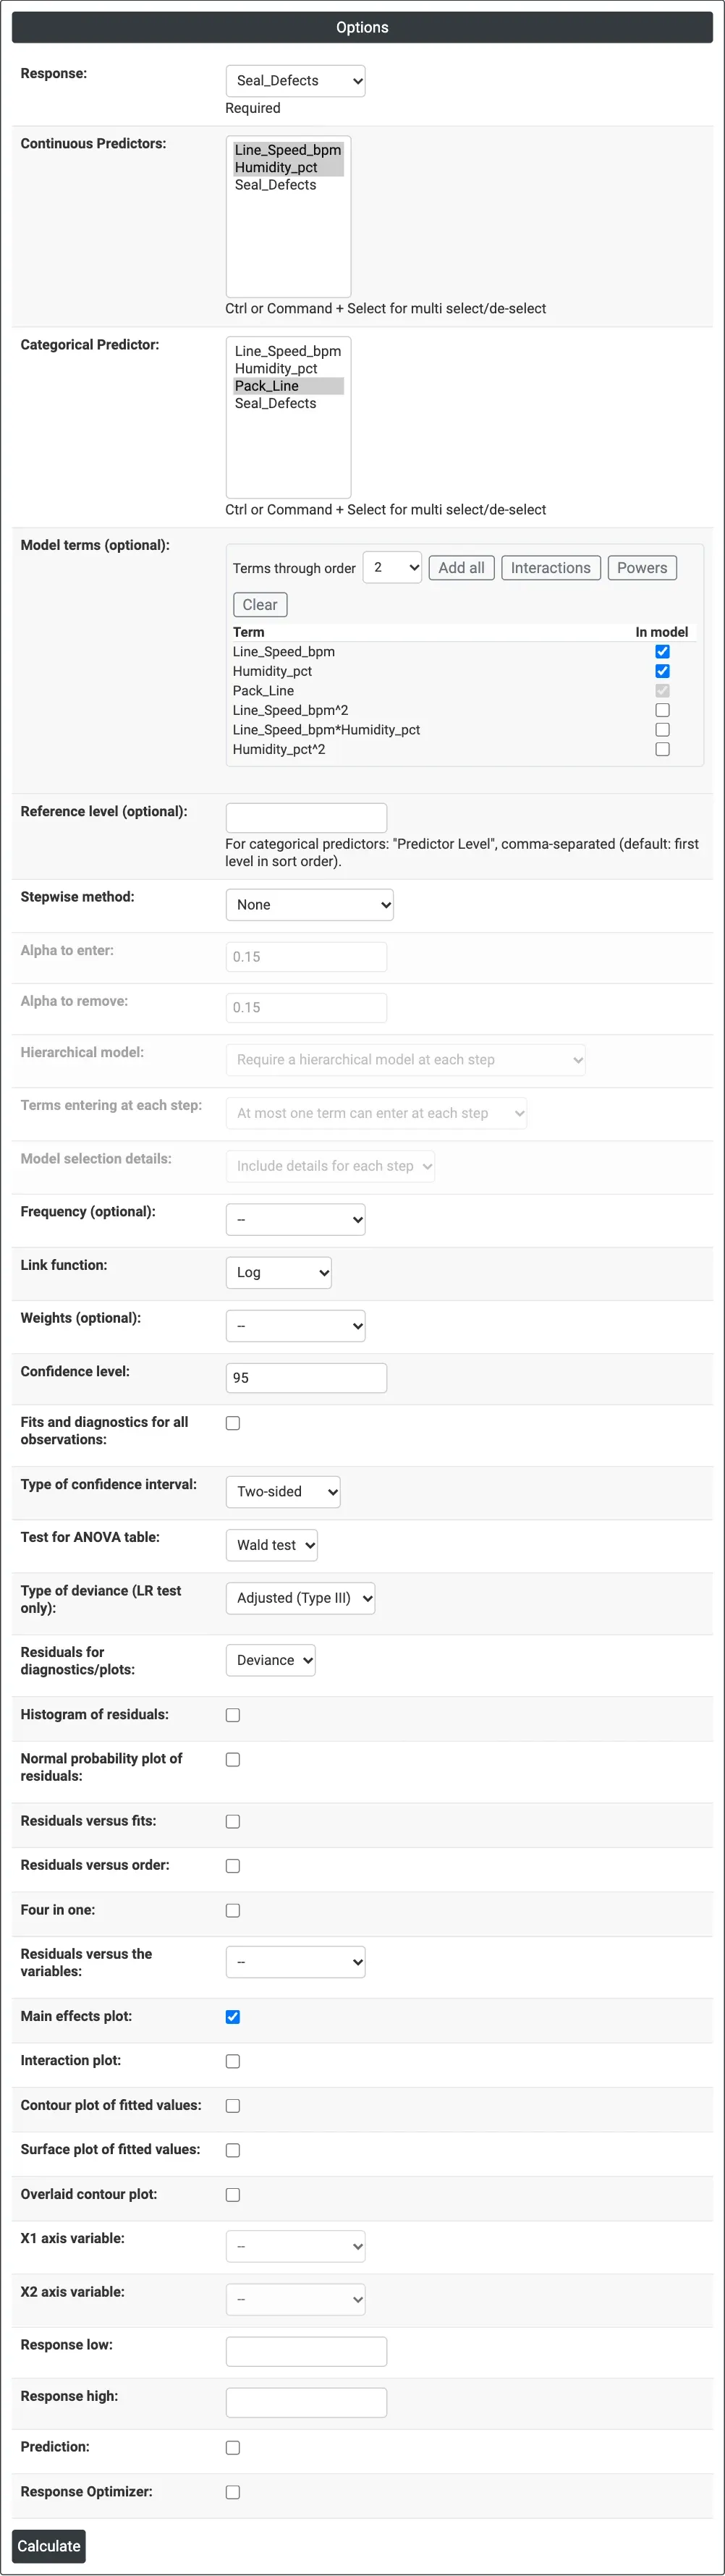
Figura 1 — Opções do exemplo de vedação de sacos: Seal_Defects como resposta, velocidade da linha e umidade como preditores contínuos, linha de embalagem como preditor categórico, gráfico de efeitos principais marcado.
Descrição da saída
- Method — função de ligação, codificação categórica e linhas usadas.
- Response Information — N, média, desvio padrão, mínimo e máximo das contagens.
- Coefficients — Coef, SE Coef, Z-Value, P-Value, limites de confiança e VIF.
- Regression Equation — o preditor linear Y' (ln da contagem esperada com a ligação log) para cada nível dos preditores categóricos.
- Model Summary — R-Sq da deviance, Adj R-Sq, AIC, AICc e BIC.
- Goodness-of-Fit Tests — testes de qui-quadrado da deviance e de Pearson.
- Fits and Diagnostics for Unusual Observations.
- Analysis of Deviance — qui-quadrado e valor-p da regressão e de cada termo.
- Tabela de seleção stepwise, gráficos de resíduos, fatoriais, de contorno e de superfície, painéis de previsão e de otimização, quando selecionados.
- Exportação em PDF por meio de Download.
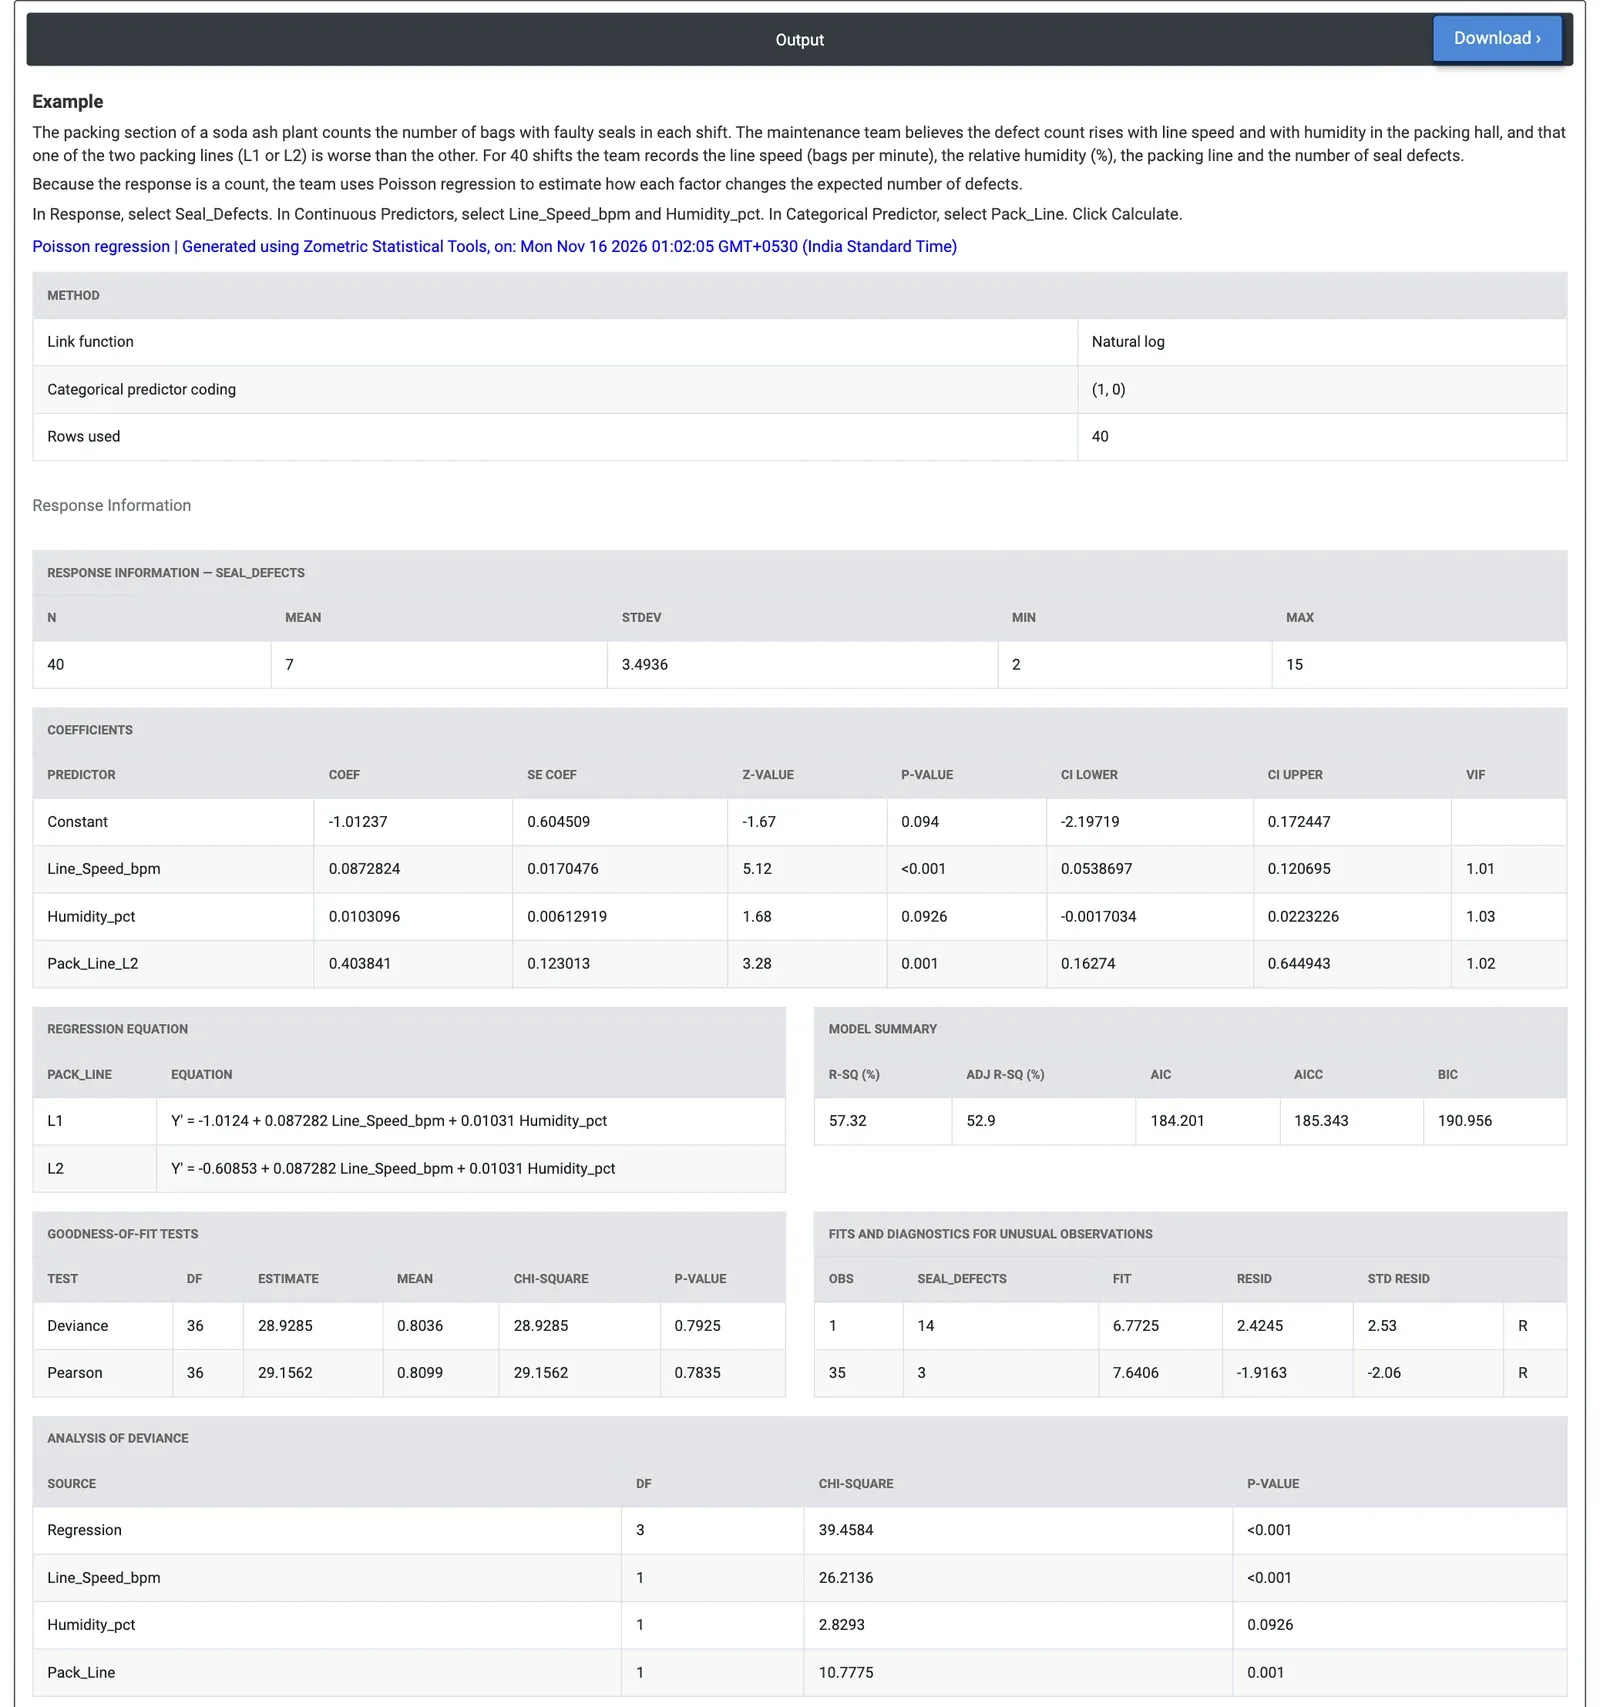
Figura 2 — Regressão de Poisson dos defeitos de vedação por turno: a velocidade da linha (p < 0.001) e a linha de embalagem (p = 0.001) importam; a umidade não, ao nível de 5% (p = 0.0926).
Exemplo prático
A seção de embalagem de uma fábrica de barrilha conta os sacos com vedação defeituosa em cada turno. Ao longo de 40 turnos, a equipe registra a velocidade da linha (sacos por minuto), a umidade no galpão de embalagem (%), a linha de embalagem (L1 ou L2) e o número de defeitos de vedação (de 2 a 15, média 7). Ela seleciona Seal_Defects como resposta, a velocidade da linha e a umidade como preditores contínuos e Pack_Line como preditor categórico, e mantém a ligação log.
A velocidade da linha tem o efeito mais forte (qui-quadrado de Wald 26.21, p < 0.001): seu coeficiente 0.0873 significa que cada saco adicional por minuto multiplica os defeitos esperados por exp(0.0873) = 1.09, e 5 sacos por minuto a mais, por cerca de 1.55. A linha L2 tem coeficiente 0.404 (p = 0.001); portanto, com a mesma velocidade e umidade, produz cerca de 1.50 vez mais defeitos de vedação que a L1. A umidade aponta na mesma direção (cerca de 11% mais defeitos a cada 10% de UR), mas não é significativa ao nível de 5% (p = 0.0926).
O modelo se ajusta às contagens: qui-quadrado da deviance 28.93 com 36 DF (p = 0.7925) e Pearson 29.16 (p = 0.7835), com Mean abaixo de 1, portanto não há sinal de superdispersão. Dois turnos são sinalizados: o turno 1, com 14 defeitos contra um ajuste de 6.8, e o turno 35, com 3 contra 7.6. A equipe examina primeiro as garras de vedação da L2 e o ponto de ajuste da velocidade, e continua coletando dados de umidade antes de decidir sobre a desumidificação.
Perguntas frequentes
Quando usar a regressão de Poisson em vez da regressão de mínimos quadrados comum?
Use a regressão de Poisson quando a resposta for uma contagem de eventos em uma quantidade fixa de tempo, área ou produto, como defeitos por turno ou paradas por mês. As contagens não podem ser negativas e sua dispersão cresce com a média, o que a regressão de mínimos quadrados não contempla. A regressão de Poisson trata isso como um modelo linear generalizado ajustado por máxima verossimilhança.
Como interpretar os coeficientes da regressão de Poisson?
Com a ligação log padrão, o ln da contagem esperada é igual a b0 + b1x1 + ..., de modo que cada coeficiente multiplica a contagem esperada por exp(b) a cada aumento de uma unidade no seu preditor. Por exemplo, um coeficiente de velocidade da linha de 0.0873 significa que cada saco adicional por minuto multiplica os defeitos esperados por exp(0.0873) = 1.09. Os preditores categóricos são comparados com um nível de referência.
Como verificar a superdispersão na regressão de Poisson?
Os testes de aderência comparam a deviance e o qui-quadrado de Pearson com uma distribuição qui-quadrado nos graus de liberdade do erro. Um valor-p pequeno, ou uma Mean (deviance dividida por DF) bem acima de 1, significa que as contagens variam mais do que um modelo de Poisson permite. Nesse caso, os valores-p dos termos do modelo são pequenos demais e não devem ser considerados confiáveis.
Como as observações incomuns são sinalizadas na regressão de Poisson?
As observações com resíduo padronizado além de mais ou menos 2 são sinalizadas com R, e as observações com alavancagem acima de 3p/n são sinalizadas com X. Elas são listadas na tabela Fits and Diagnostics for Unusual Observations, e gráficos de resíduos, como resíduos versus ajustados e um gráfico de probabilidade normal dos resíduos, podem ser adicionados para examiná-las melhor.