
Poder e tamanho amostral para t de 1 amostra
Planeja um teste t de 1 amostra de uma média contra um valor alvo ou nominal. Informe dois entre tamanho amostral, diferença e poder, além de um desvio padrão assumido, e a ferramenta calcula o terceiro. Supõe dados normais, com o desvio padrão estimado a partir da amostra, e calcula o poder pela distribuição t não central. A saída é uma tabela de resultados com o poder real e uma curva de poder.
Última revisão
Conclusão principal
O poder e tamanho amostral para t de 1 amostra calcula quantas medições um teste t de 1 amostra exige para detectar um deslocamento em relação à média alvo, o poder que uma amostra planejada oferece ou o menor deslocamento detectável.
Nesta página
Finalidade
O poder e tamanho amostral para t de 1 amostra planeja, antes da coleta dos dados, um teste de uma média contra um valor alvo ou nominal: quantas medições são necessárias para detectar um deslocamento relevante, que chance (poder) uma amostra planejada tem de detectá-lo ou qual é o menor deslocamento que uma dada amostra consegue detectar. Informe dois entre tamanho amostral, diferença e poder, e a ferramenta calcula o terceiro. Use-o antes de um teste t de 1 amostra, por exemplo, para verificar se uma máquina está centrada no valor nominal ou se um material atende a uma média especificada.
Principais recursos
- Calcula o tamanho amostral, o poder ou a diferença: deixe em branco o que você quer obter.
- Vários valores de uma só vez, por exemplo, diferenças “0.01 0.02” e valores de poder “0.8 0.9”, geram uma linha para cada combinação.
- Alternativas bicaudais (Mean ≠ hypothesized mean) ou unicaudais (Mean < hypothesized mean, Mean > hypothesized mean), no nível de confiança que você escolher.
- Ao calcular o tamanho amostral, informa o número inteiro de medições e o poder real que ele oferece.
- Curva de poder em função do tamanho amostral para cada diferença, com os pontos calculados marcados.
Métodos estatísticos
O cálculo pressupõe que as medições vêm de uma população normal cujo desvio padrão σ é estimado a partir da amostra, como no teste t de 1 amostra. O nível de significância é α = 1 − nível de confiança / 100, e a diferença padronizada é d = diferença / σ, em que a diferença é a média verdadeira menos a média hipotética.
O poder é a probabilidade de o teste t rejeitar a hipótese nula quando a média verdadeira difere da média hipotética pela diferença informada. É calculado a partir da distribuição t não central com n − 1 graus de liberdade e parâmetro de não centralidade δ = d·√n: para um teste bicaudal, poder = P(T > t₁₋α/₂) + P(T < −t₁₋α/₂), em que T segue essa distribuição t não central; para um teste unicaudal, conta apenas a cauda do lado da alternativa. Para o tamanho amostral, encontra-se o n que dá o poder alvo, arredondado para cima ao próximo número inteiro, e o poder nesse n é informado como poder real. Para a diferença, encontra-se a menor diferença que atinge o poder alvo com o n dado.
O poder aumenta com o tamanho amostral e com o tamanho da diferença, e diminui à medida que σ cresce ou o nível de confiança aumenta. Um teste unicaudal exige menos medições para o mesmo poder, mas só detecta um deslocamento na direção indicada: com Mean > hypothesized mean, uma diferença negativa dá um poder próximo de 0, e calcular o tamanho amostral a partir dela retorna uma mensagem de erro. No teste bicaudal, importa apenas o tamanho da diferença. Calcular a diferença com Mean < hypothesized mean retorna uma diferença negativa.
Campos de entrada e opções
Campo | Descrição |
Sample sizes | Separados por espaço ou vírgula, ex.: “10 20 30”. Deixe em branco para calcular o tamanho amostral. |
Differences | Separadas por espaço ou vírgula, ex.: “1 2 3”. A diferença em relação à média hipotética que você quer detectar, nas unidades de medida. Deixe em branco para calcular a diferença. |
Power values | Separados por espaço ou vírgula, ex.: “0.8 0.9”. Deixe em branco para calcular o poder. |
Standard deviation | Obrigatório. Desvio padrão assumido ou histórico da população, ex.: a partir de dados anteriores ou de um piloto. |
Confidence level | Padrão 95 (α = 0.05); de 75 a 100. |
Alternative hypothesis | Mean ≠ hypothesized mean (padrão), Mean < hypothesized mean ou Mean > hypothesized mean. |
Power curve | Marcada por padrão: desenha o poder em função do tamanho amostral. |
Title | Título exibido na saída e na curva de poder. |
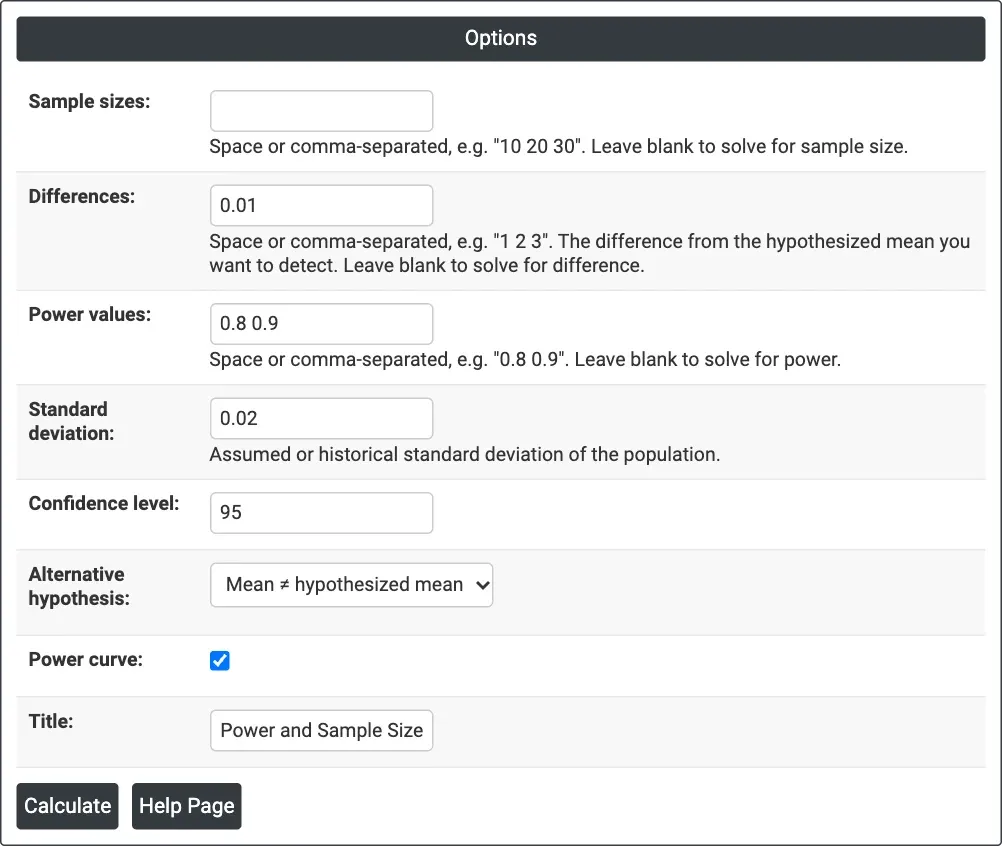
Figura 1 — Cálculo do tamanho amostral: Differences = 0.01, Power values = 0.8 0.9, Standard deviation = 0.02, bicaudal com 95% de confiança.
Descrição da saída
- Settings — o que foi calculado, o desvio padrão, o nível de confiança e a hipótese alternativa.
- Results — uma linha por combinação: diferença, tamanho amostral e poder alvo e real ao calcular o tamanho amostral, ou poder ao calcular o poder, ou diferença ao calcular a diferença.
- Power Curve — poder em função do tamanho amostral para cada diferença, com os pontos calculados marcados.
- Exportação em PDF por Download.
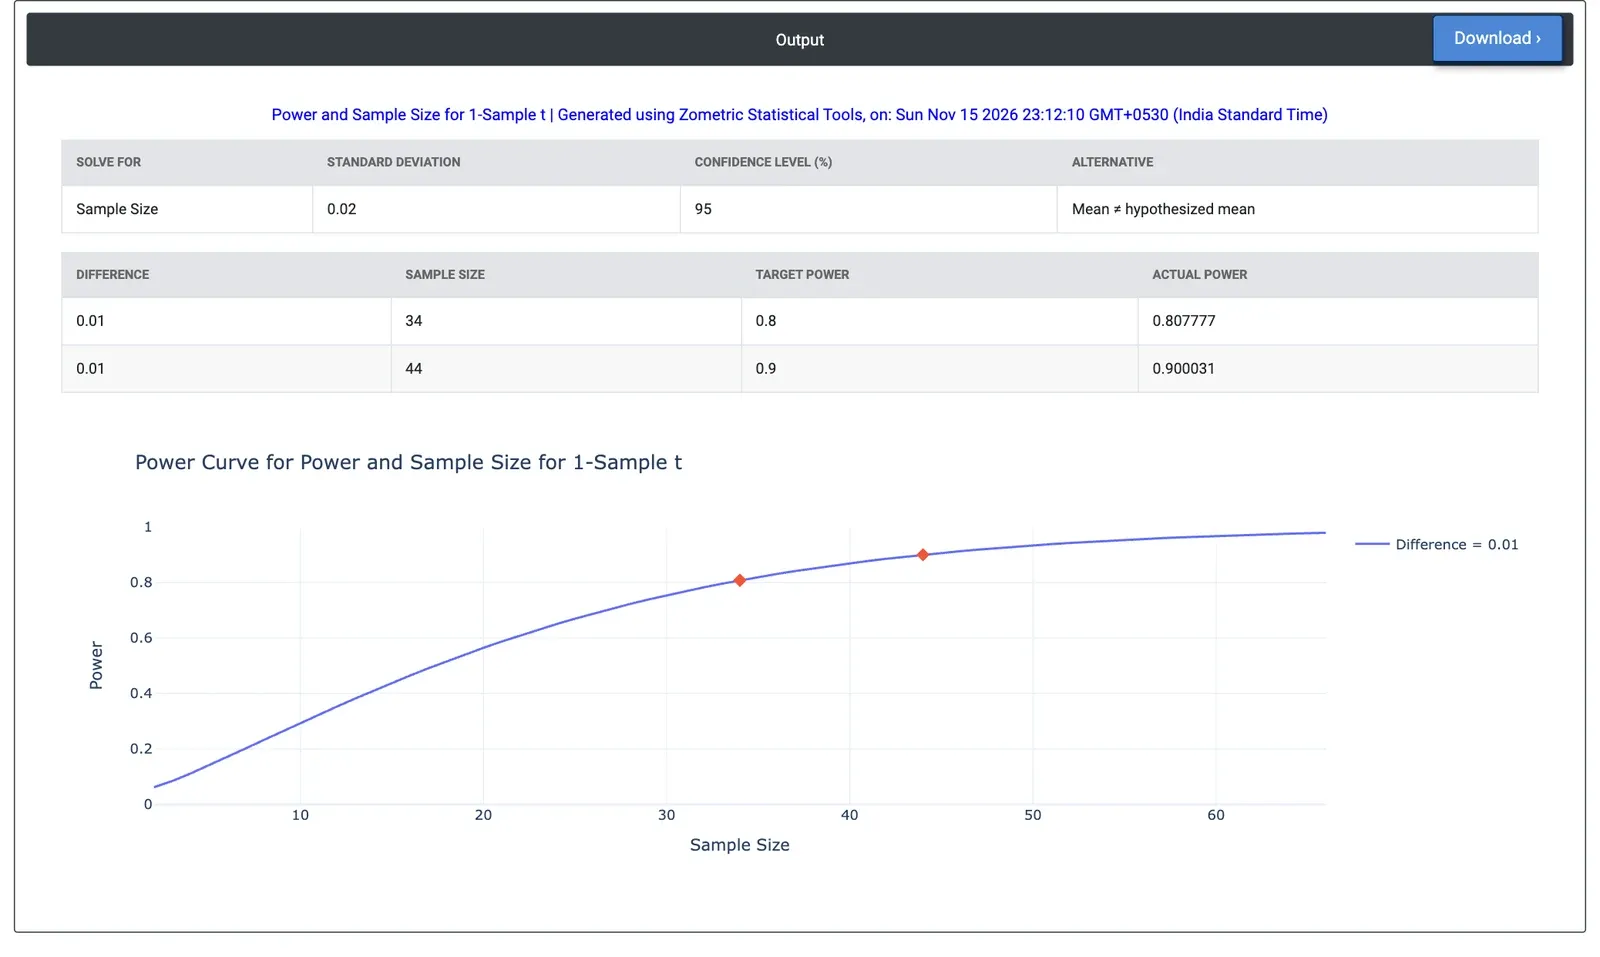
Figura 2 — Resultados do exemplo: 34 eixos para 80% de poder e 44 para 90% de poder para detectar um desvio de 0.01 mm em relação ao nominal.
Exemplo prático
Uma célula de torneamento produz eixos com diâmetro nominal de 25.00 mm. Após uma troca de ferramenta, o supervisor quer verificar se o processo continua centrado, e um desvio de 0.01 mm para mais ou para menos seria relevante. Dados anteriores indicam um desvio padrão do diâmetro de 0.02 mm. O supervisor deixa Sample sizes em branco, insere Differences = 0.01, Power values = 0.8 0.9 e Standard deviation = 0.02, e mantém a alternativa bicaudal com 95% de confiança.
A ferramenta exige 34 eixos para 80% de poder (poder real 0.808) e 44 eixos para 90% de poder (poder real 0.900). A verificação usual com 20 eixos dá um poder de apenas 0.565 para um desvio de 0.01 mm; com 20 eixos e 80% de poder, o menor desvio que o teste consegue detectar de forma confiável é 0.0132 mm. Se só importar um deslocamento para cima (Mean > hypothesized mean), 27 eixos dão 80% de poder.
Perguntas frequentes
Como o poder é calculado em um teste t de 1 amostra?
O poder é a probabilidade de o teste t rejeitar a hipótese nula quando a média verdadeira difere da média hipotética pela diferença informada. É calculado a partir da distribuição t não central com n - 1 graus de liberdade e parâmetro de não centralidade d vezes a raiz quadrada de n, em que d é a diferença dividida pelo desvio padrão. Um teste bicaudal conta as duas caudas.
Que desvio padrão informar em uma análise de poder para t de 1 amostra?
Informe um desvio padrão assumido ou histórico da população, por exemplo, a partir de dados anteriores ou de um piloto. Ele é obrigatório, porque o poder depende da diferença em relação ao desvio padrão. O poder aumenta com o tamanho amostral e o tamanho da diferença, e diminui à medida que o desvio padrão cresce ou o nível de confiança aumenta.
Quantas medições são necessárias para um teste t de 1 amostra?
Em um exemplo prático, detectar um desvio de 0.01 mm em relação ao diâmetro nominal de um eixo, com desvio padrão de 0.02 mm, bicaudal com 95% de confiança, exige 34 eixos para 80% de poder e 44 para 90% de poder. Uma verificação com 20 eixos dá um poder de apenas 0.565. Se só importar um deslocamento para cima, 27 eixos dão 80% de poder.
Devo escolher uma alternativa unicaudal ou bicaudal?
Um teste unicaudal exige menos medições para o mesmo poder, mas só detecta um deslocamento na direção indicada. Com Mean > hypothesized mean, uma diferença negativa dá um poder próximo de 0, e calcular o tamanho amostral a partir dela retorna uma mensagem de erro. No teste bicaudal, importa apenas o tamanho da diferença, não o seu sinal.