
Poder e tamanho amostral para o teste de equivalência de 2 amostras
Planeja um teste de equivalência de 2 amostras que deve mostrar que dois grupos independentes têm praticamente a mesma média, como dois fornecedores. Informe os limites de equivalência, um desvio padrão combinado e quaisquer dois entre tamanho amostral por grupo, diferença e poder; a ferramenta calcula o terceiro. O poder é calculado de forma exata para o TOST com grupos de tamanhos iguais. A saída é uma tabela de resultados e uma curva de poder.
Última revisão
Conclusão principal
O Power and Sample Size for 2-Sample Equivalence Test calcula quantas unidades cada um de dois grupos independentes precisa ter para mostrar, com dois testes t unicaudais (TOST), que suas médias diferem menos que uma janela de equivalência.
Nesta página
Finalidade
O Power and Sample Size for 2-Sample Equivalence Test planeja um estudo que deve mostrar que dois grupos independentes têm praticamente a mesma média, por exemplo, um segundo fornecedor em relação ao atual, uma máquina nova em relação a uma antiga, ou um material mais barato em relação ao padrão. Você define uma janela de equivalência para a diferença (média do teste − média de referência), e a ferramenta informa quantas unidades cada grupo precisa ter para provar que a diferença fica dentro dela, qual poder uma amostra planejada oferece ou qual o tamanho da diferença verdadeira que pode ser tolerada. Informe quaisquer dois entre tamanho amostral, diferença e poder, e a ferramenta calcula o terceiro. Use-o antes de um 2-Sample Equivalence Test.
Principais recursos
- Calcula o tamanho amostral, o poder ou a diferença: deixe em branco o que você deseja obter.
- Vários valores de uma só vez, ex.: diferenças “0 0.5” e valores de poder “0.8 0.9”, geram uma linha para cada combinação.
- Qualquer janela de equivalência, simétrica ou não.
- Poder exato para o procedimento dos dois testes unicaudais (TOST), com desvio padrão combinado e grupos de tamanhos iguais.
- Curva de poder em função do tamanho amostral para cada diferença, com os pontos calculados marcados.
Métodos estatísticos
O teste de equivalência usa dois testes t unicaudais (TOST) sobre a diferença das duas médias. Com n unidades em cada grupo e um desvio padrão comum σ, o erro padrão da diferença é SE = σ·√(2/n), e os testes t combinados têm 2(n − 1) graus de liberdade. A equivalência é declarada quando se mostra que a diferença está acima do limite inferior L e abaixo do limite superior U, com cada teste unicaudal ao nível de significância α (o campo Significance level (alpha), padrão 0.05).
O poder é a probabilidade de que os dois testes unicaudais tenham sucesso quando a diferença verdadeira é δ. Ele é calculado de forma exata: para um dado desvio padrão amostral combinado s, a chance de sucesso é Φ(−t·s/σ − (δ − U)/SE) − Φ(t·s/σ − (δ − L)/SE), com t = t₁₋α,2(n−1), e isso é promediado sobre a distribuição qui-quadrado da variância combinada por integração numérica. Para o tamanho amostral, encontra-se o n por grupo que atinge o poder desejado, arredondado para cima, e o poder nesse n é informado como poder real. Ao calcular a diferença, a ferramenta busca entre o ponto médio dos limites e o limite superior.
A diferença a detectar deve ficar estritamente entre os limites. O poder é máximo quando a diferença verdadeira está no ponto médio da janela e diminui em direção a qualquer um dos limites. Em comparação com um estudo de uma amostra, dois grupos independentes precisam de cerca de o dobro de unidades por grupo, porque ambas as médias carregam erro de amostragem.
Campos de entrada e opções
Campo | Descrição |
Sample sizes | Por grupo. Separados por espaço ou vírgula, ex.: “20 30 40”. Deixe em branco para calcular o tamanho amostral. |
Difference(s) to detect | Separados por espaço ou vírgula, ex.: “0.5 0.7”. A diferença verdadeira (média do teste − média de referência) que você espera; deve ficar estritamente entre os limites. Deixe em branco para calculá-la (busca entre o ponto médio dos limites e o limite superior). |
Power values | Separados por espaço ou vírgula, ex.: “0.8 0.9”. Deixe em branco para calcular o poder. |
Lower equivalence limit / Upper equivalence limit | Obrigatório. A menor e a maior diferença aceitáveis entre as médias; o limite inferior deve ser menor que o superior. |
Standard deviation | Obrigatório. Desvio padrão comum (combinado) assumido ou histórico das duas populações. |
Significance level (alpha) | Padrão 0.05. Aplicado a cada um dos dois testes unicaudais. |
Power curve | Marcada por padrão: desenha o poder em função do tamanho amostral. |
Title | Título exibido na saída e na curva de poder. |
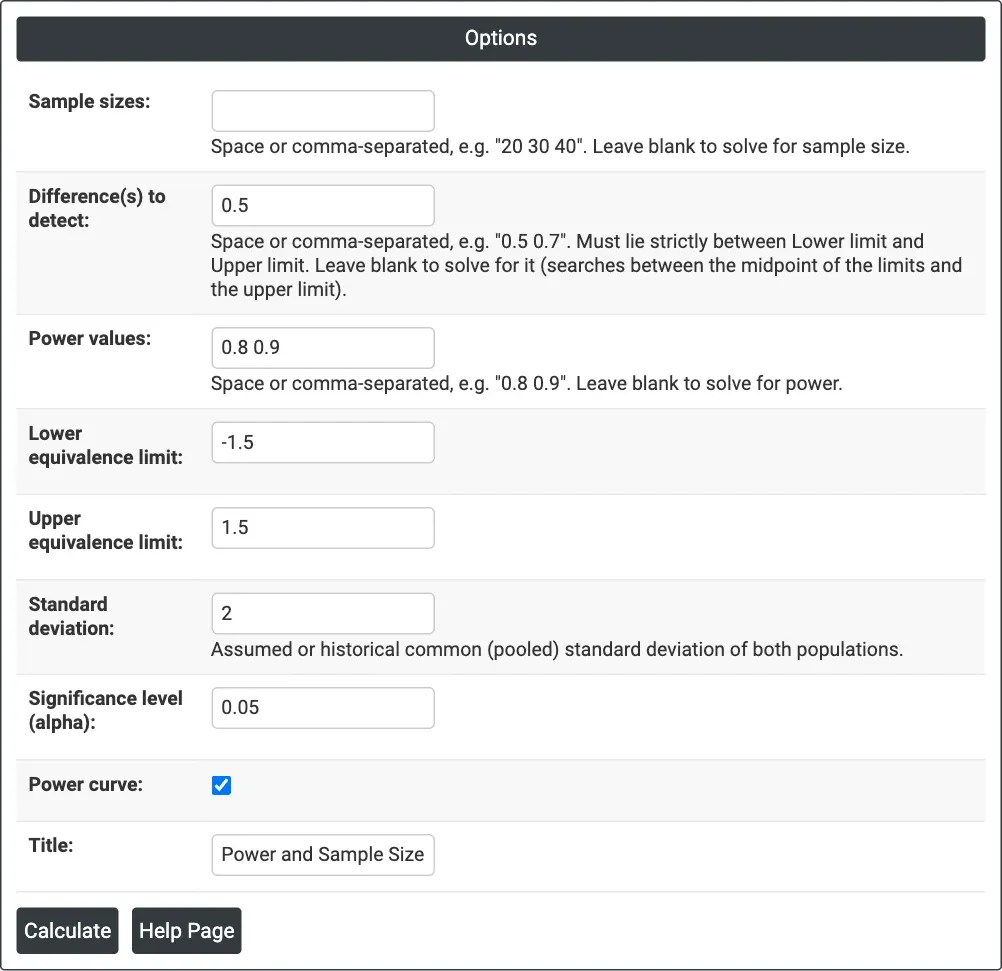
Figura 1 — Cálculo do tamanho amostral: Difference(s) to detect = 0.5, Power values = 0.8 0.9, limites −1.5 e 1.5, Standard deviation = 2, alpha = 0.05.
Descrição da saída
- Settings — o que foi calculado, os limites de equivalência inferior e superior, o desvio padrão e o nível de significância.
- Results — uma linha por combinação: diferença, tamanho amostral por grupo, e poder desejado e poder real ao calcular o tamanho amostral, ou poder ao calcular o poder, ou diferença ao calcular a diferença.
- Power Curve — poder em função do tamanho amostral para cada diferença, com os pontos calculados marcados.
- Exportação em PDF por meio de Download.
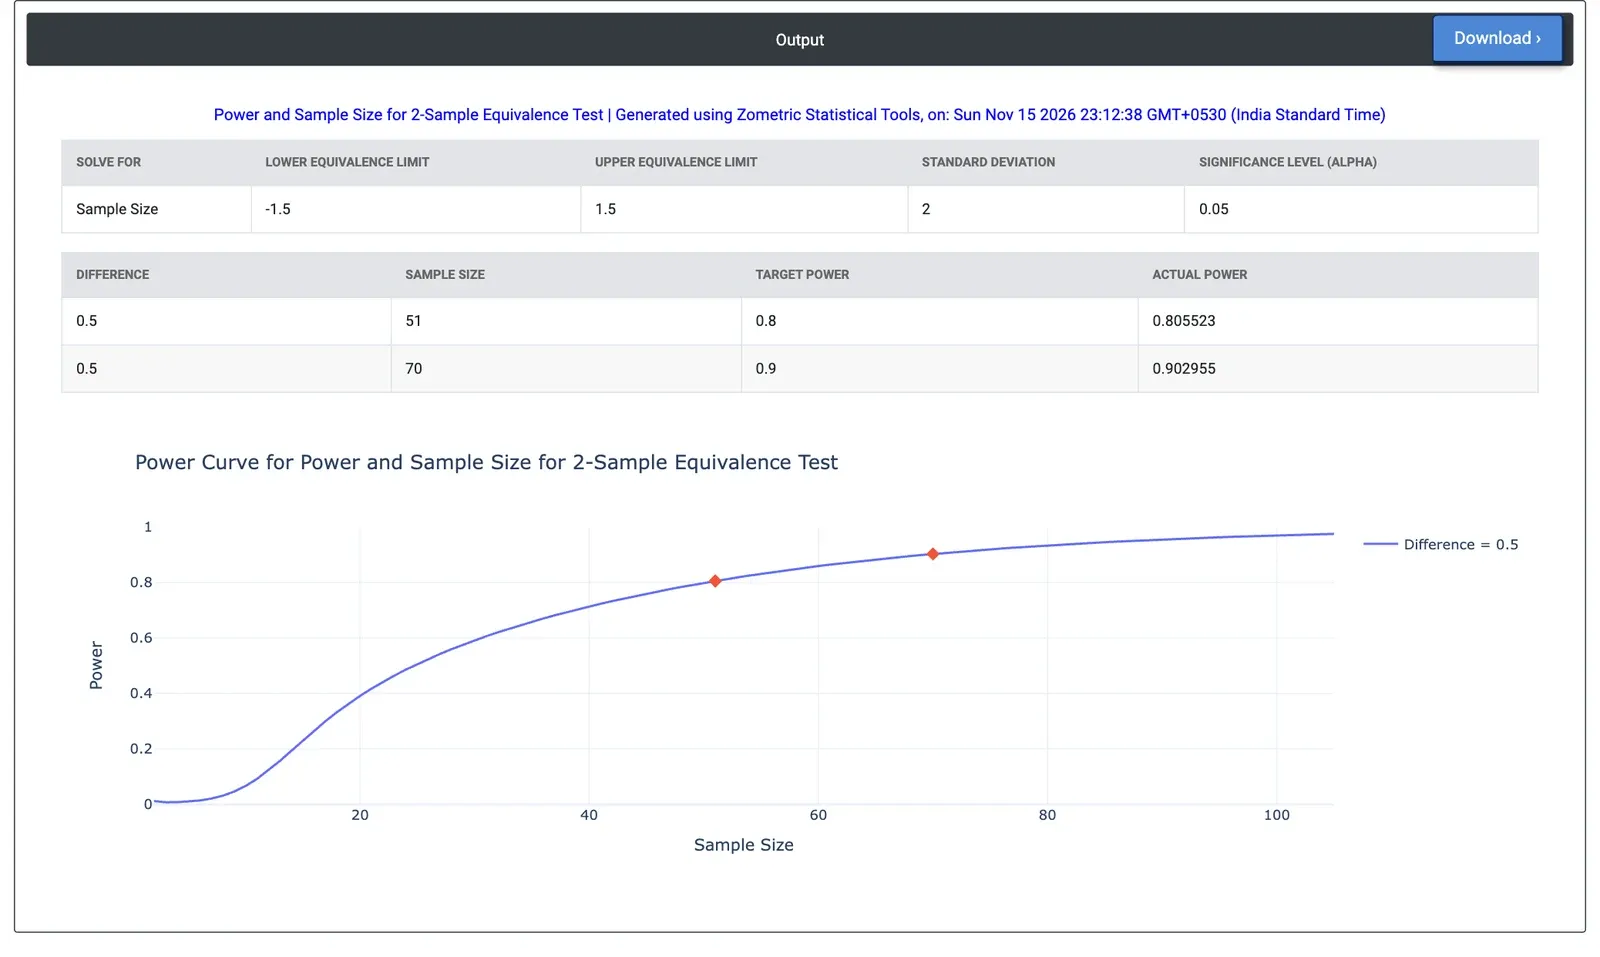
Figura 2 — Resultados do exemplo: 51 barras por fornecedor para 80% de poder e 70 para 90% de poder, com uma janela de ±1.5 MPa e uma diferença verdadeira de 0.5 MPa.
Exemplo prático
Uma equipe de compras quer aprovar um segundo fornecedor de barras de aço. A resistência ao escoamento média do novo fornecedor deve ficar dentro de ±1.5 MPa da do fornecedor atual. Dados anteriores dão um desvio padrão de 2 MPa para ambos, e a equipe espera que a diferença verdadeira seja de até 0.5 MPa. Eles deixam Sample sizes em branco e inserem Difference(s) to detect = 0.5, Power values = 0.8 0.9, Lower equivalence limit = −1.5, Upper equivalence limit = 1.5 e Standard deviation = 2, com alpha = 0.05.
A ferramenta indica 51 barras de cada fornecedor para 80% de poder (poder real 0.806) e 70 de cada um para 90% de poder (poder real 0.903). Com 30 barras por fornecedor, o poder é de apenas 0.591. Se os fornecedores realmente tiverem a mesma média (diferença 0), 32 barras cada dão 80% de poder e 40 dão 90%. Ampliar a janela para ±2 MPa, se o projeto permitir, reduz a exigência para 24 barras por fornecedor para 80% de poder com uma diferença de 0.5 MPa.
Perguntas frequentes
O que uma análise de poder de equivalência de 2 amostras informa?
Informa quantas unidades cada um de dois grupos independentes precisa ter para provar que a diferença entre suas médias (média do teste menos média de referência) fica dentro de uma janela de equivalência, qual poder uma amostra planejada oferece ou qual o tamanho da diferença verdadeira que pode ser tolerada. A equivalência é declarada quando dois testes t unicaudais mostram que a diferença está acima do limite inferior e abaixo do limite superior.
Quantas amostras por grupo são necessárias para um teste de equivalência de 2 amostras?
Em um exemplo prático com uma janela de mais ou menos 1.5 MPa, um desvio padrão de 2 MPa e uma diferença esperada de 0.5 MPa, 51 barras por fornecedor dão 80% de poder e 70 dão 90%. Se as médias forem realmente iguais, 32 barras cada dão 80% de poder, e ampliar a janela para mais ou menos 2 MPa reduz a exigência para 24 barras.
Por que um estudo de equivalência de duas amostras precisa de mais unidades que um de uma amostra?
As médias dos dois grupos carregam erro de amostragem; assim, o erro padrão da diferença é o desvio padrão vezes a raiz quadrada de 2/n. Como resultado, dois grupos independentes precisam de cerca de o dobro de unidades por grupo em relação a um estudo de uma amostra. O poder é máximo quando a diferença verdadeira está no ponto médio da janela e diminui em direção a qualquer um dos limites.
Quais entradas o cálculo de poder de equivalência de 2 amostras exige?
Exige os limites de equivalência inferior e superior, com o inferior menor que o superior, e um desvio padrão comum (combinado) assumido ou histórico. Depois, informe quaisquer dois entre tamanhos amostrais por grupo, diferenças a detectar e valores de poder. A diferença deve ficar estritamente entre os limites. O nível de significância, padrão 0.05, aplica-se a cada teste unicaudal.