
Poder e tamanho amostral para o teste de equivalência pareado
Planeja um teste de equivalência pareado em que cada unidade é medida duas vezes, por exemplo por um instrumento novo e um de referência, e é preciso mostrar que a diferença média é pequena o bastante para ser ignorada. Informe os limites de equivalência, o desvio padrão das diferenças pareadas e quaisquer dois entre número de pares, diferença e poder; a ferramenta resolve o terceiro usando o poder exato do TOST. Gera uma tabela de resultados e uma curva de poder.
Última revisão
Conclusão principal
O cálculo de poder e tamanho amostral para o teste de equivalência pareado informa quantos pares são necessários para mostrar, com dois testes t unicaudais (TOST), que a diferença média pareada está dentro de uma janela de equivalência.
Nesta página
Finalidade
O cálculo de poder e tamanho amostral para o teste de equivalência pareado planeja um estudo em que cada unidade é medida duas vezes, por exemplo por um método novo e um de referência, antes e depois de uma mudança de processo, ou em dois dispositivos de fixação, e o objetivo é mostrar que a diferença média pareada é pequena o bastante para ser ignorada. Você define uma janela de equivalência para a diferença média, e a ferramenta informa quantos pares são necessários, qual poder um número planejado de pares proporciona ou quão grande pode ser uma diferença verdadeira tolerada. Informe quaisquer dois entre tamanho amostral, diferença e poder, e a ferramenta resolve o terceiro. Use-o antes de um teste de equivalência pareado.
Principais recursos
- Resolve o tamanho amostral (número de pares), o poder ou a diferença: deixe em branco o que você quer obter.
- Vários valores de uma vez, ex.: tamanhos amostrais “10 20 30”, geram uma linha para cada combinação.
- Qualquer janela de equivalência, simétrica ou não.
- Poder exato do procedimento de dois testes unicaudais (TOST) sobre as diferenças pareadas.
- Curva de poder do poder contra o número de pares para cada diferença, com os pontos resolvidos marcados.
Métodos estatísticos
Um estudo pareado é analisado por meio das diferenças dentro de cada par (teste − referência); assim, o cálculo é o TOST de uma amostra aplicado a essas diferenças. Com n pares e desvio padrão das diferenças σ_d, o erro padrão é SE = σ_d/√n com n − 1 graus de liberdade. A equivalência é declarada quando se mostra que a diferença média está acima do limite inferior L e abaixo do limite superior U, cada teste t unicaudal ao nível de significância α (o campo Significance level (alpha), padrão 0.05).
O poder é a probabilidade de que os dois testes unicaudais tenham sucesso quando a diferença média verdadeira é δ. Ele é calculado de forma exata: para um dado desvio padrão amostral das diferenças s, a chance de sucesso é Φ(−t·s/σ_d − (δ − U)/SE) − Φ(t·s/σ_d − (δ − L)/SE), com t = t₁₋α,n−1, e isso é calculado em média sobre a distribuição qui-quadrado da variância amostral por integração numérica. Para o tamanho amostral, encontra-se o número de pares que atinge o poder-alvo, arredondado para cima, e o poder nesse número é informado como poder real. Ao resolver a diferença, a ferramenta busca entre o ponto médio dos limites e o limite superior.
O desvio padrão a ser informado é o das diferenças pareadas, e não o das medições individuais. O pareamento compensa quando as duas medições de uma unidade são fortemente relacionadas, porque σ_d é então muito menor que a dispersão entre unidades. A diferença deve estar estritamente entre os limites; o poder é máximo no ponto médio da janela.
Campos de entrada e opções
Campo | Descrição |
Sample sizes | Número de pares. Separados por espaço ou vírgula, ex.: “20 30 40”. Deixe em branco para resolver o tamanho amostral. |
Difference(s) to detect | Separadas por espaço ou vírgula, ex.: “0.5 0.7”. A diferença média pareada verdadeira que você espera; deve estar estritamente entre os limites. Deixe em branco para resolvê-la (a busca é feita entre o ponto médio dos limites e o limite superior). |
Power values | Separados por espaço ou vírgula, ex.: “0.8 0.9”. Deixe em branco para resolver o poder. |
Lower equivalence limit / Upper equivalence limit | Obrigatório. A menor e a maior diferença média aceitáveis; o limite inferior deve ser menor que o superior. |
Standard deviation of the differences | Obrigatório. Desvio padrão assumido ou histórico das diferenças pareadas. |
Significance level (alpha) | Padrão 0.05. Aplicado a cada um dos dois testes unicaudais. |
Power curve | Marcada por padrão: desenha o poder contra o tamanho amostral. |
Title | Título exibido na saída e na curva de poder. |
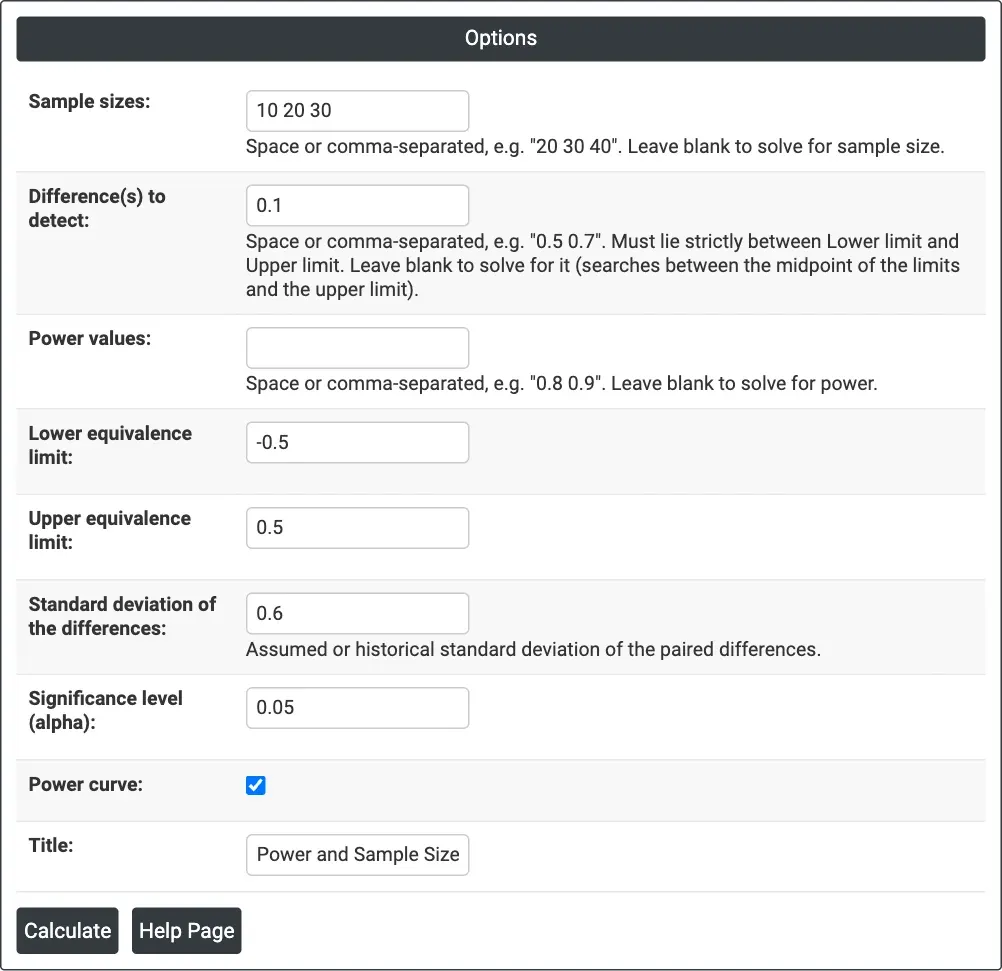
Figura 1 — Resolvendo o poder: Sample sizes = 10 20 30, Difference(s) to detect = 0.1, limites −0.5 e 0.5, Standard deviation of the differences = 0.6, alpha = 0.05.
Descrição da saída
- Settings — o que foi resolvido, os limites de equivalência inferior e superior, o desvio padrão das diferenças e o nível de significância.
- Results — uma linha por combinação: diferença, tamanho amostral (pares) e poder ao resolver o poder, poder-alvo e poder real ao resolver o tamanho amostral, ou diferença ao resolver a diferença.
- Power Curve — poder contra o tamanho amostral para cada diferença, com os pontos calculados marcados.
- Exportação em PDF por meio de Download.
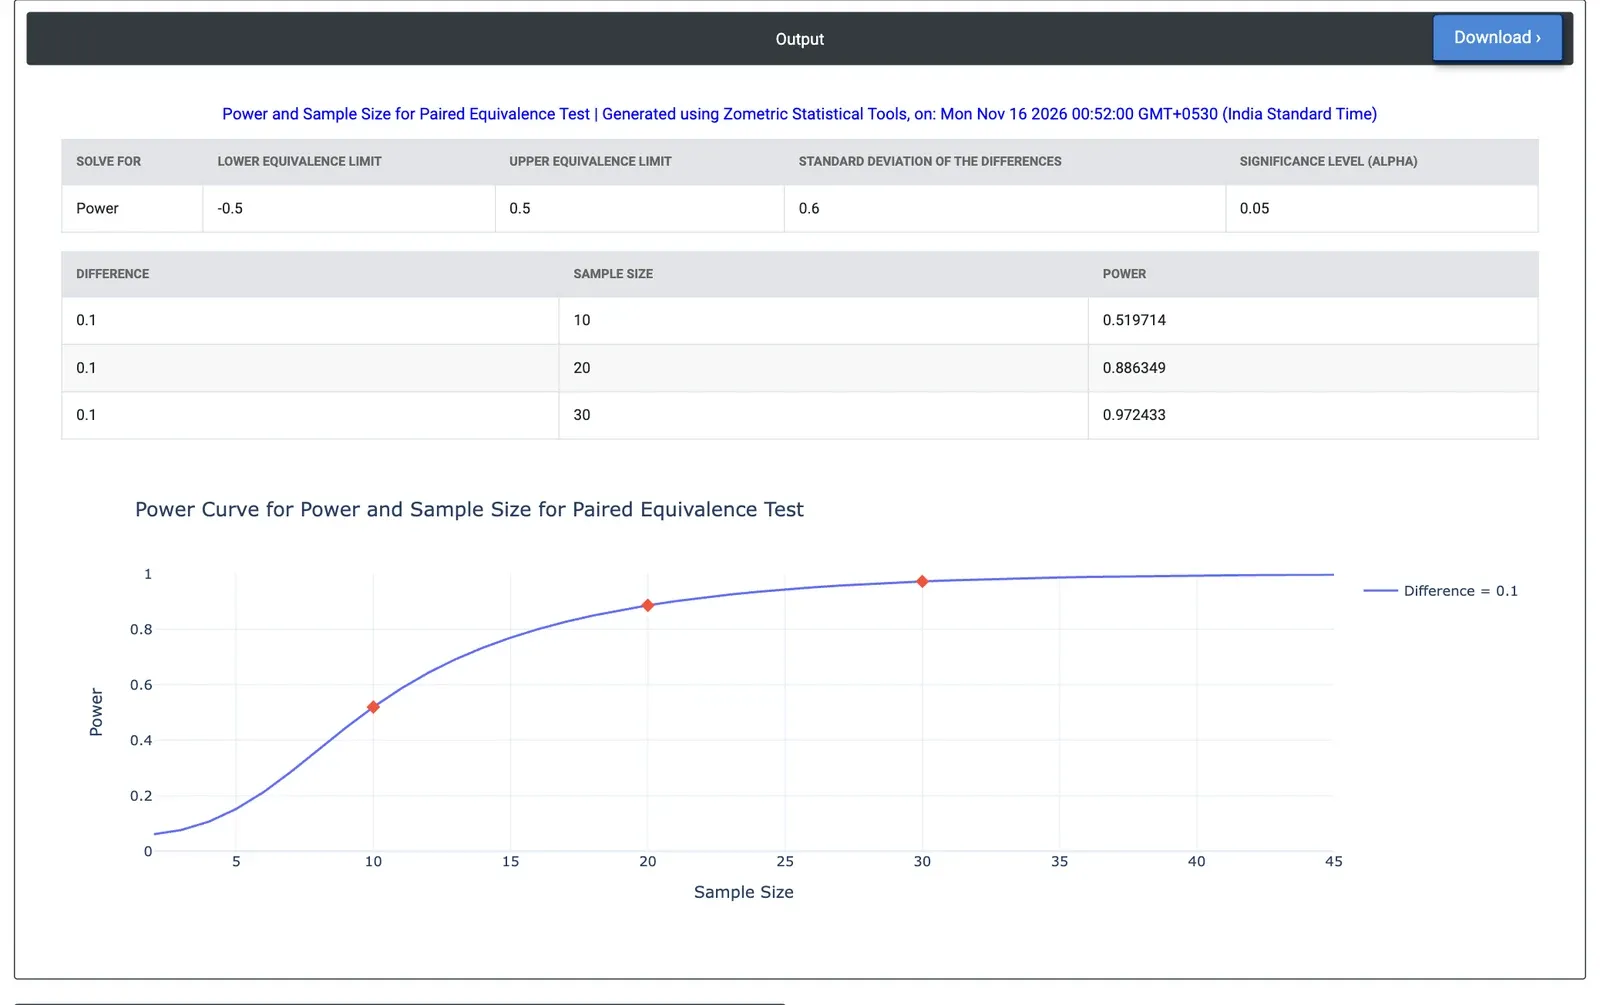
Figura 2 — Resultados do exemplo: poder de 0.520, 0.886 e 0.972 para 10, 20 e 30 painéis quando o vício verdadeiro é 0.1 µm dentro de uma janela de ±0.5 µm.
Exemplo prático
Uma oficina de pintura quer substituir o instrumento de referência de espessura de revestimento por um modelo portátil mais barato. Cada painel de teste será medido com os dois instrumentos, e o portátil é aceitável se o seu vício médio estiver dentro de ±0.5 µm. Uma corrida piloto estimou em 0.6 µm o desvio padrão das diferenças pareadas, e o vício esperado é de cerca de 0.1 µm. O metrologista insere Sample sizes = 10 20 30, Difference(s) to detect = 0.1, Lower equivalence limit = −0.5, Upper equivalence limit = 0.5 e Standard deviation of the differences = 0.6, deixa Power values em branco e mantém alpha = 0.05.
O poder é 0.520 com 10 painéis, 0.886 com 20 e 0.972 com 30. Dez painéis deixariam cerca de uma chance em duas de reprovar um instrumento que na verdade é aceitável. Resolver o tamanho amostral (Power values = 0.8 0.9) dá 16 painéis para 80% de poder e 21 para 90%. Se o vício for de 0.2 µm, 20 painéis dão um poder de 0.695; sem nenhum vício, dão 0.948.
Perguntas frequentes
Como se calcula a análise de poder de equivalência pareada?
Um estudo pareado é analisado por meio das diferenças dentro de cada par, teste menos referência; assim, o cálculo é um TOST de uma amostra aplicado a essas diferenças. A equivalência é declarada quando se mostra que a diferença média está acima do limite inferior e abaixo do limite superior, cada teste t unicaudal ao alpha escolhido. O poder é calculado de forma exata por integração numérica.
Qual desvio padrão informar em um teste de equivalência pareado?
Informe o desvio padrão das diferenças pareadas, e não o das medições individuais. O pareamento compensa quando as duas medições de uma unidade são fortemente relacionadas, porque o desvio padrão das diferenças é então muito menor que a dispersão entre unidades, o que reduz o número de pares necessário.
Quantos pares são necessários para um teste de equivalência pareado?
Em um exemplo prático com uma janela de mais ou menos 0.5 micrômetro, desvio padrão das diferenças de 0.6 e vício esperado de 0.1, 16 painéis dão 80% de poder e 21 dão 90%. O poder é 0.520 com 10 painéis, 0.886 com 20 e 0.972 com 30. Um vício maior, de 0.2, reduz o poder com 20 painéis para 0.695.
Por que a diferença deve estar estritamente entre os limites de equivalência?
Uma diferença média verdadeira em um limite ou além dele nunca pode ser mostrada como equivalente; por isso, a diferença esperada deve estar estritamente entre os limites inferior e superior. O poder é máximo quando a diferença verdadeira está no ponto médio da janela e diminui à medida que ela se aproxima de qualquer um dos limites.