
Poder e tamanho amostral para o teste t pareado
Planeja um teste t pareado em que cada unidade é medida duas vezes, como antes e depois de uma mudança. Informe o desvio padrão das diferenças pareadas e quaisquer dois entre número de pares, diferença média e poder; a ferramenta calcula o terceiro. Pressupõe diferenças aproximadamente normais e usa a distribuição t não central. Gera uma tabela de resultados com o poder real e uma curva de poder.
Última revisão
Conclusão principal
Poder e tamanho amostral para o teste t pareado calcula quantos pares o teste exige para detectar uma diferença média relevante, o poder que um número planejado de pares oferece ou a menor diferença média detectável.
Nesta página
Finalidade
Poder e tamanho amostral para o teste t pareado planeja um estudo em que cada unidade é medida duas vezes, por exemplo antes e depois de uma mudança, com dois métodos ou em dois dispositivos, e a pergunta é se a diferença média é zero. Responde quantos pares são necessários para detectar uma diferença média relevante, que poder um número planejado de pares oferece ou qual é a menor diferença média que um dado número de pares consegue detectar. Informe quaisquer dois entre tamanho amostral, diferença e poder, e a ferramenta calcula o terceiro. Use-o antes de um teste t pareado.
Principais recursos
- Calcula o número de pares, o poder ou a diferença: deixe em branco o que você quer obter.
- Vários valores de uma vez, ex.: diferenças “0.5 1” e valores de poder “0.8 0.9”, dão uma linha para cada combinação.
- Alternativas bicaudal (Mean difference ≠ 0) ou unicaudal (Mean difference < 0, Mean difference > 0), no nível de confiança que você escolher.
- Ao calcular o tamanho amostral, informa o número inteiro de pares e o poder real que ele oferece.
- Curva de poder em função do número de pares para cada diferença, com os pontos calculados marcados.
Métodos estatísticos
Um teste t pareado é um teste t de uma amostra aplicado às diferenças dentro de cada par, de modo que o cálculo é o do teste t de uma amostra aplicado às diferenças. Pressupõe que as diferenças são aproximadamente normais com desvio padrão σ_d. O nível de significância é α = 1 − nível de confiança / 100, e a diferença padronizada é d = diferença média / σ_d.
O poder é calculado a partir da distribuição t não central com n − 1 graus de liberdade e parâmetro de não centralidade δ = d·√n, em que n é o número de pares: em um teste bicaudal, poder = P(T > t₁₋α/₂) + P(T < −t₁₋α/₂); em um teste unicaudal, conta apenas a cauda do lado da alternativa, de modo que uma diferença média do outro lado dá um poder próximo de 0 (e calcular o tamanho amostral a partir dela retorna uma mensagem de erro). Para o tamanho amostral, encontra-se o n que dá o poder-alvo e arredonda-se para cima, e o poder nesse n é informado como poder real. Para a diferença, encontra-se a menor diferença média que atinge o poder-alvo com o n dado.
O desvio padrão a informar é o das diferenças pareadas, e não o das leituras individuais. Quando as duas leituras de uma unidade variam juntas, σ_d é muito menor que a dispersão entre unidades, e por isso um delineamento pareado costuma exigir bem menos unidades que dois grupos independentes. O poder aumenta com o número de pares e com a diferença, e diminui quando σ_d cresce.
Campos de entrada e opções
Campo | Descrição |
Sample sizes | Número de pares. Separados por espaço ou vírgula, ex.: “10 20 30”. Deixe em branco para calcular o tamanho amostral. |
Differences | Separadas por espaço ou vírgula, ex.: “1 2 3”. A diferença média pareada que você quer detectar. Deixe em branco para calcular a diferença. |
Power values | Separados por espaço ou vírgula, ex.: “0.8 0.9”. Deixe em branco para calcular o poder. |
Standard deviation of the differences | Obrigatório. Desvio padrão assumido ou histórico das diferenças pareadas, ex.: de uma corrida-piloto. |
Confidence level | Padrão 95 (α = 0.05); de 75 a 100. |
Alternative hypothesis | Mean difference ≠ 0 (padrão), Mean difference < 0 ou Mean difference > 0. |
Power curve | Marcada por padrão: desenha o poder em função do tamanho amostral. |
Title | Título exibido na saída e na curva de poder. |
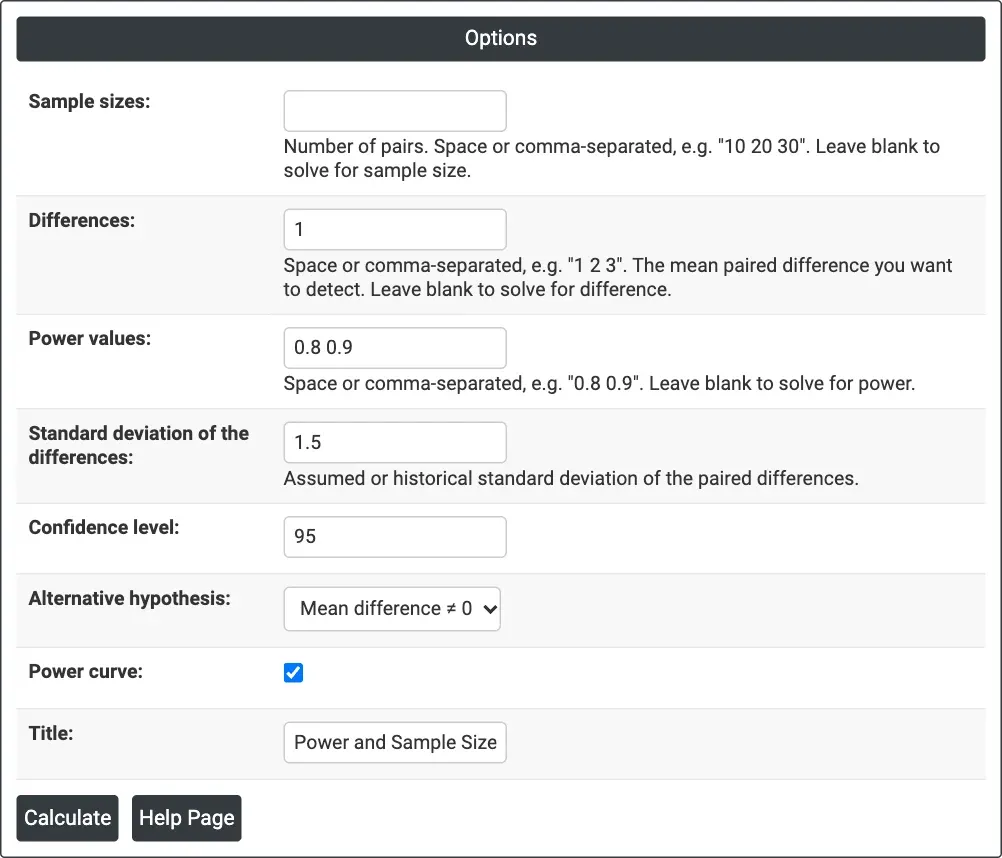
Figura 1 — Cálculo do tamanho amostral: Differences = 1, Power values = 0.8 0.9, Standard deviation of the differences = 1.5, bicaudal com 95% de confiança.
Descrição da saída
- Settings — o que foi calculado, o desvio padrão das diferenças, o nível de confiança e a hipótese alternativa.
- Results — uma linha por combinação: diferença, tamanho amostral (pares) e poder-alvo e real ao calcular o tamanho amostral, ou o poder ao calcular o poder, ou a diferença ao calcular a diferença.
- Power Curve — poder em função do tamanho amostral para cada diferença, com os pontos calculados marcados.
- Exportação em PDF por meio de Download.
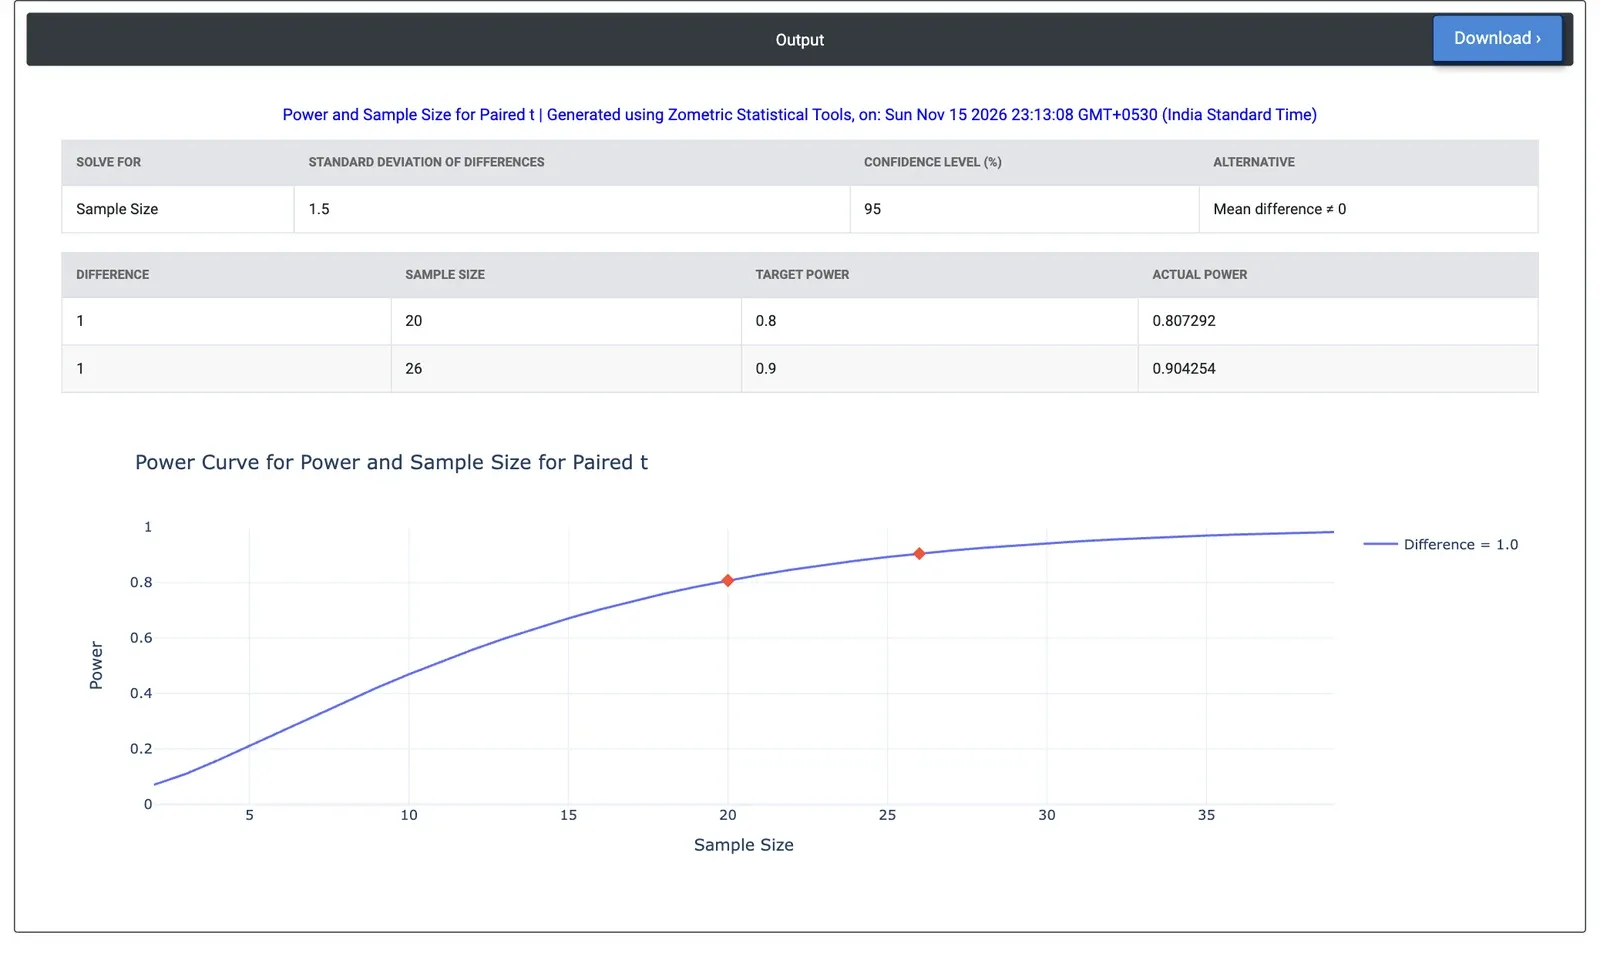
Figura 2 — Resultados do exemplo: 20 motores para 80% de poder e 26 para 90% de poder para detectar uma variação de 1 g/kWh no consumo de combustível.
Exemplo prático
Uma fábrica de motores está testando um novo software de calibração e ensaiará cada motor no banco de provas antes e depois da atualização. Uma variação de 1 g/kWh no consumo específico de combustível seria relevante, e testes anteriores de antes e depois indicaram um desvio padrão das diferenças de 1.5 g/kWh. O engenheiro de ensaios deixa Sample sizes em branco, insere Differences = 1, Power values = 0.8 0.9 e Standard deviation of the differences = 1.5, e mantém a alternativa bicaudal com 95% de confiança.
A ferramenta exige 20 motores para 80% de poder (poder real 0.807) e 26 para 90% de poder (poder real 0.904). Os 12 motores disponíveis em uma semana dariam um poder de 0.558. Se os resultados do banco de provas forem mais ruidosos que o esperado, com σ_d = 2 g/kWh, são necessários 34 motores para 80% de poder. Se a única pergunta for se o consumo melhora, uma alternativa unicaudal exige 16 motores para 80% de poder.
Perguntas frequentes
Como o poder é calculado para um teste t pareado?
Um teste t pareado é um teste t de uma amostra aplicado às diferenças dentro de cada par, de modo que o poder é calculado a partir da distribuição t não central com n - 1 graus de liberdade e parâmetro de não centralidade d vezes a raiz quadrada de n, em que n é o número de pares e d é a diferença média dividida pelo desvio padrão das diferenças.
Por que um delineamento pareado exige menos unidades que dois grupos independentes?
Quando as duas leituras de uma unidade variam juntas, o desvio padrão das diferenças pareadas é muito menor que a dispersão entre unidades. Como o poder depende da diferença média em relação a esse desvio padrão, um delineamento pareado costuma exigir bem menos unidades que dois grupos independentes. Informe o desvio padrão das diferenças, e não o das leituras individuais.
Quantos pares são necessários para um teste t pareado?
Em um exemplo prático para detectar uma variação de 1 g/kWh com desvio padrão das diferenças de 1.5 g/kWh, bicaudal com 95% de confiança, 20 motores dão 80% de poder e 26 dão 90%. Doze motores dão um poder de 0.558. Se as diferenças forem mais ruidosas, de 2 g/kWh, são necessários 34 motores para 80% de poder.
O teste t pareado deve ser unicaudal ou bicaudal?
Use uma alternativa unicaudal quando só importa uma direção, como saber se o consumo melhora; no exemplo prático, ela exige 16 motores em vez de 20 para 80% de poder. Um teste unicaudal conta apenas a cauda do lado da alternativa, de modo que uma diferença média do outro lado dá um poder próximo de 0 e o cálculo do tamanho amostral retorna um erro.