
Dados aleatórios
Dados aleatórios gera de 10 a 10,000 linhas em até 10 colunas independentes a partir de uma de 26 distribuições, incluindo Normal, Lognormal, Weibull, Triangular, Binomial, Poisson e Multivariate Normal. Os valores são gerados sem semente fixa, então cada execução gera números novos. Arredondamento opcional e um resumo gráfico com histograma, teste de normalidade de Anderson-Darling, intervalos de confiança e gráfico de probabilidade descrevem os dados gerados.
Última revisão
Conclusão principal
Dados aleatórios gera números aleatórios de qualquer uma de 26 distribuições contínuas, discretas ou normal multivariada no painel de dados, para dados de treinamento, simulação, estudos hipotéticos e para ver o quanto as amostras variam.
Nesta página
Finalidade
Dados aleatórios gera números aleatórios de uma de 26 distribuições e os coloca no painel de dados, prontos para copiar ou usar em outras ferramentas. Use para criar dados de prática para treinamento, para ver o quanto varia uma amostra de um processo conhecido (um histograma de 30 valores de um processo normal perfeito raramente tem forma de sino), para testar uma análise antes de os dados reais chegarem ou para simular um processo em um estudo hipotético, por exemplo, tempos de ciclo a partir de uma estimativa triangular ou tempos de falha a partir de um modelo de Weibull. Um resumo gráfico opcional descreve os números gerados.
Principais recursos
- 26 distribuições em uma só lista Distribution: contínuas (Normal, Lognormal, Weibull, Exponential, Gamma, Uniform, Triangular e outras), discretas (Binomial, Poisson, Geometric, Hypergeometric, Integer, Discrete e outras) e Multivariate Normal.
- Apenas os campos de parâmetros da distribuição escolhida são exibidos.
- De 10 a 10,000 linhas e de 1 a 10 colunas independentes (data_1, data_2, …).
- Arredondamento opcional para um número definido de casas decimais.
- Resumo gráfico opcional de todos os valores gerados: histograma, estatísticas descritivas, teste de normalidade de Anderson-Darling, intervalos de confiança e gráfico de probabilidade.
- Multivariate Normal: colunas correlacionadas a partir de um vetor de médias e de uma matriz de covariância, com as matrizes de correlação e covariância amostrais como verificação.
Métodos estatísticos
Os valores são gerados de forma independente com os geradores de números aleatórios do NumPy e do SciPy, sem semente fixa, de modo que cada Calculate gera números novos. Cada coluna é uma amostra separada do tamanho escolhido da mesma distribuição. Os parâmetros seguem as definições usuais: por exemplo, Normal (média μ, desvio padrão σ), Weibull (forma β, escala η, limiar opcional somado a cada valor), Exponential (escala = média, limiar opcional), Integer (números inteiros de Minimum a Maximum, ambos incluídos), Geometric (número de tentativas até o primeiro evento, inclusive) e Negative Binomial (número de não eventos antes do número exigido de eventos). Para a Lognormal, você insere a média e o desvio padrão dos próprios dados: a ferramenta os converte nos parâmetros da escala logarítmica σ = √ln(1 + (s/m)²) e μ = ln(m) − σ²/2. Para Discrete, as probabilidades são reescaladas para somar 1.
Com Graphical Summary marcado, todas as colunas são agrupadas em uma única amostra e descritas: média, desvio padrão, variância, assimetria, curtose, N, mínimo, quartis, mediana, máximo e coeficiente de variação (%); o teste de normalidade de Anderson-Darling (A-quadrado e valor-p); intervalos de confiança de 95% para a média (t), a mediana (Hettmansperger-Sheather) e o desvio padrão (qui-quadrado). Com Exclude outliers marcado, os valores fora de Q1 − 1.5×IQR ou Q3 + 1.5×IQR ficam de fora apenas do resumo; os dados gerados os mantêm. Para Multivariate Normal, a matriz de covariância deve ser quadrada, simétrica, semidefinida positiva e compatível com o número de médias.
Campos de entrada e opções
Campo | Descrição |
Distribution | Obrigatório. Uma de 26 distribuições; os campos de parâmetros abaixo mudam de acordo com ela. |
Number of rows of data to generate | Obrigatório, de 10 a 10,000. |
Number of columns | Padrão 1, até 10. Cada coluna é uma amostra independente. Não é usado em Multivariate Normal (uma coluna por média). |
Graphical Summary | Desmarcado por padrão. Adiciona à saída o resumo gráfico dos valores gerados. |
Exclude outliers (1.5×IQR rule) | Opcional. Não tem efeito, a menos que Graphical Summary esteja marcado; nesse caso, remove os outliers apenas do resumo. |
Decimals | Opcional, de 0 a 10. Arredonda os valores gerados para as distribuições contínuas (Normal, Lognormal, Weibull, Exponential, T, F, Beta, Cauchy, Chi-Square, Gamma, Laplace, as distribuições de valor extremo, Logistic, Loglogistic, Triangular e Uniform). Para Normal, são mantidas pelo menos as casas decimais suficientes para mostrar o desvio padrão. Não é exibido para as distribuições que geram números inteiros ou valores listados (Binomial, Poisson, Bernoulli, Discrete, Geometric, Hypergeometric, Integer e Negative Binomial) nem para Multivariate Normal. |
Mean / Standard Deviation | Normal; Lognormal (média e desvio padrão dos dados); Poisson usa apenas Mean. |
Number of trials / Event probability | Binomial. Apenas Event probability: Bernoulli e Geometric; com Number of events (sucessos exigidos): Negative Binomial. |
Shape parameter / Scale parameter / Threshold parameter | Weibull (limiar opcional); Gamma e Loglogistic usam forma e escala. |
Scale parameter / Threshold parameter | Exponential (limiar opcional). |
Location parameter / Scale parameter | Cauchy, Laplace, Largest Extreme Value, Smallest Extreme Value e Logistic. |
Degrees of freedom / Numerator and Denominator degrees of freedom | T e Chi-Square; F. |
First shape parameter / Second shape parameter | Beta. |
Values / Probabilities | Discrete. Separados por vírgula ou espaço, na mesma quantidade, ex.: “1 2 3” e “0.2 0.3 0.5” (renormalizados se não somarem 1). |
Population size (N) / Event count in population / Sample size (n) | Hypergeometric. A contagem de eventos e o tamanho amostral não podem exceder o tamanho da população. |
Minimum / Maximum / Mode (most likely value) | Integer (mínimo e máximo); Triangular (os três, com a moda entre eles). |
Lower endpoint / Upper endpoint | Uniform. |
Means / Covariance matrix | Multivariate Normal. Means, um por variável, ex.: “10 20 30”; linhas da covariância separadas por ponto e vírgula, ex.: “4,2,0; 2,9,1; 0,1,1”. |
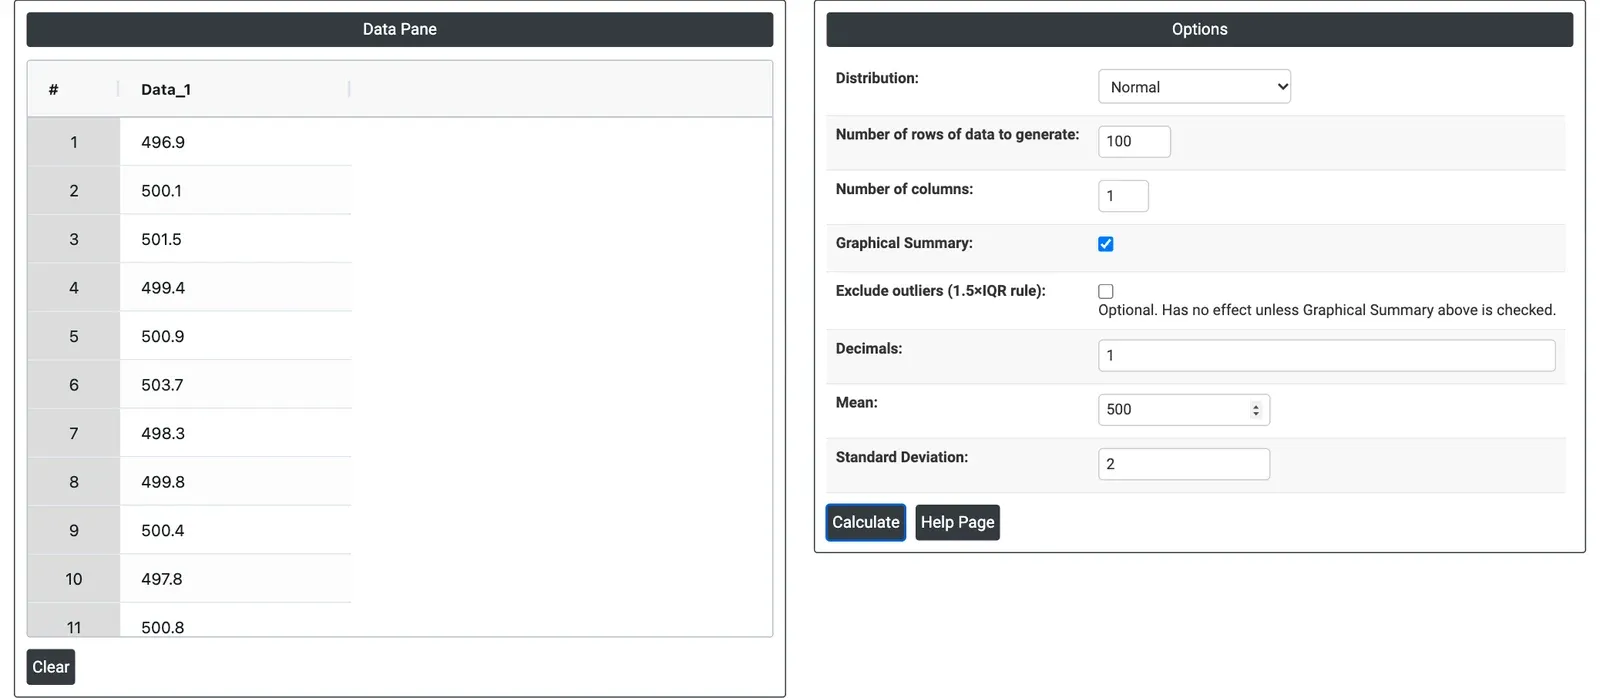
Figura 1 — 100 valores de uma distribuição Normal com média 500 e desvio padrão 2, arredondados para 1 casa decimal, no painel de dados (à esquerda) com as Options (à direita).
Descrição da saída
- Data Pane — os valores gerados, uma coluna por amostra (data_1, data_2, …), substituindo o que havia antes.
- Graphical summary (quando marcado) — histograma com curva normal ajustada e boxplot; tabela-resumo com A-Squared, p-value, Mean, StDev, Variance, Skewness, Kurtosis, N, Minimum, 1st Quartile, Median, 3rd Quartile, Maximum e Coeff Var; gráfico de intervalos de confiança de 95% (95% Confidence Intervals) para a média e a mediana; Probability Plot com o resultado de Anderson-Darling; e uma tabela com os limites inferior e superior de 95% para a média, a mediana e o desvio padrão, com a meia-largura de cada intervalo.
- Multivariate Normal — matrizes de correlação e covariância amostrais das colunas geradas.
- Exportação em PDF via Download as PDF.
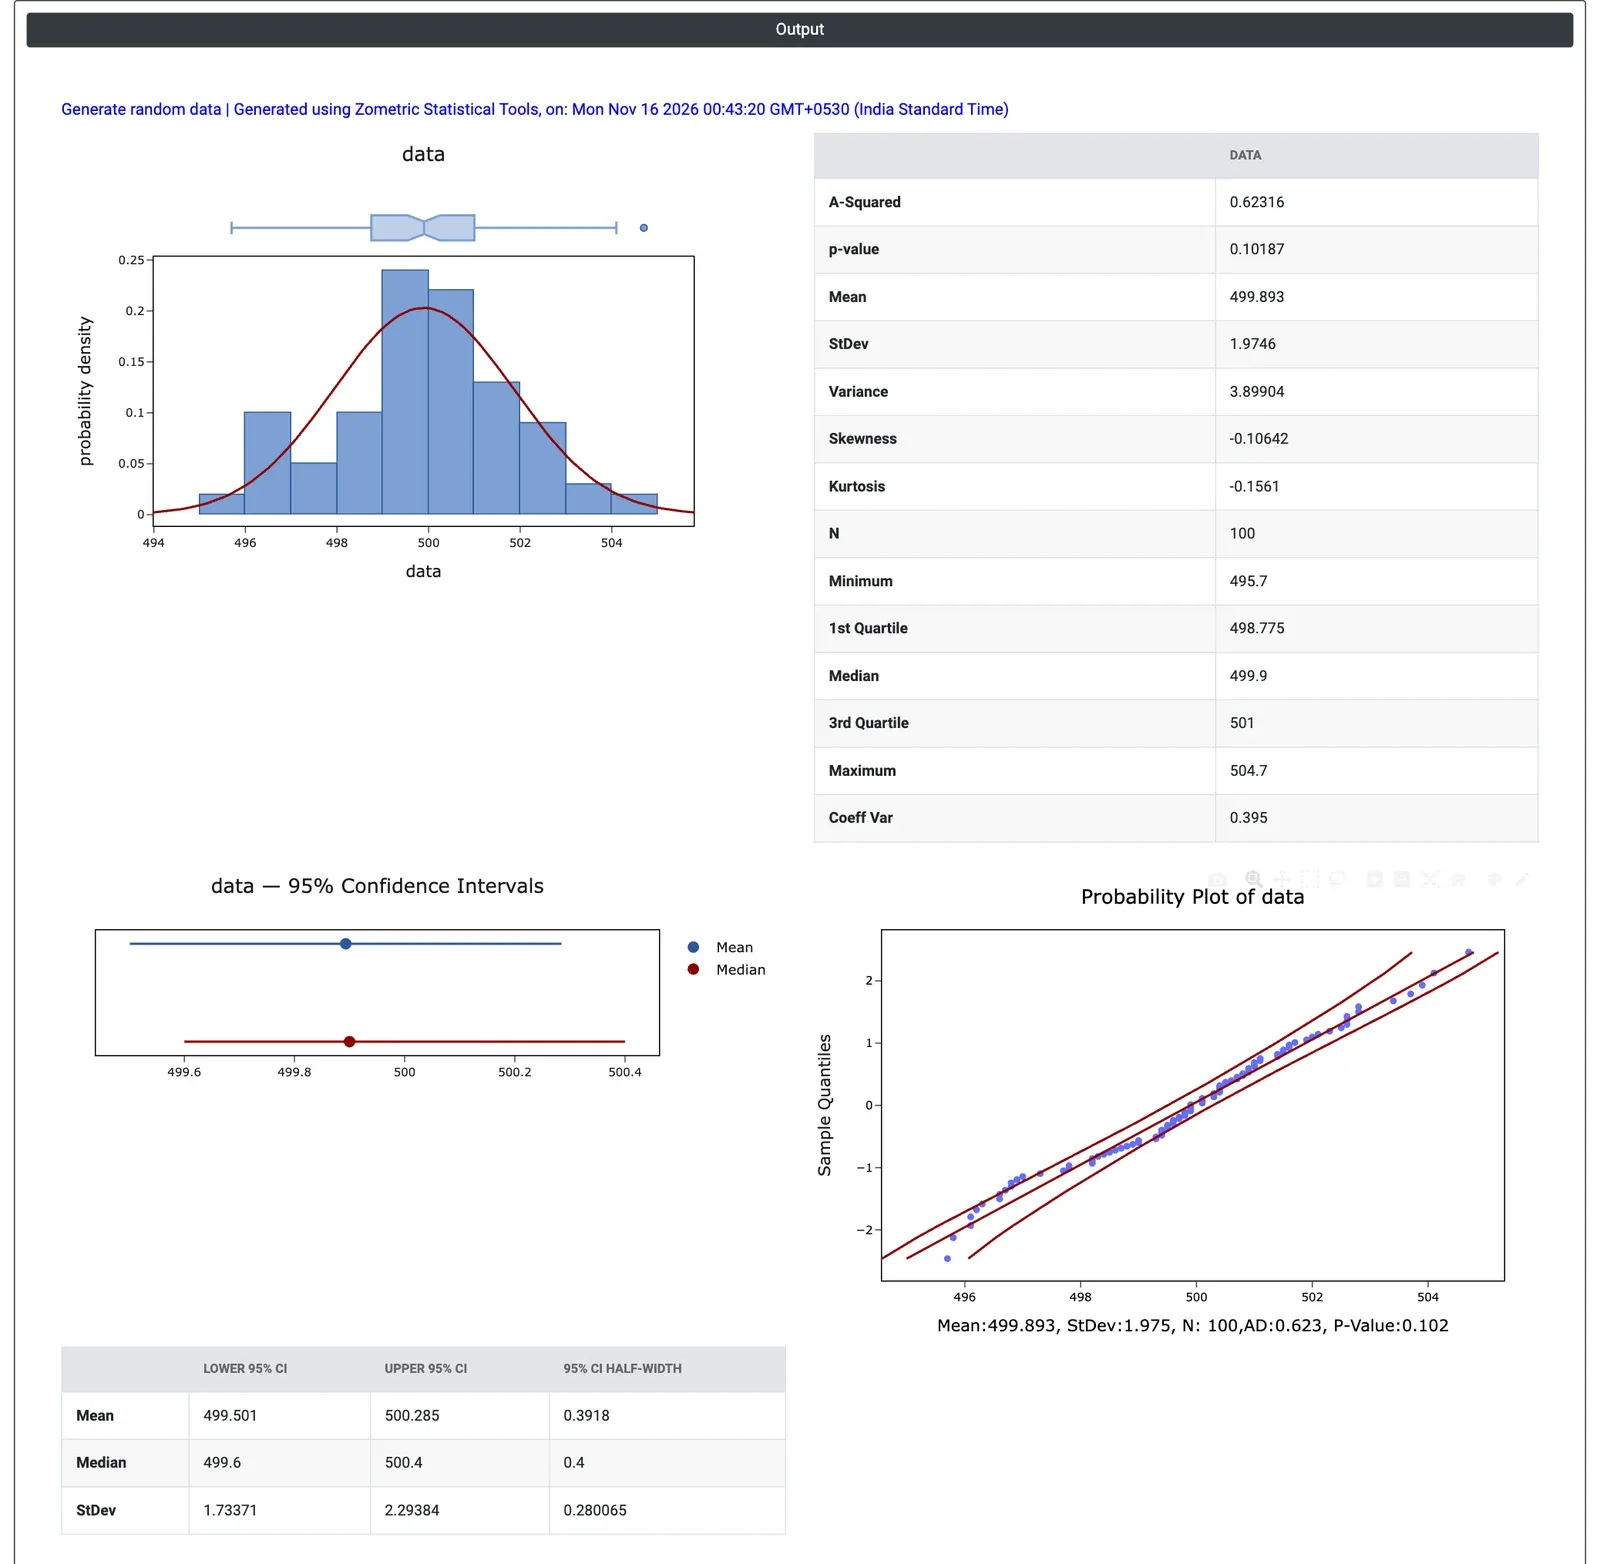
Figura 2 — Resumo gráfico dos 100 valores gerados: média 499.89, StDev 1.97, valor-p de Anderson-Darling 0.102.
Exemplo prático
Um instrutor de qualidade prepara uma sessão sobre variação de processo para operadores de uma linha de envase. A linha enche garrafas de 500 g com desvio padrão de cerca de 2 g. Para mostrar como é a variação normal por si só, o instrutor escolhe Distribution = Normal, Number of rows = 100, Number of columns = 1, Mean = 500, Standard Deviation = 2 e Decimals = 1, e marca Graphical Summary.
Os 100 pesos de enchimento simulados vão de 495.7 a 504.7 g, com média de 499.89 g e desvio padrão de 1.97 g, não exatamente 500 e 2, embora o processo tenha sido definido com exatidão. O histograma é irregular, e não uma curva em sino perfeita, mas o teste de Anderson-Darling dá p = 0.102, portanto não há evidência contra a normalidade. O intervalo de confiança de 95% para a média, de 499.50 a 500.29 g (meia-largura de 0.39 g), contém o verdadeiro 500, e o intervalo para o desvio padrão, de 1.73 a 2.29 g, contém o verdadeiro 2.
A lição para os operadores: um processo estável e centrado ainda produz garrafas individuais a 4 g do alvo e estatísticas amostrais que diferem dos valores verdadeiros. Cada Calculate gera uma nova amostra com números ligeiramente diferentes, que o instrutor pode usar para mostrar a variação de amostra para amostra. Gerar 5 colunas de 20 linhas dá cinco amostras pequenas para comparar, ou os dados podem ser copiados para uma ferramenta de capacidade ou de carta de controle para praticar.
Perguntas frequentes
Para que servem dados aleatórios no trabalho de qualidade?
Servem para criar dados de prática para treinamento, ver o quanto variam amostras de um processo conhecido, testar uma análise antes de os dados reais chegarem e simular um processo em estudos hipotéticos, como tempos de ciclo a partir de uma estimativa triangular ou tempos de falha a partir de um modelo de Weibull. Os dados gerados podem ser copiados para outras ferramentas, como as de capacidade ou de cartas de controle.
De quais distribuições é possível gerar dados aleatórios?
São 26: distribuições contínuas, como Normal, Lognormal, Weibull, Exponential, Gamma, Uniform e Triangular; distribuições discretas, como Binomial, Poisson, Geometric, Hypergeometric, Integer e Discrete; e Multivariate Normal, que produz colunas correlacionadas a partir de um vetor de médias e de uma matriz de covariância. Apenas os campos de parâmetros da distribuição escolhida são exibidos.
Por que uma amostra aleatória não coincide exatamente com a média e o desvio padrão da população?
Cada amostra varia por acaso. Em um exemplo prático, 100 valores de um processo normal com média 500 e desvio padrão 2 tiveram média amostral de 499.89 e desvio padrão de 1.97, e o histograma foi irregular, e não em forma de sino, mas o teste de Anderson-Darling deu p = 0.102, sem evidência contra a normalidade.
Como inserir os parâmetros da lognormal ao gerar dados aleatórios?
Para a distribuição Lognormal, você insere a média e o desvio padrão dos próprios dados, e não dos logaritmos. A ferramenta os converte em parâmetros da escala logarítmica: sigma é igual à raiz quadrada de ln(1 + (s/m) ao quadrado) e mu é igual a ln(m) menos sigma ao quadrado dividido por 2.