
Dados t aleatórios (Random T Data)
Random T Data simula valores da distribuição t para validar testes t e intervalos de confiança, fazer análise de poder e ensinar. Você define o número de linhas e colunas, os graus de liberdade, tipicamente n - 1, e o número de casas decimais. Poucos graus de liberdade dão caudas mais pesadas e valores mais extremos; acima de 30, a distribuição t é quase idêntica à normal. Há um resumo gráfico opcional.
Última revisão
Conclusão principal
Random T Data gera valores da distribuição t, uma distribuição simétrica em forma de sino com caudas mais pesadas que a normal, definida pelos seus graus de liberdade, para simular estatísticas t e estudos com amostras pequenas.
Nesta página
O que é Random T Data?
Random T Data gera valores da distribuição t, uma distribuição simétrica em forma de sino, semelhante à distribuição normal, mas com caudas mais pesadas, controlada por um parâmetro de graus de liberdade. À medida que os graus de liberdade aumentam, a distribuição t converge para a normal padrão. É amplamente usada para simular estatísticas de testes t e modelar a incerteza em estudos com amostras pequenas.
Definição simples:Gera valores aleatórios da distribuição t, uma curva em forma de sino com caudas mais pesadas que a normal, ideal para simulações com amostras pequenas e para validar testes t.
Quando usar Random T Data?
- Use para validar testes t e cálculos de intervalos de confiança com propriedades de distribuição conhecidas.
- Use em simulações de análise de poder para determinar tamanhos amostrais adequados para estudos com teste t.
- Use em demonstrações educacionais de como a distribuição t se aproxima da normalidade à medida que o tamanho amostral cresce.
Diretrizes para o uso correto de Random T Data
- Defina os graus de liberdade com base no tamanho amostral do seu estudo (tipicamente n − 1).
- Para graus de liberdade grandes (> 30), a distribuição t é quase idêntica à distribuição normal.
Alternativas: quando não usar Random T Data
- Para simulações com amostras grandes em que a normalidade é adequada, use Random Normal Data
- Para simulações de comparação de variâncias, use Random F Data
Exemplo de Random T Data
As etapas a seguir mostram como gerar Random T Data:
- Para gerar Random T Data, é preciso preencher as opções necessárias.
- Em seguida, analise os dados no Zometric Statistical Software em https://statsai.zometric.com/.
- Para encontrar Random T Data, escolha Statistical module> Random Data > Random T Data
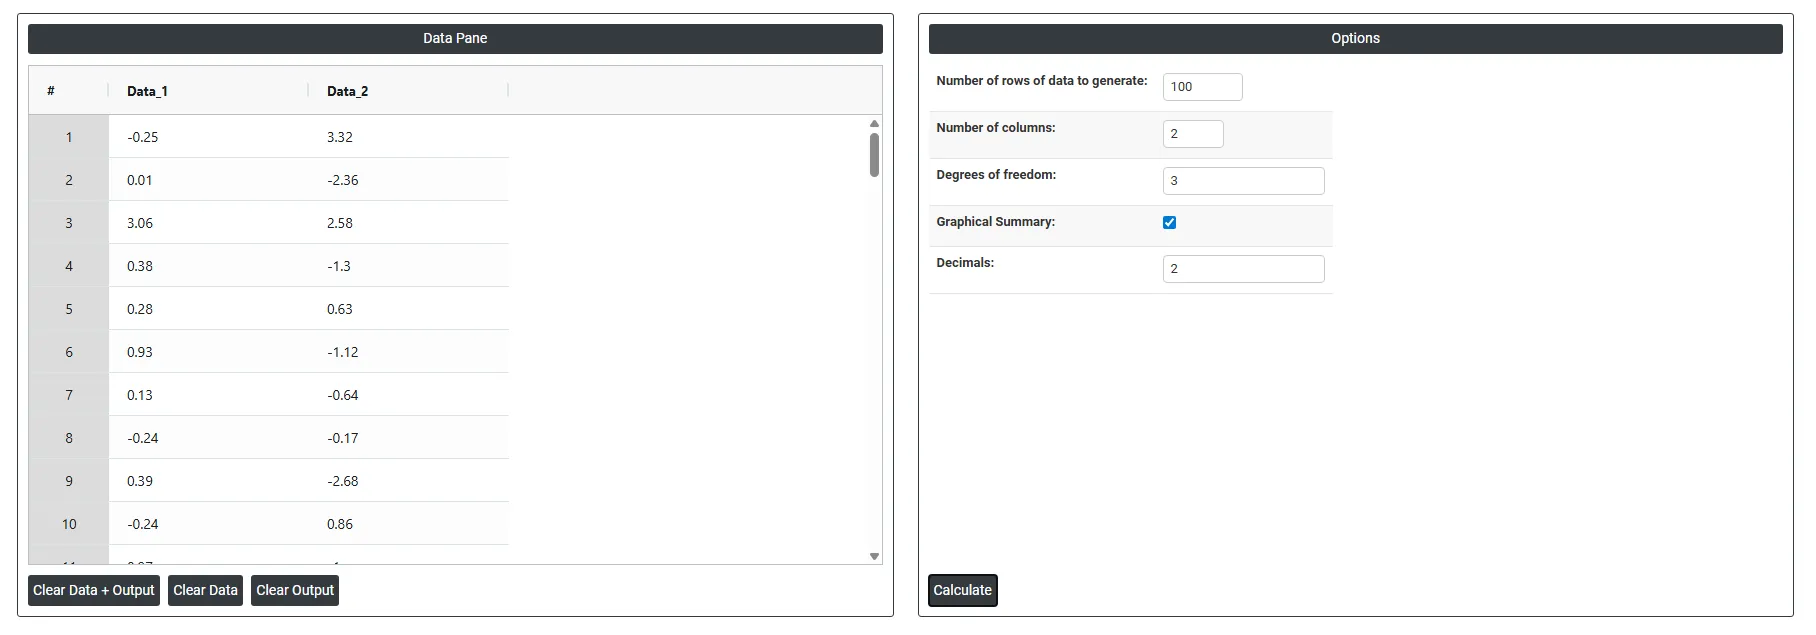
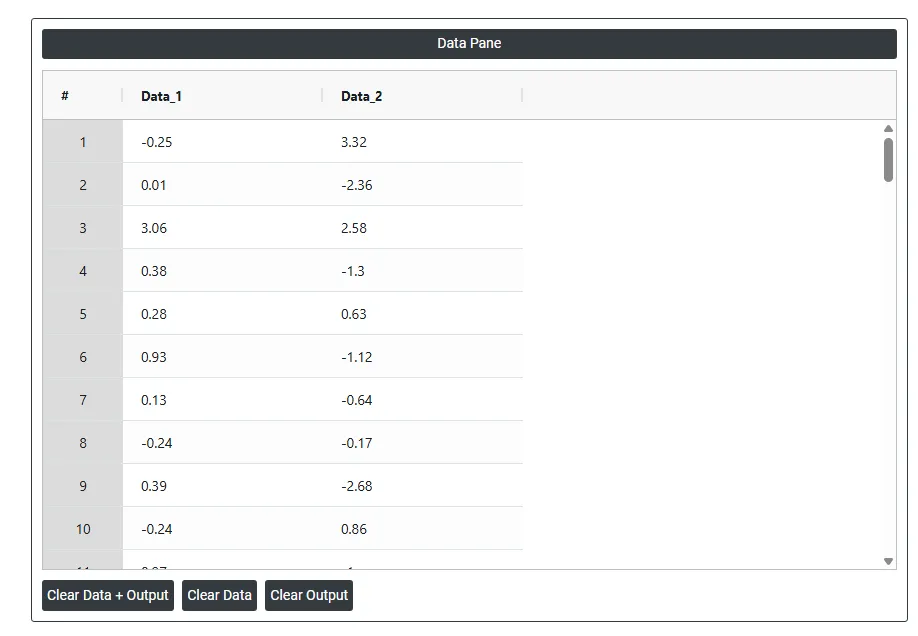
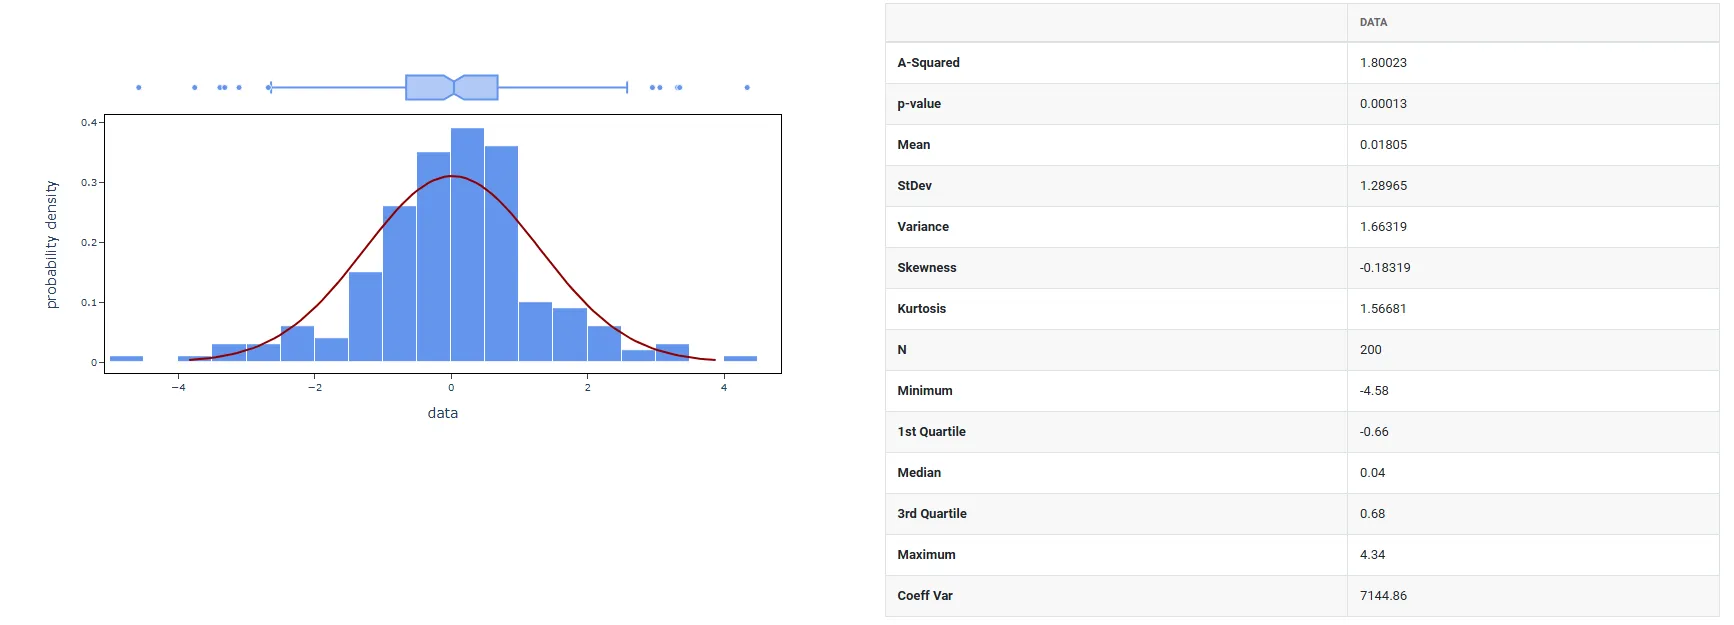
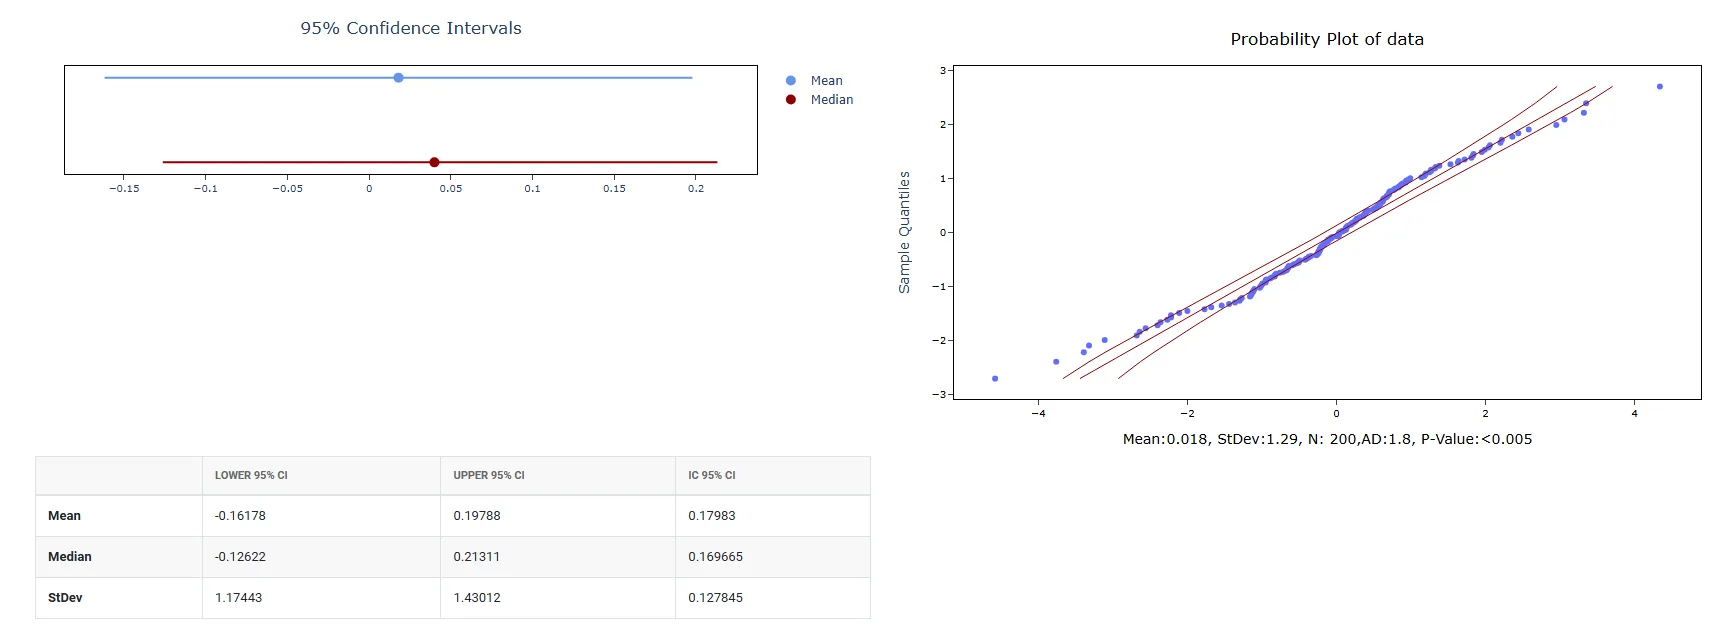
4. Depois de usar a ferramenta mencionada acima, obtém-se a saída a seguir:
Como usar Random T Data
O guia é o seguinte:
- Faça login no Zometric Statistical Software em https://statsai.zometric.com/
- Na página inicial, escolha Statistical Tool> Random Data>Random T Data.
- Em seguida, você precisa preencher as opções necessárias.
- Por fim, clique em calculate na parte inferior da página para obter os resultados desejados.
No painel (dashboard) de Random T Data, a janela é dividida em duas partes.
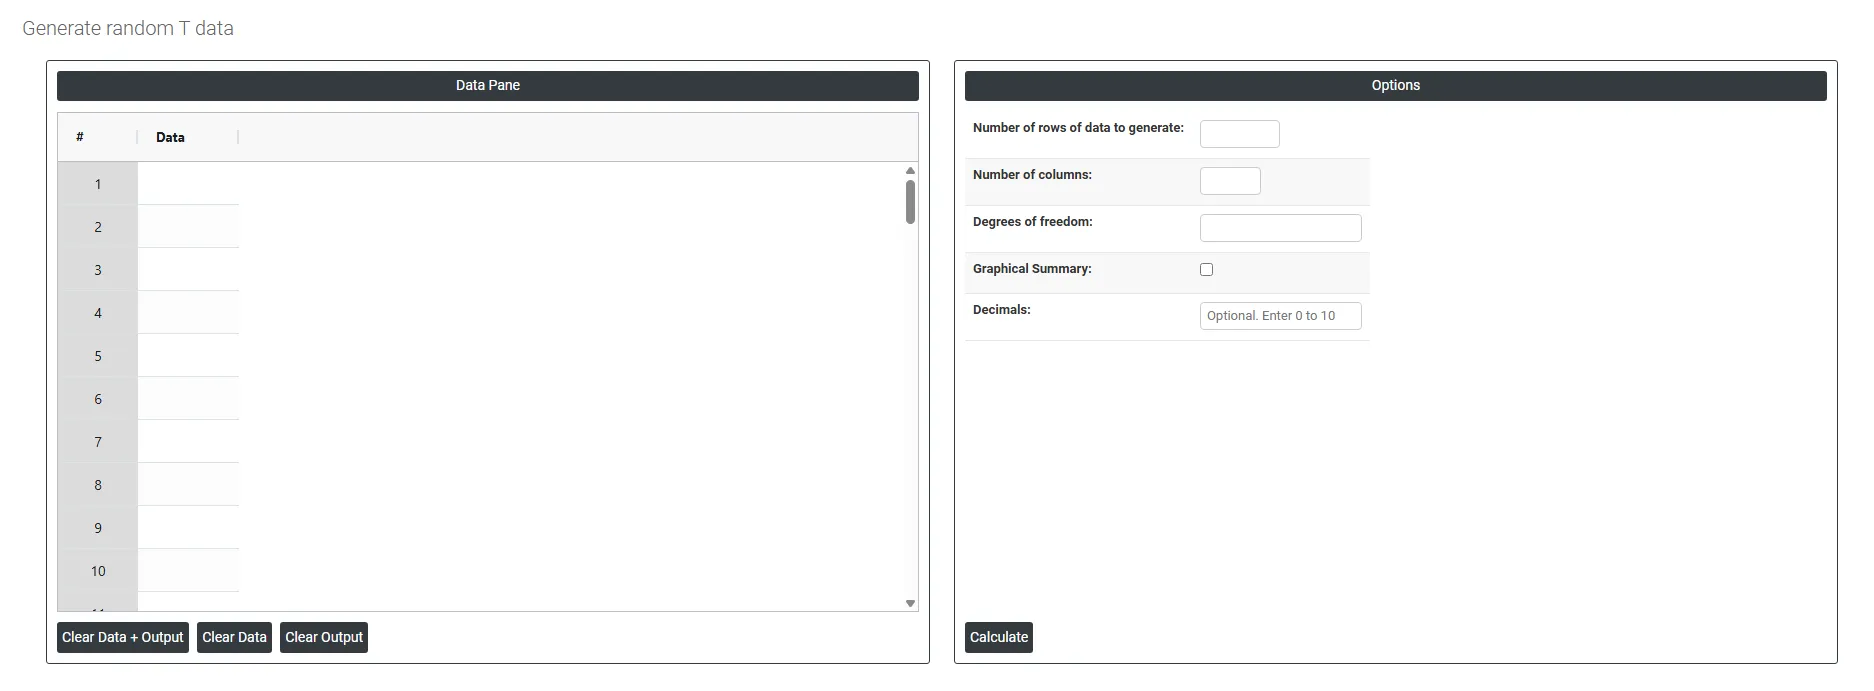
Na parte esquerda fica o painel de dados (Data Pane). No Data Pane, cada linha contém dados aleatórios gerados. Os dados serão gerados depois que as opções necessárias forem preenchidas.
Na parte direita, há várias opções, descritas a seguir:
- Number of rows of data to generate: Especifica quantos pontos de dados aleatórios gerar. Por exemplo, inserir 10 produzirá exatamente 10 linhas de valores aleatórios, todas visíveis no painel de dados.
- Number of columns: Especifica quantas variáveis (colunas) cada linha terá. Por exemplo, inserir 3 produzirá 3 colunas de dados gerados aleatoriamente, lado a lado, no painel de dados.
- Degrees of freedom: Determina o formato da distribuição t usada para gerar os dados aleatórios. Com poucos graus de liberdade (como 1 ou 2), a distribuição tem caudas mais pesadas, o que significa que valores mais extremos aparecerão nos dados gerados. À medida que os graus de liberdade aumentam, a distribuição t se aproxima gradualmente do formato de uma distribuição normal. Por exemplo, inserir 30 gerará dados aleatórios de uma distribuição t com 30 graus de liberdade, produzindo valores que se parecem muito com dados de distribuição normal.
- Graphical summary: Quando selecionada, todos os valores gerados são reunidos e resumidos: um histograma com curva normal ajustada e boxplot, estatísticas descritivas, um teste de normalidade de Anderson-Darling, um gráfico de probabilidade e intervalos de confiança de 95% para a média, a mediana e o desvio padrão. É um resultado visual baseado nos dados que acabaram de ser criados.
- Decimals: Controla o número de casas decimais nos próprios valores aleatórios gerados. Por exemplo, defini-lo como 2 significa que todo número gerado será arredondado para 2 casas decimais, como 47.83 ou 52.16. Defini-lo como 0 produz apenas números inteiros.
Perguntas frequentes
O que é a distribuição t?
A distribuição t é uma distribuição simétrica em forma de sino, semelhante à normal, mas com caudas mais pesadas, controlada por um parâmetro de graus de liberdade. À medida que os graus de liberdade aumentam, ela converge para a distribuição normal padrão. É amplamente usada para simular estatísticas de testes t e modelar a incerteza em estudos com amostras pequenas.
Quais graus de liberdade usar em dados t aleatórios?
Defina os graus de liberdade com base no tamanho amostral do seu estudo, tipicamente n - 1. Valores baixos, como 1 ou 2, dão caudas mais pesadas e valores mais extremos. Para graus de liberdade grandes, acima de 30, a distribuição t é quase idêntica à normal, portanto Random Normal Data pode ser usado no lugar em simulações com amostras grandes.
Quando gerar dados t aleatórios?
Use-o para validar testes t e cálculos de intervalos de confiança com propriedades de distribuição conhecidas, em simulações de análise de poder para encontrar tamanhos amostrais adequados para estudos com teste t e no ensino de como a distribuição t se aproxima da normalidade à medida que o tamanho amostral cresce. Para simulações de comparação de variâncias, use Random F Data.