
Teste de taxa de Poisson de duas amostras
O teste de taxa de Poisson de duas amostras compara as taxas de eventos entre dois grupos usando contagens de eventos independentes em uma exposição conhecida. Ele estima a diferença das taxas com um intervalo de confiança e a testa com uma aproximação normal e, quando a diferença hipotética é 0, com um teste binomial exato. Pressupõe que os eventos ocorrem de forma independente a uma taxa constante. Os dados podem ser resumidos, em duas colunas ou empilhados.
Última revisão
Conclusão principal
O teste de taxa de Poisson de duas amostras compara a frequência de eventos em dois grupos, como defeitos por unidade ou paradas por turno, estimando a diferença das taxas com um intervalo de confiança e um teste exato ou normal.
Nesta página
Finalidade
O teste de taxa de Poisson de duas amostras (2-Sample Poisson Rate Test) compara as taxas de ocorrência de eventos em dois grupos, como paradas por turno nos turnos diurno e noturno, defeitos por unidade de duas linhas ou reclamações por mês antes e depois de uma mudança. Ele estima a diferença entre as duas taxas com um intervalo de confiança e testa se ela difere de zero ou de outra diferença hipotética. Use-o para contagens de eventos independentes em uma quantidade conhecida de exposição; para resultados aprovado/reprovado, use o teste 2 Proportions.
Principais recursos
- Dados como contagens resumidas, como duas colunas de contagens ou como uma coluna de contagens com uma coluna de identificadores de amostra.
- Teste exato (binomial condicional) e aproximação normal lado a lado quando a diferença hipotética é 0.
- Variância da diferença a partir das taxas separadas ou da taxa combinada.
- Hipóteses alternativas bicaudais ou unicaudais, com um intervalo de confiança ou um limite unilateral para a diferença.
- Durações de observação diferentes para as duas amostras, ex.: turnos de 8 horas e de 12 horas.
Métodos estatísticos
Para a amostra i com Nᵢ unidades, cada uma observada por uma duração tᵢ (Observation length), a exposição é Tᵢ = Nᵢ·tᵢ e, com Xᵢ eventos no total, a taxa é λ̂ᵢ = Xᵢ / Tᵢ. A diferença estimada é D = λ̂₁ − λ̂₂, Sample 1 menos Sample 2. Com dados em duas colunas ou empilhados, Nᵢ é o número de contagens não vazias na amostra e Xᵢ é a sua soma.
Aproximação normal: z = (D − D₀) / SE, em que D₀ é a diferença hipotética. Com Estimate the rates separately, SE = √(λ̂₁ / T₁ + λ̂₂ / T₂); com Use the pooled estimate of the rates, SE = √[λ̂ₚ(1 / T₁ + 1 / T₂)] com λ̂ₚ = (X₁ + X₂) / (T₁ + T₂). Quando as duas exposições são iguais, os dois métodos dão o mesmo SE. O valor-p vem da distribuição normal padrão, e o intervalo de confiança para a diferença é D ± z·SE (ou um limite unilateral).
Teste exato, fornecido apenas quando D₀ = 0: se as taxas são iguais, a contagem X₁ em relação ao total X₁ + X₂ segue uma distribuição binomial com probabilidade T₁ / (T₁ + T₂). Os valores-p unicaudais são as caudas binomiais, e o valor-p bicaudal é o dobro da menor cauda. O teste exato é preferível quando as contagens são pequenas. Ambos os métodos pressupõem que os eventos ocorrem de forma independente a uma taxa constante dentro de cada grupo.
Campos de entrada e opções
Campo | Descrição |
Data | Summarized data (padrão), Each sample is in its own column ou Both samples are in one column. |
Sample 1 / Sample 2 | Com Each sample is in its own column: as duas colunas de contagens. |
Samples / Sample IDs | Com Both samples are in one column: a coluna de contagens e a coluna que nomeia a amostra de cada linha (exatamente dois valores distintos; o primeiro encontrado é a Sample 1). |
Sample 1 sample size / Sample 1 total occurrences / Sample 2 sample size / Sample 2 total occurrences | Com Summarized data: o número de unidades e o número total de eventos em cada amostra. |
Hypothesized difference | Padrão 0. O valor de λ₁ − λ₂ sob a hipótese nula; o teste exato é fornecido apenas para 0. |
Confidence level | Padrão 95; de 75 a 100. |
Alternative hypothesis | Difference ≠ hypothesized difference (padrão), Difference < hypothesized difference ou Difference > hypothesized difference. |
Test method | Estimate the rates separately (padrão) ou Use the pooled estimate of the rates, para a aproximação normal. |
Observation length (Sample 1) / Observation length (Sample 2) | Padrão 1. A exposição de cada unidade; a Sample 2 usa a duração da Sample 1 quando deixada em branco. |
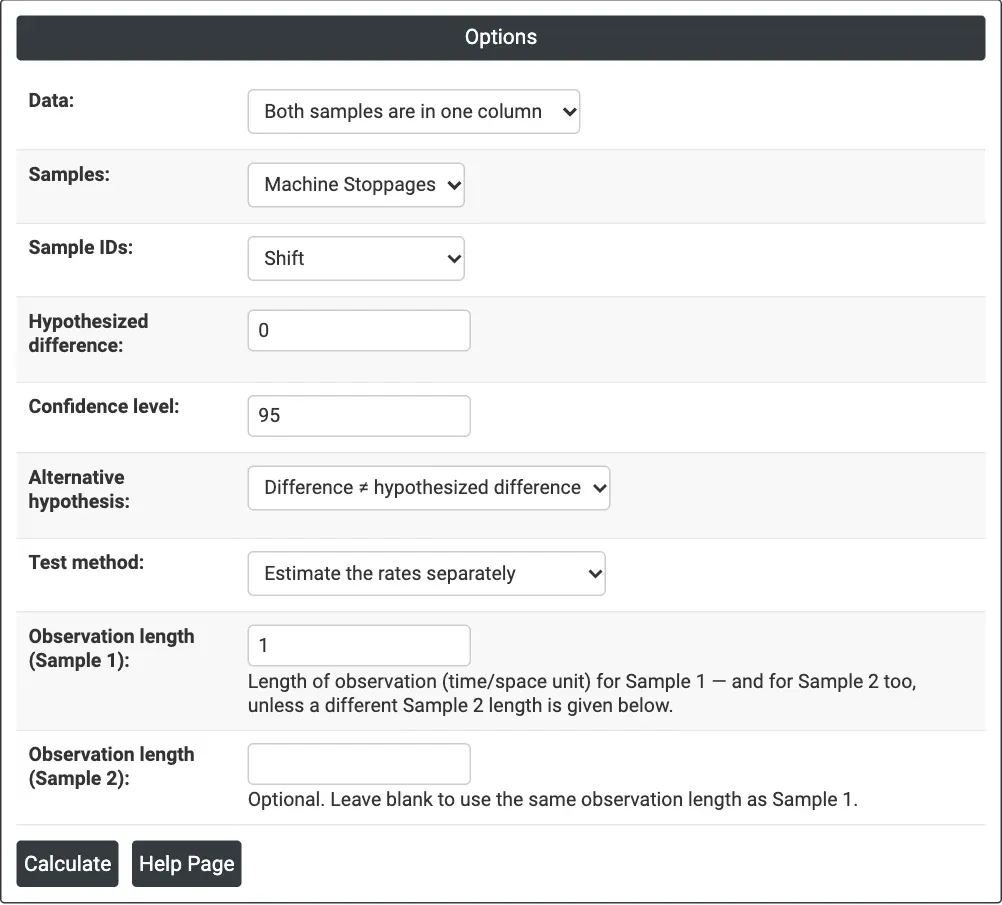
Figura 1 — Opções do exemplo: Machine Stoppages empilhadas em uma coluna com Shift como identificadores de amostra, bicaudal, taxas estimadas separadamente.
Descrição da saída
- Method — qual amostra é λ₁ e qual é λ₂, e a diferença λ₁ − λ₂.
- Descriptive Statistics — Sample, N, Total Occurrences e Sample Rate de cada amostra.
- Estimation for Difference — o Estimated Difference e seu intervalo de confiança (ou limite superior ou inferior).
- Test — as hipóteses nula e alternativa e uma tabela com o Z-Value e o P-Value dos métodos Exact e Normal approximation, com uma nota quando a estimativa combinada é usada.
- Exportação em PDF por meio de Download.
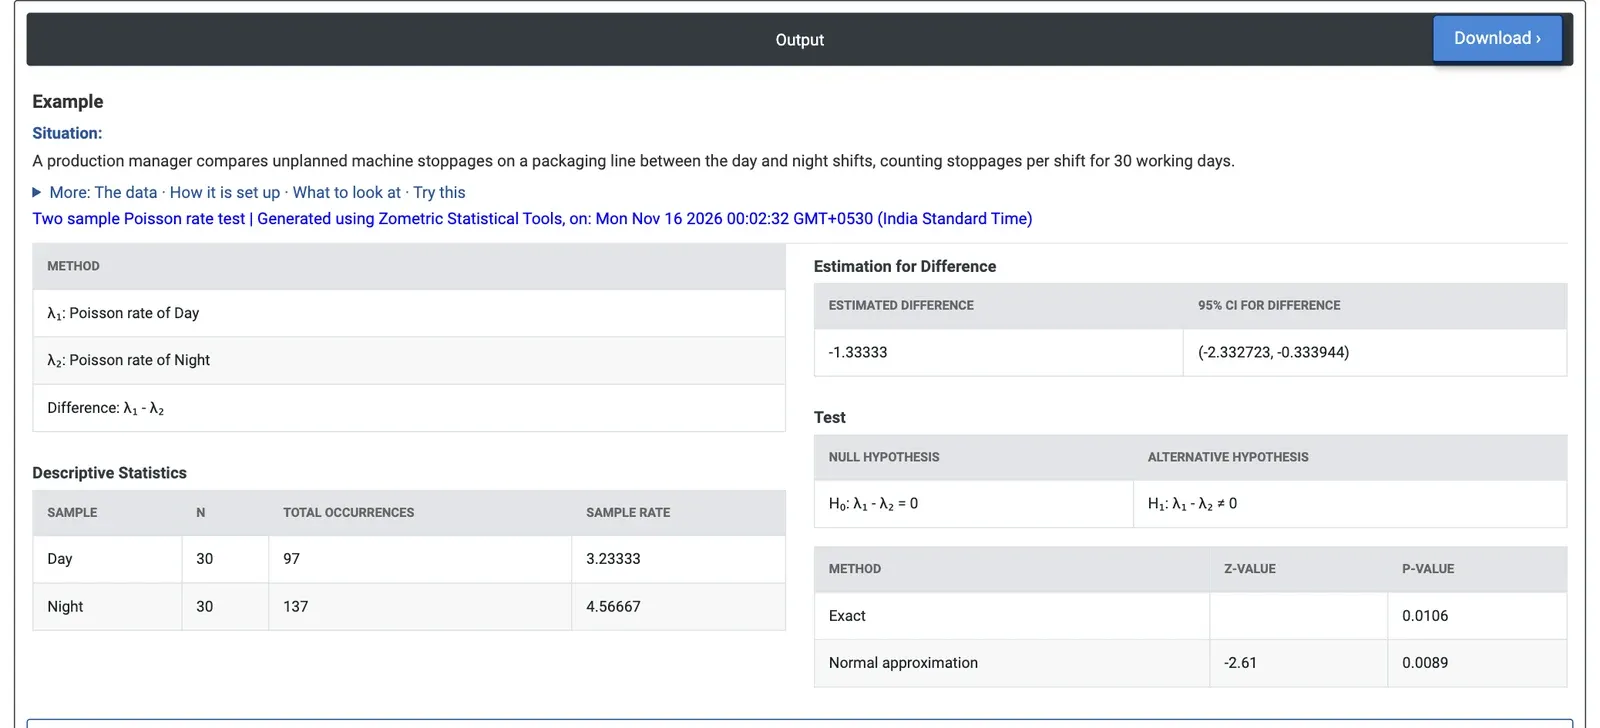
Figura 2 — Os turnos diurnos têm em média 3.233 paradas e os noturnos 4.567; o IC de 95% para a diferença, −2.333 a −0.334, exclui 0 (p exato = 0.0106).
Exemplo prático
Um gerente de produção compara as paradas não planejadas de máquina em uma linha de embalagem entre os turnos diurno e noturno, contando as paradas em cada turno ao longo de 30 dias úteis. Data = Both samples are in one column, Samples = Machine Stoppages, Sample IDs = Shift, Hypothesized difference = 0, Confidence level = 95, bicaudal, Test method = Estimate the rates separately, Observation length = 1 (um turno).
Os turnos diurnos tiveram 97 paradas em 30 turnos, uma taxa de 3.233 por turno, e os turnos noturnos 137 em 30 turnos, 4.567 por turno. A diferença estimada, diurno menos noturno, é −1.333 paradas por turno, com um IC de 95% de −2.333 a −0.334: o intervalo exclui 0. O teste exato resulta em p = 0.0106 e a aproximação normal em z = −2.61, p = 0.0089. O turno noturno tem mais paradas, cerca de 40% a mais que o turno diurno.
Como as duas amostras cobrem 30 turnos, Use the pooled estimate of the rates resulta aqui no mesmo z e no mesmo valor-p. Se o gerente esperasse, antes de coletar os dados, que o turno noturno fosse pior, Difference < hypothesized difference resulta em p = 0.0053 (exato) e em um limite superior de 95% de −0.495 para a diferença. O próximo passo é descobrir o que é diferente à noite, por exemplo, equipe, trocas de produto ou material, antes que as paradas extras custem mais produção.
Perguntas frequentes
Quando usar um teste de taxa de Poisson de duas amostras?
Use-o para comparar as taxas de ocorrência de eventos em dois grupos, para contagens de eventos independentes em uma quantidade conhecida de exposição, como paradas por turno nos turnos diurno e noturno, defeitos por unidade de duas linhas ou reclamações por mês antes e depois de uma mudança. Para resultados aprovado/reprovado, use o teste 2 Proportions.
Qual é a diferença entre o teste exato e a aproximação normal?
O teste exato condiciona-se à contagem total: se as taxas são iguais, a contagem na Sample 1 segue uma distribuição binomial com probabilidade igual à sua parcela da exposição total. Ele é fornecido apenas quando a diferença hipotética é 0 e é preferível quando as contagens são pequenas. A aproximação normal usa uma estatística z com um erro-padrão separado ou combinado.
Quais são as premissas do teste de taxa de Poisson de duas amostras?
Tanto o método exato quanto o normal pressupõem que os eventos ocorrem de forma independente a uma taxa constante dentro de cada grupo. A taxa de cada amostra é o total de eventos dividido pela exposição, o número de unidades vezes a duração de observação, de modo que as duas amostras podem ter durações de observação diferentes, como turnos de 8 horas e de 12 horas.
Como interpretar os resultados do teste de taxa de Poisson de duas amostras?
A saída fornece a taxa de cada amostra, a diferença estimada, Sample 1 menos Sample 2, com seu intervalo de confiança, e os valores-p dos métodos exato e normal. Se o intervalo de confiança da diferença exclui 0 e o valor-p é pequeno, as duas taxas de eventos diferem.