
Capacités supplémentaires pour l'essai biologique logistique à 4 paramètres
Ce complément de la méthode logistique à quatre paramètres ajoute le réglage ANOVA / CI error term. Sequential (par défaut) donne à chaque test F son propre résidu de modèle emboîté ; Pure Error utilise le résidu du modèle saturé pour les trois tests F de validité (Regression, Non-parallelism, Lack of Fit) et l'intervalle de confiance de l'activité, comme les logiciels EP 5.3. Pure Error exige une certaine réplication. Les paramètres de la courbe et l'estimation de l'activité ne changent pas.
Dernière révision
Point clé
L'option de terme d'erreur de l'essai biologique logistique à 4 paramètres choisit si les tests F de validité et l'IC de l'activité utilisent les résidus emboîtés séquentiels ou un seul terme d'erreur pure, comme dans EP 5.3.
Sur cette page
- Essai biologique — Méthode logistique à quatre paramètres
- Ce qui a été ajouté
- Contexte réglementaire et statistique
- Les mathématiques
- Raisonnement : pourquoi deux conventions, et quand utiliser chacune
- Ce qui change dans les résultats, et ce qui ne change pas
- Où trouver cette capacité
- Vérification par rapport à des données de référence publiées
- Références
Essai biologique — Méthode logistique à quatre paramètres
Capacité ajoutée : terme d'erreur optionnel de l'ANOVA / de l'intervalle de confiance (« Sequential » ou « Pure Error »)
Ce qui a été ajouté
La méthode logistique à quatre paramètres reçoit le même type de convention optionnelle de terme d'erreur que celle déjà ajoutée aux méthodes des droites parallèles (Parallel Line) et du rapport de pentes (Slope Ratio), adaptée à la structure de modèle propre à cette méthode. Elle détermine quelle estimation de la variance alimente ensemble les trois tests F de validité et l'intervalle de confiance de l'activité (et pas seulement l'intervalle de confiance, comme dans les deux méthodes linéaires), ce qui reflète la structure de l'ANOVA de cette méthode. Les paramètres de la courbe ajustée et l'estimation ponctuelle de l'activité ne sont pas affectés, quel que soit le choix.
Contexte réglementaire et statistique
Un essai logistique à quatre paramètres (4PL) ajuste une courbe sigmoïde, définie par une asymptote supérieure, une asymptote inférieure, un facteur de pente et un point d'inflexion, à la réponse de chaque préparation en fonction du logarithme de la dose. Trois modèles emboîtés sont comparés pour construire les tests de validité : un modèle nul (droite plate), un modèle où toutes les préparations partagent une même forme de courbe (seul le point d'inflexion peut différer, ce qui produit l'estimation de l'activité) et une courbe entièrement distincte ajustée indépendamment à chaque préparation.
Comme pour les autres méthodes d'essai biologique, les logiciels commerciaux conformes à la Pharmacopée européenne (Ph. Eur.), chapitre 5.3 « Analyse statistique des résultats d'essais et dosages biologiques », construisent classiquement les trois tests F de validité et l'intervalle de confiance de l'activité à partir d'un seul terme de variance d'erreur commun, leur convention « Pure-error ANOVA ». La valeur par défaut actuelle de cet outil donne au contraire à chaque test F son propre terme d'erreur, plus adapté localement.
Les mathématiques
Convention A — « Sequential » (valeur par défaut actuelle de cet outil). Chacun des trois tests F est construit à partir de la paire précise de modèles emboîtés qu'il compare, avec la variance résiduelle de cette comparaison comme dénominateur :
F(Regression) = MS(expliqué par la courbe commune par rapport à la droite plate) / MS(résidu de l'ajustement de la courbe commune)
F(Non-parallelism) = MS(expliqué par les courbes séparées par rapport à la courbe commune) / MS(résidu de l'ajustement des courbes séparées)
F(Lack of Fit) = MS(expliqué par l'ajustement saturé par rapport aux courbes séparées) / MS(résidu de l'ajustement saturé, c'est-à-dire l'erreur pure)
et l'intervalle de confiance de l'activité utilise de même le résidu propre du modèle à courbe commune, ce qui intègre toute petite part non significative de non-parallélisme.
Convention B — « Pure Error » (la nouvelle option ; la « Pure-error ANOVA » d'EP 5.3). Les trois tests F et l'intervalle de confiance de l'activité partagent à la place un seul dénominateur : le résidu de l'ajustement entièrement saturé, une courbe par préparation / groupe de doses :
F(tout test) = MS(expliqué par la comparaison de ce test) / MS(erreur pure, issue de l'ajustement saturé) — même dénominateur à chaque fois
Raisonnement : pourquoi deux conventions, et quand utiliser chacune
Les deux conventions répondent à des questions légèrement différentes, exactement comme pour les deux méthodes linéaires : la convention séquentielle permet de juger la signification de chaque test par rapport à la variabilité propre à cette comparaison, tandis que la convention d'erreur pure pose la même question de fond à chaque test (« comment cet écart se compare-t-il au bruit pur des répétitions, sans rien d'autre de regroupé ? ») et lie en outre l'intervalle de confiance de l'activité à cette même estimation d'erreur, la plus étroite possible.
Pour un essai valide dont l'ajustement est bon, la différence entre les deux est généralement faible. Elle devient plus sensible en présence d'un faible non-parallélisme ou défaut d'ajustement non significatif, car la convention séquentielle intègre cette variabilité supplémentaire au terme d'erreur du test correspondant (et de l'intervalle de l'activité), alors que la convention d'erreur pure l'exclut délibérément partout.
Comme pour les autres méthodes, choisir « Pure Error » vise surtout à rapprocher les résultats de ceux d'un logiciel commercial conforme à EP 5.3 ou d'une méthode validée historique fondée sur sa convention Pure-error ANOVA. La valeur par défaut séquentielle de l'outil reste un choix tout à fait valide lorsqu'aucune comparaison externe de ce type n'est requise.
Ce qui change dans les résultats, et ce qui ne change pas
Affecté :
- Valeur F et valeur p des trois tests de validité (Regression, Non-parallelism, Lack of Fit)
- Une nouvelle colonne « Error Term » dans le tableau ANOVA, qui indique la convention et les degrés de liberté utilisés
- Lower CL et Upper CL de l'intervalle de confiance de l'activité, ainsi qu'une nouvelle colonne « CI Error Term »
Non affecté :
- Les paramètres de la courbe ajustée (asymptotes supérieure et inférieure, facteur de pente, point d'inflexion) pour chaque préparation
- Le rapport d'activité relative estimé
- L'équation du modèle ajusté affichée pour chaque préparation
Où trouver cette capacité
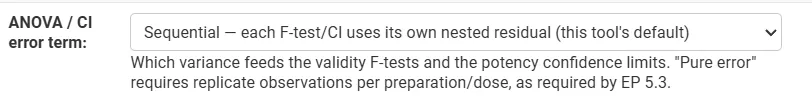
Dans le formulaire de saisie de l'outil Four-Parameter Logistic Method, un champ intitulé « ANOVA / CI error term » propose le choix entre « Sequential — each F-test/CI uses its own nested residual (this tool's default) » et « Pure error — single saturated-model residual for all F-tests and the CI (EP 5.3 default) ». L'option d'erreur pure exige que le modèle saturé (un ajustement par préparation / groupe de doses) ait au moins un degré de liberté résiduel, c'est-à-dire qu'il y ait une certaine réplication dans les données.
Vérification par rapport à des données de référence publiées
Cette option a été vérifiée sur un essai sérologique publié de l'antitoxine tétanique, comparant une préparation étalon et une préparation de sérum à l'essai sur dix étapes de dilution au facteur deux, avec deux répétitions par dose.
Source : Pharmacopée européenne, 5e édition (2005), chapitre 5.3, exemple résolu 5.4.1.a, tel que reproduit dans le rapport d'exemple publié de PLA 3.0 de Stegmann Systems (Document-3567, « PLA_3.0.7_Example_Parallel-Logistic_Quantitative_Response_Assay_Standard_Report.pdf »)
Indicateur | Publié (PLA/EP 5.3) | Calculé (option Pure Error) |
F de régression (df=3) | 9785.4821 | 9788.5262 |
F de non-parallélisme (df=3) | 0.48912 | 0.4884 |
F de défaut d'ajustement (df=12) | 0.62266 | 0.6216 |
Rapport d'activité | 1.45886 | 1.45880 (arrondi : 1.4588) |
Activité estimée de l'échantillon (IU/ml) | 0.58354 | 0.5835 |
IC à 95 % (activité de l'échantillon, IU/ml) | 0.55511 – 0.61343 | 0.5544 – 0.6127 |
Les paramètres de forme de la courbe (asymptotes supérieure et inférieure, facteur de pente, points d'inflexion) et l'estimation ponctuelle de l'activité concordent presque exactement avec le rapport publié sous les deux conventions, ce qui confirme que l'ajustement lui-même n'est pas affecté par cette option, comme prévu. Les valeurs F et l'intervalle de confiance calculés avec l'option d'erreur pure sont proches des valeurs publiées, avec un petit écart résiduel (visible surtout sur l'intervalle de confiance) attribuable à l'arrondi à trois décimales des valeurs intermédiaires par le rapport publié avant le calcul final. La valeur par défaut séquentielle de l'outil n'était, comme attendu, pas destinée à correspondre à ce rapport « Pure-error ANOVA » et sa cohérence interne a été vérifiée séparément.
Références
- Pharmacopée européenne (Ph. Eur.), chapitre 5.3 — « Analyse statistique des résultats d'essais et dosages biologiques » (5e édition, 2005, et éditions suivantes).
- United States Pharmacopeia, chapitre général <111> — « Design and Analysis of Biological Assays ».
- Stegmann Systems GmbH, exemple résolu publié de PLA 3.0 : « PLA_3.0.7_Example_Parallel-Logistic_Quantitative_Response_Assay_Standard_Report.pdf » — https://www.bioassay.de/fileadmin/user_upload/Webseiten-Landingpages/Bioassay.de/Analytical_methodes/Experiments/Parallel_logistic_potency_assays__3PL__4PL__5PL_/PLA_3.0.7_Example_Parallel-Logistic_Quantitative_Response_Assay_Standard_Report.pdf
Questions fréquentes
Qu'est-ce qu'un essai biologique logistique à quatre paramètres (4PL) ?
Un essai 4PL ajuste une courbe sigmoïde, définie par une asymptote supérieure, une asymptote inférieure, un facteur de pente et un point d'inflexion, à la réponse de chaque préparation en fonction du logarithme de la dose. Les tests de validité comparent un modèle à droite plate, un modèle à forme partagée dans lequel seul le point d'inflexion diffère, ce qui donne l'estimation de l'activité, et des courbes entièrement séparées pour chaque préparation.
Quelle différence entre ANOVA séquentielle et ANOVA à erreur pure dans un essai 4PL ?
Dans la convention séquentielle, chaque test F utilise le résidu des modèles emboîtés précis qu'il compare, et l'intervalle de l'activité utilise le résidu de la courbe commune. Dans la convention d'erreur pure, les trois tests F et l'intervalle de l'activité partagent un seul dénominateur : le résidu de l'ajustement entièrement saturé. La courbe ajustée et l'estimation de l'activité sont identiques dans les deux cas.
Quand utiliser l'option d'erreur pure pour un essai 4PL ?
Utilisez l'erreur pure surtout pour rapprocher les résultats de ceux d'un logiciel conforme à EP 5.3 ou d'une méthode validée historique fondée sur sa convention d'ANOVA à erreur pure. Pour un essai valide dont l'ajustement est bon, les deux conventions diffèrent généralement peu. L'écart augmente en présence d'un faible non-parallélisme ou défaut d'ajustement non significatif. Sinon, la valeur par défaut séquentielle reste valide.
Comment sélectionner le terme d'erreur dans Zometric Statistical Software ?
Dans le formulaire de saisie de Four-Parameter Logistic Method, utilisez le champ ANOVA / CI error term pour choisir Sequential (par défaut) ou Pure error. L'option d'erreur pure exige que le modèle saturé ait au moins un degré de liberté résiduel, ce qui signifie qu'il doit y avoir une certaine réplication dans les données.