
ARIMA (prévision de Box-Jenkins)
ARIMA modélise une série mesurée à intervalles réguliers avec des termes autorégressifs (p), de différenciation (d) et de moyenne mobile (q), plus des termes saisonniers facultatifs (P, D, Q, s) et une constante. Utilisez-le lorsque les valeurs dépendent des valeurs précédentes ou que la série présente une tendance ou une saisonnalité. Les graphiques ACF et PACF guident le choix des ordres. Les résultats comprennent les estimations des paramètres, les tests de Ljung-Box, l'ACF/PACF des résidus, MAPE, MAD, MSD et les prévisions avec leurs limites de prévision.
Dernière révision
Point clé
ARIMA ajuste un modèle de Box-Jenkins (autorégressif intégré à moyenne mobile) à une série à pas régulier et prévoit les valeurs futures avec des intervalles de prévision, en tenant compte de la rémanence, de la tendance et de la saison.
Sur cette page
Objectif
ARIMA ajuste un modèle autorégressif intégré à moyenne mobile de Box-Jenkins à une série mesurée à intervalles de temps réguliers (quotidien, hebdomadaire, mensuel) et prévoit les valeurs suivantes avec des intervalles de prévision. Utilisez-le lorsque chaque valeur dépend des valeurs qui la précèdent, ou lorsque la série présente une tendance ou une saison récurrente que des méthodes plus simples, comme les moyennes mobiles ou le lissage exponentiel, ne saisissent pas bien. Les graphiques d'autocorrélation (ACF) et d'autocorrélation partielle (PACF) de la série aident à choisir les ordres du modèle avant de lancer l'analyse.
Principales fonctionnalités
- Termes autorégressifs (p), de différenciation (d) et de moyenne mobile (q) non saisonniers, plus des termes saisonniers (P, D, Q) pour toute période saisonnière, par exemple 12 pour des données mensuelles avec un motif annuel ou 7 pour des données quotidiennes avec un motif hebdomadaire.
- Terme constant facultatif : le niveau moyen d'une série non différenciée, ou la dérive moyenne (tendance) d'une série différenciée.
- Estimations des paramètres avec erreurs-types, valeurs T et valeurs p, afin de pouvoir retirer les termes inutiles.
- Contrôles des résidus : somme des carrés et carré moyen des résidus, tests du khi-deux de Box-Pierce modifié (Ljung-Box) aux décalages 12, 24, 36 et 48, et graphiques ACF et PACF des résidus.
- Prévisions avec limites de prévision inférieure et supérieure au niveau de confiance choisi ; une origine de prévision permet de prévoir à partir d'une ligne antérieure et de comparer les prévisions à ce qui s'est réellement produit.
- Mesures de précision de l'ajustement MAPE, MAD et MSD, comparables à celles des autres outils de séries chronologiques.
- Résultats supplémentaires facultatifs : estimations à chaque itération, matrice de corrélation des paramètres estimés, prévisions rétrospectives (back forecasts) et graphique des résidus quatre-en-un.
Méthodes statistiques
Le modèle est φ(B)Φ(Bˢ)(1−B)ᵈ(1−Bˢ)ᴰ yₜ = C + θ(B)Θ(Bˢ) aₜ, où B est l'opérateur de retard, φ et θ sont les polynômes AR et MA non saisonniers d'ordres p et q, Φ et Θ sont les polynômes AR et MA saisonniers d'ordres P et Q en Bˢ, s est la période saisonnière, C est la constante et aₜ sont les résidus (chocs aléatoires). La différenciation (1−B)ᵈ(1−Bˢ)ᴰ élimine la tendance et la saison avant l'ajustement des termes AR et MA, de sorte que d + D·s observations sont perdues au début de la série.
Les paramètres sont estimés par la méthode des moindres carrés de Box-Jenkins avec prévisions rétrospectives : les valeurs de départ sont affinées par itérations pour minimiser la somme des carrés des résidus, la série étant prévue à rebours pour fournir ses valeurs antérieures à l'échantillon. Le carré moyen résiduel MS = SS / DF, avec DF = nombre d'observations différenciées − nombre de paramètres estimés. La valeur T de chaque coefficient est le coefficient divisé par son erreur-type, la valeur p provenant de la distribution t avec le DF résiduel. Pour un modèle non différencié avec constante, la moyenne du procédé C / (φ(1)Φ(1)) est également indiquée.
La statistique de Ljung-Box Q = n(n+2) Σ rₖ² / (n−k) est calculée à partir des autocorrélations des résidus rₖ jusqu'à chaque décalage et comparée à une distribution du khi-deux dont le DF est le décalage moins le nombre de paramètres estimés ; une valeur p supérieure à 0.05 signifie qu'aucun élément n'indique qu'il reste de l'autocorrélation dans les résidus. Les prévisions sont établies de manière récursive à partir de l'équation ajustée ; l'intervalle de prévision à h périodes est la prévision ± z·√(MS·Σψⱼ²), en sommant les h premiers poids ψ du modèle, de sorte que les intervalles s'élargissent avec l'horizon de prévision.
Champs de saisie et options
Champ | Description |
Variable (Y) | Obligatoire. La colonne contenant la série, dans l'ordre chronologique, à intervalles réguliers. |
Autoregressive order (p) | Nombre de termes AR non saisonniers (0 à 10, 1 par défaut) : combien de valeurs précédentes se répercutent sur la valeur courante. |
Difference order (d) | Nombre de différenciations non saisonnières (0 à 3, 0 par défaut). Utilisez 1 pour une série dont la tendance dérive ou croît. |
Moving average order (q) | Nombre de termes MA non saisonniers (0 à 10, 0 par défaut) : combien de chocs aléatoires précédents se répercutent. |
Include seasonal terms | Cochez pour ajouter les ordres saisonniers ci-dessous. Le modèle a besoin d'au moins un terme AR ou MA au total. |
Seasonal AR order (P) / Seasonal difference order (D) / Seasonal MA order (Q) | Ordres saisonniers (P et Q de 0 à 5, D de 0 à 2). D = 1 modélise la variation d'une année sur l'autre pour des données mensuelles avec s = 12. |
Seasonal period (s) | Obligatoire avec les termes saisonniers : le nombre d'observations dans une saison (12 pour des données mensuelles avec un cycle annuel, 4 pour des données trimestrielles, 7 pour des données quotidiennes avec un cycle hebdomadaire). |
Include constant term | Coché par défaut. Décochez pour une série différenciée sans dérive. |
Number of forecasts | Nombre de périodes à prévoir après l'origine de prévision (0 à 1000 ; 0 = aucune prévision). |
Confidence level (%) for forecast interval | 95 par défaut. |
Forecast origin (row) | Facultatif. Les prévisions commencent après cette ligne, à partir des données jusqu'à cette ligne ; vide = fin de la série. Utilisez-le pour tester le modèle sur des données que vous possédez déjà. |
Results to display | Estimations finales, informations de différenciation, sommes des carrés des résidus, nombre d'observations ; ou, en plus, les estimations à chaque itération, la matrice de corrélation des paramètres estimés ou les prévisions rétrospectives. |
Residual plots (four in one) | Ajoute une droite de probabilité normale, les résidus en fonction des valeurs ajustées, un histogramme et les résidus en fonction de l'ordre. |
Title | Titre affiché sur les résultats. |
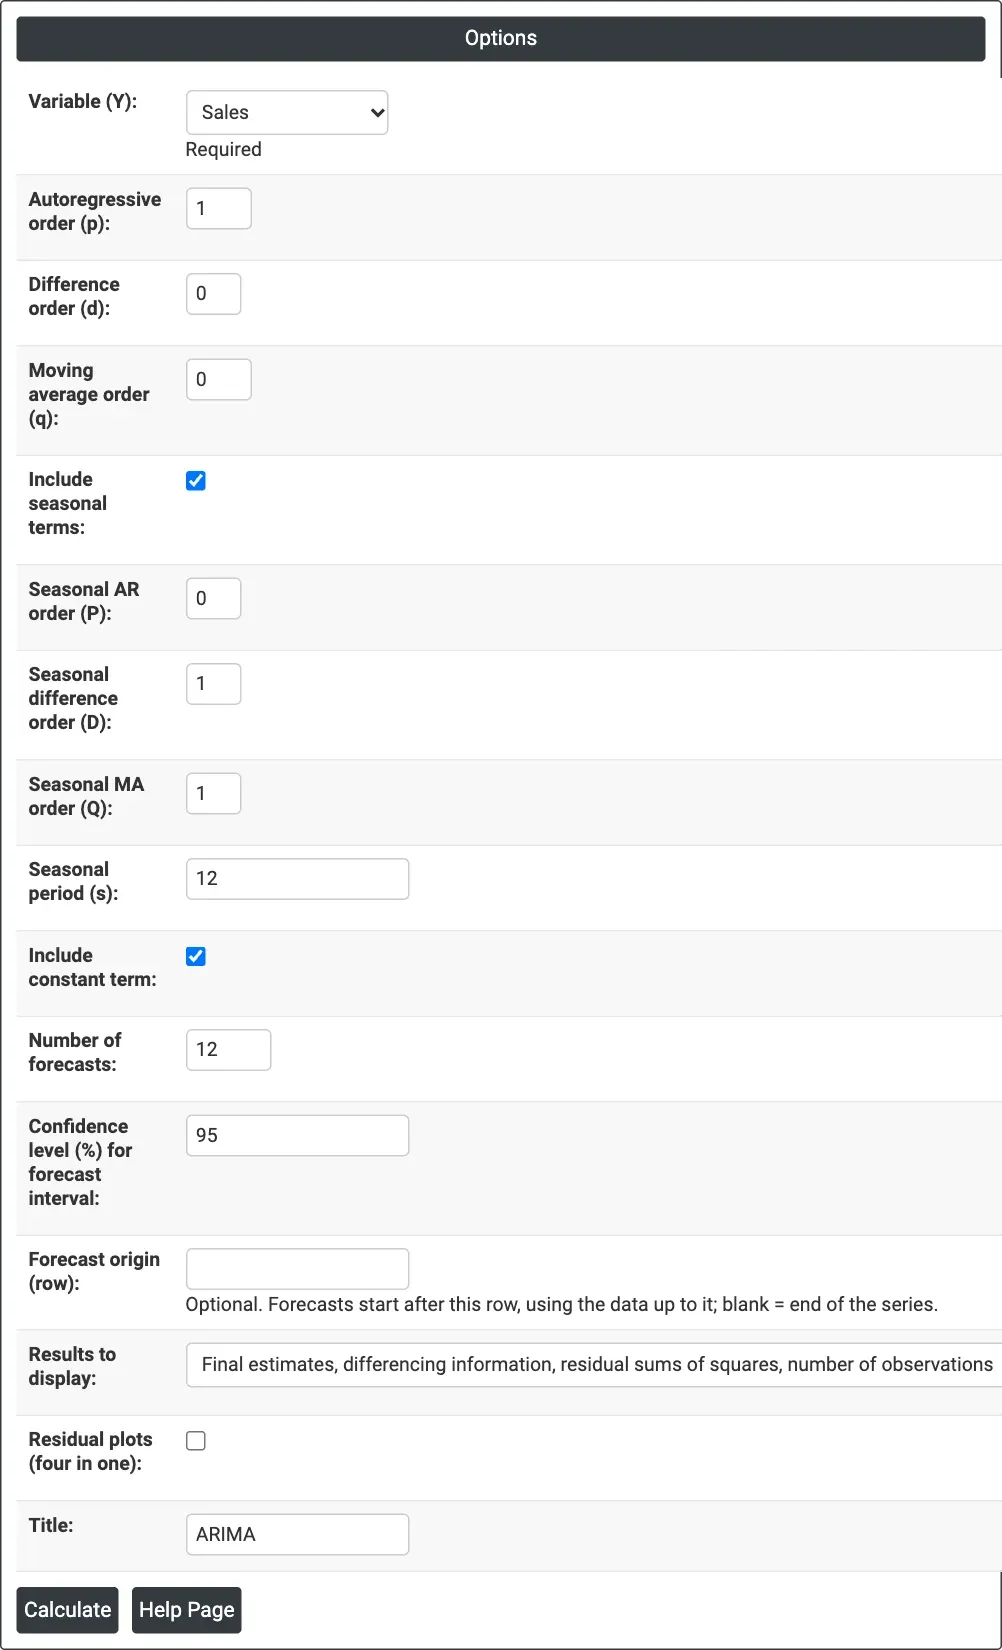
Figure 1 — L'exemple des ventes mensuelles : Variable (Y) = Sales, un modèle ARIMA(1, 0, 0)(0, 1, 1)12 saisonnier avec constante et 12 prévisions.
Description des résultats
- ARIMA plot — la série avec les valeurs ajustées, les prévisions et leur bande d'intervalle de prévision ; MAPE, MAD et MSD sont indiqués sous le titre.
- Final Estimates of Parameters — chaque terme AR, SAR, MA et SMA et la constante, avec coefficient, SE Coef, T-Value et P-Value (et la moyenne (Mean) pour un modèle non différencié avec constante).
- Residual Sums of Squares — DF, SS et MS des résidus.
- Modified Box-Pierce (Ljung-Box) Chi-Square statistic — Chi-Square, DF et P-Value aux décalages 12, 24, 36 et 48 (les décalages plus longs que la série sont omis).
- Forecasts — période, prévision, et limites de prévision inférieure et supérieure.
- ACF and PACF of Residuals — des barres à l'intérieur des limites en pointillés signifient qu'il ne reste pas d'autocorrélation.
- Tableaux et graphiques facultatifs choisis dans Results to display et Residual plots, et export PDF via Download.
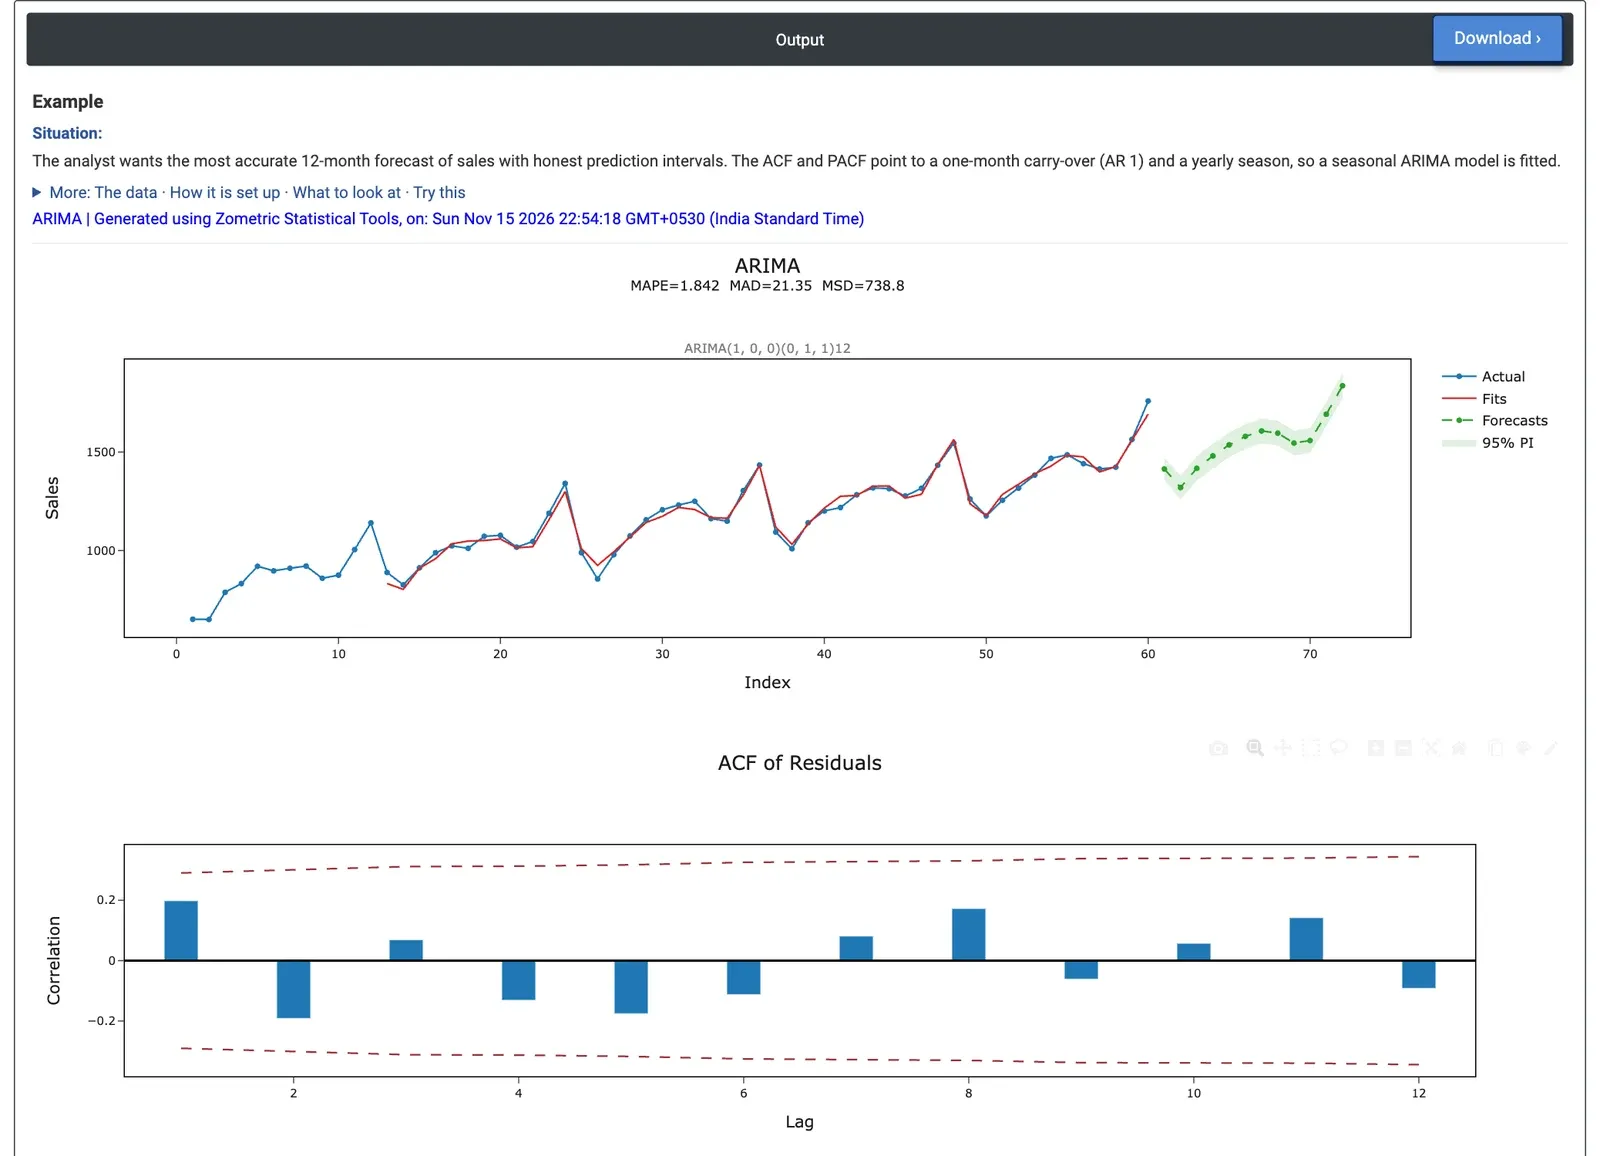
Figure 2 — Résultats ARIMA pour l'exemple des ventes mensuelles : l'ajustement et la prévision à 12 mois avec sa bande de prévision à 95%, et l'ACF des résidus.
Exemple résolu
Un analyste dispose de 60 mois de ventes (janvier 2020 à décembre 2024) et veut une prévision à 12 mois avec des intervalles de prévision fiables. L'ACF et la PACF indiquent une rémanence d'un mois et une saison annuelle ; le modèle est donc ARIMA(1, 0, 0)(0, 1, 1)12 avec constante : Autoregressive order (p) = 1, Seasonal difference order (D) = 1, Seasonal MA order (Q) = 1, Seasonal period (s) = 12 et Number of forecasts = 12.
Les deux termes sont manifestement nécessaires : AR 1 = 0.481 (SE 0.104, T = 4.63, p < 0.001) et SMA 12 = 0.805 (SE 0.144, T = 5.59, p < 0.001), avec une constante de 69.34 (la croissance annuelle moyenne d'une année sur l'autre). Le MS résiduel est de 788.1 pour 45 DF (60 mois − 12 perdus à cause de la différenciation saisonnière − 3 paramètres). Les valeurs p de Ljung-Box sont 0.214, 0.319 et 0.254 aux décalages 12, 24 et 36, toutes supérieures à 0.05 : les résidus ressemblent donc à du bruit aléatoire et le modèle a saisi le motif. L'ajustement est serré : MAPE 1.84%, MAD 21.35, MSD 738.8.
La prévision pour janvier 2025 (période 61) est de 1,414 unités avec un intervalle de prévision à 95% de 1,359 à 1,469, qui monte à 1,837 pour décembre 2025 (période 72), intervalle de 1,774 à 1,899. Pour tester le modèle avant de s'y fier, définissez Forecast origin (row) = 48 afin de prévoir 2024 à partir des données jusqu'en décembre 2023 et comparez les prévisions aux ventes réelles de 2024.
Questions fréquentes
Qu'est-ce qu'un modèle ARIMA ?
ARIMA est un modèle autorégressif intégré à moyenne mobile de Box-Jenkins pour une série mesurée à intervalles de temps réguliers. Les termes autorégressifs répercutent les valeurs précédentes, la différenciation élimine la tendance et les termes de moyenne mobile répercutent les chocs aléatoires précédents. Des termes saisonniers peuvent être ajoutés pour une saison récurrente, par exemple la période 12 pour des données mensuelles avec un motif annuel.
Quand utiliser ARIMA plutôt que le lissage exponentiel ?
Utilisez ARIMA lorsque chaque valeur dépend des valeurs qui la précèdent, ou lorsque la série présente une tendance ou une saison récurrente que des méthodes plus simples, comme les moyennes mobiles ou le lissage exponentiel, ne saisissent pas bien. Les graphiques d'autocorrélation (ACF) et d'autocorrélation partielle (PACF) de la série aident à choisir les ordres du modèle avant l'ajustement.
Comment vérifier qu'un modèle ARIMA s'ajuste bien ?
Vérifiez que la valeur p de chaque terme montre qu'il est nécessaire, et examinez les tests du khi-deux de Ljung-Box aux décalages 12, 24, 36 et 48 : une valeur p supérieure à 0.05 signifie qu'aucun élément n'indique de l'autocorrélation restante dans les résidus. Les barres de l'ACF et de la PACF des résidus doivent rester à l'intérieur des limites en pointillés. MAPE, MAD et MSD résument la précision de l'ajustement.
Comment tester une prévision ARIMA avant de s'y fier ?
Définissez une origine de prévision à une ligne antérieure afin que le modèle prévoie à partir des données jusqu'à ce point, puis comparez ces prévisions à ce qui s'est réellement produit. Dans l'exemple résolu, définir l'origine à la ligne 48 prévoit 2024 à partir des données jusqu'en décembre 2023, pour comparaison avec les ventes réelles de 2024. Les intervalles de prévision s'élargissent avec l'horizon de prévision.