
Capabilité du procédé automatisée
La capabilité du procédé automatisée supprime la vérification manuelle de la normalité. Elle exécute un test d'Anderson-Darling : si la valeur p atteint le seuil (0.1 par défaut), elle calcule Pp, Ppl, Ppu et Ppk normaux ; sinon, elle ajuste des distributions non normales candidates par maximum de vraisemblance, retient la meilleure et applique la méthode du score z. Les résultats indiquent le chemin suivi, un histogramme ajusté, les indices et les PPM attendus et observés.
Dernière révision
Point clé
La capabilité du procédé automatisée teste la normalité par Anderson-Darling et calcule automatiquement Pp et Ppk selon le modèle normal ou la meilleure distribution non normale, en documentant le chemin suivi.
Sur cette page
Objectif
La capabilité du procédé automatisée supprime l'étape manuelle qui consiste à tester d'abord la normalité, puis à choisir séparément entre un modèle de capabilité normal ou non normal. L'outil exécute lui-même le test de normalité d'Anderson-Darling et oriente automatiquement le calcul vers les indices de capabilité normaux standard lorsque les données le passent, ou vers la distribution non normale la mieux ajustée (choisie dans la bibliothèque de distributions candidates de l'application) lorsqu'elles ne le passent pas — en produisant un seul rapport où la décision d'orientation est documentée en haut.
Principales fonctionnalités
- Exécute automatiquement le test de normalité d'Anderson-Darling — aucune étape séparée de vérification de la normalité n'est nécessaire.
- Sélectionne automatiquement la distribution candidate non normale la mieux ajustée lorsque l'hypothèse de normalité est rejetée, avec la même bibliothèque d'ajustement de distributions que les autres outils de capabilité non normale de l'application.
- Seuil de valeur p de normalité configurable, afin que les utilisateurs puissent régler le degré de prudence avec lequel l'outil retient par défaut le chemin normal.
- Indique directement dans les résultats le chemin suivi (normal ou non normal, et quelle distribution), de sorte que la décision d'orientation est transparente et auditable.
- Prend en charge une colonne Factor facultative et un mode « Compare selected columns as separate groups », comme les autres outils de capabilité de l'application.
Méthodes statistiques
La normalité est évaluée par le test d'Anderson-Darling (anderson() de scipy par rapport à une référence normale), avec la correction standard pour petits échantillons AD = A²·(1 + 0.75/n + 2.25/n²), la valeur p étant dérivée des approximations empiriques par morceaux de D'Agostino–Stephens pour la statistique AD corrigée.
Règle d'orientation : si la valeur p d'Anderson-Darling est supérieure ou égale au seuil Normality p-value threshold (0.1 par défaut), l'outil considère les données comme normales — il estime σ_overall par la méthode de l'étendue mobile (MRbar/d2, ou une variante à médiane de l'étendue mobile) et en déduit les indices de performance standard fondés sur z : Pp, Ppl, Ppu, Ppk. Si la valeur p est inférieure au seuil, l'outil ajuste à la place chaque distribution non normale candidate prise en charge par l'application (Weibull, Weibull à 3 paramètres, exponentielle, exponentielle à 2 paramètres, gamma, logistique, log-logistique, log-normale, et distributions des valeurs extrêmes minimales et maximales) par maximum de vraisemblance, les classe selon la qualité d'ajustement et sélectionne automatiquement la mieux ajustée.
Pour le chemin non normal, la fonction de répartition (CDF) de la distribution sélectionnée est évaluée en LSL et en USL pour obtenir les probabilités de queue p_lsl et p_usl, qui sont ensuite converties en scores z de la loi normale centrée réduite équivalents par la fonction de répartition normale inverse (norm.ppf) — la « méthode du score z ». La capabilité est ensuite exprimée sur l'échelle familière du Cpk à partir de ces scores z : Pp = (z_usl − z_lsl) / 6, PPL = −norm.ppf(p_lsl) / 3, PPU = norm.ppf(p_usl) / 3, Ppk = min(PPL, PPU) — de sorte que le risque réel en queue d'une distribution asymétrique est pris en compte avant d'être exprimé dans les mêmes unités de type Cpk que dans toute l'application, au lieu d'appliquer à tort un score Z normal brut à des données non normales.
Les chiffres de PPM (parties par million) sont fournis de deux façons : les PPM « attendus », issus des probabilités de queue de la distribution ajustée au-delà de chaque limite de spécification, et les PPM « observés », obtenus en comptant simplement la fraction de l'échantillon brut qui se situe réellement hors des limites de spécification.
Champs de saisie et options
Champ | Description |
Choose columns | La ou les colonnes de réponse à analyser. |
Factor | Facultatif. Compare la capabilité entre groupes lorsque les données se composent d'une seule colonne Response et d'une colonne Factor. |
Compare selected columns as separate groups | Lorsque 2 colonnes ou plus sont sélectionnées, exécute la capabilité séparément pour chacune et les compare côte à côte. |
LSL / USL | Limites de spécification inférieure et supérieure, appliquées à chaque colonne sélectionnée. |
Normality p-value threshold | 0.1 par défaut. Si la valeur p d'Anderson-Darling est égale ou supérieure à ce seuil, la capabilité est calculée en supposant la normalité ; sinon, la distribution non normale la mieux ajustée est sélectionnée automatiquement et utilisée à la place. |
Download as Excel | Facultatif. Exporte le rapport dans un classeur Excel. |
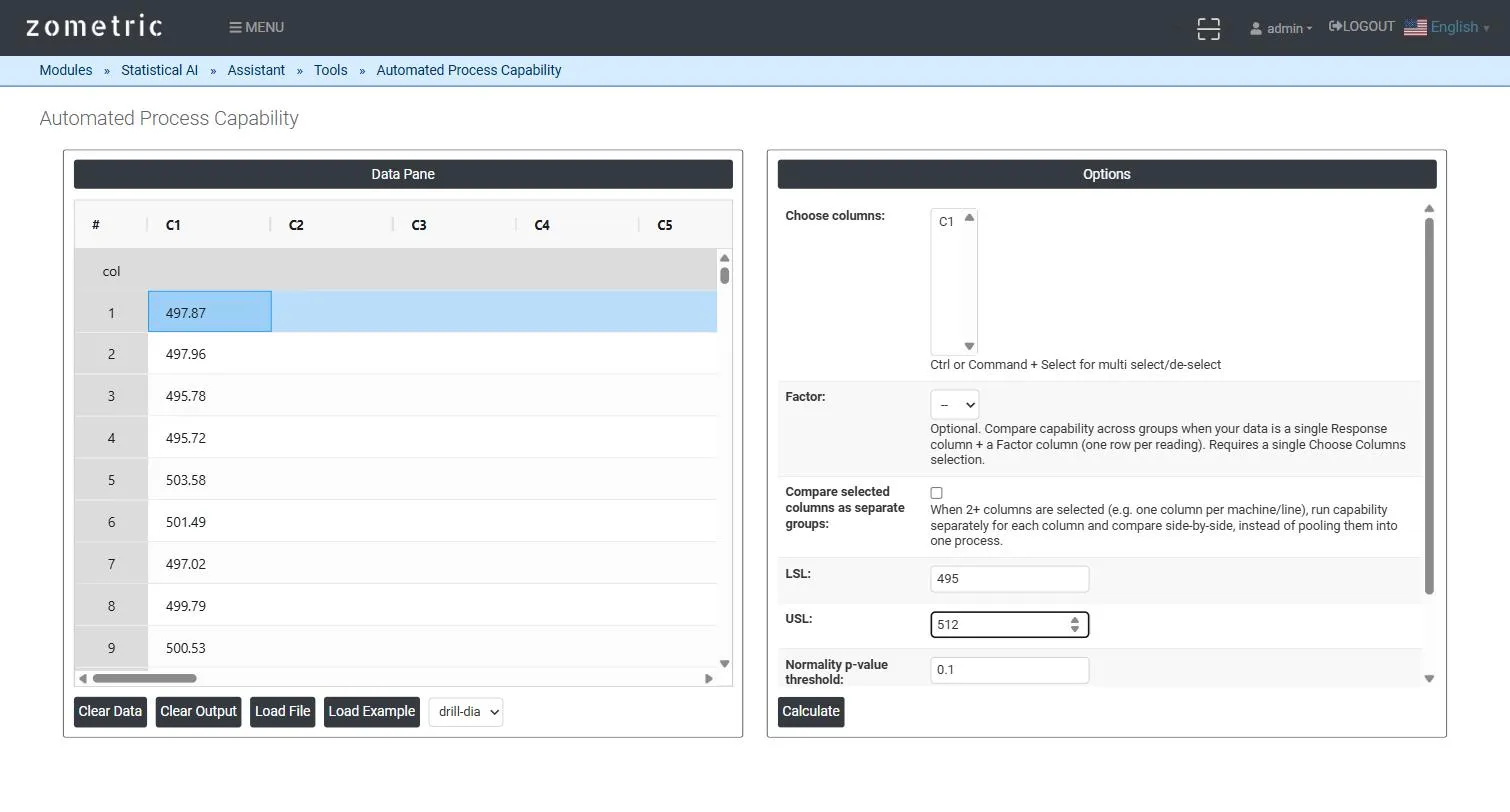
Figure 1 — Data pane avec 60 relevés de poids de remplissage collés dans C1, LSL/USL et Normality p-value threshold renseignés dans le panneau Options.
Description des résultats
- Résultat du test de normalité — la statistique et la valeur p d'Anderson-Darling, et le chemin suivi (normal, ou la distribution non normale précise sélectionnée automatiquement).
- Histogramme de la distribution ajustée — histogramme de l'échantillon avec la courbe de densité ajustée et les lignes de référence LSL/USL superposées.
- Tableau des paramètres de la distribution — LSL, USL, moyenne de l'échantillon, effectif de l'échantillon, et paramètres de forme/d'échelle (ou équivalents) de la distribution ajustée.
- Indices de capabilité — Pp, Ppl, Ppu, Ppk calculés à partir de la distribution sélectionnée, quelle qu'elle soit.
- Tableaux de PPM — PPM attendus (issus des queues de la distribution ajustée) et PPM observés (issus de l'échantillon brut), chacun réparti en PPM < LSL, PPM > USL et PPM Total.
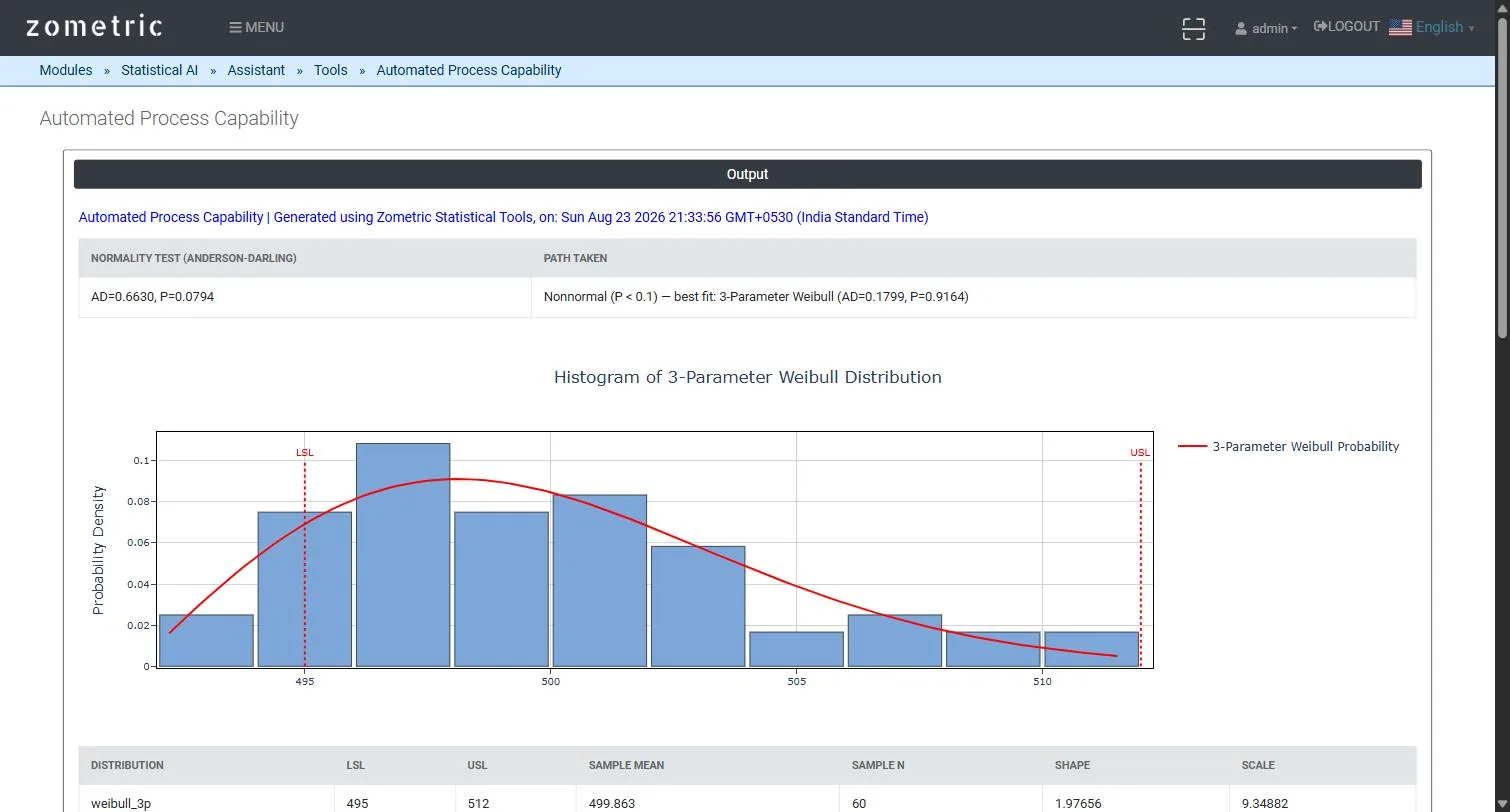
Figure 2 — Paramètres de la distribution et indices Pp/Ppl/Ppu/Ppk obtenus, avec les tableaux de PPM attendus et observés.
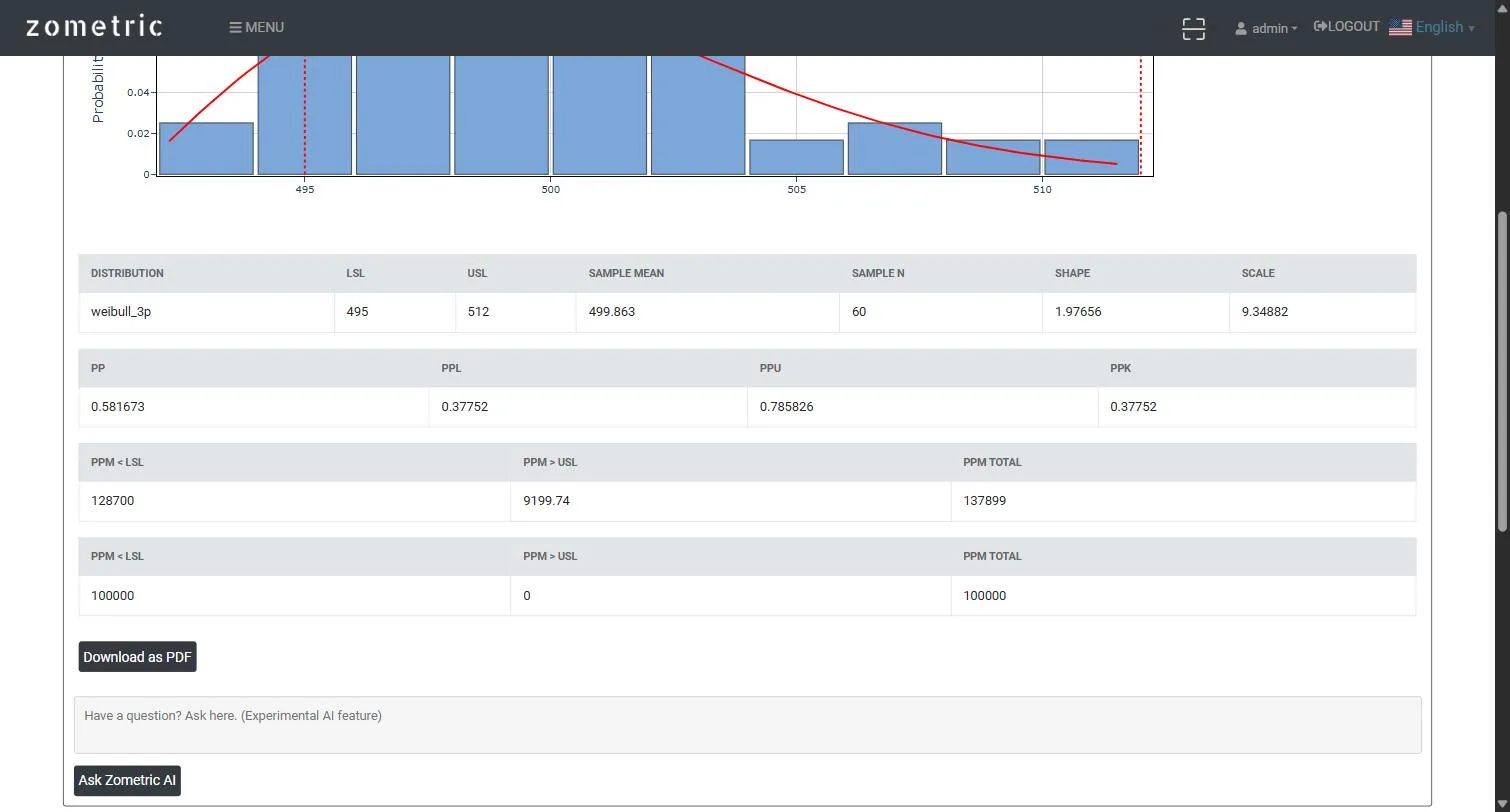
Figure 3 — Décision d'orientation automatique (résultat d'Anderson-Darling et chemin suivi) avec l'histogramme de la distribution ajustée.
Exemple résolu
Une ligne de remplissage conditionne un liquide de nettoyage visqueux ; le poids de remplissage (g) est mesuré sur 60 flacons prélevés au cours d'un poste (colonne C1), avec LSL = 495 g et USL = 512 g. Avec le seuil par défaut de 0.1, le test d'Anderson-Darling donne AD = 0.6630, P = 0.0794 — inférieur au seuil — et l'outil s'oriente donc automatiquement vers le chemin non normal et sélectionne un ajustement de Weibull à 3 paramètres (AD = 0.1799, P = 0.9164) comme distribution la mieux ajustée, en indiquant Ppk = 0.378 à partir des probabilités de queue de la distribution de Weibull ajustée plutôt qu'à partir d'une hypothèse de distribution normale (trompeuse).
Questions fréquentes
Que fait la capabilité du procédé automatisée ?
Elle exécute le test de normalité d'Anderson-Darling sur les données, puis oriente automatiquement le calcul de capabilité : vers les indices de capabilité normaux standard si les données le passent, ou vers la distribution non normale la mieux ajustée sinon. Un seul rapport présente le résultat du test de normalité, le chemin suivi et la distribution utilisée, de sorte que la décision d'orientation est transparente et auditable.
Comment l'outil choisit-il entre capabilité normale et non normale ?
Si la valeur p d'Anderson-Darling est supérieure ou égale au seuil Normality p-value threshold, qui vaut 0.1 par défaut, les données sont considérées comme normales. Si elle est inférieure au seuil, l'outil ajuste par maximum de vraisemblance des distributions candidates telles que Weibull, Weibull à 3 paramètres, gamma, log-normale et d'autres, les classe selon la qualité d'ajustement et retient la meilleure.
Comment calcule-t-on le Ppk pour des données non normales ?
La CDF de la distribution sélectionnée donne les probabilités de queue au-delà de la LSL et de la USL, converties en scores z de la loi normale centrée réduite équivalents. Ensuite, PPL = -z(p_lsl)/3, PPU = z(p_usl)/3 et Ppk = min(PPL, PPU). Cela rend compte du risque réel en queue d'une distribution asymétrique tout en conservant l'échelle familière de type Cpk.
Comment exécuter la capabilité automatisée dans Zometric Statistical Software ?
Collez les données, choisissez la ou les colonnes de réponse, éventuellement un Factor ou l'option de comparer les colonnes comme groupes séparés, et saisissez la LSL et la USL. Réglez le Normality p-value threshold (0.1 par défaut). Le rapport présente la décision d'orientation, l'histogramme ajusté, les paramètres de la distribution, les indices de capabilité et les tableaux de PPM, et peut être exporté vers Excel.