
Régression sur les meilleurs sous-ensembles (Best Subsets)
La régression sur les meilleurs sous-ensembles (Best Subsets Regression) ajuste des modèles des moindres carrés ordinaires pour chaque sous-ensemble de prédicteurs libres, en en imposant éventuellement certains dans tous les modèles, et affiche les un à cinq meilleurs modèles de chaque taille. Chaque ligne indique R-Sq, R-Sq(adj), R-Sq(pred), le Cp de Mallows et S, avec PRESS, AICc, BIC et VIF en option. Utilisez-la tôt pour présélectionner les prédicteurs, puis ajustez le modèle retenu avec Fit Regression Model.
Dernière révision
Point clé
Ajuste une régression linéaire pour chaque combinaison de prédicteurs candidats et liste les meilleurs modèles de chaque taille, afin de trouver le plus petit ensemble expliquant l'essentiel de la variation de la réponse.
Sur cette page
Objectif
La régression sur les meilleurs sous-ensembles (Best Subsets Regression) ajuste une régression linéaire pour chaque combinaison des prédicteurs candidats et liste côte à côte les meilleurs modèles de chaque taille. Utilisez-la tôt dans une étude, lorsque vous disposez de plusieurs réglages possibles du procédé et cherchez le plus petit ensemble qui explique l'essentiel de la variation de la réponse, avant d'ajuster en détail le modèle retenu avec Fit Regression Model.
Principales fonctionnalités
- Ajuste chaque sous-ensemble des prédicteurs libres, du nombre minimal au nombre maximal que vous définissez.
- Affiche les un à cinq meilleurs modèles de chaque taille, classés selon R-Sq.
- Fournit R-Sq, R-Sq(adj), R-Sq(pred), le Cp de Mallows et S pour chaque modèle, avec PRESS, AICc et BIC sur demande.
- Predictors in all models : imposez dans chaque sous-ensemble les variables dont vous savez qu'elles comptent.
- Les tableaux Enhanced ajoutent le facteur d'inflation de la variance (VIF) de chaque prédicteur dans chaque modèle, pour repérer les prédicteurs corrélés.
- Modèle avec ou sans constante (intercept).
Méthodes statistiques
Les lignes dont la réponse ou l'un des prédicteurs sélectionnés est manquant ou non numérique sont écartées. Pour chaque taille de sous-ensemble, du minimum au maximum, l'outil ajuste un modèle des moindres carrés ordinaires pour chaque combinaison de ce nombre de prédicteurs libres (plus les éventuels prédicteurs imposés), les trie selon R-Sq et conserve les meilleurs modèles de chaque taille. Avec p prédicteurs libres, il y a 2ᵖ − 1 sous-ensembles : chaque candidat ajouté double donc le nombre d'ajustements.
Pour un modèle à k coefficients (constante comprise) ajusté sur n lignes : S = √MSE ; R-Sq(adj) corrige R-Sq en fonction du nombre de termes ; PRESS = Σ (eᵢ / (1 − hᵢ))², somme des carrés des erreurs de prédiction par omission d'une observation (leave-one-out) à l'aide des leviers hᵢ ; R-Sq(pred) = 1 − PRESS / SS Total. Cp de Mallows = SSE / MSE(full) − (n − 2k), où MSE(full) est le carré moyen de l'erreur du modèle contenant tous les prédicteurs ; un modèle peu biaisé a un Cp proche de k, et le modèle complet a toujours Cp = k. AICc = −2 log L + 2(k+1) + 2(k+1)(k+2)/(n − k − 2) et BIC = −2 log L + (k+1) ln n, σ étant compté comme un paramètre ; plus la valeur est petite, mieux c'est pour PRESS, AICc et BIC.
Cherchez le modèle où R-Sq(adj) et R-Sq(pred) cessent d'augmenter, où Cp est proche du nombre de coefficients et où S est faible. Un écart important entre R-Sq et R-Sq(pred) signale un surajustement. Best Subsets ne fait que comparer des ajustements : vérifiez les résidus et les coefficients du modèle retenu dans Fit Regression Model.
Champs de saisie et options
Champ | Description |
Response (Y) | Colonne numérique à expliquer. Obligatoire. |
Free predictors | Prédicteurs candidats numériques ; toutes les combinaisons sont essayées. Obligatoire. Ctrl ou Commande + clic pour en sélectionner plusieurs. |
Predictors in all models (optional) | Prédicteurs numériques inclus dans chaque modèle. Ils ne doivent pas figurer aussi parmi les prédicteurs libres. |
Models of each size to display | Nombre des meilleurs modèles de chaque taille qui sont listés, de 1 à 5. Par défaut 2. |
Display PRESS / Display AICc / Display BIC | Ajoutent ces colonnes au tableau. Désactivées par défaut. |
Free Predictors: Minimum / Maximum | Plus petit et plus grand nombre de prédicteurs libres dans un modèle. Par défaut de 1 à tous. |
Fit intercept | Cochée par défaut. Décochez pour ajuster des modèles passant par l'origine (R-Sq n'est alors plus centré). |
Display of results | Simple tables (par défaut) ou Enhanced tables, qui ajoutent une colonne VIF pour chaque prédicteur. |
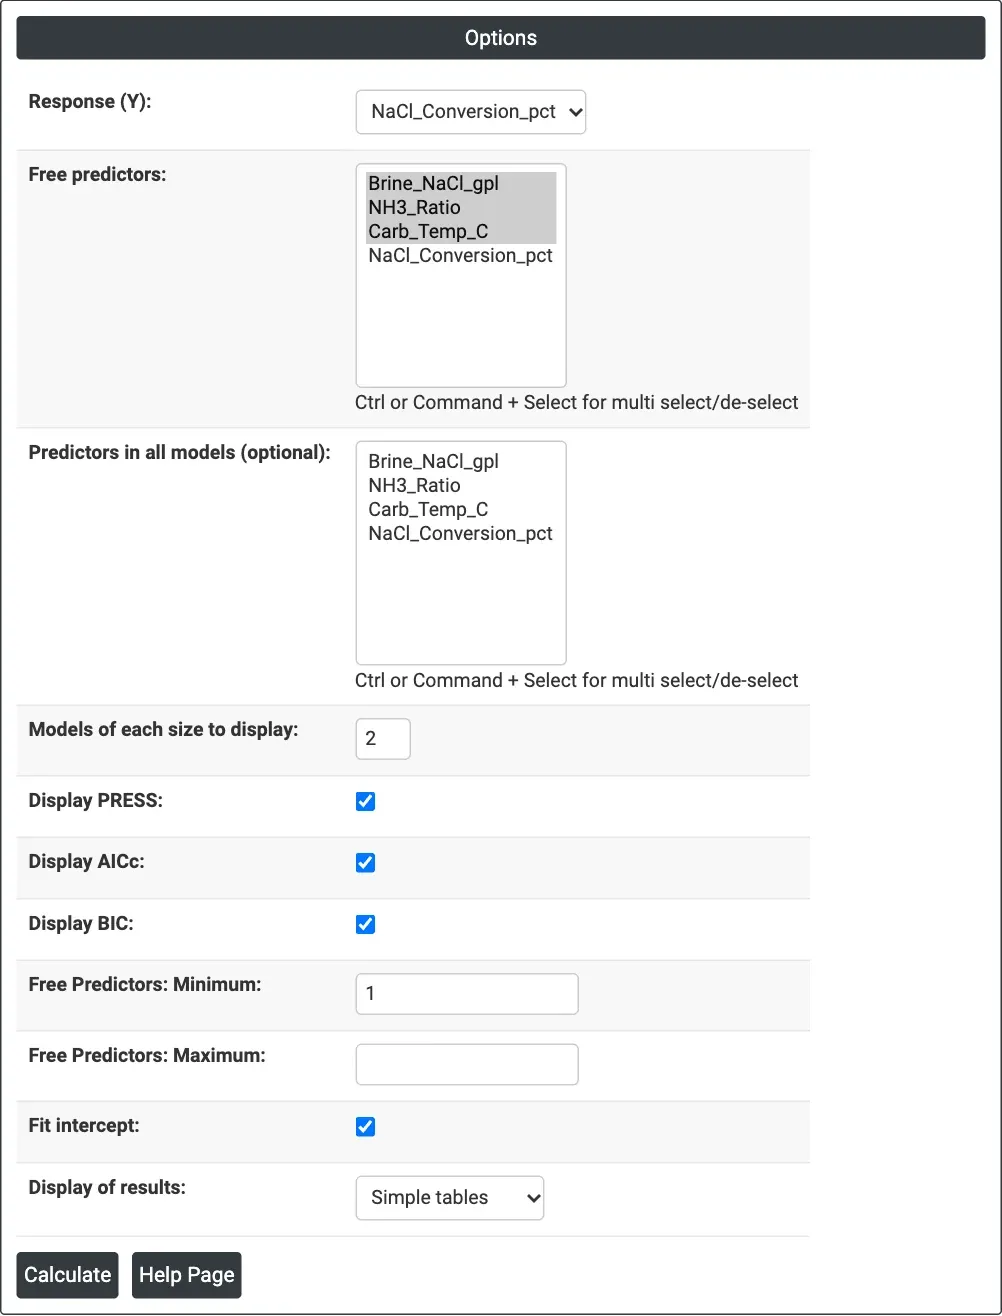
Figure 1 — Options de l'exemple du carbonate de sodium : NaCl_Conversion_pct comme réponse, les trois réglages du procédé comme prédicteurs libres, avec PRESS, AICc et BIC affichés.
Description des résultats
- Response line : indique la réponse et les éventuels prédicteurs imposés dans tous les modèles.
- Best Subsets Results table : une ligne par modèle : Vars (nombre de prédicteurs libres), R-Sq, R-Sq(adj), R-Sq(pred), Cp de Mallows, S, PRESS, AICc et BIC en option, et un X sous chaque prédicteur du modèle ; avec les tableaux Enhanced, le VIF de chaque prédicteur du modèle.
- Export PDF via Download.
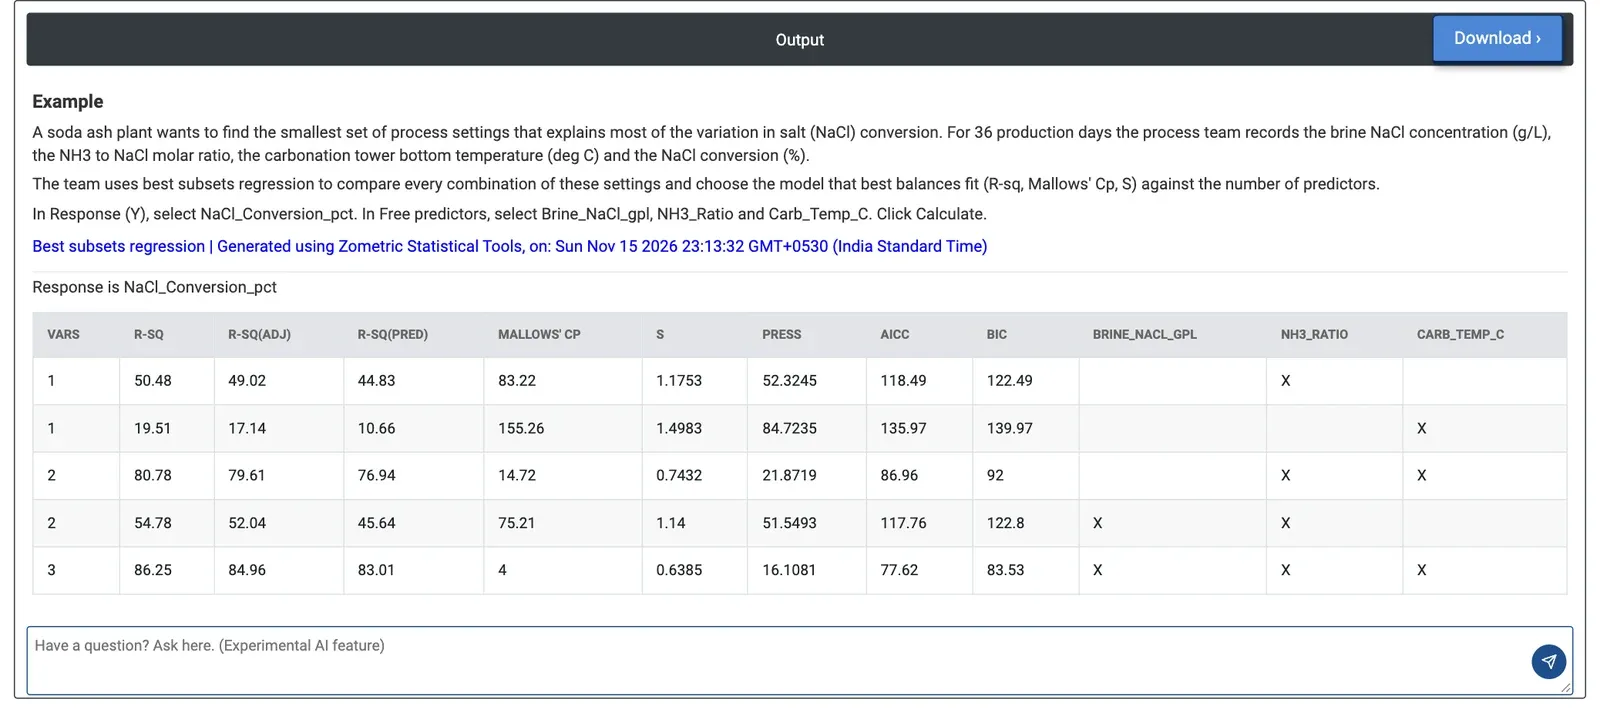
Figure 2 — Résultats des meilleurs sous-ensembles pour la conversion de NaCl : le modèle à trois prédicteurs a un R-Sq de 86.25 %, un R-Sq(pred) de 83.01 %, un Cp de 4 et un S de 0.6385.
Exemple résolu
Une usine de carbonate de sodium veut savoir quels réglages du procédé expliquent la conversion quotidienne du NaCl (%). Pendant 36 jours de production, l'équipe relève la concentration en NaCl de la saumure (Brine_NaCl_gpl), le rapport molaire NH3/NaCl (NH3_Ratio) et la température en bas de la tour de carbonatation (Carb_Temp_C). Elle sélectionne NaCl_Conversion_pct comme réponse, les trois réglages comme prédicteurs libres, conserve deux modèles de chaque taille et coche Display PRESS, AICc et BIC.
Pris seul, le rapport NH3 est le meilleur prédicteur unique, mais il n'explique que 50.48 % de la variation (Cp 83.22). Ajouter la température de carbonatation porte R-Sq à 80.78 % et fait passer S de 1.1753 à 0.7432 point de pourcentage ; pourtant Cp reste à 14.72, bien au-dessus des 3 coefficients de ce modèle : il manque donc quelque chose. Avec les trois réglages, R-Sq vaut 86.25 %, R-Sq(pred) 83.01 %, S 0.6385, et PRESS, AICc et BIC sont les plus bas du tableau (16.1081, 77.62 et 83.53). Le faible écart entre R-Sq et R-Sq(pred) montre que le modèle n'est pas surajusté.
L'équipe conserve les trois réglages et les ajuste avec Fit Regression Model. En cochant Enhanced tables, on obtient des VIF de 1.01 à 1.03 : les trois réglages n'ont donc pas été modifiés simultanément et chaque effet peut être lu séparément.
Questions fréquentes
Qu'est-ce que la régression sur les meilleurs sous-ensembles ?
La régression sur les meilleurs sous-ensembles ajuste une régression linéaire pour chaque combinaison des prédicteurs candidats et liste côte à côte les meilleurs modèles de chaque taille, classés selon R-Sq. Elle sert tôt dans une étude à trouver le plus petit ensemble de prédicteurs, par exemple des réglages du procédé, qui explique l'essentiel de la variation de la réponse.
Comment choisir le meilleur modèle à partir des résultats des meilleurs sous-ensembles ?
Cherchez le modèle où R-Sq(adj) et R-Sq(pred) cessent d'augmenter, où le Cp de Mallows est proche du nombre de coefficients et où S est faible. Plus PRESS, AICc et BIC sont petits, mieux c'est. Un écart important entre R-Sq et R-Sq(pred) signale un surajustement. Vérifiez ensuite les résidus et les coefficients du modèle retenu dans Fit Regression Model.
Que signifie le Cp de Mallows dans la régression sur les meilleurs sous-ensembles ?
Le Cp de Mallows compare l'erreur d'un modèle à celle du modèle complet contenant tous les prédicteurs. Un modèle peu biaisé a un Cp proche de k, son nombre de coefficients constante comprise, et le modèle complet a toujours Cp égal à k. Un Cp nettement supérieur à k, comme 14.72 pour un modèle à 3 coefficients dans l'exemple, suggère qu'un prédicteur important manque.
Combien de modèles la régression sur les meilleurs sous-ensembles ajuste-t-elle ?
Avec p prédicteurs libres, il y a 2 puissance p moins 1 sous-ensembles : chaque prédicteur candidat ajouté double donc le nombre d'ajustements. Vous pouvez limiter le nombre minimal et maximal de prédicteurs libres par modèle, imposer des prédicteurs connus dans chaque modèle et choisir combien des meilleurs modèles de chaque taille afficher, de 1 à 5.