
Droite d'ajustement binaire (Binary Fitted Line Plot)
La droite d'ajustement binaire modélise la probabilité d'un résultat conforme/non conforme ou oui/non en fonction d'un prédicteur continu, à partir de lignes binaires brutes ou de comptes d'événements/essais et d'un lien logit, probit ou log-log complémentaire. Les résultats comprennent l'équation de régression, l'ANOVA de la déviance, le Deviance R-Sq, l'AIC, l'aire sous la courbe ROC, les coefficients, les rapports de cotes (logit), la courbe ajustée et les observations inhabituelles.
Dernière révision
Point clé
Une droite d'ajustement binaire ajuste une régression logistique (ou probit) d'un résultat oui/non sur un prédicteur continu et trace la courbe en S, montrant de combien un réglage doit varier pour que l'événement devienne probable.
Sur cette page
Objectif
La droite d'ajustement binaire (Binary Fitted Line Plot) modélise comment la probabilité d'un résultat oui/non varie avec un prédicteur continu, et trace la courbe en S ajustée sur les données. Utilisez-la lorsque le résultat est conforme/non conforme, défectueux/bon ou aggloméré/non aggloméré, et que vous voulez savoir de combien un réglage tel que la température, l'humidité ou la dose doit varier pour que l'événement devienne probable.
Fonctionnalités principales
- Accepte des données brutes (une ligne par unité avec une colonne oui/non) ou des données résumées (nombre d'événements et nombre d'essais par ligne).
- Lien logit, probit ou log-log complémentaire.
- Équation de régression, tableau d'ANOVA de la déviance, résumé du modèle, coefficients avec intervalles de confiance et, pour le lien logit, rapport de cotes (odds ratio) pour tout incrément du prédicteur.
- Graphique de la courbe de probabilité ajustée, avec proportions observées et bande de confiance facultatives.
- Tableau des observations inhabituelles (résidus élevés ou valeurs inhabituelles du prédicteur) et graphiques de résidus facultatifs.
- Colonne de fréquence facultative pour les données comportant des lignes répétées.
Méthodes statistiques
L'outil ajuste une régression logistique binaire à un prédicteur comme un modèle linéaire généralisé de loi binomiale, par maximum de vraisemblance (moindres carrés itérativement repondérés). Avec le lien logit, P(événement) = exp(b₀ + b₁x) / (1 + exp(b₀ + b₁x)) ; avec probit, P = Φ(b₀ + b₁x) ; avec log-log complémentaire, P = 1 − exp(−exp(b₀ + b₁x)). Dans le format de données brutes, les lignes dont la réponse est égale à la valeur Event comptent comme des événements et toutes les autres comme des non-événements.
Le tableau d'ANOVA teste le prédicteur par la baisse de la déviance : χ² = déviance nulle − déviance résiduelle, avec 1 degré de liberté. Le Deviance R-Sq est la part de la déviance nulle expliquée. Le tableau des coefficients donne les valeurs z de Wald et les intervalles de confiance b ± z·SE ; le rapport de cotes pour un incrément Δ est exp(b₁·Δ), avec l'intervalle exp(Δ × les limites de b₁). L'aire sous la courbe ROC (Area Under ROC Curve) est la probabilité qu'un événement tiré au hasard ait une probabilité ajustée supérieure à celle d'un non-événement tiré au hasard (0.5 = aucune discrimination, 1 = parfaite).
La bande de confiance autour de la courbe utilise l'erreur-type du prédicteur linéaire, retransformée à l'échelle des probabilités. Dans le tableau des observations inhabituelles, un résidu standardisé au-delà de ±2 est signalé R et un effet de levier supérieur à 3p/n est signalé X. Avec des données brutes, les proportions observées sur le graphique sont les taux d'événements dans un maximum de 10 groupes de même taille le long du prédicteur.
Champs de saisie et options
Champ | Description |
Data format | Binary response (une ligne par observation, par défaut) ou Event/Trial (une ligne par réglage avec un nombre d'événements et un nombre d'essais). |
Response / Event value | Format Binary response : la colonne contenant le résultat, et la valeur qui y compte comme événement (par exemple Yes, Fail, 1). |
Number of events / Number of trials | Format Event/Trial : les colonnes contenant le nombre d'événements et le nombre d'unités testées sur chaque ligne. |
Event name | Libellé facultatif de l'événement, utilisé dans l'équation et sur l'axe du graphique, par exemple Caked. Vide : la valeur Event (format Binary response) ou le nom de la colonne d'événements (format Event/Trial). |
Predictor (continuous) | Prédicteur numérique. Obligatoire. |
Link function | Logit (par défaut), Probit ou Complementary log-log. |
Confidence level | 95 par défaut. |
Type of confidence interval | Two-sided (par défaut), Lower bound ou Upper bound ; s'applique aux coefficients, aux rapports de cotes et à la bande de la courbe. |
Frequency (optional) | Colonne indiquant combien de fois chaque ligne se produit. |
Increment for odds ratio | Variation du prédicteur pour laquelle le rapport de cotes est rapporté. 1 par défaut. Lien logit uniquement. |
Display observed proportions / Display confidence interval | Ajoutent au graphique les proportions d'événements observées et la bande de confiance. Désactivé par défaut. |
Residuals for plots | Résidus Regular ou Deviance pour les graphiques de résidus. |
Histogram of residuals / Normal probability plot of residuals / Residuals versus order / Three in one | Graphiques de résidus ; Three in one trace les trois ensemble. |
Residuals versus the variables | Trace les résidus en fonction d'une colonne choisie. |
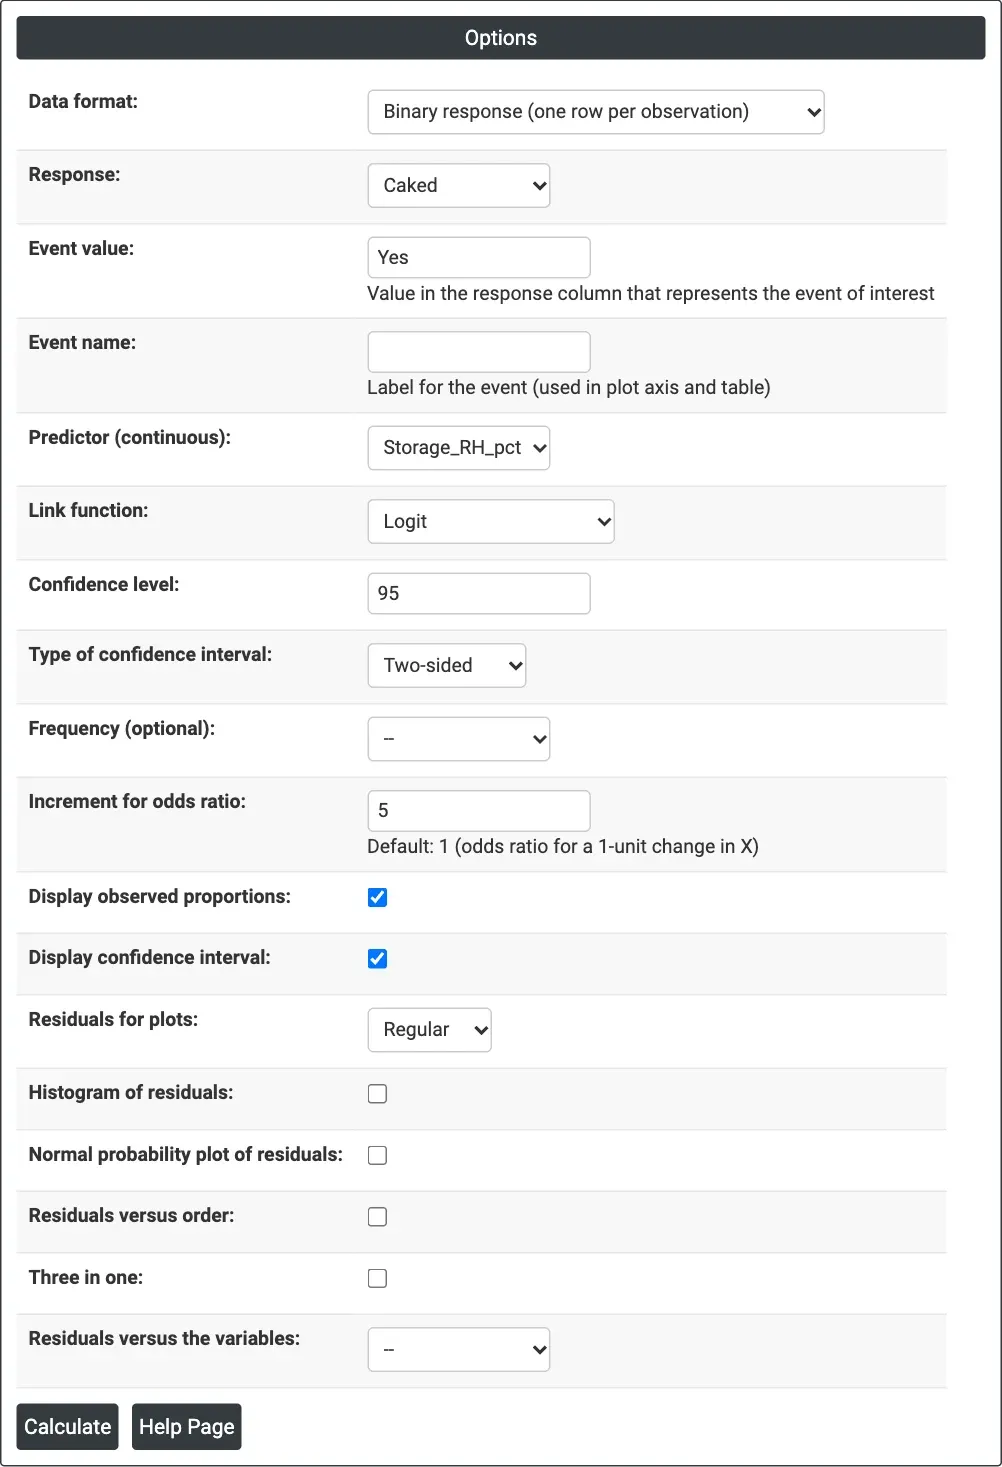
Figure 1 — Options pour l'exemple d'agglomération en sac : Caked comme réponse avec l'événement Yes, Storage_RH_pct comme prédicteur, lien logit, rapport de cotes pour une hausse de 5 points d'humidité.
Description des résultats
- Regression Equation — la probabilité ajustée de l'événement en fonction du prédicteur.
- Analysis of Variance — test de déviance du prédicteur (Adj Dev, Chi-Square, P-Value), avec déviance de l'erreur et totale.
- Model Summary — Deviance R-Sq, Deviance R-Sq(adj), AIC, AICc, BIC et Area Under ROC Curve.
- Coefficients — Coef, SE Coef, Z-Value, P-Value et limites de confiance pour la constante et le prédicteur.
- Odds Ratios for Continuous Predictors (ou Odds Ratios (Increment=Δ)) — lien logit uniquement.
- Binary Fitted Line Plot — courbe de probabilité ajustée, avec les proportions observées et la bande de confiance si la case est cochée.
- Fits and Diagnostics for Unusual Observations — lignes signalées R (résidu élevé) ou X (X inhabituel).
- Graphiques de résidus, s'ils sont sélectionnés.
- Export PDF via Download.
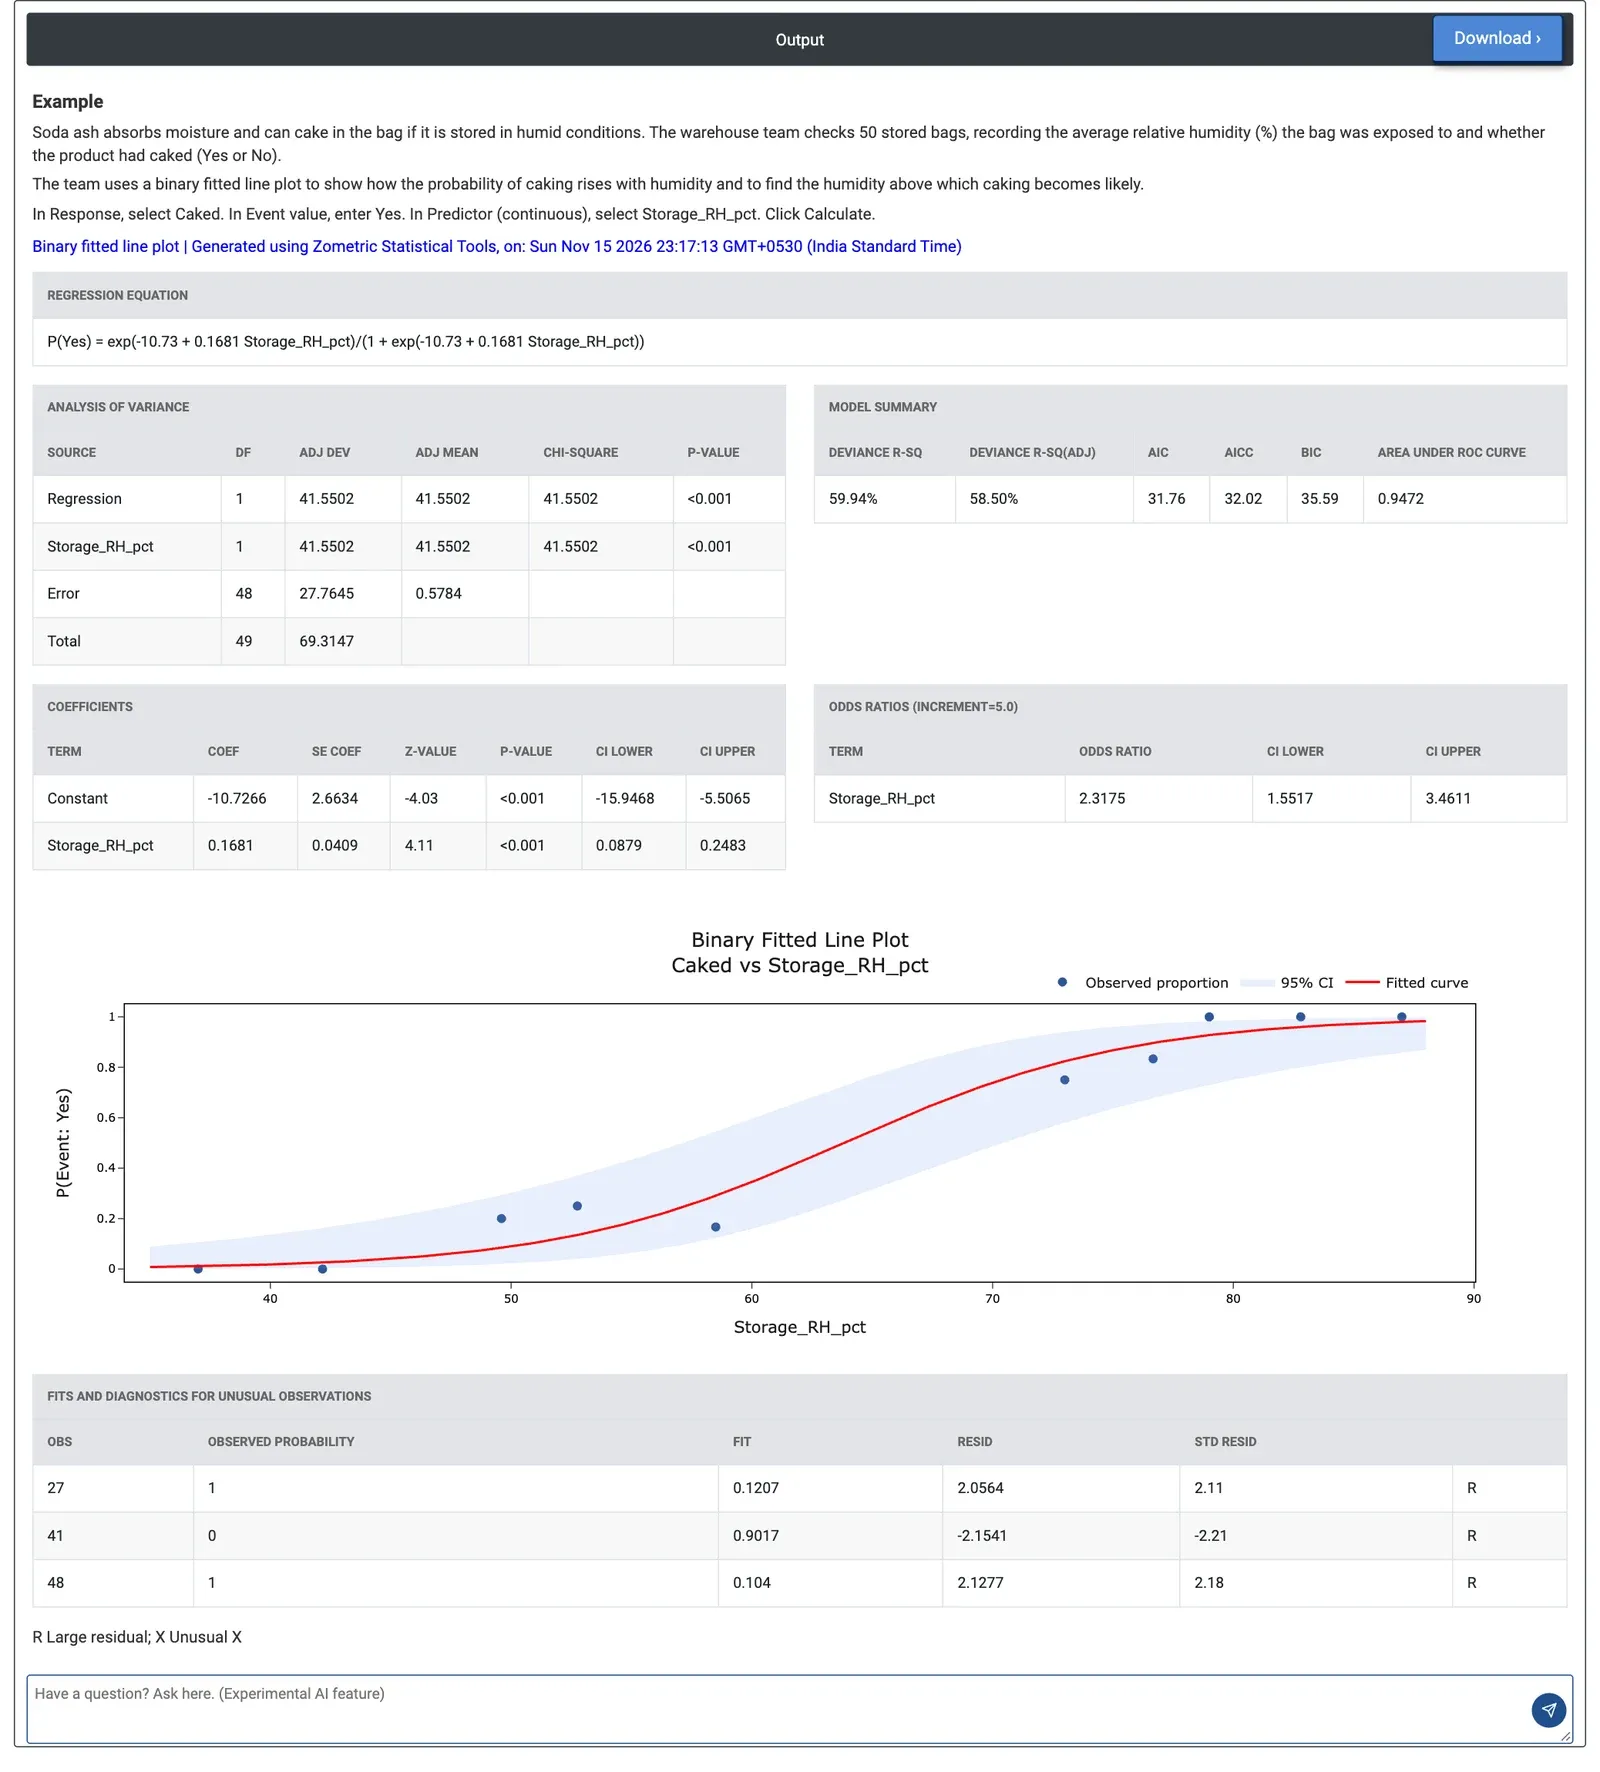
Figure 2 — Droite d'ajustement binaire de la probabilité d'agglomération en fonction de l'humidité de stockage : la courbe passe par 50 % à environ 64 % d'HR.
Exemple résolu
La soude (carbonate de sodium) peut s'agglomérer dans le sac lorsqu'elle est stockée dans des conditions humides. Une équipe d'entrepôt contrôle 50 sacs stockés, en notant l'humidité relative moyenne à laquelle chaque sac a été exposé (Storage_RH_pct, de 35 à 88 %) et si le produit s'était aggloméré (Caked : 25 Yes, 25 No). Elle sélectionne Caked comme réponse avec la valeur d'événement Yes, Storage_RH_pct comme prédicteur, conserve le lien logit, règle l'incrément du rapport de cotes à 5 et coche les deux options d'affichage.
L'humidité a un effet net : le khi-deux de déviance est de 41.55 avec p < 0.001, le Deviance R-Sq est de 59.94 % et l'aire sous la courbe ROC est de 0.9472 ; l'humidité sépare donc bien les sacs agglomérés des sacs sains. L'équation est P(Yes) = exp(−10.73 + 0.1681 RH) / (1 + exp(−10.73 + 0.1681 RH)). Chaque hausse de 5 points d'humidité multiplie les cotes d'agglomération par 2.32 (IC à 95 % de 1.55 à 3.46). D'après l'équation, la probabilité d'agglomération est d'environ 19 % à 55 % d'HR, 50 % à 63.8 % d'HR et 74 % à 70 % d'HR.
Trois sacs sont signalés comme inhabituels : deux agglomérés à de faibles probabilités ajustées (0.12 et 0.10) et un resté sain à 0.90 ; cela mérite de rechercher d'autres causes, comme des doublures endommagées. Pour maintenir le risque d'agglomération sous 10 % environ, la courbe indique un stockage sous 51 % d'HR environ. Le passage au lien probit donne presque le même ajustement (Deviance R-Sq 60.50 %).
Questions fréquentes
Qu'est-ce qu'une droite d'ajustement binaire ?
Une droite d'ajustement binaire modélise comment la probabilité d'un résultat oui/non, comme conforme/non conforme ou aggloméré/non aggloméré, varie avec un prédicteur continu, et trace la courbe en S ajustée sur les données. C'est une régression logistique binaire à un prédicteur, ajustée par maximum de vraisemblance, avec un lien logit, probit ou log-log complémentaire.
Comment interpréter le rapport de cotes dans une droite d'ajustement binaire ?
Avec le lien logit, le rapport de cotes pour un incrément du prédicteur est exp(b1 x incrément). C'est le facteur par lequel les cotes de l'événement sont multipliées pour cette variation. Dans l'exemple, chaque hausse de 5 points de l'humidité de stockage multipliait les cotes d'agglomération par 2.32, avec un intervalle de confiance à 95 % de 1.55 à 3.46.
Comment savoir si le prédicteur a un effet significatif ?
Le tableau d'ANOVA teste le prédicteur par la baisse de la déviance, un khi-deux à 1 degré de liberté ; une petite valeur p indique un effet net. Le Deviance R-Sq indique la part de déviance nulle expliquée, et l'aire sous la courbe ROC indique la discrimination, où 0.5 signifie aucune et 1 parfaite.
Comment réaliser une droite d'ajustement binaire dans Zometric Statistical Software ?
Choisissez le format de données : une colonne de réponse binaire avec une valeur Event, ou des colonnes pour le nombre d'événements et d'essais. Sélectionnez le prédicteur continu et une fonction de lien (logit par défaut), réglez le niveau de confiance et l'incrément du rapport de cotes, et affichez au besoin les proportions observées et la bande de confiance. Les résultats comprennent l'équation, les tableaux et le graphique.