
Régression logistique binaire
La régression logistique binaire prédit la probabilité de l'une de deux issues, comme réussite/échec ou oui/non, à partir de prédicteurs continus, catégoriels ou des deux. Utilisez-la lorsque la réponse a exactement deux catégories ; pour une réponse continue, utilisez Fit Regression Model. Recueillez assez de données dans les deux catégories, évitez la séparation parfaite et validez avec des statistiques d'ajustement et des diagnostics des résidus. Les résultats sont accompagnés d'intervalles de confiance, à 95 % par défaut.
Dernière révision
Point clé
La régression logistique binaire modélise la relation entre un ou plusieurs prédicteurs et une réponse à exactement deux issues, comme conforme/non conforme ou défectueux/non défectueux, et prédit la probabilité de chaque issue.
Sur cette page
Qu'est-ce que la régression logistique binaire ?
La régression logistique binaire est un outil statistique servant à analyser la relation entre une ou plusieurs variables prédictives et une variable de réponse catégorielle à exactement deux issues — comme réussite/échec, oui/non ou défectueux/non défectueux. Elle prédit la probabilité qu'une issue se produise plutôt que l'autre, d'après les valeurs des prédicteurs.
Quand utiliser la régression logistique binaire ?
Variables prédictives
- Les prédicteurs peuvent être continus, catégoriels ou un mélange des deux
- Les variables discrètes peuvent être traitées comme continues ou catégorielles selon le nombre de niveaux et l'objectif de l'analyse
- Un seul prédicteur continu avec une réponse continue → utilisez la droite d'ajustement
- Plusieurs prédicteurs avec une réponse continue → utilisez ajuster un modèle de régression
Variable de réponse
- La réponse doit avoir exactement deux catégories (par ex. réussite/échec, oui/non, bon/mauvais)
- Si la réponse est continue → utilisez ajuster un modèle de régression
- Si la réponse a trois catégories non ordonnées ou plus → utilisez la régression logistique nominale
- Si la réponse a trois catégories ordonnées ou plus → utilisez la régression logistique ordinale
Recommandations pour bien utiliser la régression logistique binaire
- La variable de réponse doit avoir exactement deux catégories; si elle en a davantage, utilisez plutôt la régression logistique ordinale ou nominale.
- Les prédicteurs peuvent être continus ou catégoriels; assurez-vous que chaque variable est correctement classée avant de lancer l'analyse.
- Assurez-vous que les données représentent fidèlement la population cible; des données biaisées ou incomplètes produisent des prédictions peu fiables.
- Recueillez suffisamment de points de données pour les deux catégories — avoir très peu d'observations dans une catégorie rend le modèle instable et les prédictions peu fiables.
- Mesurez toutes les variables le plus précisément possible; les erreurs dans les données d'entrée réduisent directement la précision des probabilités prédites.
- Enregistrez les données dans l'ordre où elles sont recueillies pour aider à repérer d'éventuelles structures temporelles susceptibles d'influencer les résultats.
- Après l'ajustement, validez le modèle à l'aide de statistiques d'ajustement et de diagnostics des résidus; un modèle mal ajusté produit des prédictions trompeuses.
- Évitez la séparation parfaite — lorsqu'un prédicteur sépare complètement les deux catégories — car elle pose des problèmes d'estimation dans le modèle.
Alternatives : quand ne pas utiliser la régression logistique binaire
- Si la variable de réponse est continue, utilisez plutôt ajuster un modèle de régression .
- Si vous n'avez qu' un seul prédicteur continu avec une réponse continue, utilisez plutôt la droite d'ajustement .
- Si la réponse a trois catégories non ordonnées ou plus, utilisez plutôt la régression logistique nominale .
- Si la réponse a trois catégories ordonnées ou plus, utilisez plutôt la régression logistique ordinale .
- Si vous avez un seul prédicteur catégoriel avec une réponse continue, utilisez plutôt l' ANOVA à un facteur .
Comment réaliser une régression logistique binaire
La marche à suivre est la suivante :
- Connectez-vous à Zometric Statistical Software à l'adresse https://statsai.zometric.com/
- Sur la page d'accueil, choisissez Statistical Tool>Regression >Binary Logistic Regression .
- Cliquez sur Binary Logistic Regression pour accéder au tableau de bord.
- Ensuite, saisissez les données manuellement, ou copiez (Ctrl+C) l'ensemble des données d'une feuille Excel et collez-les (Ctrl+V) ici.
- Renseignez les options requises à gauche.
- Enfin, cliquez sur calculate en bas de la page pour obtenir les résultats.
Dans le tableau de bord de la régression logistique binaire, la fenêtre est divisée en deux parties.
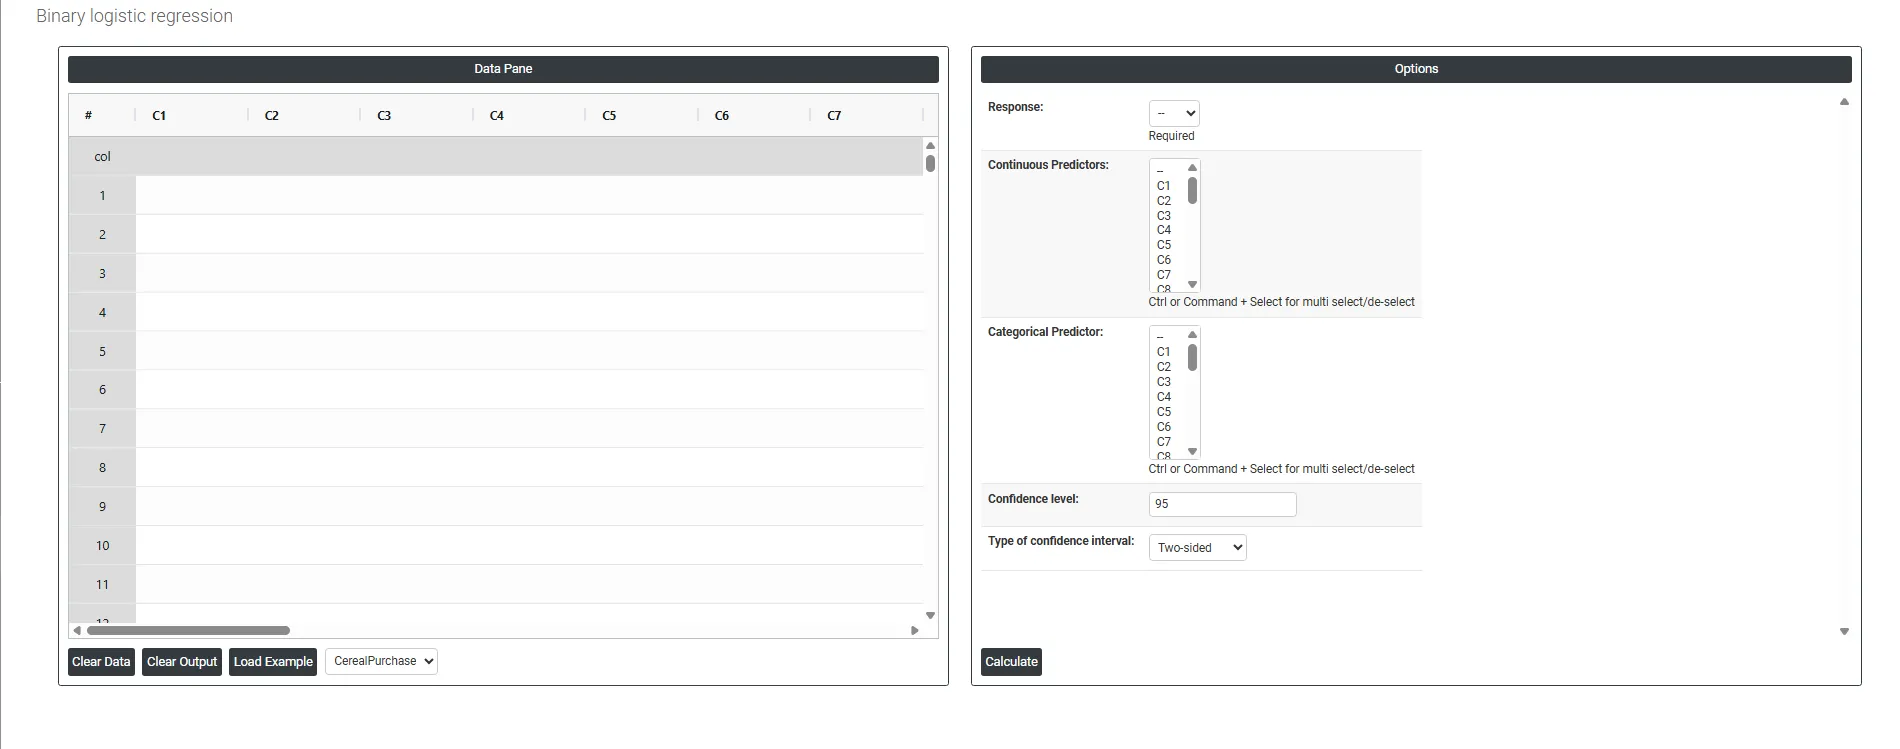
La partie gauche contient le Data Pane (volet de données). Dans le Data Pane, chaque ligne constitue un sous-groupe. Les données peuvent être saisies manuellement, ou vous pouvez copier (Ctrl+C) l'ensemble des données d'une feuille Excel et les coller (Ctrl+V) ici.
Load example : des données d'exemple sont chargées.
Load File : permet de charger directement les données Excel.
La partie droite contient de nombreuses options, décrites ci-dessous :
- Response : la variable de résultat que vous cherchez à prédire ; elle doit contenir exactement deux catégories, comme réussite/échec, oui/non ou défectueux/non défectueux. Le modèle calcule la probabilité qu'une catégorie se produise plutôt que l'autre, d'après les valeurs de prédicteurs saisies.
- Categorical Predictor : une variable prédictive qui contient un ensemble fixe de groupes ou d'étiquettes distincts, comme l'équipe, le type de machine ou le fournisseur. Le modèle estime comment l'appartenance à chaque groupe modifie la probabilité que la réponse tombe dans une catégorie plutôt que dans l'autre.
- Continuous Predictor : une variable prédictive qui contient des valeurs numériques mesurables, comme la température, la vitesse ou la masse. Le modèle estime comment une augmentation d'une unité de cette variable accroît ou réduit la probabilité que l'issue de la réponse se produise.
- Confidence Interval : une plage de valeurs dans laquelle le vrai résultat a de fortes chances de se situer. La valeur par défaut est 95%, ce qui signifie que vous êtes confiant à 95 % que la vraie probabilité ou le vrai coefficient se situe dans cette plage. Elle est fixée à 95 % par défaut car c'est la norme largement admise qui concilie fiabilité statistique et facilité d'emploi — assez étroite pour être utile, assez large pour tenir compte de l'incertitude.
- Type of Confidence Interval
- Two-Sided — fournit une borne inférieure et une borne supérieure, indiquant la plage où la vraie valeur a de fortes chances de se situer des deux côtés. Utilisez-la lorsque vous voulez détecter toute différence, au-dessus comme au-dessous. C'est l'option par défaut et la plus courante.
- Upper Bound — fournit uniquement la limite maximale, indiquant la valeur la plus élevée que le vrai résultat est susceptible d'atteindre. Utilisez-la lorsque seul vous importe de savoir si la valeur dépasse un certain seuil.
- Lower Bound — fournit uniquement la limite minimale, indiquant la valeur la plus basse que le vrai résultat est susceptible de prendre. Utilisez-la lorsque seul vous importe de savoir si la valeur tombe sous un certain seuil.
Questions fréquentes
Qu'est-ce que la régression logistique binaire ?
La régression logistique binaire analyse la relation entre une ou plusieurs variables prédictives et une réponse catégorielle à exactement deux issues, comme réussite/échec, oui/non ou défectueux/non défectueux. Elle prédit la probabilité qu'une issue se produise plutôt que l'autre d'après les valeurs des prédicteurs. Les prédicteurs peuvent être continus, catégoriels ou un mélange des deux.
Quand utiliser la régression logistique binaire plutôt que d'autres méthodes de régression ?
Utilisez-la lorsque la réponse a exactement deux catégories. Si la réponse est continue, utilisez Fit Regression Model, ou Fit Line Model pour un seul prédicteur continu. Si la réponse a trois catégories non ordonnées ou plus, utilisez la régression logistique nominale ; pour trois catégories ordonnées ou plus, utilisez la régression logistique ordinale.
Quelles sont les conditions d'une régression logistique binaire fiable ?
Recueillez assez de points de données dans les deux catégories de la réponse, car très peu d'observations dans une catégorie rendent le modèle instable. Classez correctement chaque prédicteur comme continu ou catégoriel, utilisez des données représentatives et mesurées avec précision, et évitez la séparation parfaite, où un prédicteur sépare complètement les deux catégories, car elle pose des problèmes d'estimation. Validez le modèle avec des statistiques d'ajustement et des diagnostics des résidus.
Comment réaliser une régression logistique binaire dans Zometric Statistical Software ?
Choisissez Statistical Tool > Regression > Binary Logistic Regression, puis saisissez, collez ou chargez les données. Sélectionnez la Response à deux catégories, les colonnes Categorical Predictor et Continuous Predictor, définissez le niveau de l'intervalle de confiance (95 % par défaut) et le type d'intervalle de confiance (bilatéral, borne supérieure ou borne inférieure), puis cliquez sur Calculate.