
Test d'indépendance du khi-deux (tableau croisé)
Le test d'indépendance du khi-deux vérifie si deux variables catégorielles sont associées, à partir d'un tableau de contingence résumé ou d'enregistrements bruts. Il compare les effectifs observés aux effectifs attendus sous indépendance avec le khi-deux de Pearson et du rapport de vraisemblance sur (r − 1)(c − 1) degrés de liberté. Les contributions et les résidus ajustés montrent quelles cellules portent le résultat. Les effectifs attendus ne doivent pas être trop faibles.
Dernière révision
Point clé
Le test d'indépendance du khi-deux vérifie si deux variables catégorielles sont liées, par exemple si la répartition des types de défauts dépend de l'équipe, du fournisseur ou de la ligne, et montre quelles cellules portent l'association.
Sur cette page
Objectif
Le Chi-Square Test of Independence vérifie si deux variables catégorielles sont liées, par exemple si la répartition des types de défauts dépend de l'équipe, du fournisseur ou de la ligne. Saisissez un tableau d'effectifs déjà résumé, ou les enregistrements bruts avec une ligne par unité, et l'outil teste l'association et montre quelles cellules la portent.
Principales fonctionnalités
- Tableau de contingence résumé (une colonne par catégorie de colonne, une ligne par catégorie de ligne) ou données catégorielles brutes avec fréquences facultatives.
- Tests du khi-deux de Pearson et du rapport de vraisemblance.
- Tableaux facultatifs des effectifs attendus, des contributions au khi-deux, des résidus bruts, standardisés et ajustés, et des pourcentages par ligne, par colonne et du total.
- Interprétation guidée facultative : rapport de synthèse avec profils en pourcentage et graphiques des écarts en %, rapport de diagnostic et bulletin d'évaluation.
- Data Options : sélection d'un sous-ensemble de lignes avant l'analyse.
Méthodes statistiques
Pour un tableau r × c d'effectifs observés O avec totaux de lignes Rᵢ, totaux de colonnes Cⱼ et total général N, l'effectif attendu sous indépendance est Eᵢⱼ = Rᵢ·Cⱼ / N. La statistique de Pearson est χ² = Σ (O − E)² / E, et la statistique du rapport de vraisemblance est G² = 2 Σ O·ln(O / E). Toutes deux sont comparées à une distribution du khi-deux à (r − 1)(c − 1) degrés de liberté. Une petite valeur p signifie que les variables en ligne et en colonne sont associées : la répartition en colonnes n'est pas la même dans chaque ligne.
La contribution de chaque cellule (O − E)² / E montre d'où vient l'association. Le résidu brut est O − E, le résidu standardisé (O − E) / √E, et le résidu ajusté (O − E) / √(E(1 − Rᵢ/N)(1 − Cⱼ/N)), qui suit approximativement une loi normale centrée réduite : les valeurs au-delà d'environ ±2 désignent les cellules qui s'écartent nettement de l'indépendance. Avec des données brutes, l'outil croise d'abord les deux colonnes, en additionnant la colonne de fréquences si elle est fournie ; les cellules vides sont exclues. Une ligne ou une colonne dont le total est nul doit être supprimée. La valeur p est fiable lorsque les effectifs attendus ne sont pas trop faibles ; l'interprétation guidée le vérifie.
Champs de saisie et options
Champ | Description |
Data | Summarized data in a two-way table (par défaut) ou Raw data (categorical variables). |
Columns (one per column-category) | Disposition en tableau : deux colonnes numériques ou plus, chacune contenant les effectifs d'une catégorie de la variable en colonne, une ligne par catégorie de ligne. Obligatoire. |
Row labels | Disposition en tableau, facultatif : une colonne nommant chaque catégorie de ligne ; si elle est vide, on obtient Row 1, Row 2, … |
Rows / Columns / Frequencies (optional) | Disposition brute : les deux colonnes catégorielles, et une colonne facultative d'effectifs pour chaque enregistrement. |
Statistics | Expected cell counts et Each cell's contribution to chi-square (cochées par défaut) ; Raw residuals, Standardized residuals, Adjusted residuals, Row percents, Column percents, Total percents. |
Data Options: Subset (optional) | Exclude matching rows (par défaut) ou Include only matching rows, selon les numéros de ligne et/ou une condition. |
Show guided interpretation | Ajoute une synthèse (Summary), un diagnostic (Diagnostic) et un bulletin d'évaluation (Report Card) en langage clair ; Difference between the % defectives with practical value est une saisie facultative pour cette option. |
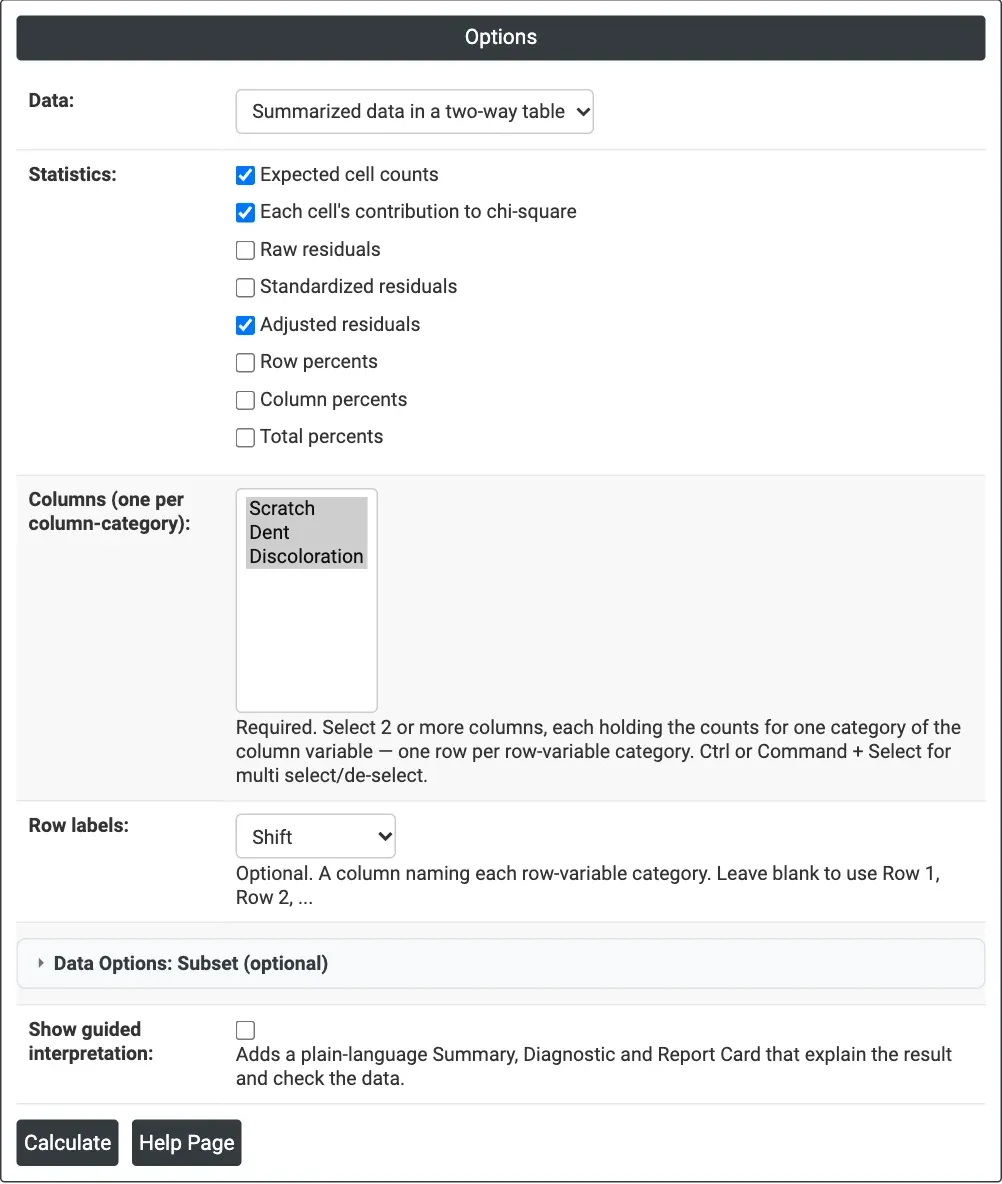
Figure 1 — Options pour l'exemple des types de défauts : un tableau résumé avec les effectifs Scratch, Dent et Discoloration en colonnes et Shift en étiquettes de lignes, résidus ajustés cochés.
Description des résultats
- Observed Counts — le tableau avec les totaux de lignes et de colonnes (All).
- Expected Counts et Contribution to Chi-Square — lorsqu'ils sont cochés.
- Chi-Square Tests — Chi-Sq, DF et P-Value des tests de Pearson et du rapport de vraisemblance.
- Raw Residuals, Standardized Residuals, Adjusted Residuals, Row Percents, Column Percents et Total Percents — lorsqu'ils sont cochés.
- Summary Report, Diagnostic Report et Report Card — avec l'interprétation guidée.
- Export PDF via Download.
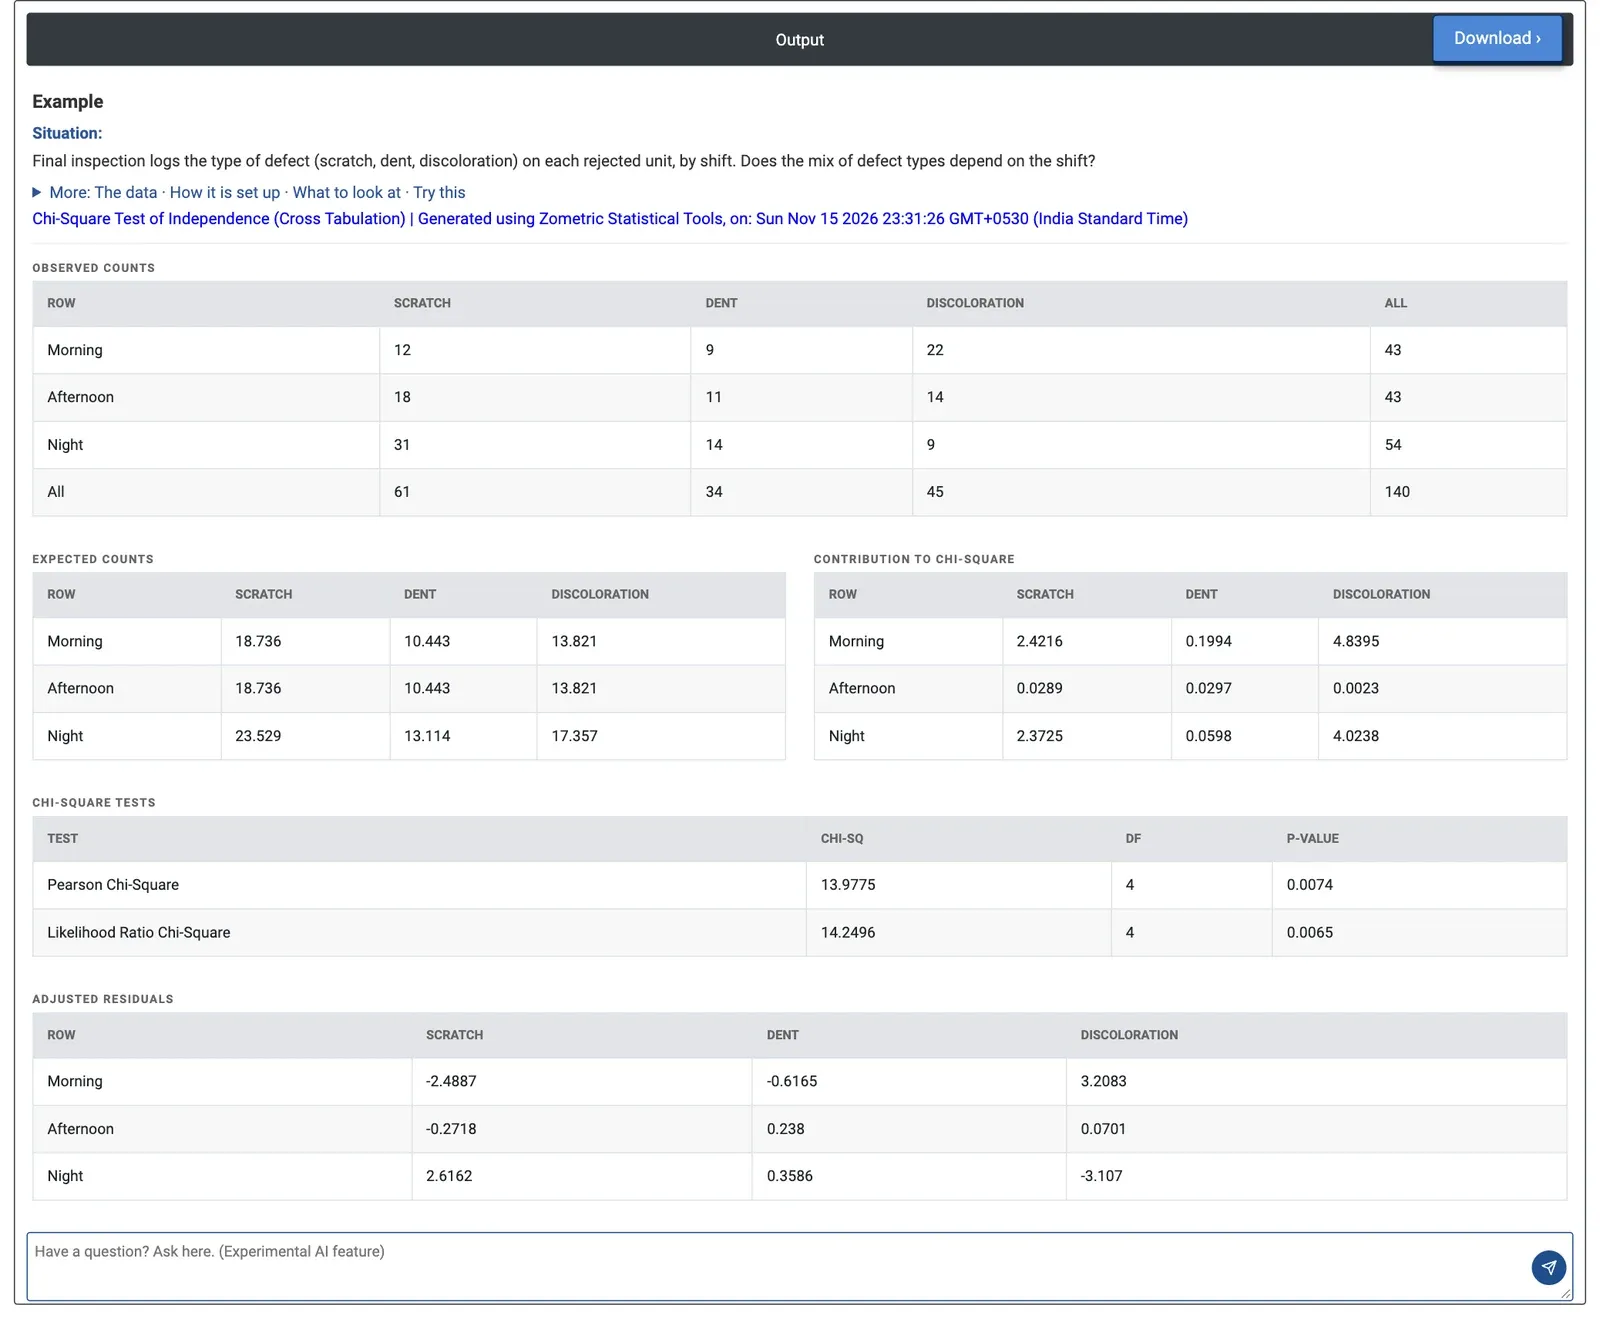
Figure 2 — Type de défaut par équipe : khi-deux de Pearson 13.98 à 4 DF, p = 0.0074 ; les résidus ajustés pointent la décoloration en équipe du matin et les rayures en équipe de nuit.
Exemple résolu
Le contrôle final enregistre le type de défaut de chaque unité rejetée, par équipe : 140 rebuts au total. L'équipe qualité veut savoir si la répartition des types de défauts dépend de l'équipe. Elle saisit les effectifs sous forme de tableau avec une colonne par type de défaut (Scratch, Dent, Discoloration) et Shift en étiquettes de lignes, et coche Adjusted residuals en plus des statistiques par défaut.
La répartition des défauts dépend bien de l'équipe : khi-deux de Pearson 13.98 à 4 DF, p = 0.0074 (rapport de vraisemblance 14.25, p = 0.0065). Les contributions montrent où : la décoloration en équipe du matin (4.84 ; 22 observés pour 13.8 attendus) et en équipe de nuit (4.02 ; 9 pour 17.4), puis les rayures en équipe du matin (2.42 ; 12 pour 18.7) et de nuit (2.37 ; 31 pour 23.5). L'équipe de l'après-midi correspond à la répartition globale, et les bosses sont réparties uniformément.
Les résidus ajustés le confirment : 3.21 pour la décoloration du matin et 2.62 pour les rayures de nuit sont bien au-delà de 2. L'équipe examine ce qui change au début de la journée (par exemple la montée en température ou un autre lot de peinture) pour la décoloration, et la manutention et l'éclairage en équipe de nuit pour les rayures. Tous les effectifs attendus sont supérieurs à 10, la valeur p est donc fiable.
Questions fréquentes
Comment l'effectif attendu est-il calculé dans un test d'indépendance du khi-deux ?
Sous indépendance, l'effectif attendu d'une cellule est son total de ligne multiplié par son total de colonne et divisé par le total général, E = R x C / N. La statistique de Pearson additionne (O − E)² / E sur toutes les cellules et est comparée à une distribution du khi-deux à (r − 1)(c − 1) degrés de liberté, où r et c sont les nombres de lignes et de colonnes.
Comment interpréter un test d'indépendance du khi-deux ?
Une petite valeur p signifie que les variables en ligne et en colonne sont associées : la répartition en colonnes n'est pas la même dans chaque ligne. Pour voir d'où vient l'association, examinez la contribution de chaque cellule (O − E)² / E et les résidus ajustés, qui suivent approximativement une loi normale centrée réduite ; les valeurs au-delà d'environ ±2 désignent les cellules qui s'écartent nettement de l'indépendance.
Quel format de données le test exige-t-il ?
Dans Zometric Statistical Software, vous pouvez saisir un tableau de contingence résumé, avec une colonne numérique par catégorie de colonne et une ligne par catégorie de ligne, ou des données brutes avec deux colonnes catégorielles et une colonne de fréquences facultative. Avec des données brutes, l'outil croise d'abord les deux colonnes. Une ligne ou une colonne dont le total est nul doit être supprimée.
Quand la valeur p du test du khi-deux est-elle fiable ?
La valeur p est fiable lorsque les effectifs attendus ne sont pas trop faibles, et l'interprétation guidée facultative le vérifie. Dans l'exemple résolu du type de défaut par équipe, tous les effectifs attendus étaient supérieurs à 10 ; la valeur p de Pearson de 0.0074 à 4 degrés de liberté était donc fiable.