
Classification par les K-moyennes (Cluster K-Means)
Cluster K-Means regroupe des observations sur au moins deux variables numériques en K classes que vous fixez, avec la méthode de Lloyd, des centres initiaux k-means++ et plusieurs départs aléatoires. Standardisez les variables mesurées dans des unités différentes. Utilisez-la lorsque vous attendez un nombre connu de groupes. Les résultats incluent la partition finale, les centroïdes, la classe et la distance de chaque observation, et le pourcentage de variation expliquée.
Dernière révision
Point clé
La classification par les K-moyennes répartit les observations en un nombre fixé de groupes (K), aussi semblables que possible sur les variables choisies, par exemple pour trier des lots, pièces ou fournisseurs en types.
Sur cette page
Objectif
Cluster K-Means répartit les observations en un nombre fixé de groupes (K) de sorte que les observations de chaque groupe soient aussi semblables que possible sur les variables que vous choisissez. Utilisez-la lorsque vous attendez un nombre connu de groupes, par exemple pour trier des lots de matière, des pièces ou des fournisseurs en types à partir de plusieurs propriétés mesurées, ou pour vérifier si une étiquette que vous utilisez déjà (qualité, ligne, équipe) apparaît dans les mesures.
Principales fonctionnalités
- Regroupe les observations sur au moins deux variables numériques en K classes que vous fixez.
- Standardisation facultative, pour qu'une variable mesurée dans de grandes unités ne domine pas le regroupement.
- Plusieurs points de départ aléatoires ; la meilleure solution (plus faible dispersion intra-classe) est conservée, et les mêmes données donnent toujours le même résultat.
- Fournit la partition finale (effectif, somme des carrés intra-classe, distance moyenne et maximale au centroïde), le centroïde de chaque classe dans les unités d'origine, la classe de chaque observation et le pourcentage de la variation totale expliquée par les classes.
- Nuage de points des deux premières variables sélectionnées, coloré par classe.
Méthodes statistiques
Les lignes avec une valeur manquante ou non numérique dans l'une des variables sélectionnées sont exclues. Lorsque Standardize variables est cochée, chaque variable est convertie en z = (x − moyenne) / s, avec s l'écart-type de l'échantillon, de sorte que chaque variable ait une moyenne de 0 et un écart-type de 1 avant la classification.
L'algorithme des K-moyennes (méthode de Lloyd) affecte chaque observation au centre de classe le plus proche selon la distance euclidienne, recalcule chaque centre comme la moyenne de ses membres, et répète jusqu'à ce que les affectations ne changent plus. Les centres initiaux sont choisis avec la règle k-means++. Comme le résultat peut dépendre du départ, l'algorithme est exécuté autant de fois que Number of random starts et l'exécution ayant la plus petite somme des carrés intra-classe est conservée. Une graine aléatoire fixe est utilisée, de sorte que les résultats se répètent exactement.
Le pourcentage de variation expliquée par les classes est (SC totale − SC intra-classe) / SC totale × 100, où la SC totale est la somme des carrés des distances de toutes les observations à la moyenne générale et la SC intra-classe est la somme des carrés des distances de chaque observation au centre de sa propre classe. Les deux sont mesurées sur les données telles que classées (standardisées lorsque cette option est cochée). Une valeur plus élevée signifie des groupes plus distincts et plus compacts, mais elle augmente toujours avec K ; comparez-la donc avec prudence entre différentes valeurs de K. Les centroïdes sont reconvertis dans les unités d'origine pour la présentation. La partition finale donne, pour chaque classe, le nombre d'observations, la somme des carrés intra-classe, ainsi que la distance moyenne et maximale de ses membres au centroïde ; ces distances, et la distance de chaque observation dans le tableau d'appartenance, sont des distances euclidiennes dans les unités de la classification (standardisées lorsque cette option est cochée), comme dans Minitab.
Champs de saisie et options
Champ | Description |
Variables | Deux colonnes numériques ou plus sur lesquelles classer. Ctrl ou Command + clic pour en sélectionner plusieurs. |
Number of clusters (K) | Nombre de groupes à former. Par défaut 3 ; minimum 2. Il faut au moins K observations complètes. |
Standardize variables | Cochée par défaut. Place chaque variable sur la même échelle (moyenne 0, écart-type 1) avant la classification. Ne la décochez que si toutes les variables ont les mêmes unités et que vous voulez que les variables de plus grande dispersion pèsent davantage. |
Number of random starts | Nombre de points de départ à essayer ; le meilleur résultat est conservé. Par défaut 10, de 1 à 100. |
Title | Titre affiché sur le graphique et les résultats. Par défaut Cluster K-Means. |
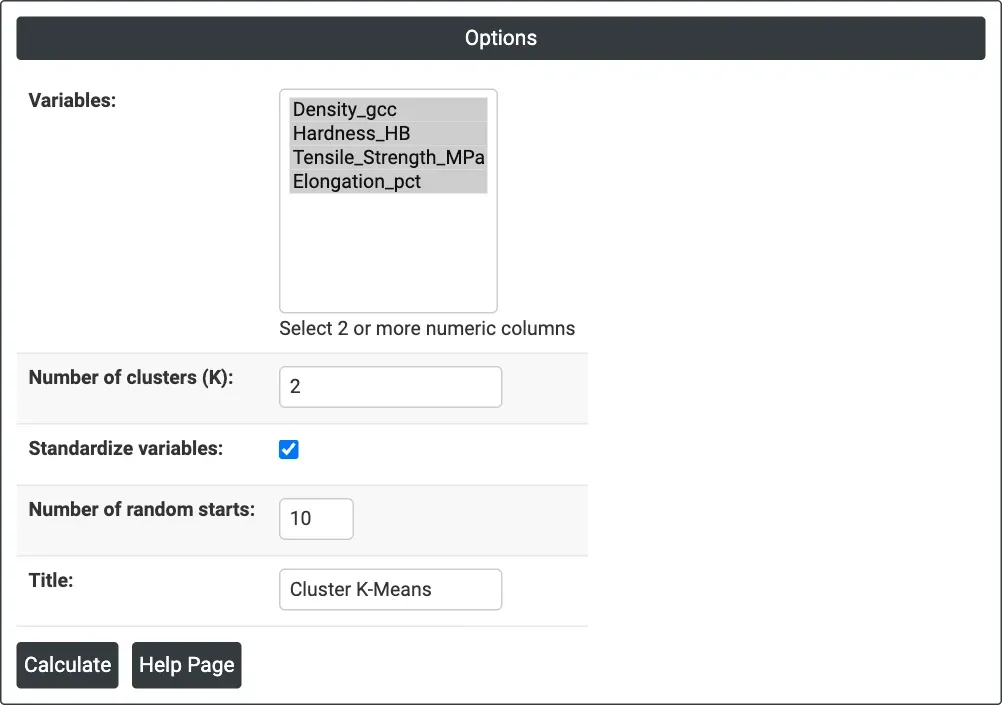
Figure 1 — Options pour l'exemple : les quatre colonnes de propriétés, K = 2, standardisation, 10 départs aléatoires.
Description des résultats
- Cluster K-Means plot : nuage de points de la première variable sélectionnée (x) en fonction de la deuxième (y), chaque point étant coloré selon sa classe.
- % variation explained by clusters : part de la variation totale située entre les classes plutôt qu'à l'intérieur de celles-ci.
- Final Partition : pour chaque classe, Number of observations, Within cluster sum of squares, Average distance from centroid et Maximum distance from centroid.
- Cluster Centroids : pour chaque classe, son nombre N d'observations et la moyenne de chaque variable dans les unités d'origine.
- Cluster Membership : chaque observation (par ligne de la feuille), sa classe et sa distance au centroïde de cette classe.
- Export PDF via Download.
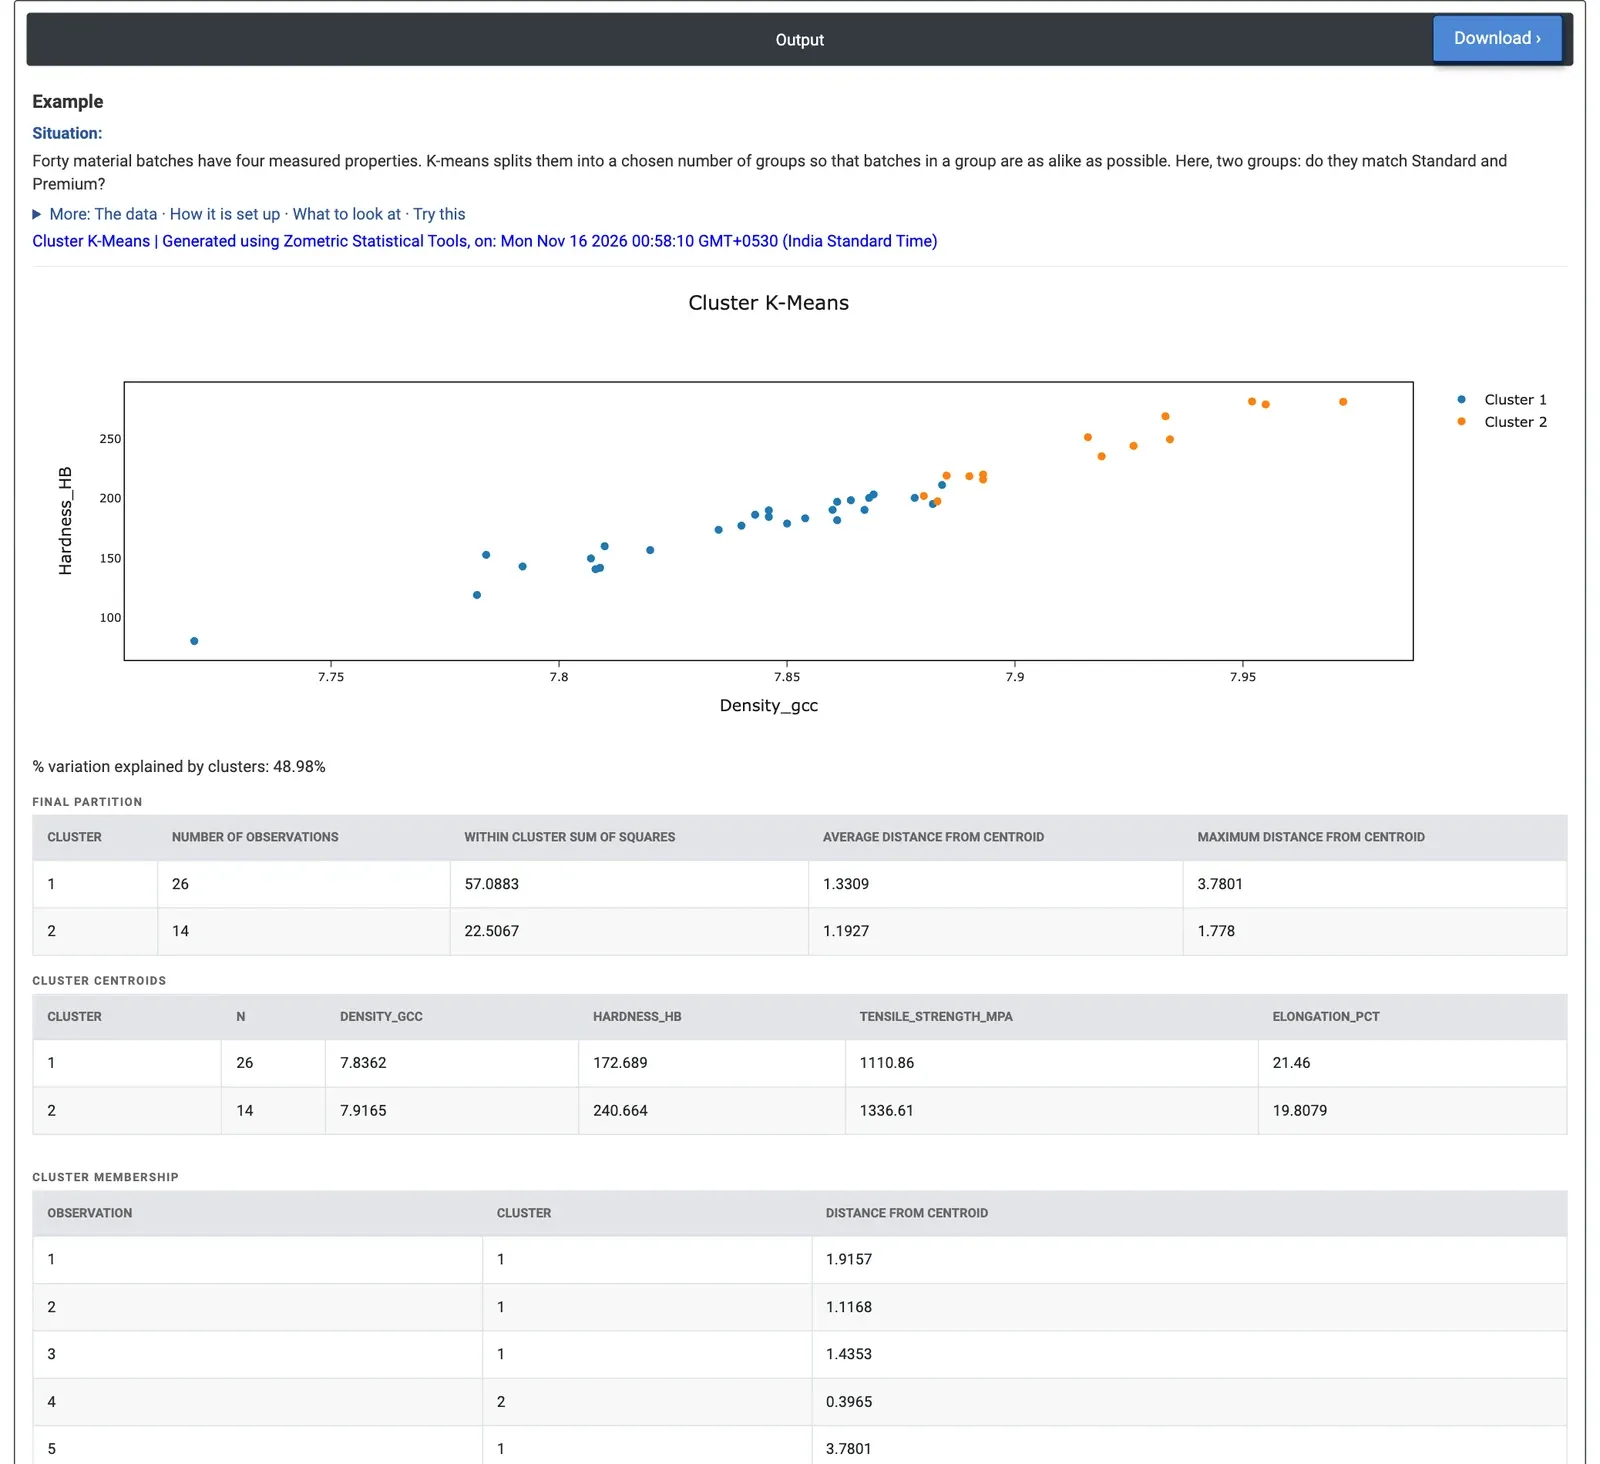
Figure 2 — Deux classes de 40 lots de matière : la classe 2 (14 lots) est plus dure et plus résistante ; les classes expliquent 48.98% de la variation. La partition finale, les centroïdes et le début du tableau d'appartenance suivent le graphique.
Exemple résolu
Un laboratoire de matériaux dispose de 40 lots, chacun mesuré pour la masse volumique (g/cc), la dureté (HB), la résistance à la traction (MPa) et l'allongement (%). Les lots sont vendus en Standard ou Premium, 20 de chaque. Le laboratoire veut savoir si les mesures seules se répartissent en deux groupes naturels, et si ces groupes correspondent au type de lot. Il sélectionne les quatre colonnes de propriétés, définit Number of clusters (K) = 2, laisse Standardize variables cochée (la résistance à la traction, de l'ordre de centaines, dominerait sinon) et conserve 10 départs aléatoires.
Les classes expliquent 48.98% de la variation. La classe 2 contient 14 lots plus durs et plus résistants (moyennes de 240.7 HB et 1,336.6 MPa) et un peu moins ductiles (19.8% d'allongement) ; la classe 1 contient 26 lots avec des moyennes de 172.7 HB, 1,110.9 MPa et 21.5% d'allongement. Les centroïdes de masse volumique ne diffèrent que légèrement (7.92 contre 7.84 g/cc). Dans la partition finale, la classe 2 est le groupe le plus compact (distance moyenne au centroïde de 1.19 contre 1.33 unité standardisée) ; le membre le plus éloigné de la classe 1, la ligne 5, est à 3.78 unités de son centroïde, un lot inhabituel à vérifier. En comparant avec la colonne du type de lot, la classe 2 contient 11 lots Premium et 3 lots Standard, et la classe 1 contient 17 lots Standard et 9 Premium ; 28 lots sur 40 se trouvent donc dans la classe qui correspond à leur type.
Pour le laboratoire, cela signifie que les lots les plus résistants forment un groupe net, mais que de nombreux lots Premium ne sont ni plus durs ni plus résistants que les Standard : l'étiquette n'est pas entièrement confirmée par les propriétés. Avec K = 3, la variation expliquée passe à 69.66% et un groupe faible et mou de 9 lots (138.2 HB, 995.9 MPa) se sépare d'un groupe intermédiaire de 23 lots et d'un groupe supérieur de 8 lots. Décocher Standardize variables modifie la répartition en 19 et 21 lots, car la résistance à la traction pèse alors le plus. Pour construire une règle qui utilise les types connus, exécutez l'analyse discriminante (Discriminant Analysis) sur les mêmes données.
Questions fréquentes
Quand utiliser la classification par les K-moyennes ?
Utilisez-la lorsque vous attendez un nombre connu de groupes et voulez trier des observations, comme des lots de matière, des pièces ou des fournisseurs, en types à partir de plusieurs propriétés mesurées. Elle sert aussi à vérifier si une étiquette que vous utilisez déjà, comme la qualité, la ligne ou l'équipe, apparaît réellement dans les mesures.
Faut-il standardiser les variables avant les K-moyennes ?
La standardisation convertit chaque variable en moyenne 0 et écart-type 1, de sorte qu'une variable mesurée dans de grandes unités ne domine pas le regroupement. Elle est cochée par défaut. Ne la décochez que si toutes les variables ont les mêmes unités et que vous voulez que les variables de plus grande dispersion pèsent davantage ; dans l'exemple résolu, la décocher a modifié la répartition car la résistance à la traction pesait alors le plus.
Comment choisir le nombre de classes K ?
Les résultats indiquent le pourcentage de la variation totale expliquée par les classes ; une valeur plus élevée signifie des groupes plus distincts et plus compacts. Elle augmente toujours avec K ; comparez-la donc avec prudence entre différentes valeurs de K. Dans l'exemple, deux classes expliquaient 48.98% de la variation et trois classes 69.66%, avec un groupe faible et mou de 9 lots qui se séparait.
Quelle est la différence entre les K-moyennes et l'analyse discriminante ?
Les K-moyennes trouvent des groupes à partir des seules mesures, sans utiliser d'étiquettes connues. Dans l'exemple, les deux classes ne correspondaient à l'étiquette Standard ou Premium que pour 28 lots sur 40. Pour construire une règle qui utilise les types connus afin de séparer les groupes, exécutez l'analyse discriminante (Discriminant Analysis) sur les mêmes données.