
Classification des variables (Cluster Variables)
Cluster Variables applique une classification hiérarchique à trois variables numériques ou plus, selon la corrélation, la corrélation absolue ou la distance euclidienne et l'une des sept méthodes de liaison. Les variables qui évoluent ensemble sont réunies en premier, ce que montre un dendrogramme. Utilisez-le pour raccourcir une longue liste de mesures ou de questions d'enquête. Au moins 3 lignes complètes sont nécessaires. Saisir un nombre de groupes attribue un groupe à chaque variable.
Dernière révision
Point clé
Cluster Variables regroupe les variables (colonnes) porteuses d'informations similaires, en réunissant celles qui montent et descendent ensemble, pour ramener une longue liste de mesures ou de questions d'enquête à une variable par groupe.
Sur cette page
Objectif
Cluster Variables regroupe les variables (colonnes) porteuses d'informations similaires. Les variables qui montent et descendent ensemble d'une observation à l'autre sont réunies en premier, et le résultat est tracé sous forme de dendrogramme. Utilisez-le pour réduire une longue liste de mesures ou de questions d'enquête : lorsque plusieurs variables se trouvent dans le même groupe, vous pouvez suivre l'une d'elles, ou un score combiné, au lieu de toutes.
Principales fonctionnalités
- Classification hiérarchique de trois variables numériques ou plus.
- Distance fondée sur la corrélation, la corrélation absolue ou la distance euclidienne.
- Sept méthodes de liaison : Single, Complete, Average, Centroid, Median, McQuitty et Ward.
- Dendrogramme montrant l'ordre et le niveau auxquels les variables se réunissent.
- Attribution facultative d'un groupe à chaque variable lorsque vous indiquez un nombre de groupes.
Méthodes statistiques
Les lignes comportant une valeur manquante ou non numérique dans l'une des variables sélectionnées sont écartées ; au moins 3 variables et 3 lignes complètes sont nécessaires. Chaque variable est traitée comme un point dont les coordonnées sont ses valeurs sur les lignes, et la distance entre chaque paire de variables est calculée avec la mesure choisie. La distance de corrélation vaut 1 − r, où r est le coefficient de corrélation de Pearson entre les deux variables : 0 pour une corrélation positive parfaite et 2 pour une corrélation négative parfaite. La distance de corrélation absolue (Absolute Correlation) vaut 1 − |r|, ce qui traite une forte relation négative comme aussi proche qu'une forte relation positive. La distance euclidienne vaut √Σ(xᵢ − yᵢ)² sur les valeurs brutes ; elle dépend donc des unités de chaque variable.
La classification commence avec chaque variable isolée et fusionne de façon répétée les deux groupes les plus proches. La méthode de liaison fixe la distance entre groupes : Single utilise la paire la plus proche, Complete la paire la plus éloignée, Average la moyenne de toutes les distances entre paires, McQuitty une moyenne pondérée, Centroid et Median la distance entre les centres des groupes, et Ward la plus faible augmentation de la somme des carrés intra-groupe. Ward, Centroid et Median exigent la distance euclidienne ; l'outil refuse les autres combinaisons.
Avec la distance de corrélation, une jonction à la hauteur h signifie que les variables des deux branches ont une corrélation moyenne d'environ 1 − h. Lorsque Number of clusters est saisi, l'arbre est coupé de façon à donner ce nombre de groupes et chaque variable est étiquetée avec son groupe.
Champs de saisie et options
Champ | Description |
Variables | Trois colonnes numériques ou plus à regrouper. Ctrl ou Commande + clic pour en sélectionner plusieurs. |
Linkage method | Façon de mesurer la distance entre groupes : Single, Complete, Average (par défaut), Centroid, Median, McQuitty ou Ward. |
Distance measure | Correlation (par défaut), Absolute Correlation ou Euclidean. |
Number of clusters | Facultatif, 2 ou plus. Coupe l'arbre en ce nombre de groupes et ajoute le tableau Cluster Assignments. Laissez vide pour n'afficher que le dendrogramme. |
Title | Titre affiché sur le dendrogramme. Cluster Variables par défaut. |
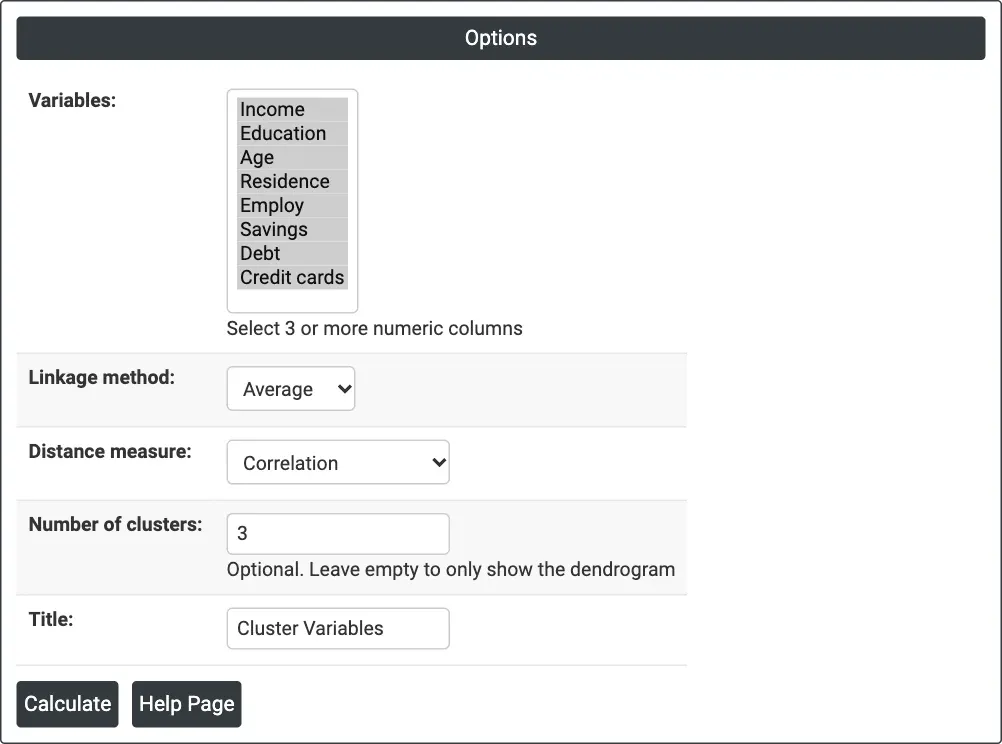
Figure 1 — Options de l'exemple : huit variables de demandeurs de prêt, liaison Average, distance Correlation, 3 groupes.
Description des résultats
- Dendrogram — les variables sont placées le long de l'axe x dans l'ordre de l'arbre ; l'axe y (Distance) indique le niveau auquel les branches se réunissent. Plus la jonction est basse, plus les variables sont semblables.
- Cluster Assignments — affiché lorsque Number of clusters est saisi : chaque variable et son numéro de groupe.
- Export PDF via Download.
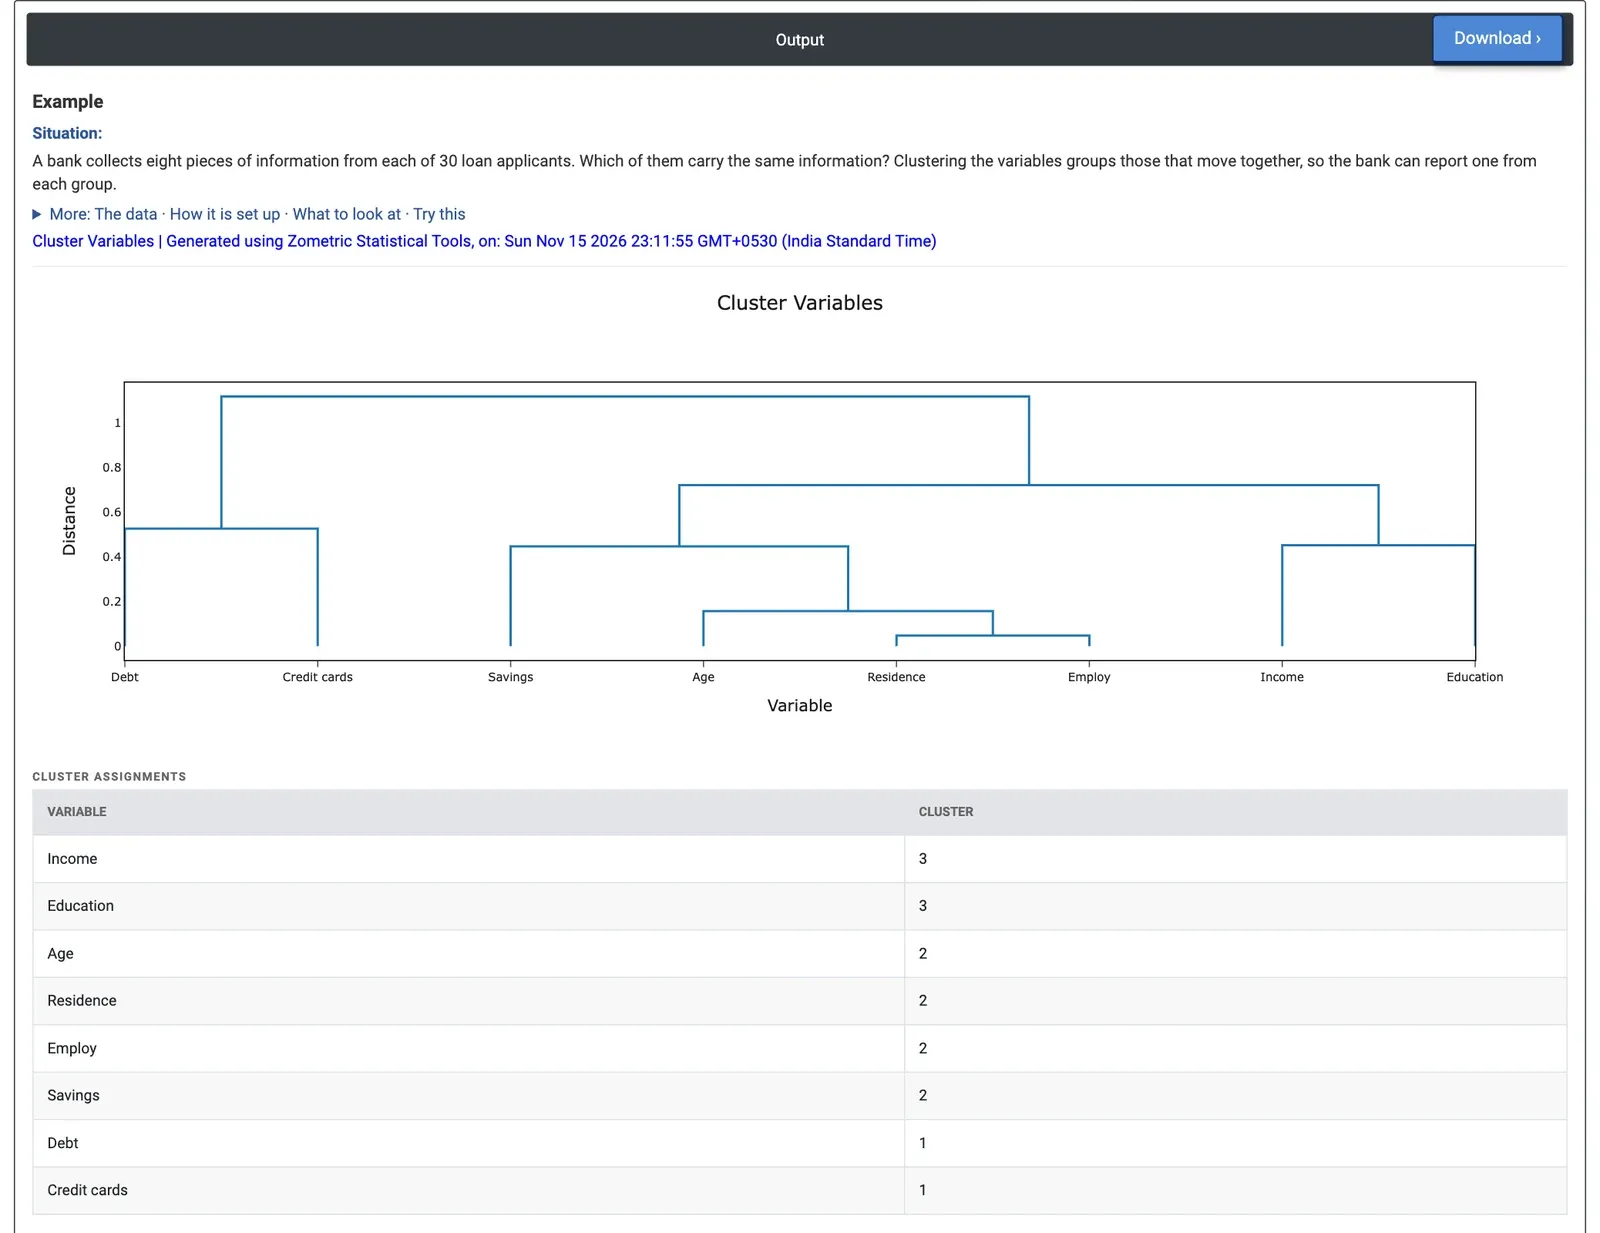
Figure 2 — Dendrogramme et attribution des groupes pour les huit variables de demandeurs de prêt : groupes stabilité, revenu et endettement.
Exemple résolu
Une banque enregistre huit informations sur chaque demandeur de prêt : revenu, années d'études, âge, années à l'adresse actuelle (Residence), années chez l'employeur actuel (Employ), épargne, dette et nombre de cartes de crédit. Un analyste crédit veut savoir lesquelles portent la même information, afin qu'un rapport court puisse en présenter une par groupe. Avec 30 demandeurs, l'analyste sélectionne les huit colonnes, conserve Linkage method = Average et Distance measure = Correlation, et saisit Number of clusters = 3.
Residence et Employ se réunissent en premier, à une distance de 0.048 (corrélation 0.95), et Age les rejoint à 0.157. Savings rejoint ce groupe à 0.446. Income et Education se réunissent à 0.451, et Debt et Credit cards à 0.526. Avec trois groupes, le Cluster 2 contient Age, Residence, Employ et Savings, qui décrivent la stabilité du demandeur ; le Cluster 3 contient Income et Education ; et le Cluster 1 contient Debt et Credit cards, l'endettement. Les deux dernières jonctions interviennent à 0.72 et 1.117, bien au-dessus des autres, ce qui conforte l'idée de trois groupes.
Pour l'analyste, une variable de chaque groupe, par exemple Employ, Income et Debt, couvrirait l'essentiel de ce que disent les huit variables. Avec Number of clusters = 2, les groupes stabilité et revenu fusionnent et Debt et Credit cards restent seuls ; avec 4 groupes, Debt et Credit cards se séparent. L'analyse factorielle (Factor Analysis) sur les mêmes huit colonnes donne un regroupement similaire, avec des saturations qui montrent à quel point chaque variable appartient à son groupe.
Questions fréquentes
À quoi sert Cluster Variables ?
Il sert à réduire une longue liste de mesures ou de questions d'enquête. Les variables qui montent et descendent ensemble d'une observation à l'autre sont réunies en premier, et le résultat est tracé sous forme de dendrogramme. Lorsque plusieurs variables se trouvent dans le même groupe, vous pouvez suivre l'une d'elles, ou un score combiné, au lieu de toutes.
Qu'est-ce que la distance de corrélation ?
La distance de corrélation vaut 1 − r, où r est le coefficient de corrélation de Pearson entre deux variables : 0 pour une corrélation positive parfaite et 2 pour une corrélation négative parfaite. La distance de corrélation absolue, 1 − |r|, traite une forte relation négative comme aussi proche qu'une forte relation positive. La distance euclidienne utilise les valeurs brutes ; elle dépend donc des unités de chaque variable.
Comment lire le dendrogramme des variables ?
Les variables sont placées le long de l'axe x dans l'ordre de l'arbre et l'axe y indique la distance à laquelle les branches se réunissent ; plus la jonction est basse, plus les variables sont semblables. Avec la distance de corrélation, une jonction à la hauteur h signifie que les variables des deux branches ont une corrélation moyenne d'environ 1 − h.
Comment choisir le nombre de groupes de variables ?
Cherchez les jonctions situées bien au-dessus des autres. Dans l'exemple des demandeurs de prêt, les deux dernières jonctions se situaient à 0.72 et 1.117, bien au-dessus du reste, ce qui confortait trois groupes : stabilité, revenu et endettement. Une variable de chaque groupe, comme Employ, Income et Debt, couvrirait alors l'essentiel de ce que disent les huit variables.