
Analyse factorielle des correspondances simple
L'analyse factorielle des correspondances simple prend des données catégorielles brutes ou un tableau de contingence et représente les catégories de lignes et de colonnes sur une carte. Elle fournit un test d'association du khi-deux, un tableau d'inertie indiquant ce qu'explique chaque composante, et des tableaux de contributions des lignes et des colonnes. Chaque variable doit avoir au moins 2 catégories. Utilisez-la pour lire la structure d'un grand tableau croisé, comme les types de défauts par machine.
Dernière révision
Point clé
L'analyse factorielle des correspondances simple transforme un tableau de comptages à double entrée en une carte où les catégories de lignes et de colonnes associées plus souvent que le hasard ne le laisse prévoir sont proches.
Sur cette page
Objectif
L'analyse factorielle des correspondances simple transforme un tableau de comptages à double entrée en une carte. Les catégories de lignes et de colonnes sont représentées par des points, et les catégories associées plus souvent que le hasard ne le laisse prévoir sont proches les unes des autres. Utilisez-la pour voir d'un coup d'œil la structure d'un grand tableau croisé : quels types de défauts vont avec quelles machines, quelles catégories de réclamations vont avec quels produits, ou quels attributs les clients associent à quelles marques.
Fonctionnalités principales
- Accepte des données brutes (une ligne par élément avec deux colonnes catégorielles) ou un tableau de contingence déjà résumé sous forme de comptages.
- Test d'association du khi-deux entre la variable en ligne et la variable en colonne.
- Tableau d'inertie indiquant la part de l'association expliquée par chaque composante (axe de la carte).
- Tableaux de contributions des lignes et des colonnes : qualité, masse, inertie, coordonnées, corrélations au carré et contributions pour le nombre de composantes choisi.
- Cinq graphiques : graphique symétrique des lignes et des colonnes, lignes seules, colonnes seules, et graphiques asymétriques des lignes ou des colonnes.
Méthodes statistiques
Avec l'entrée Categorical variables, l'outil croise la variable en ligne avec la variable en colonne, en ignorant les lignes comportant une valeur manquante. Avec l'entrée Columns of a contingency table, chaque colonne sélectionnée contient les comptages d'une catégorie de colonne et chaque ligne est une catégorie de ligne ; les lignes ou colonnes dont le total est nul sont supprimées. Chaque variable doit avoir au moins 2 catégories.
Les comptages sont divisés par le total général n pour obtenir les proportions P, avec les masses des lignes r (totaux de lignes de P) et les masses des colonnes c (totaux de colonnes). La matrice des résidus standardisés S = Dr^−½ (P − r cᵀ) Dc^−½ est décomposée par décomposition en valeurs singulières. Chaque valeur singulière d donne une composante d'inertie d², et le nombre de composantes est le plus petit de (lignes − 1) et (colonnes − 1). L'inertie totale est égale à la statistique du khi-deux divisée par n, et l'outil fournit khi-deux = n × inertie totale avec (lignes − 1)(colonnes − 1) degrés de liberté et sa valeur p. Une petite valeur p signifie que les lignes et les colonnes sont associées : la carte montre donc une structure réelle.
Les coordonnées principales des lignes sont Dr^−½ U D et celles des colonnes Dc^−½ V D. Dans les tableaux de contributions, Mass est la part de la catégorie dans le comptage total, Inert sa part de l'inertie totale, Corr le cosinus carré (la qualité de représentation du point par une composante), Qual la somme des Corr sur les composantes retenues, et Contr la part de l'inertie d'une composante dont le point rend compte. Les graphiques symétriques utilisent les coordonnées principales pour les deux ensembles de points ; un graphique asymétrique des lignes représente les lignes en coordonnées principales et les colonnes en coordonnées standard (coordonnées principales divisées par d), et un graphique asymétrique des colonnes fait l'inverse.
Champs de saisie et options
Champ | Description |
Input data | Categorical variables (par défaut) : une ligne par élément. Columns of a contingency table : comptages déjà résumés. Les champs ci-dessous changent selon ce choix. |
Row variable / Column variable | Pour l'entrée Categorical variables : les deux colonnes catégorielles à croiser. Les deux sont obligatoires et doivent être différentes. |
Contingency table columns | Pour l'entrée par tableau de contingence : deux colonnes ou plus, chacune contenant les comptages d'une catégorie de colonne, avec une ligne par catégorie de ligne. |
Row names | Pour l'entrée par tableau de contingence, facultatif : une colonne nommant chaque ligne du tableau. Si vide, Row 1, Row 2, etc. sont utilisés. |
Column names | Pour l'entrée par tableau de contingence, facultatif : une colonne listant un nom par colonne de tableau sélectionnée, dans le même ordre. Si vide, les en-têtes de colonnes sont utilisés. |
Number of components | Nombre de composantes pour lesquelles fournir Coord, Corr et Contr dans les tableaux de contributions. 2 par défaut ; de 1 à 20, dans la limite du nombre de composantes disponibles. |
Symmetric plot showing rows and columns | Coché par défaut. Lignes et colonnes sur une même carte, toutes deux en coordonnées principales. |
Symmetric plot showing rows only / columns only | Décoché par défaut. La même carte avec un seul des deux ensembles de points. |
Asymmetric row plot / Asymmetric column plot | Décoché par défaut. Lignes en coordonnées principales et colonnes en coordonnées standard, ou l'inverse. |
Title | Titre affiché sur les graphiques. Par défaut Simple Correspondence Analysis. |
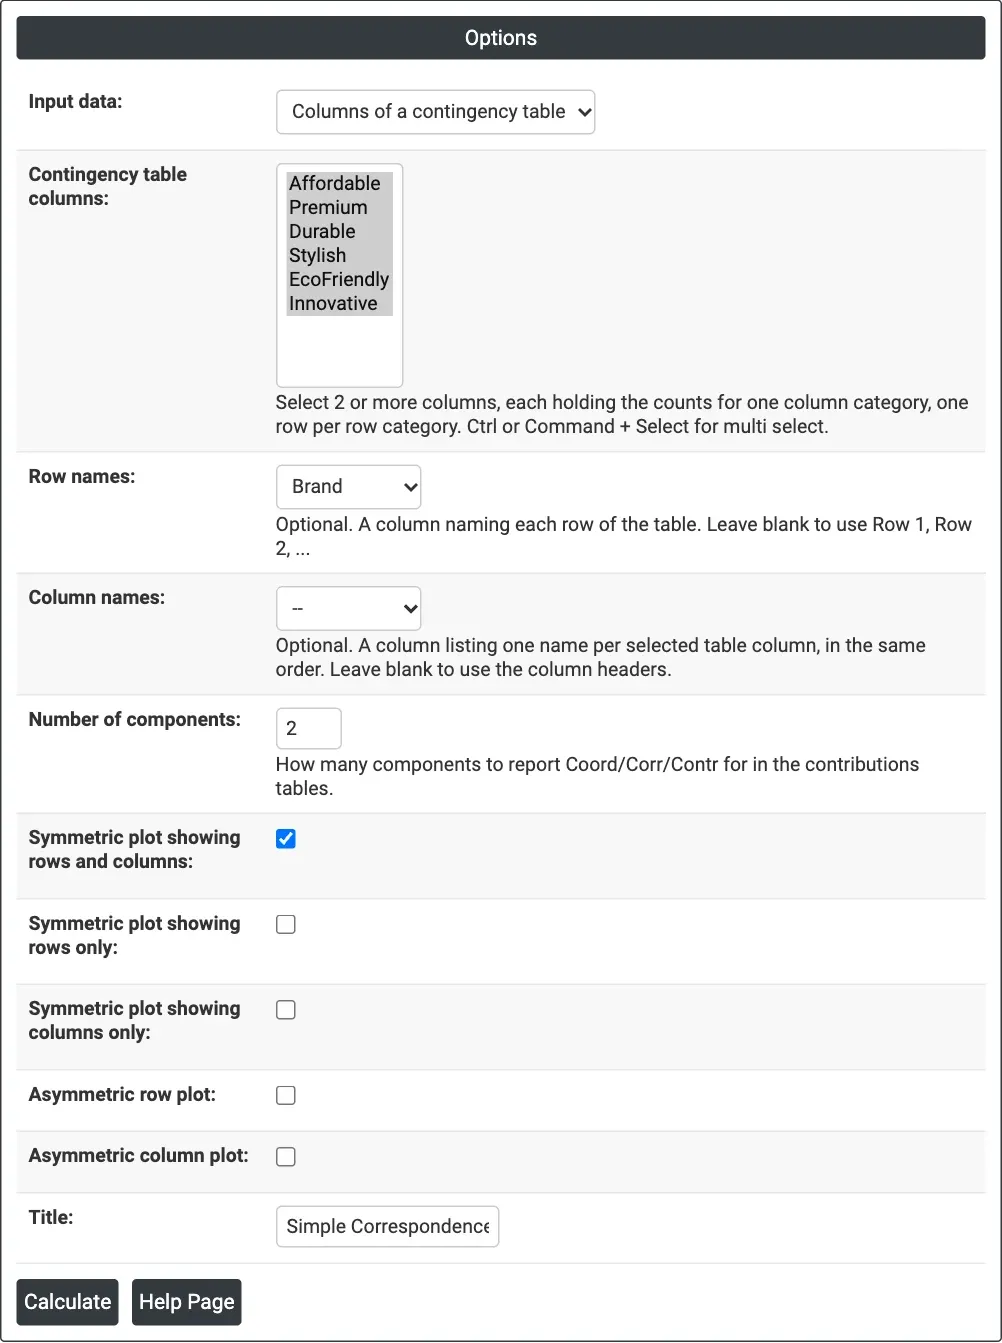
Figure 1 — Options de l'exemple de perception des marques : entrée par tableau de contingence avec six colonnes d'attributs et Brand comme noms de lignes.
Description des résultats
- Symmetric Plot, Row Plot, Column Plot, Asymmetric Row Plot, Asymmetric Column Plot — les graphiques cochés, avec Component 1 et Component 2 comme axes et le pourcentage d'inertie expliqué par chacun dans les titres des axes.
- Contingency Table — affiché pour l'entrée par tableau de contingence : le tableau tel qu'il a été analysé.
- Chi-square, DF et P-value — le test d'association entre lignes et colonnes.
- Analysis of Contingency Table — inertie, proportion et proportion cumulée pour chaque axe, avec un histogramme en texte, et l'inertie totale.
- Row Contributions et Column Contributions — ID, Name, Qual, Mass, Inert, ainsi que Coord, Corr et Contr pour chaque composante retenue.
- Export PDF via Download.
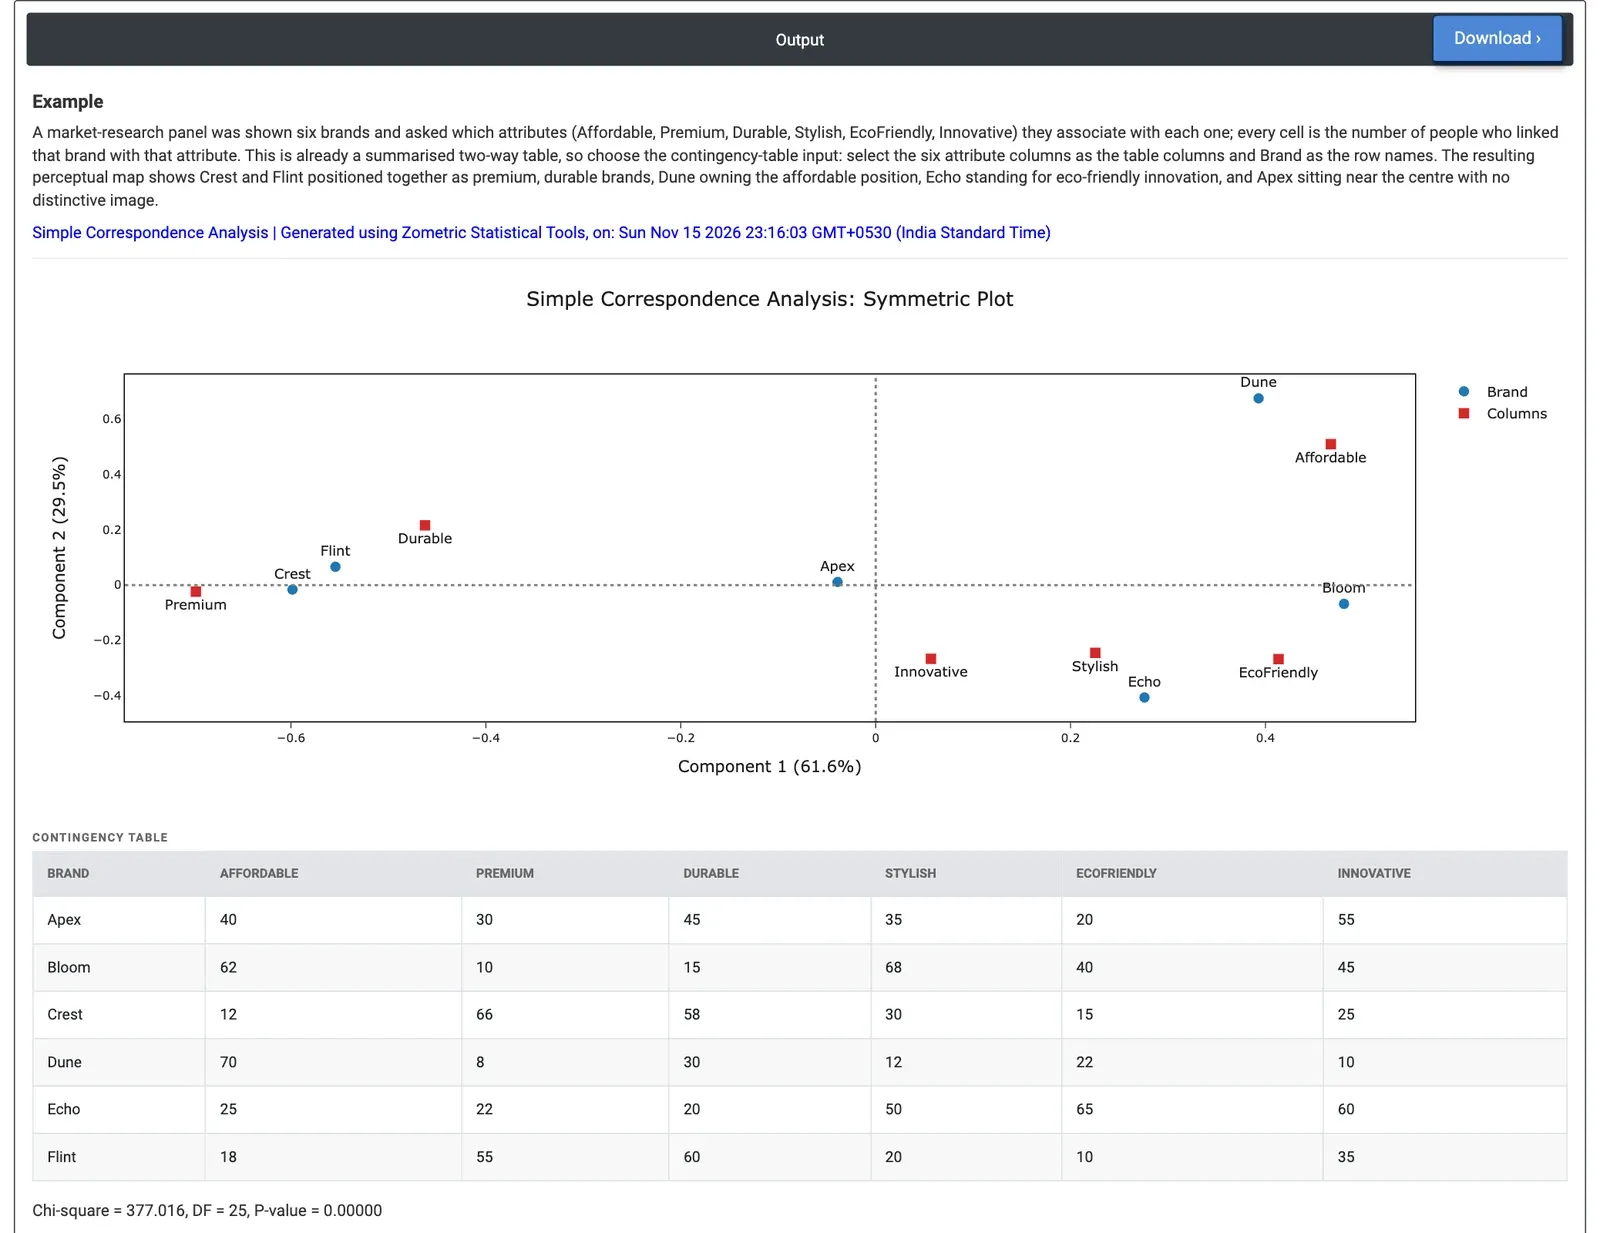
Figure 2 — Graphique symétrique de six marques et six attributs : Crest et Flint sont proches de Premium et Durable, Dune d'Affordable, Echo d'EcoFriendly ; khi-deux 377.0 pour 25 DF.
Exemple résolu
Un panel d'étude de marché a vu six marques (Apex, Bloom, Crest, Dune, Echo et Flint) et devait indiquer, parmi six attributs, ceux qu'il associe à chacune : Affordable, Premium, Durable, Stylish, EcoFriendly et Innovative. Chaque cellule contient le nombre de personnes ayant associé cette marque à cet attribut. L'équipe marketing veut voir la position de chaque marque. Comme les données forment déjà un tableau de comptages, elle règle Input data = Columns of a contingency table, sélectionne les six colonnes d'attributs comme Contingency table columns et choisit Brand comme Row names, en conservant le graphique symétrique des lignes et des colonnes.
Le khi-deux vaut 377.016 avec 25 degrés de liberté (p < 0.00001) : l'image de marque diffère donc nettement d'une marque à l'autre. La composante 1 porte 61.6 % de l'inertie et la composante 2 29.5 %, si bien que la carte à deux dimensions montre 91.1 % de la structure. La composante 1 va de Premium (−0.698) et Durable (−0.462) à gauche à Affordable (0.467) et EcoFriendly (0.414) à droite. Crest (−0.599) et Flint (−0.554) se situent du côté premium et durable et sont presque parfaitement représentées sur cet axe (Corr 0.94 et 0.98). Dune se situe haut sur la composante 2 (0.674), près d'Affordable, et rend compte de 62.2 % de l'inertie de cette composante. Echo (0.276, −0.406) se situe près d'EcoFriendly, Stylish et Innovative, et Bloom (0.481) penche vers Stylish et Affordable.
Apex se situe près du centre (−0.039, 0.011) avec une qualité de seulement 0.038 : son profil est proche de la moyenne de toutes les marques, il n'a donc pas d'image distinctive. Pour l'équipe, Crest et Flint se disputent la même position premium et durable, Dune occupe la position abordable, et Apex est la marque qui a besoin d'un message plus clair.
Questions fréquentes
À quoi sert l'analyse des correspondances ?
Elle sert à voir d'un coup d'œil la structure d'un grand tableau croisé, par exemple quels types de défauts vont avec quelles machines, quelles catégories de réclamations vont avec quels produits, ou quels attributs les clients associent à quelles marques. Les catégories de lignes et de colonnes sont représentées par des points, et les catégories associées plus souvent que le hasard sont proches.
Qu'est-ce que l'inertie en analyse des correspondances ?
L'inertie mesure l'association dans le tableau. Chaque composante, ou axe de la carte, a une inertie égale au carré de sa valeur singulière, et l'inertie totale est égale à la statistique du khi-deux divisée par le total général n. Le tableau d'inertie indique la proportion expliquée par chaque composante ; dans l'exemple des marques, les deux premières composantes montraient 91.1 % de la structure.
Comment interpréter la qualité, la masse et la contribution ?
Mass est la part d'une catégorie dans le comptage total, Inert sa part de l'inertie totale, Corr la qualité de représentation du point par une composante, Qual la somme des Corr sur les composantes retenues, et Contr la part de l'inertie d'une composante dont le point rend compte. Un point proche du centre avec une faible qualité, comme Apex dans l'exemple, a un profil proche de la moyenne.
Quelle est la différence entre graphiques symétriques et asymétriques ?
Un graphique symétrique montre ensemble les lignes et les colonnes, toutes deux en coordonnées principales, et il est coché par défaut. Un graphique asymétrique des lignes montre les lignes en coordonnées principales et les colonnes en coordonnées standard (coordonnées principales divisées par la valeur singulière), et un graphique asymétrique des colonnes fait l'inverse. Des graphiques des lignes seules ou des colonnes seules sont aussi disponibles.