
Statistiques descriptives (tableaux)
Choisissez des variables numériques et, facultativement, des variables de regroupement en lignes et en colonnes, puis sélectionnez parmi neuf statistiques : N, moyenne, erreur-type de la moyenne, écart-type, minimum, premier quartile, médiane, troisième quartile et maximum. Les valeurs manquantes sont exclues. Utilisez-le pour comparer des sous-groupes, comme des poids de remplissage par doseuse et par équipe. Il décrit les données et ne teste pas si les différences sont réelles.
Dernière révision
Point clé
Statistiques descriptives (tableaux) résume une ou plusieurs colonnes numériques dans un seul tableau ventilé selon jusqu'à deux colonnes de regroupement, pour comparer de nombreux sous-groupes côte à côte avant d'approfondir.
Sur cette page
Objectif
Statistiques descriptives (tableaux) résume une ou plusieurs colonnes numériques dans un seul tableau, ventilé selon jusqu'à deux colonnes de regroupement : l'une sur le côté du tableau et l'autre en haut. Pour chaque variable, vous choisissez les statistiques à afficher : effectif, moyenne, erreur-type de la moyenne, écart-type, minimum, quartiles, médiane et maximum. Utilisez-le pour placer de nombreux sous-groupes côte à côte avant de décider où approfondir, par exemple des poids de remplissage par doseuse et par équipe, des temps de cycle par ligne et par produit, ou des résultats d'essai par fournisseur et par lot. Il décrit les données ; il ne teste pas si les différences sont réelles.
Principales fonctionnalités
- Plusieurs variables numériques dans un seul tableau, chacune avec son propre bloc de statistiques.
- Ventilation par une variable en lignes, une variable en colonnes, ou les deux : les groupes de la variable en lignes descendent le long du tableau et ceux de la variable en colonnes s'étalent en travers, comme dans Minitab.
- Neuf statistiques au choix ; N, Mean, Standard deviation, Minimum, Median et Maximum sont cochées par défaut.
- Les valeurs manquantes d'une variable sont exclues des statistiques de cette variable.
- Export PDF via Download.
Méthodes statistiques
Les données sont réparties selon les niveaux de la variable en lignes et de la variable en colonnes (lorsqu'elle est donnée), et les statistiques sont calculées séparément dans chaque groupe et pour chaque variable, après suppression des valeurs manquantes et non numériques. Les groupes apparaissent dans l'ordre trié des valeurs de regroupement. Sans variable de regroupement, le tableau comporte une seule ligne pour toute la colonne.
N est le nombre de valeurs non manquantes. La moyenne x̄ = Σx / N. L'écart-type s utilise le diviseur N − 1 : s = √(Σ(x − x̄)² / (N − 1)). SE of mean = s / √N, l'incertitude de la moyenne du groupe. Minimum, médiane et maximum sont les valeurs la plus petite, centrale et la plus grande. Les premier et troisième quartiles sont les 25e et 75e centiles obtenus par interpolation linéaire entre les valeurs triées à la position 1 + (N − 1)·p ; ils peuvent donc différer légèrement de ceux des logiciels qui utilisent la règle (N + 1)·p. Avec de petits groupes (moins d'une dizaine de valeurs environ), l'écart-type et les quartiles sont approximatifs : interprétez-les avec prudence.
Champs de saisie et options
Champ | Description |
Variables | Obligatoire. Une ou plusieurs colonnes numériques à résumer (maintenez Ctrl ou Cmd pour en sélectionner plusieurs). |
For rows (optional) | Colonne de regroupement. Chacun de ses niveaux obtient ses propres lignes dans le tableau. |
For columns (optional) | Seconde colonne de regroupement. Ses niveaux deviennent les colonnes du tableau, une par niveau ; chaque ligne contient alors une statistique d'une variable (pour chaque niveau de la variable en lignes, si elle est définie). |
N / Mean / SE of mean / Standard deviation / Minimum / First quartile / Median / Third quartile / Maximum | Statistiques à afficher pour chaque variable. Cochées par défaut : N, Mean, Standard deviation, Minimum, Median et Maximum. Au moins une doit être cochée. |
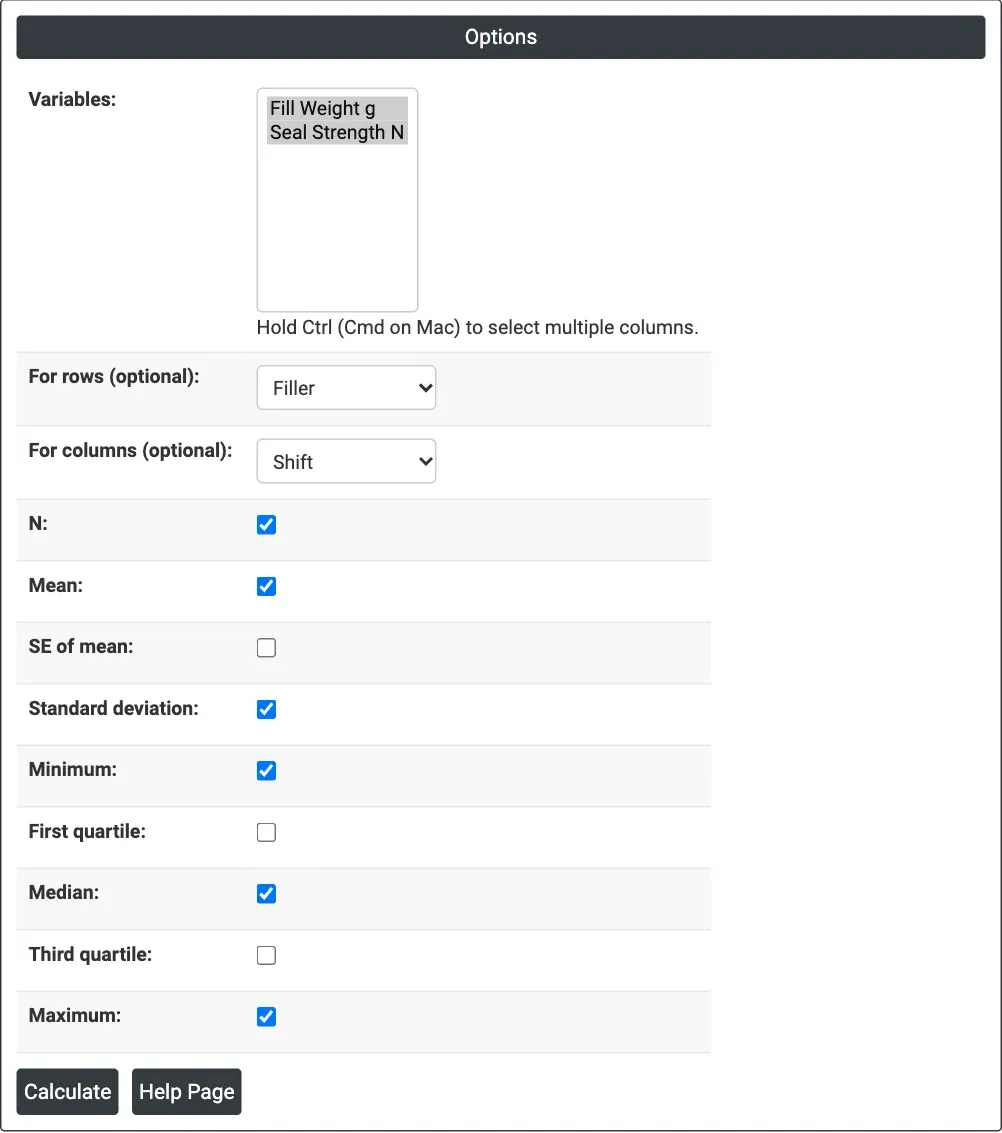
Figure 1 — Fill Weight g et Seal Strength N résumés par Filler (lignes) et Shift (colonnes) avec les statistiques par défaut.
Description des résultats
- Statistics table — avec une variable en colonnes (intitulé « Rows: <row variable>; Columns: <column variable> ») : d'abord le niveau de la variable en lignes, Variable et Statistic, puis une colonne par niveau de la variable en colonnes. Sans variable en colonnes : une ligne par groupe de la variable en lignes (ou une seule ligne au total), puis une colonne par variable et par statistique, nommée Variable_Statistic, par exemple Fill Weight g_Mean, Seal Strength N_StDev (Q1, Q3 et SE Mean pour les statistiques facultatives).
- Export PDF via Download.
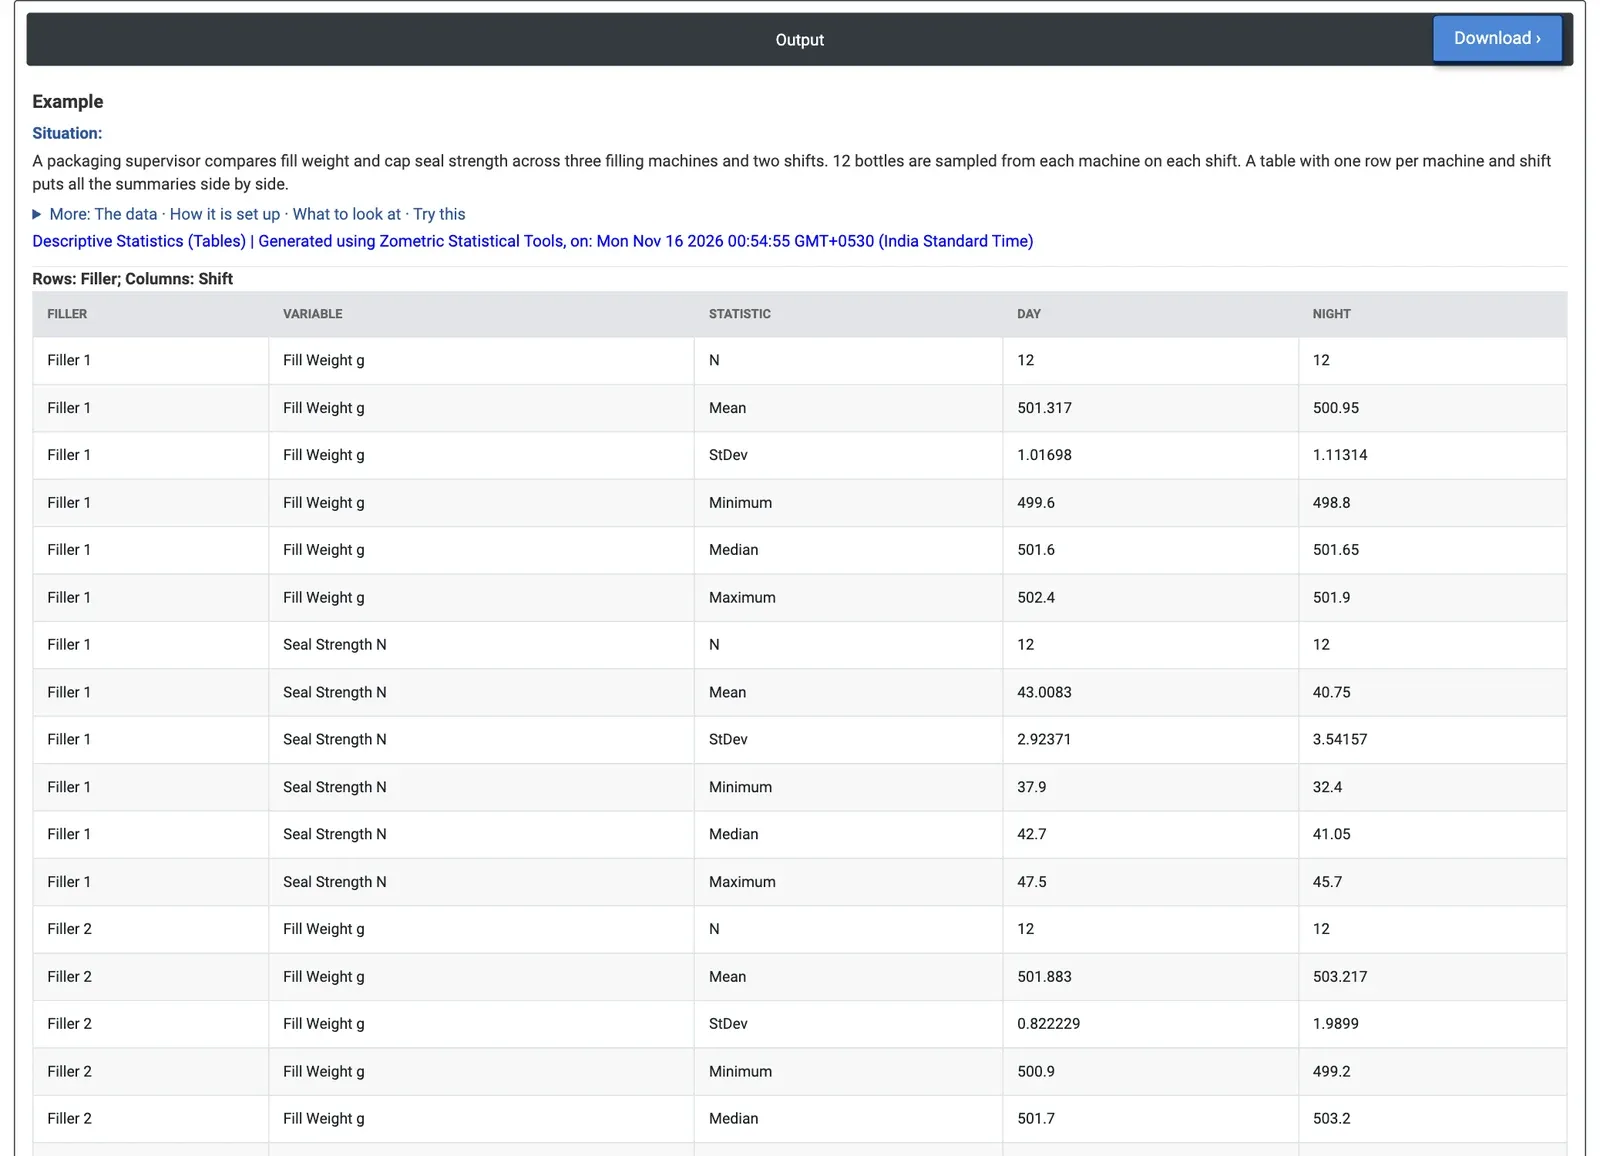
Figure 2 — Doseuses sur le côté et équipes en haut : la résistance des scellés est plus faible en équipe de nuit pour les trois doseuses, et la doseuse 2 en équipe de nuit remplit le plus lourd et de la façon la plus variable.
Exemple résolu
Un responsable d'emballage compare trois machines de remplissage sur deux équipes. Douze bouteilles sont prélevées sur chaque doseuse à chaque équipe (72 au total), et le poids de remplissage (g) et la résistance du scellé du bouchon (N) de chaque bouteille sont mesurés. Le responsable sélectionne Variables = Fill Weight g et Seal Strength N, For rows = Filler et For columns = Shift, et conserve les statistiques par défaut.
La résistance des scellés est plus faible en équipe de nuit pour chaque doseuse : moyennes de 40.75, 38.93 et 38.66 N la nuit contre 43.01, 43.38 et 43.23 N le jour. Le motif est le même sur les trois machines, ce qui désigne un facteur lié à l'équipe (personnel, lot de bouchons, réglage du couple) plutôt qu'une seule machine. Le poids de remplissage raconte une autre histoire : la doseuse 2 en équipe de nuit remplit le plus lourd (moyenne 503.22 g) et est la plus variable (écart-type 1.99 g, étendue de 499.2 à 506.2 g), tandis que la doseuse 3 remplit le plus léger aux deux équipes (499.67 et 499.61 g).
Pour une vue au niveau de l'équipe, définir For rows = Shift sans variable en colonnes et cocher First quartile et Third quartile donne des moyennes de résistance des scellés de 43.21 N le jour et 39.44 N la nuit, la moitié centrale des bouteilles de nuit se situant entre 37.15 et 41.18 N. Le tableau montre où chercher ; pour vérifier si les différences entre équipes et entre doseuses dépassent le hasard, le responsable réalise une ANOVA à deux facteurs sur Seal Strength N avec Filler et Shift comme facteurs.
Questions fréquentes
Quand utiliser des tableaux de statistiques descriptives ?
Utilisez-les pour placer de nombreux sous-groupes côte à côte avant de décider où approfondir, par exemple des poids de remplissage par doseuse et par équipe, des temps de cycle par ligne et par produit, ou des résultats d'essai par fournisseur et par lot. Une variable de regroupement descend le long du tableau et une seconde peut s'étaler en haut.
Comment les quartiles sont-ils calculés ?
Les premier et troisième quartiles sont les 25e et 75e centiles, obtenus par interpolation linéaire entre les valeurs triées à la position 1 + (N − 1)·p ; ils peuvent donc différer légèrement de ceux des logiciels qui utilisent la règle (N + 1)·p. Avec de petits groupes de moins d'une dizaine de valeurs environ, l'écart-type et les quartiles sont approximatifs : interprétez-les avec prudence.
Un tableau de statistiques descriptives teste-t-il si les groupes diffèrent ?
Non. Il décrit les données mais ne teste pas si les différences sont réelles. Dans l'exemple résolu, le tableau montrait une résistance des scellés plus faible en équipe de nuit pour les trois doseuses ; pour vérifier si les différences entre équipes et entre doseuses dépassaient le hasard, le responsable a réalisé une ANOVA à deux facteurs.
Comment configurer le tableau dans Zometric Statistical Software ?
Sélectionnez une ou plusieurs Variables numériques, éventuellement une colonne For rows et une colonne For columns, et cochez les statistiques à afficher. N, Mean, Standard deviation, Minimum, Median et Maximum sont cochées par défaut, et au moins une doit être cochée. L'écart-type utilise le diviseur N − 1, et les valeurs manquantes sont exclues.