
Analyse discriminante (LDA/QDA)
Fournissez des éléments de groupe connu et des prédicteurs numériques. L'analyse discriminante linéaire suppose des prédicteurs normaux multivariés avec une matrice de covariance commune ; la quadratique en admet une par groupe. Les probabilités a priori peuvent être égales, proportionnelles ou spécifiées. Les résultats incluent les matrices de confusion, la précision globale et par validation croisée leave-one-out, et des fonctions de classification linéaires pour évaluer de nouveaux éléments. Servez-vous-en pour vérifier si une qualité se distingue à partir des données de contrôle.
Dernière révision
Point clé
L'analyse discriminante construit une règle qui affecte des éléments à des groupes connus à partir de valeurs mesurées, trouve la combinaison de mesures qui sépare le mieux les groupes et indique combien d'éléments sont bien classés.
Sur cette page
Objectif
L'analyse discriminante (Discriminant Analysis) construit une règle qui affecte des éléments à des groupes connus à partir de valeurs mesurées. Vous lui fournissez des éléments dont le groupe est connu (par exemple des lots Standard et Premium, des pièces bonnes et mauvaises, ou des fournisseurs) et les mesures prises sur eux ; elle trouve la combinaison de mesures qui sépare le mieux les groupes et indique combien d'éléments la règle classe correctement. Utilisez-la pour vérifier si une qualité ou un type peut se déduire des données de contrôle, ou pour construire une règle de tri de nouveaux éléments.
Principales fonctionnalités
- Fonctions discriminantes linéaires ou quadratiques pour deux groupes ou plus.
- Probabilités a priori égales pour tous les groupes, proportionnelles aux effectifs des groupes, ou définies par vous.
- Matrice de confusion du groupe réel par rapport au groupe prédit, avec le pourcentage global de bien classés.
- Validation croisée leave-one-out pour une estimation plus juste du comportement de la règle sur de nouveaux éléments.
- Fonctions de classification linéaires (constante et un coefficient par prédicteur pour chaque groupe) pour évaluer de nouveaux éléments.
Méthodes statistiques
Les lignes dont le groupe est manquant ou dont un prédicteur est manquant ou non numérique sont exclues. La réponse est traitée comme une étiquette textuelle, et les groupes sont listés par ordre alphabétique ou numérique. Il doit y avoir au moins 2 groupes et plus de lignes que la somme du nombre de prédicteurs et du nombre de groupes.
L'analyse discriminante linéaire suppose que les prédicteurs suivent une distribution normale multivariée dans chaque groupe avec la même matrice de covariance. Elle estime la moyenne x̄g de chaque groupe et une matrice de covariance intra-groupe groupée S, et attribue à chaque groupe un score Lg(x) = x̄gᵀ S⁻¹ x − ½ x̄gᵀ S⁻¹ x̄g + ln(pg), où pg est la probabilité a priori du groupe. Un élément est affecté au groupe de score le plus élevé. Le tableau Linear Discriminant (Classification) Functions liste, pour chaque groupe, la constante (−½ x̄gᵀ S⁻¹ x̄g + ln pg) et les coefficients S⁻¹ x̄g. L'analyse discriminante quadratique abandonne l'hypothèse de covariances égales et estime une matrice de covariance distincte pour chaque groupe, ce qui donne des frontières courbes ; elle exige plus de données par groupe et n'a pas de fonctions de classification simples.
Les probabilités a priori valent 1/k pour k groupes par défaut. Les probabilités a priori proportionnelles utilisent la part de chaque groupe dans les données, ce qui favorise les groupes plus grands. La précision par resubstitution classe les mêmes éléments que ceux qui ont servi à construire la règle et est optimiste. La validation croisée leave-one-out retire chaque élément à tour de rôle, construit la règle avec les autres et classe l'élément retiré ; c'est donc un meilleur indicateur de la précision sur de nouveaux éléments.
Champs de saisie et options
Champ | Description |
Response (grouping variable) | Obligatoire. Colonne catégorielle contenant le groupe connu de chaque élément. |
Predictors | Une ou plusieurs colonnes numériques servant à séparer les groupes. |
Discriminant function | Linear (par défaut ; matrice de covariance commune) ou Quadratic (une matrice de covariance par groupe). |
Prior probabilities | All groups equal (par défaut), Proportional to group sizes in the data, ou User-specified. |
Custom priors | Utilisé uniquement lorsque Prior probabilities est User-specified. Une valeur par groupe, séparées par des virgules ou des espaces, dans l'ordre alphabétique ou numérique des groupes ; toutes positives et de somme 1, par exemple 0.2, 0.5, 0.3. |
Cross-validate (leave-one-out) | Cochée par défaut. Ajoute la précision par validation croisée et la matrice de confusion correspondante. |
Title | Titre de l'analyse. Par défaut Discriminant Analysis. |
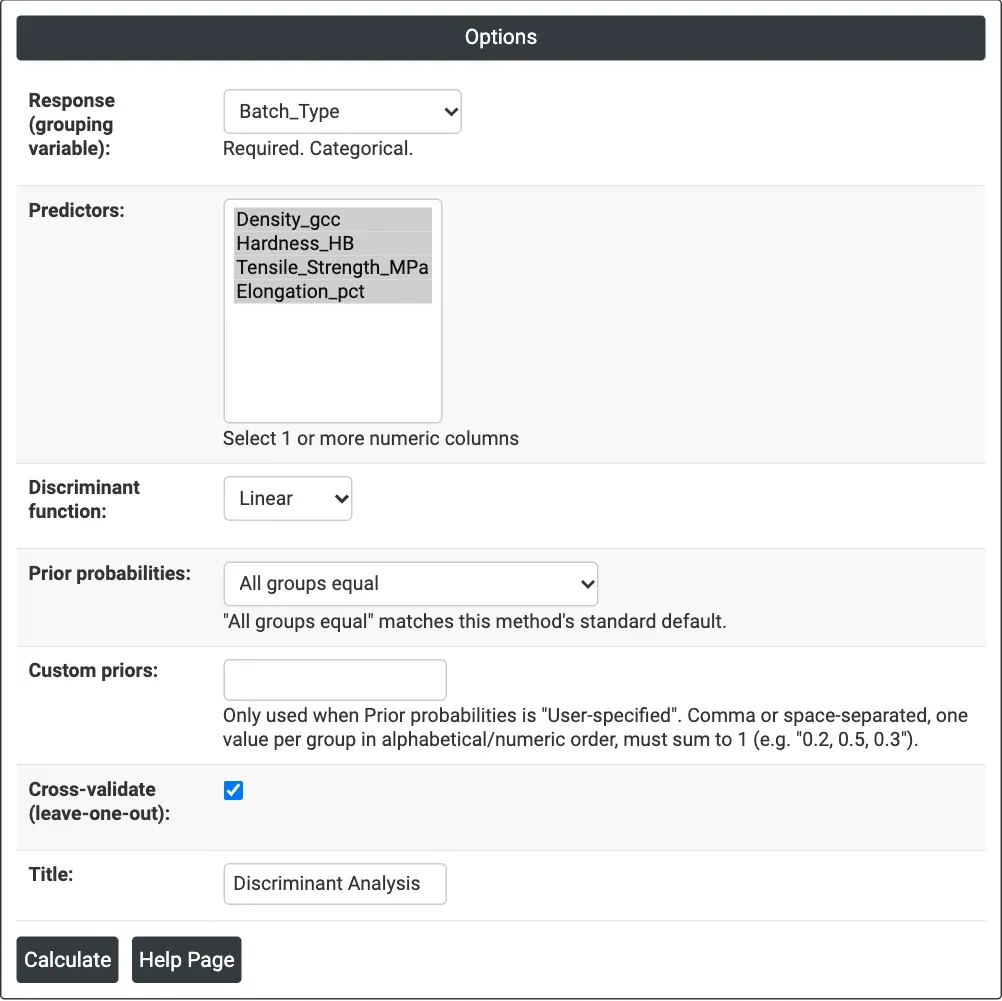
Figure 1 — Options pour l'exemple : Batch_Type comme réponse, quatre colonnes de propriétés comme prédicteurs, fonction linéaire, probabilités a priori égales, validation croisée leave-one-out.
Description des résultats
- Summary line : N utilisé, précision par resubstitution et, si cochée, précision par validation croisée (leave-one-out).
- Prior Probabilities : la probabilité a priori utilisée pour chaque groupe.
- Confusion Matrix (Resubstitution) : groupe réel en lignes, groupe prédit en colonnes.
- Confusion Matrix (Cross-Validated) : la même avec les prédictions leave-one-out.
- Linear Discriminant (Classification) Functions : pour une fonction linéaire uniquement, la constante et le coefficient de chaque prédicteur pour chaque groupe. Un nouvel élément va au groupe dont la fonction donne la valeur la plus élevée.
- Export PDF via Download.
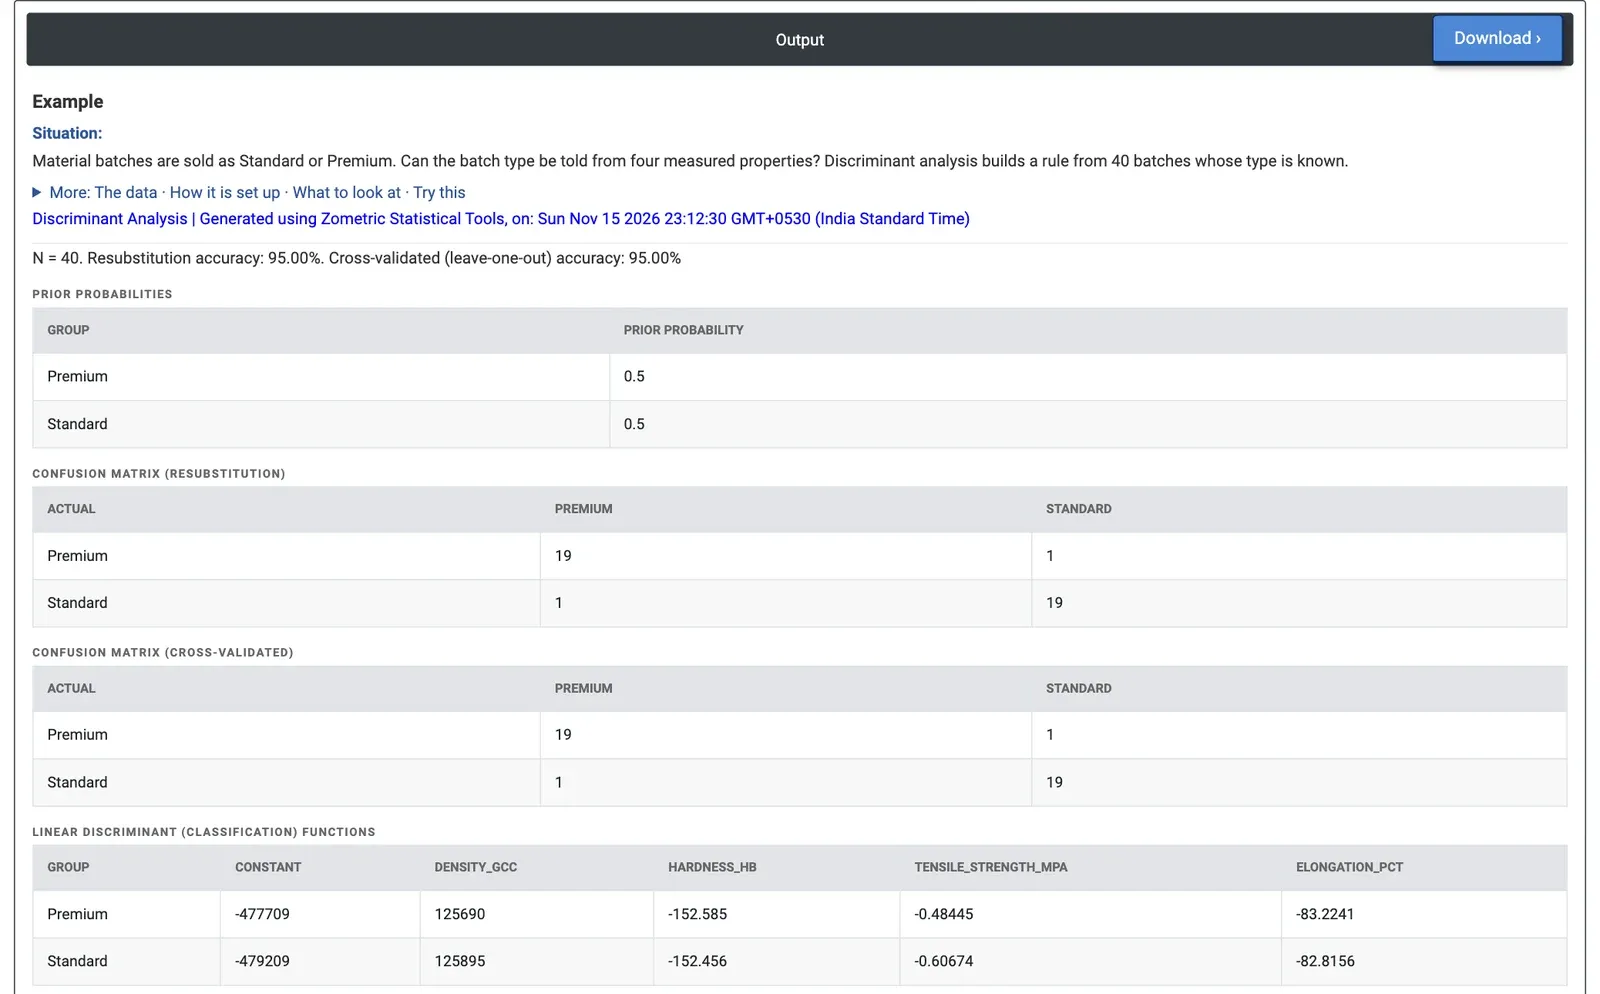
Figure 2 — Résultats pour 40 lots : 95% bien classés, à la fois sur les données et par validation croisée leave-one-out ; un lot de chaque type est mal classé.
Exemple résolu
Une usine de matériaux vend ses lots en Standard ou Premium. L'ingénieur qualité veut savoir si le type de lot peut se déduire de quatre mesures courantes : masse volumique (g/cc), dureté (HB), résistance à la traction (MPa) et allongement (%). Il utilise 40 lots dont le type est connu, 20 de chaque, et définit Response (grouping variable) = Batch_Type, les quatre propriétés comme Predictors, Discriminant function = Linear, Prior probabilities = All groups equal et Cross-validate coché.
La règle classe correctement 38 lots sur 40 : 95.00% sur les données et 95.00% par validation croisée leave-one-out ; elle ne se contente donc pas d'ajuster les 40 lots qui ont servi à la construire. Dans chaque type, 19 lots sur 20 sont corrects. Les deux lots mal classés sont la ligne 3 (Standard, 197.4 HB, 1,210.8 MPa) et la ligne 27 (Premium, 202.3 HB, 1,209.7 MPa) : ils se situent entre les moyennes des groupes (Premium 212.9 HB et 1,253.6 MPa, Standard 180.1 HB et 1,126.2 MPa) et méritent d'être vérifiés. Les fonctions de classification donnent à chaque nouveau lot un score Premium et un score Standard à partir de ses quatre mesures, et le lot est affecté au type de score le plus élevé.
La masse volumique compte plus que ne le suggère sa faible dispersion : la moyenne Premium est de 7.878 g/cc contre 7.850 pour Standard, et si la masse volumique est retirée des prédicteurs, la précision tombe à 82.5% (75.0% en validation croisée). Une fonction quadratique fait moins bien ici, avec 92.5% sur les données et 85.0% en validation croisée, car elle estime davantage de paramètres à partir de seulement 20 lots par groupe. Pour l'ingénieur, la règle linéaire sur les quatre propriétés suffit pour signaler les lots dont l'étiquette ne correspond pas aux mesures. Comparée à la classification des mêmes données sans les étiquettes (Cluster K-Means retrouve les types pour 28 lots sur 40), la connaissance des groupes donne une séparation bien plus nette.
Questions fréquentes
Quelle est la différence entre l'analyse discriminante linéaire et quadratique ?
L'analyse discriminante linéaire suppose que les prédicteurs sont normaux multivariés dans chaque groupe avec la même matrice de covariance, et donne des fonctions de classification linéaires. L'analyse discriminante quadratique estime une matrice de covariance distincte pour chaque groupe, ce qui donne des frontières courbes, mais exige plus de données par groupe et n'a pas de fonctions de classification simples. Dans l'exemple, la quadratique a fait moins bien avec seulement 20 lots par groupe.
Pourquoi utiliser la validation croisée leave-one-out ?
La précision par resubstitution classe les mêmes éléments que ceux qui ont servi à construire la règle ; elle est donc optimiste. La validation croisée leave-one-out retire chaque élément à tour de rôle, construit la règle avec les autres et classe l'élément retiré, ce qui donne un meilleur indicateur de la précision sur de nouveaux éléments. Dans l'exemple, les deux valaient 95% : la règle ne se contentait donc pas d'ajuster ses propres données.
Comment les probabilités a priori influencent-elles l'analyse discriminante ?
Par défaut, chacun des k groupes reçoit une probabilité a priori de 1/k. Les probabilités a priori proportionnelles utilisent la part de chaque groupe dans les données, ce qui favorise les groupes plus grands. Les probabilités a priori spécifiées doivent être positives, données une par groupe dans l'ordre alphabétique ou numérique des groupes, et de somme 1. La probabilité a priori intervient dans le score de chaque groupe par son logarithme népérien.
Comment classer un nouvel élément avec l'analyse discriminante ?
Pour une fonction discriminante linéaire, Zometric Statistical Software liste une constante et un coefficient par prédicteur pour chaque groupe dans le tableau Linear Discriminant (Classification) Functions. Évaluez le nouvel élément avec la fonction de chaque groupe et affectez-le au groupe dont la fonction donne la valeur la plus élevée.