
Diagramme en points (dotplot)
Un diagramme en points (dotplot) divise l'étendue des données en classes égales et empile un point par valeur : la hauteur de la pile est l'effectif. Utilisez-le pour des échantillons allant jusqu'à quelques centaines de valeurs, avant de les résumer ou de réaliser des tests supposant la normalité. Options : colonne de regroupement ou plusieurs colonnes, nombre de classes, échelle logarithmique et exclusion des valeurs aberrantes par la règle 1.5xIQR.
Dernière révision
Point clé
Un diagramme en points (dotplot) montre chaque valeur d'un petit ou moyen jeu de données comme un point sur une droite graduée, en empilant les valeurs voisines : amas, vides, groupes distincts et points isolés.
Sur cette page
Objectif
Un diagramme en points (dotplot) montre chaque valeur d'un jeu de données de petite ou moyenne taille sous forme de point sur une droite graduée, les points de valeur voisine étant empilés les uns sur les autres. Contrairement à une moyenne et un écart-type, il montre la forme des données : où les valeurs s'accumulent, les vides, les groupes distincts et les points isolés. Utilisez-le pour des échantillons allant jusqu'à quelques centaines de valeurs, par exemple des volumes de remplissage, des cotes d'un contrôle de première pièce ou des résultats d'essais, avant de les résumer ou de réaliser un test supposant une distribution normale.
Principales fonctionnalités
- Une colonne de données, ou plusieurs colonnes (mode Multiple Ys), chacune sur sa propre ligne et dans sa propre couleur.
- Colonne de regroupement facultative : une ligne de points empilés par groupe, comme dans le dotplot With Groups de Minitab.
- Nombre de classes défini par vous ou calculé à partir de l'effectif de l'échantillon.
- Axe X en échelle logarithmique pour des données positives et asymétriques.
- Exclusion facultative des valeurs aberrantes par la règle 1.5×IQR, avec une note indiquant combien ont été retirées.
- Data Options pour exclure des lignes, ou ne conserver que certaines lignes, par numéro de ligne ou selon une condition.
Méthodes statistiques
Les valeurs sont converties en nombres et les entrées manquantes ou non numériques sont écartées. L'étendue de la plus petite à la plus grande valeur est divisée en classes égales ; lorsque Number of bins est vide, le nombre est 2 × √n arrondi à l'entier supérieur, borné entre 10 et 60 (10 classes pour 25 valeurs). Chaque valeur est placée au centre de sa classe, et les valeurs d'une même classe sont empilées les unes au-dessus des autres, de sorte que la hauteur d'une pile est l'effectif de cette classe. Les points montrent donc les valeurs à la classe près, et non exactement ; la plus grande valeur va dans la dernière classe. Avec une colonne de regroupement, ou plusieurs colonnes de données, chaque groupe ou colonne a sa propre ligne (la première en haut), et toutes les lignes partagent les mêmes classes, ce qui permet de les comparer directement. Avec Log scale X-axis, les classes sont égales sur l'échelle logarithmique ; toutes les valeurs doivent alors être supérieures à zéro.
Avec Exclude outliers cochée, les valeurs inférieures à Q1 − 1.5×IQR ou supérieures à Q3 + 1.5×IQR (IQR = Q3 − Q1, calculé par groupe lorsqu'une colonne de regroupement est définie) sont retirées avant le tracé, et une note sous le graphique indique combien. Lecture du graphique : un amas central qui s'amenuise régulièrement des deux côtés est compatible avec une distribution normale ; deux amas ou plus séparés par des vides suggèrent un mélange de sources (deux buses, deux équipes, deux fournisseurs) qu'il vaut la peine de séparer avant toute analyse ultérieure.
Champs de saisie et options
Champ | Description |
Data column(s) | Obligatoire. Une colonne numérique, ou plusieurs pour le mode Multiple Ys. Maintenez Ctrl ou Commande pour en sélectionner plusieurs. |
Grouping column | Facultatif. Une ligne de points empilés par groupe, chacune dans sa propre couleur et nommée sur l'axe vertical (« With Groups »). |
Number of bins | Facultatif, de 5 à 200. Laissez vide pour le calculer à partir du nombre de valeurs. |
Log scale X-axis | Décochée par défaut. Utilise un axe X logarithmique et des classes égales sur cette échelle. |
Title | Titre affiché sur le graphique. Par défaut Dotplot. |
Discrete color sequence | Palette des groupes ou des colonnes, D3 par défaut. Une colonne unique sans groupes est tracée en bleu marine. |
Exclude outliers (1.5×IQR rule) | Décochée par défaut. Écarte les points au-delà de Q1 − 1.5×IQR et Q3 + 1.5×IQR (par colonne de regroupement, si elle est définie) avant le tracé. |
Data Options: Subset (optional) | Exclude matching rows (par défaut) ou Include only matching rows, sélectionnées par Row numbers (par ex. 3,7,12-15, selon les numéros de ligne d'origine de la grille) et/ou par une Condition (par ex. Fill_Volume_mL > 249). Sans effet si Row numbers ou Condition n'est pas renseigné. |
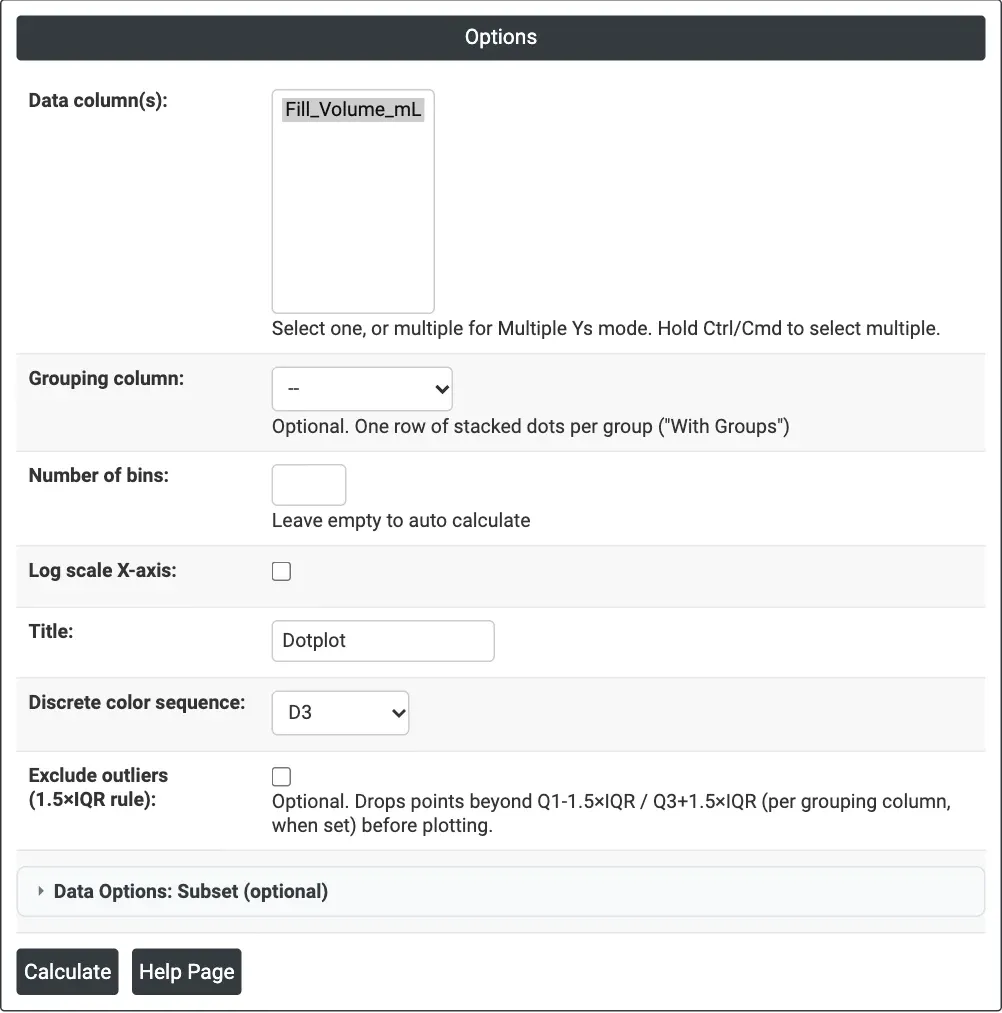
Figure 1 — Diagramme en points du volume de remplissage de 25 bouteilles, avec le nombre de classes calculé automatiquement.
Description des résultats
- Dotplot — des points empilés le long de l'axe X, un point par valeur ; avec des groupes ou plusieurs colonnes, une ligne chacun, nommée sur l'axe vertical.
- Outlier note — lorsque Exclude outliers retire des points : combien ont été exclus.
- Export PDF via Download.
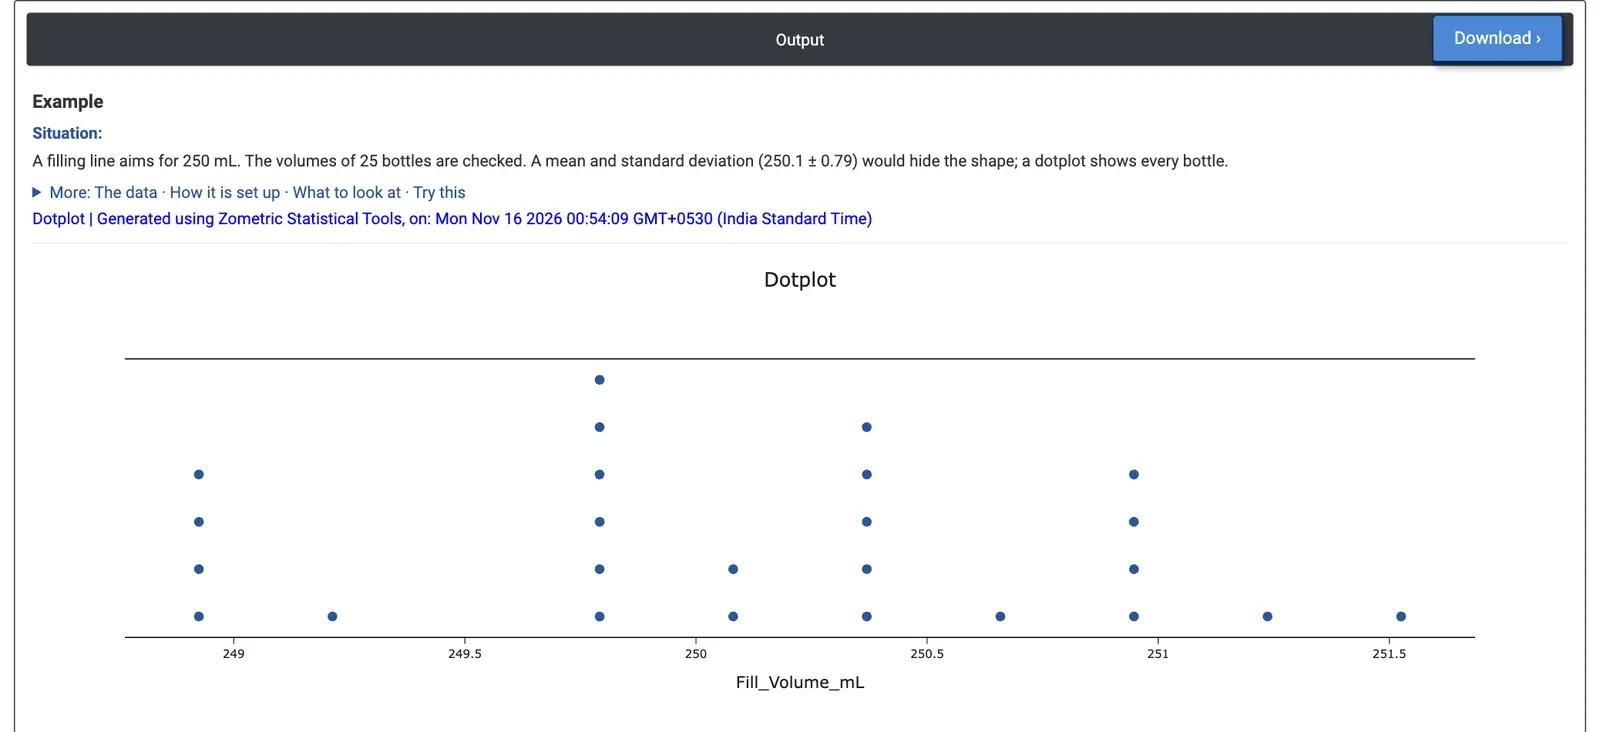
Figure 2 — Volumes de remplissage de 25 bouteilles : amas près de 249.8, 250.4 et 251.0 mL et un groupe distinct de quatre près de 248.9 mL.
Exemple résolu
Une ligne de remplissage vise 250 mL par bouteille. Le responsable de ligne contrôle le volume de 25 bouteilles. La moyenne est de 250.10 mL avec un écart-type de 0.79 mL, ce qui paraît correct, mais de tels chiffres masquent la forme des données. Il sélectionne Data column(s) = Fill_Volume_mL et laisse Number of bins vide ; l'outil utilise donc 10 classes d'environ 0.29 mL de large.
Les remplissages vont de 248.78 à 251.67 mL. Les points ne forment pas une belle cloche : il y a des amas de six bouteilles près de 249.8 mL, cinq près de 250.4 mL et quatre près de 251.0 mL, et un groupe distinct de quatre bouteilles basses près de 248.9 mL (248.78 à 249.05 mL), isolé par un vide sans bouteille entre 249.21 et 249.68 mL. Avec Number of bins = 30, les piles font au plus trois points de haut, mais les quatre bouteilles basses restent à l'écart des autres. Exclude outliers n'en retire aucune, car elles sont à moins de 1.5×IQR des quartiles : elles forment un groupe, et non des points isolés.
Pour la décision, cela signifie de chercher ce qui sépare les bouteilles, par exemple si une buse de remplissage délivre moins, avant de modifier le réglage de l'ensemble de la ligne. Si le numéro de buse est enregistré pour chaque bouteille, l'utiliser comme Grouping column montre directement si les bouteilles basses proviennent d'une seule buse.
Questions fréquentes
Comment lire un diagramme en points ?
Un amas central qui s'amenuise régulièrement des deux côtés est compatible avec une distribution normale. Deux amas ou plus séparés par des vides suggèrent un mélange de sources, comme deux buses, deux équipes ou deux fournisseurs, qu'il vaut la peine de séparer avant toute analyse ultérieure. La hauteur de chaque pile est l'effectif des valeurs de cette classe.
Quand utiliser un diagramme en points plutôt qu'une moyenne et un écart-type ?
Utilisez un diagramme en points chaque fois que la forme des données compte, pour des échantillons allant jusqu'à quelques centaines de valeurs. Dans l'exemple résolu, 25 volumes de remplissage avaient une moyenne de 250.10 mL et un écart-type de 0.79 mL, ce qui paraissait correct, mais le diagramme en points a révélé un groupe distinct de quatre bouteilles basses près de 248.9 mL.
Combien de classes un diagramme en points utilise-t-il ?
Lorsque Number of bins est laissé vide, le nombre est 2 x √n arrondi à l'entier supérieur, borné entre 10 et 60, ce qui donne 10 classes pour 25 valeurs. Chaque valeur est placée au centre de sa classe ; les points montrent donc les valeurs à la classe près, et non exactement. Vous pouvez aussi définir vous-même de 5 à 200 classes.
Comment comparer des groupes dans un diagramme en points ?
Dans Zometric Statistical Software, choisissez une colonne de regroupement pour obtenir une ligne de points empilés par groupe, ou sélectionnez plusieurs colonnes de données. Toutes les lignes partagent les mêmes classes, ce qui permet de les comparer directement. Dans l'exemple du remplissage, un regroupement par numéro de buse montrerait directement si les bouteilles basses provenaient d'une seule buse.