
Lissage exponentiel double
La méthode de Holt met à jour à chaque période un niveau avec le poids alpha et une tendance avec le poids gamma, et prévoit le niveau plus m fois la tendance. Les poids peuvent être spécifiés ou laissés vides pour obtenir les poids optimaux ARIMA(0,2,2), qu'il faut contrôler. Les résultats comprennent des prévisions avec des limites de prévision qui s'élargissent, ainsi que MAPE, MAD et MSD. La série ne doit pas avoir de trous et compter au moins 4 valeurs.
Dernière révision
Point clé
Le lissage exponentiel double (méthode de Holt) lisse une série chronologique avec un niveau et une tendance : les prévisions suivent la dernière tendance ; pour une série avec dérive régulière et sans saisonnalité.
Sur cette page
Objectif
Le lissage exponentiel double (méthode de Holt) lisse une série chronologique avec deux composantes évolutives, un niveau et une tendance, de sorte que ses prévisions continuent de monter ou de descendre à la dernière vitesse de tendance. Utilisez-le pour une série avec une dérive régulière à la hausse ou à la baisse et sans motif saisonnier, par exemple une usure cumulée, une demande qui croît de mois en mois ou une moyenne de procédé qui dérive lentement. Pour des données saisonnières, utilisez la méthode de Winters ou la décomposition.
Fonctionnalités principales
- Poids du niveau (alpha) et poids de la tendance (gamma) que vous spécifiez, ou poids optimaux issus d'un ajustement ARIMA(0,2,2) lorsque les deux sont laissés vides.
- Niveau et tendance de départ issus des données ou de valeurs que vous saisissez.
- Prévisions le long de la dernière tendance avec des limites de prévision qui s'élargissent à chaque période à venir, à partir de la fin de la série ou d'une ligne antérieure.
- Mesures de précision MAPE, MAD et MSD, et graphique des données, des valeurs ajustées et des prévisions.
- Tableau de résultats facultatif (niveau, tendance, prédiction et erreur pour chaque période) et graphiques des résidus quatre en un.
Méthodes statistiques
À chaque période, le niveau et la tendance sont mis à jour : Lₜ = α·yₜ + (1 − α)·(Lₜ₋₁ + Tₜ₋₁) et Tₜ = γ·(Lₜ − Lₜ₋₁) + (1 − γ)·Tₜ₋₁. La valeur ajustée de la période t est Lₜ₋₁ + Tₜ₋₁, et la prévision m périodes après l'origine est L + m·T, avec le niveau et la tendance à l'origine. Un α plus grand permet au niveau de suivre de plus près les valeurs récentes ; un γ plus grand permet à la tendance de changer plus vite.
Avec des poids spécifiés, le niveau et la tendance de départ sont l'ordonnée à l'origine et la pente d'une droite des moindres carrés des données en fonction du temps. Lorsque les poids sont laissés vides, l'outil ajuste un modèle ARIMA(0,2,2) sur les différences secondes par les moindres carrés et convertit ses coefficients : α = 1 + θ₂ et γ = (2 − α − θ₁) / α ; le niveau et la tendance de départ sont recalculés à partir de cet ajustement. Les poids optimaux peuvent sortir de l'intervalle 0 à 1 et doivent être contrôlés. Avec Starting values = User-specified, les Initial level et Initial trend que vous saisissez sont utilisés.
Les limites de prévision sont prévision ± z × dₘ × MAD, où z est le quantile de la loi normale pour le niveau de confiance, MAD est l'erreur absolue moyenne des valeurs ajustées, et dₘ est un facteur qui croît avec le nombre de périodes à venir m (calculé à partir du plus grand de α et γ), si bien que la bande s'élargit davantage dans le futur. Précision : MAPE = moyenne de |erreur / donnée| × 100, MAD = moyenne de |erreur|, MSD = moyenne de erreur². La série ne doit pas avoir de trous et compter au moins 4 valeurs.
Champs de saisie et options
Champ | Description |
Variable (Y) | Obligatoire. La série numérique, dans l'ordre chronologique. |
Level weight (alpha) / Trend weight (gamma) | De 0.0001 à 1. Laissez les deux vides pour utiliser les poids optimaux ARIMA(0,2,2). |
Starting values | From the data (par défaut) : recalculées à partir de l'ajustement ARIMA (poids optimaux) ou de la régression des données sur le temps (poids spécifiés). Ou User-specified. |
Initial level / Initial trend | Utilisés lorsque Starting values est User-specified ; les deux sont alors obligatoires. |
Number of forecasts | 0 par défaut (aucune), jusqu'à 1000. |
Confidence level (%) for forecast interval | 95 par défaut. Actif lorsque des prévisions sont demandées. |
Forecast origin (row) | Facultatif, actif lorsque des prévisions sont demandées. Les prévisions commencent après cette ligne, à partir des données jusqu'à cette ligne ; vide = fin de la série. |
Results to display | Summary table (par défaut) ou Summary table and results table. |
Residual plots (four in one) | Décoché par défaut. Droite de probabilité normale, résidus en fonction des valeurs ajustées, histogramme et résidus en fonction de l'ordre. |
Title | Titre des résultats. Par défaut Double Exponential Smoothing. |
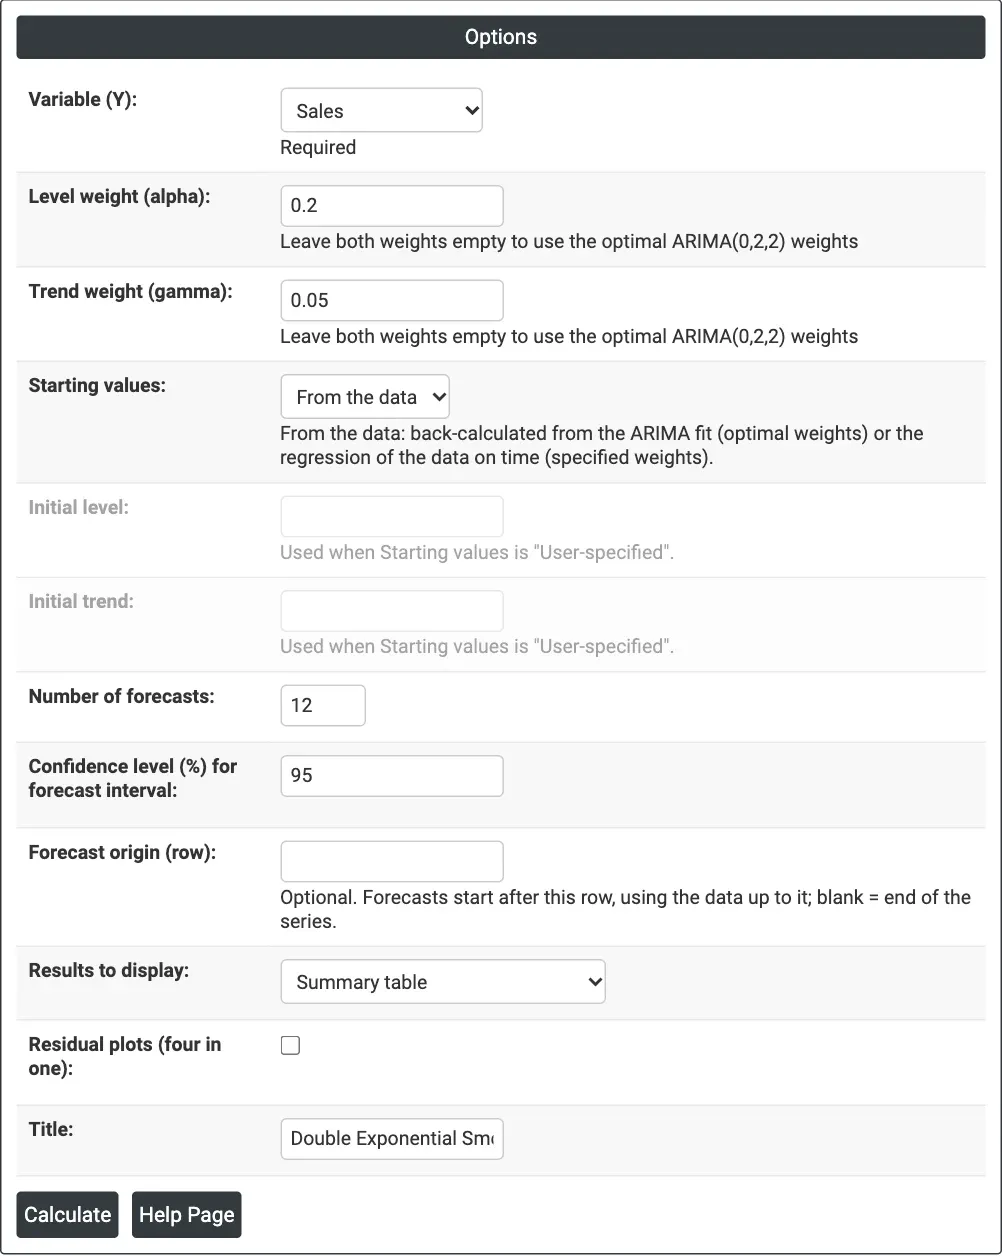
Figure 1 — Monthly Sales avec alpha = 0.2, gamma = 0.05 et 12 prévisions.
Description des résultats
- Double Exponential Smoothing (graph) — données réelles, valeurs ajustées, prévisions et bande de prévision, avec MAPE, MAD et MSD dans le titre et les poids utilisés au-dessus du graphique.
- Method — colonne de données, longueur et indication que les poids sont spécifiés ou optimaux (plus l'origine des prévisions si elle est définie).
- Smoothing Constants — α (niveau) et γ (tendance).
- Accuracy Measures — MAPE, MAD et MSD.
- Forecasts — période, prévision, limites inférieure et supérieure.
- Results — si choisi : Period, data, Level, Trend, Predict et Error pour chaque période.
- Residual Plots — si coché.
- Export PDF via Download.
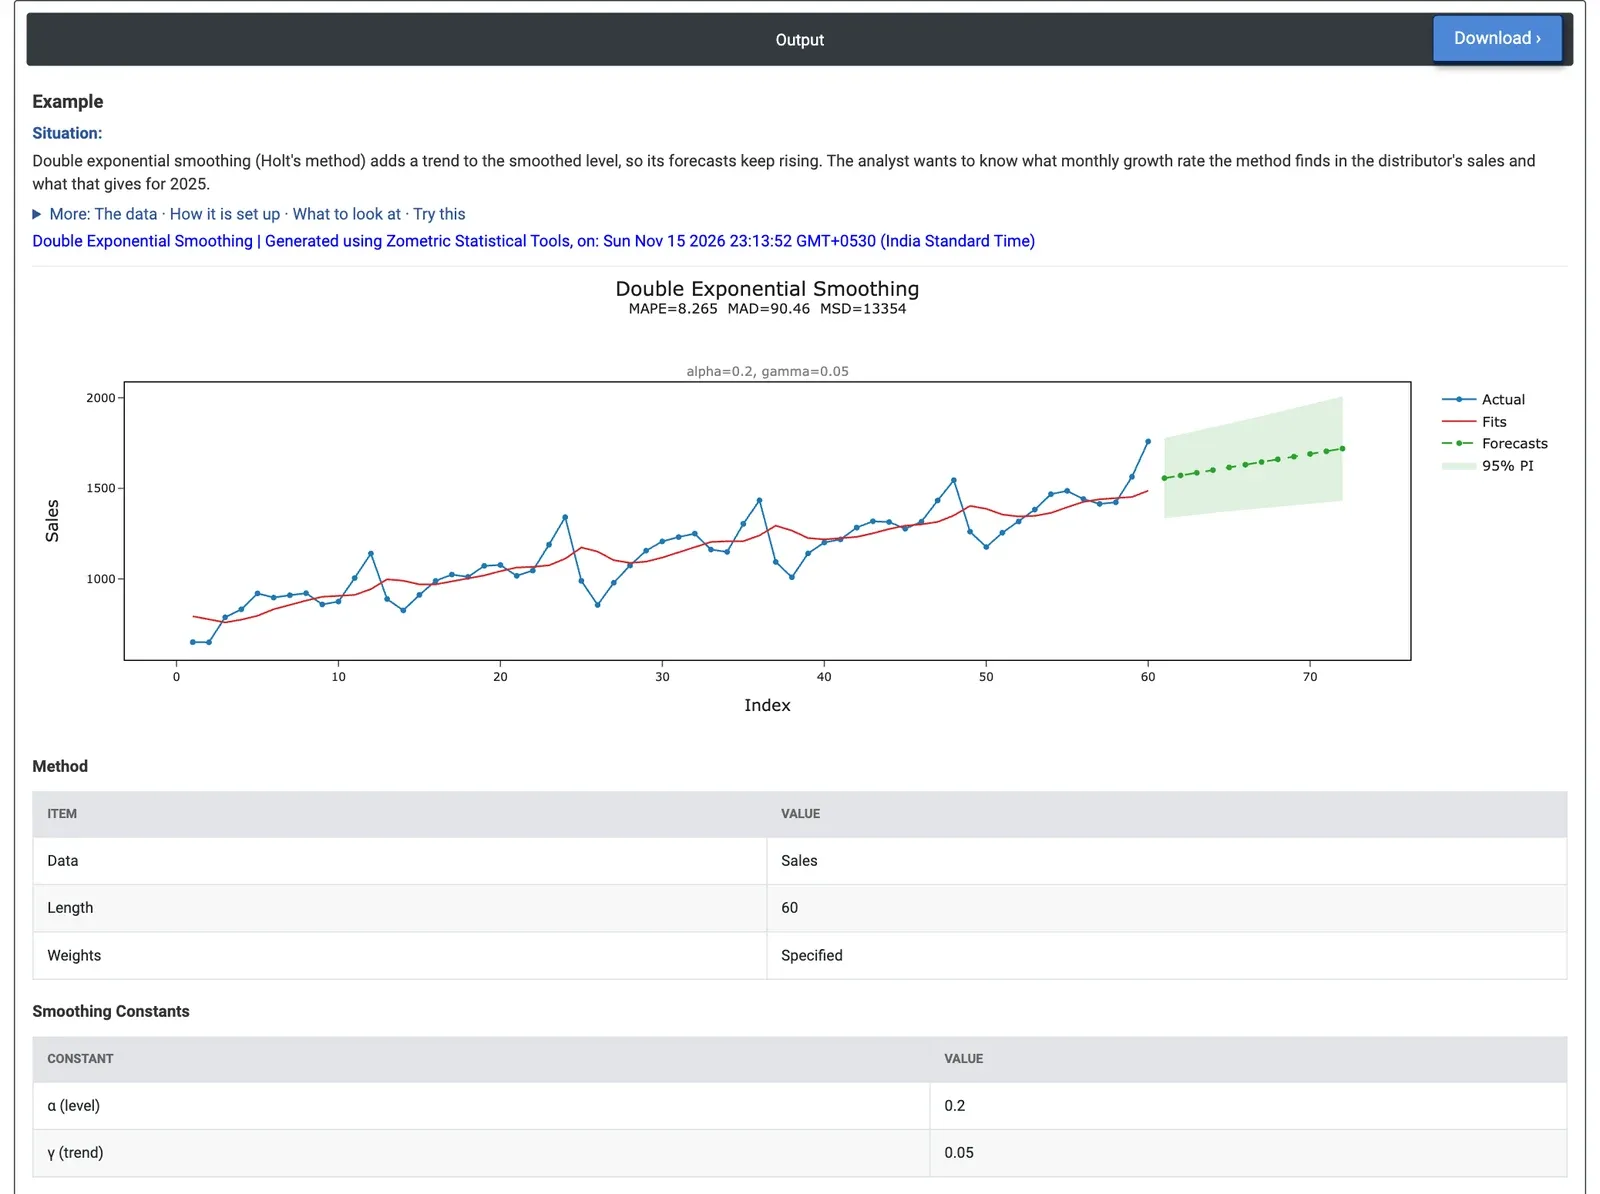
Figure 2 — Méthode de Holt sur les ventes mensuelles : les prévisions de 2025 montent en ligne droite dans une bande à 95 % qui s'élargit.
Exemple résolu
Un distributeur d'électronique grand public dispose de 60 mois de ventes en unités (de janvier 2020 à décembre 2024) qui croissent chaque année. L'analyste commercial veut savoir quelle croissance mensuelle la méthode de Holt trouve et ce qu'elle donne pour 2025. Il sélectionne Variable (Y) = Sales, saisit Level weight (alpha) = 0.2 et Trend weight (gamma) = 0.05 (un niveau qui suit doucement les données et une tendance qui change lentement, pour que la saison ne bouscule pas la tendance) et règle Number of forecasts = 12.
À la fin de 2024, la tendance est de 14.85 unités par mois : les prévisions montent donc en ligne droite de 1,556 en janvier 2025 à 1,719 en décembre 2025. L'intervalle à 95 % s'élargit à chaque mois à venir : de 1,334 à 1,778 pour janvier et de 1,431 à 2,008 pour décembre. Le MAPE est de 8.3 % (MAD 90.5), mieux que le lissage simple (9.4 %) mais loin derrière la méthode de Winters (4.2 %) et la décomposition (2.2 %), car la méthode ne tient pas compte de la saison. La prévision de 1,556 pour janvier est probablement trop haute : chaque année, les ventes chutent fortement de décembre à janvier (1,759 en décembre 2024, mais 1,261 en janvier 2024).
Avec les deux poids laissés vides, les poids optimaux ARIMA sont alpha 1.42 et gamma 0.0001. L'ajustement change à peine (MAPE 8.3 %), mais les prévisions grimpent à 3,301 en décembre 2025, car le niveau réagit de façon excessive au pic de décembre 2024. Les poids optimaux doivent être contrôlés ; ici, les variations saisonnières les faussent. Pour la décision : utilisez la méthode de Holt pour une tendance sans saison, et la méthode de Winters pour ces données.
Questions fréquentes
Quand utiliser le lissage exponentiel double ?
Utilisez-le pour une série avec une dérive régulière à la hausse ou à la baisse et sans motif saisonnier, comme une usure cumulée, une demande qui croît de mois en mois ou une moyenne de procédé qui dérive lentement. Pour des données saisonnières, utilisez la méthode de Winters ou la décomposition ; dans l'exemple résolu sur des ventes saisonnières, la méthode de Holt avait un MAPE de 8.3 % contre 4.2 % pour la méthode de Winters.
À quoi servent les poids alpha et gamma ?
Alpha est le poids du niveau : un alpha plus grand permet au niveau de suivre de plus près les valeurs récentes. Gamma est le poids de la tendance : un gamma plus grand permet à la tendance de changer plus vite. Les poids spécifiés vont de 0.0001 à 1. Laisser les deux vides utilise les poids optimaux d'un ajustement ARIMA(0,2,2), qui peuvent sortir de l'intervalle 0 à 1.
Pourquoi les limites de prévision s'élargissent-elles dans la méthode de Holt ?
Les limites sont la prévision plus ou moins z x dₘ x MAD, où z est le quantile de la loi normale pour le niveau de confiance, MAD est l'erreur absolue moyenne des valeurs ajustées, et dₘ est un facteur qui croît avec le nombre de périodes à venir. La bande s'élargit donc davantage dans le futur.
Faut-il se fier aux poids de lissage optimaux ?
Les poids optimaux doivent être contrôlés. Dans l'exemple, les poids optimaux étaient alpha 1.42 et gamma 0.0001 ; l'ajustement a à peine changé, mais les prévisions ont grimpé à 3,301 pour décembre 2025, car le niveau a réagi de façon excessive au pic de décembre 2024. Les variations saisonnières avaient faussé les poids.