
Fonction de répartition empirique (Empirical CDF)
L'Empirical CDF trie les valeurs et place chacune à (i − 0.5) / n en pourcentage, reliées en escalier. Utilisez-la pour comparer des groupes au-delà de leurs moyennes, lire la part de pièces sous une limite, ou confronter les données à une distribution ajustée comme Normal ou Weibull. Une colonne By donne une courbe par groupe, et plusieurs variables peuvent être superposées.
Dernière révision
Point clé
Une fonction de répartition empirique (Empirical CDF) trace, pour chaque valeur mesurée, le pourcentage d'observations inférieures ou égales, en escalier : médiane, dispersion, queues et trous de toute la distribution d'un coup.
Sur cette page
Objectif
L'Empirical CDF (fonction de répartition empirique) trace, pour chaque valeur d'une mesure, le pourcentage d'observations qui lui sont inférieures ou égales. Le résultat est une courbe en escalier qui montre toute la distribution d'un coup : la médiane, la dispersion, les queues et d'éventuels trous. Utilisez-la pour comparer deux groupes ou plus (machines, fournisseurs, configurations) au-delà de leurs moyennes, pour lire la part de pièces sous une limite, ou pour confronter les données à une distribution ajustée.
Fonctionnalités principales
- Une courbe en escalier par variable, ou par groupe d'une variable lorsqu'une colonne By est choisie.
- Plusieurs variables superposées sur un même graphique pour une comparaison directe.
- Distribution ajustée facultative superposée en trait pointillé : Normal, Lognormal, Weibull, Exponential, 2-Parameter Exponential, Smallest ou Largest Extreme Value, Logistic ou Loglogistic.
- Échelle en pourcentage de 0 à 100 sur l'axe vertical, pour lire les percentiles directement sur la courbe.
- Les lignes peuvent être exclues ou conservées par numéro de ligne ou selon une condition avant le tracé.
Méthodes statistiques
Pour chaque courbe, les valeurs numériques non vides sont triées, x₁ ≤ x₂ ≤ … ≤ xₙ, et la i-ième valeur est placée à la position de tracé pᵢ = (i − 0.5) / n, affichée en pourcentage. Les points sont reliés en escalier (horizontal puis vertical), si bien que la courbe monte de 100/n pour cent à chaque observation. La valeur où une courbe croise 50 % est la médiane de ce groupe ; celle où elle croise 90 % est le 90e percentile.
Avec une colonne By et une seule variable, les lignes sont réparties selon les niveaux de la colonne By et chaque niveau a sa propre courbe. Avec plusieurs variables, chaque variable a une courbe et la colonne By est ignorée.
Lorsqu'une distribution ajustée est choisie, ses paramètres sont estimés séparément pour chaque courbe (chaque groupe ou chaque variable), comme dans Minitab, et chaque fonction de répartition ajustée est tracée sur l'étendue de ses propres données. La distribution Normal utilise la moyenne et l'écart-type de l'échantillon ; les autres distributions utilisent le maximum de vraisemblance (Lognormal, Weibull, Exponential et Loglogistic avec le seuil fixé à 0, elles exigent donc des valeurs positives). La légende indique les paramètres ajustés de chaque courbe, ce qui permet de confronter chaque groupe à son propre modèle.
Champs de saisie et options
Champ | Description |
Variables | Une ou plusieurs colonnes numériques. Sélectionnez une variable, ou plusieurs pour superposer leurs courbes. |
By (grouping) column | Facultatif. Une courbe par niveau de cette colonne. Utilisé uniquement lorsqu'une seule variable est sélectionnée. |
Overlay fitted distribution | Par défaut « --- (empirical only) » : aucune droite ajustée. Ou l'une des options Normal, Lognormal, Weibull, Exponential, 2-Parameter Exponential, Smallest Extreme Value, Largest Extreme Value, Logistic, Loglogistic. |
Title | Titre du graphique. Par défaut « Empirical CDF ». |
Data Options: Subset (optional) | Exclude matching rows (par défaut) ou Include only matching rows ; Row numbers (par ex. 3,7,12-15) et/ou une Condition (par ex. Weight_kg > 100) sélectionnent les lignes. Sans effet lorsque les deux sont vides. |
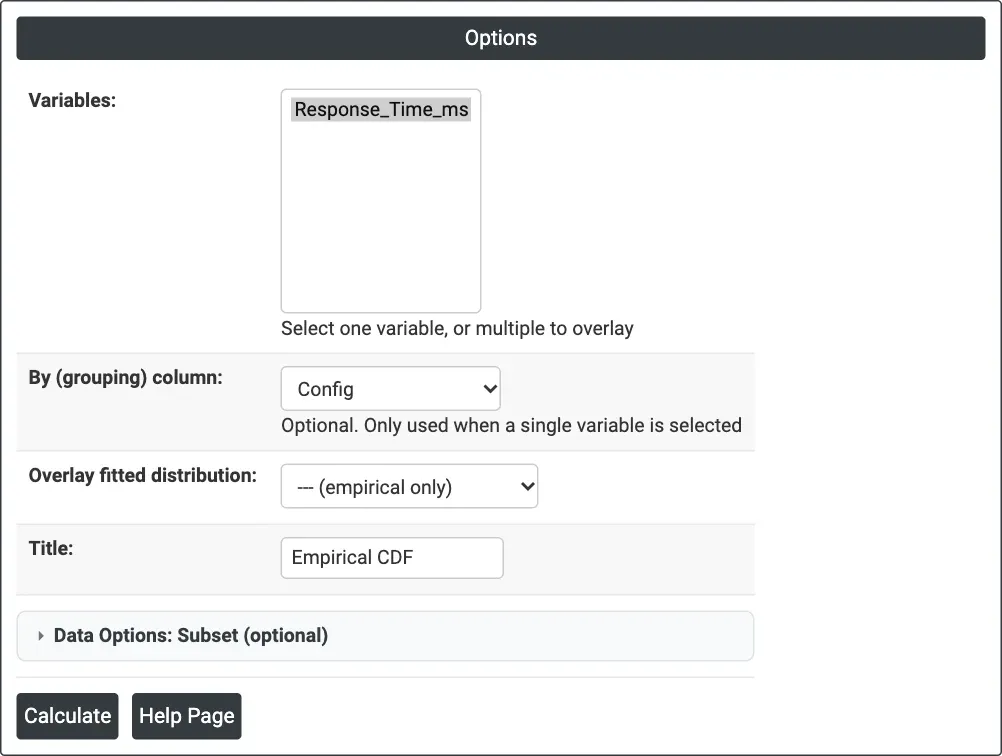
Figure 1 — Options de l'exemple : Variables = Response_Time_ms, By (grouping) column = Config, sans distribution ajustée.
Description des résultats
- Empirical CDF — courbe en escalier du pourcentage en fonction de la variable pour chaque groupe ou variable, avec des marqueurs à chaque observation et une légende nommant les courbes ; la distribution ajustée, si elle est choisie, est un trait pointillé pour chaque courbe, de la couleur de la courbe (noir lorsqu'il n'y a qu'une courbe), accompagné de ses paramètres.
- Export PDF via Download.
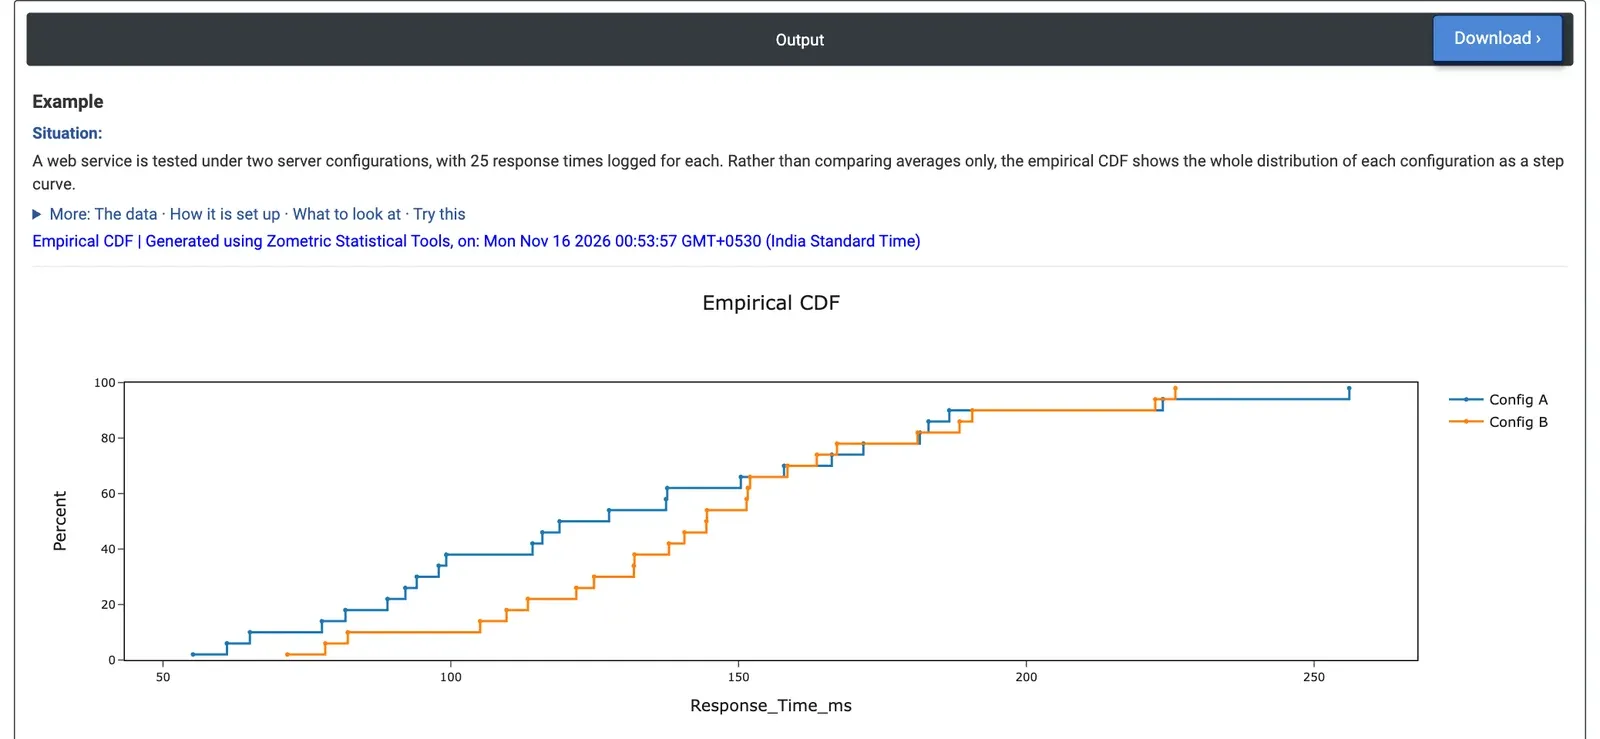
Figure 2 — Fonction de répartition empirique du temps de réponse pour Config A (bleu) et Config B (orange), 25 requêtes chacune.
Exemple résolu
Une équipe informatique teste un service web avec deux configurations de serveur et enregistre 25 temps de réponse (ms) pour chacune. Les moyennes seules (129.7 ms pour A, 143.6 ms pour B) laissent penser que A est plus rapide, mais l'équipe veut savoir comment se comparent les distributions entières, surtout les requêtes lentes que les utilisateurs remarquent. Elle sélectionne Response_Time_ms comme variable et Config comme colonne By, sans distribution ajustée.
En lisant à 50 %, la médiane est de 118.9 ms pour Config A et de 144.4 ms pour Config B : sur la majeure partie de l'étendue, la courbe de B se situe à droite, donc une requête typique est plus lente avec B. À 150 ms, 64 % des requêtes de A sont terminées contre 56 % de celles de B. En haut, les courbes se croisent : la requête la plus lente de A prend 256.1 ms contre 225.9 ms pour la plus lente de B, et la dispersion de A est plus large (écart-type 51.8 contre 39.7 ms). Les deux configurations ont 92 % des requêtes sous 200 ms. B est donc plus lente pour une requête typique tandis que A a la queue la plus longue ; le choix dépend de ce qui compte le plus pour le service, la médiane ou le pire cas.
Choisir Normal comme superposition ajoute une courbe normale en pointillé pour chaque configuration, ajustée sur ses propres 25 valeurs : moyenne 129.7 ms et écart-type 51.8 ms pour A, moyenne 143.6 ms et écart-type 39.7 ms pour B. Lorsqu'une courbe en escalier s'écarte de sa courbe pointillée, les temps de réponse de cette configuration ne sont pas normaux.
Questions fréquentes
Comment lire une fonction de répartition empirique ?
La courbe monte de 100/n pour cent à chaque observation. Lisez à 50 % pour trouver la médiane de chaque groupe et à 90 % pour le 90e percentile, ou lisez vers le haut à partir d'une limite pour voir la part des valeurs situées en dessous. Dans l'exemple résolu, le temps de réponse médian était de 118.9 ms pour Config A et de 144.4 ms pour Config B.
Pourquoi comparer des groupes avec une fonction de répartition empirique plutôt qu'avec des moyennes ?
Les moyennes masquent les différences de dispersion et de queues. Dans l'exemple résolu, Config A avait la moyenne et la médiane de temps de réponse les plus basses, mais les courbes se croisaient en haut : la requête la plus lente de A prenait 256.1 ms contre 225.9 ms pour la plus lente de B. La fonction de répartition montre si c'est le cas typique ou le pire cas qui diffère.
Comment confronter des données à une distribution ajustée ?
Choisissez une distribution à superposer, comme Normal, Lognormal, Weibull, Exponential, Logistic ou une distribution des valeurs extrêmes. Ses paramètres sont estimés séparément pour chaque courbe et tracés en pointillé. Lorsqu'une courbe en escalier s'écarte de sa courbe pointillée, les données ne suivent pas cette distribution. Lognormal, Weibull, Exponential et Loglogistic exigent des valeurs positives.
Comment comparer des groupes dans Zometric Statistical Software ?
Sélectionnez une seule variable et une By (grouping) column pour obtenir une courbe en escalier par niveau, ou sélectionnez plusieurs variables pour superposer leurs courbes, auquel cas la colonne By est ignorée. Les lignes peuvent être exclues ou conservées par numéro de ligne ou selon une condition avant le tracé, avec Data Options.