
Ajuster un modèle à effets mixtes
Fit Mixed Effects Model teste des facteurs catégoriels fixes et des covariables tout en estimant des composantes de la variance pour des facteurs aléatoires comme les lots, les opérateurs ou les jours. Utilisez-le lorsque ignorer les facteurs aléatoires rendrait les tests des facteurs fixes trop optimistes. Chaque facteur aléatoire doit avoir au moins 3 niveaux. Les résultats comprennent les composantes de la variance, des tests F avec degrés de liberté de Satterthwaite, des coefficients et un résumé du modèle avec AICc et BIC.
Dernière révision
Point clé
Un modèle à effets mixtes analyse une réponse qui dépend de facteurs fixes, dont vous comparez les niveaux, et de facteurs aléatoires échantillonnés dans une population, en testant les facteurs fixes et en estimant la variance aléatoire.
Sur cette page
Objectif
Fit Mixed Effects Model analyse une réponse qui dépend de deux types de facteurs : les facteurs fixes, dont vous voulez comparer des niveaux précis (deux machines, trois fournisseurs, une méthode nouvelle et une ancienne), et les facteurs aléatoires, dont les niveaux sont un échantillon d'une population plus large (lots, échantillons, opérateurs, jours). Il teste les facteurs fixes et estime la part de variance qu'apporte chaque facteur aléatoire. Utilisez-le lorsque ignorer les facteurs aléatoires rendrait les tests des facteurs fixes trop optimistes, par exemple lorsque les mêmes lots ou pièces sont mesurés dans toutes les conditions.
Principales fonctionnalités
- Un ou plusieurs facteurs catégoriels fixes et covariables continues, avec un ou plusieurs facteurs aléatoires.
- Composantes de la variance de chaque facteur aléatoire et de l'erreur, avec % du total, erreur standard, test Z et intervalle de confiance.
- Tests F des effets fixes avec degrés de liberté du dénominateur de Satterthwaite.
- Coefficients avec degrés de liberté de Satterthwaite, tests t et intervalles de confiance.
- Résumé du modèle avec S, R-sq, R-sq(adj), AICc, BIC et −2 log vraisemblance.
- Estimation par maximum de vraisemblance restreint (REML) ou par maximum de vraisemblance (ML).
- Data Options : sélection d'un sous-ensemble de lignes avant l'analyse.
Méthodes statistiques
Le modèle est y = Xβ + Σ Zᵢuᵢ + ε, où Xβ contient les facteurs fixes (codage à somme nulle −1/0/+1) et les covariables, chaque facteur aléatoire i ajoute des effets indépendants uᵢ de variance σᵢ², et les erreurs ε ont une variance σ². Les facteurs aléatoires sont des composantes de la variance indépendantes (aucune interaction n'est ajustée). Les variances sont estimées par REML (par défaut), qui tient compte des degrés de liberté utilisés par les effets fixes et donne des composantes de la variance presque sans biais, ou par ML, nécessaire pour comparer par AICc ou BIC des modèles ayant des effets fixes différents. Les lignes comportant une valeur manquante sont écartées ; chaque facteur aléatoire doit avoir au moins 3 niveaux.
Une fois les variances estimées, les coefficients fixes sont des estimations des moindres carrés généralisés. Chaque terme fixe est testé par une statistique F dont les degrés de liberté du dénominateur proviennent de l'approximation de Satterthwaite, et chaque coefficient par un test t sur des degrés de liberté de Satterthwaite. Les composantes de la variance ont des erreurs standard issues de l'information de Fisher, un test Z unilatéral Z = Var / SE Var de nullité de la composante, et un intervalle de confiance calculé sur l'échelle logarithmique, de sorte qu'il n'est jamais négatif. Avec peu de niveaux d'un facteur aléatoire, ce test Z a peu de puissance et l'intervalle est large.
R-sq compare les ajustements conditionnels (effets fixes plus effets aléatoires prédits) à la variation totale. S est la racine carrée de la variance de l'erreur. AICc et BIC sont plus petits pour les meilleurs modèles ; avec REML, ils ne permettent de comparer que des modèles ayant les mêmes effets fixes.
Champs de saisie et options
Champ | Description |
Response (Y) | Colonne de réponse numérique. Obligatoire. |
Fixed factors (categorical) | Une ou plusieurs colonnes dont les niveaux précis présentent un intérêt direct. Obligatoire. |
Random factors (categorical) | Une ou plusieurs colonnes dont les niveaux sont un échantillon aléatoire d'une population plus large (par ex. Field, Batch, Operator), modélisées comme des composantes de la variance indépendantes. Obligatoire. |
Covariates (continuous) | Colonnes numériques facultatives, saisies uniquement comme effets principaux fixes. |
Confidence level | 95 par défaut. |
Estimation method | Restricted maximum likelihood (REML), par défaut, ou Maximum likelihood (ML). |
Data Options: Subset (optional) | Exclude matching rows (par défaut) ou Include only matching rows, par numéros de ligne et/ou par une condition. |
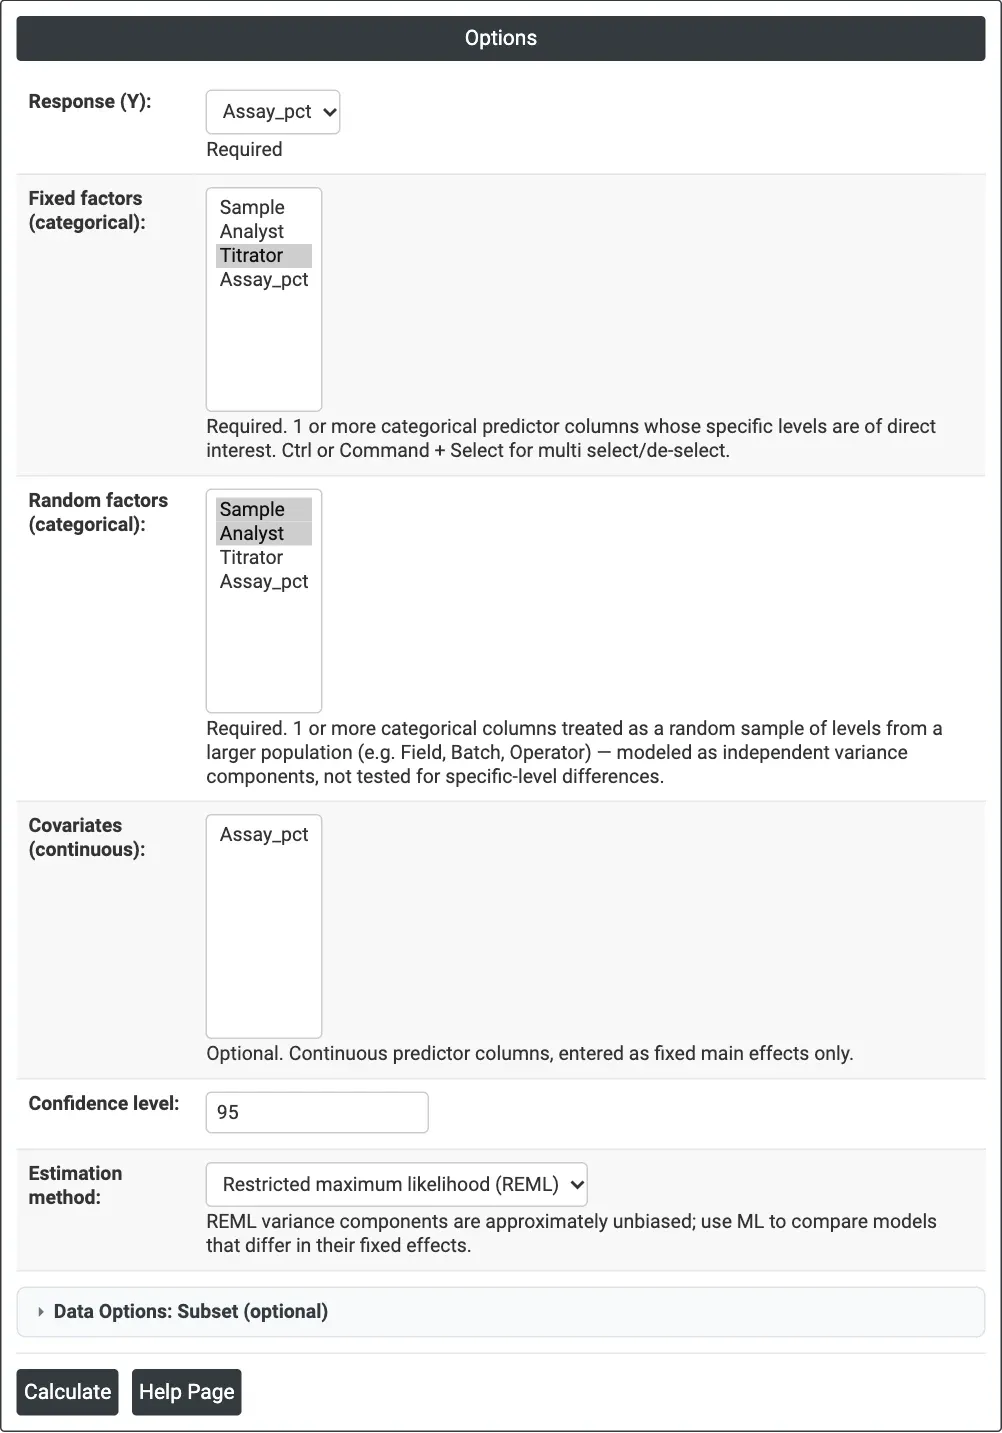
Figure 1 — Options de l'exemple des titrateurs : Assay_pct comme réponse, Titrator comme facteur fixe, Sample et Analyst comme facteurs aléatoires, REML.
Description des résultats
- Method — la méthode d'estimation des variances et la méthode des degrés de liberté pour les effets fixes.
- Variance Components — Var, % of Total, SE Var, Z-Value, P-Value et intervalle de confiance pour chaque facteur aléatoire, l'erreur et le total.
- Tests of Fixed Effects — DF Num, DF Den, F-Value et P-Value pour chaque facteur fixe et chaque covariable.
- Model Summary — S, R-sq, R-sq(adj), AICc, BIC et −2 log vraisemblance.
- Coefficients — Coef, SE Coef, DF, T-Value, P-Value et intervalle de confiance.
- Un avertissement s'affiche si l'optimiseur n'a pas totalement convergé.
- Export PDF via Download.
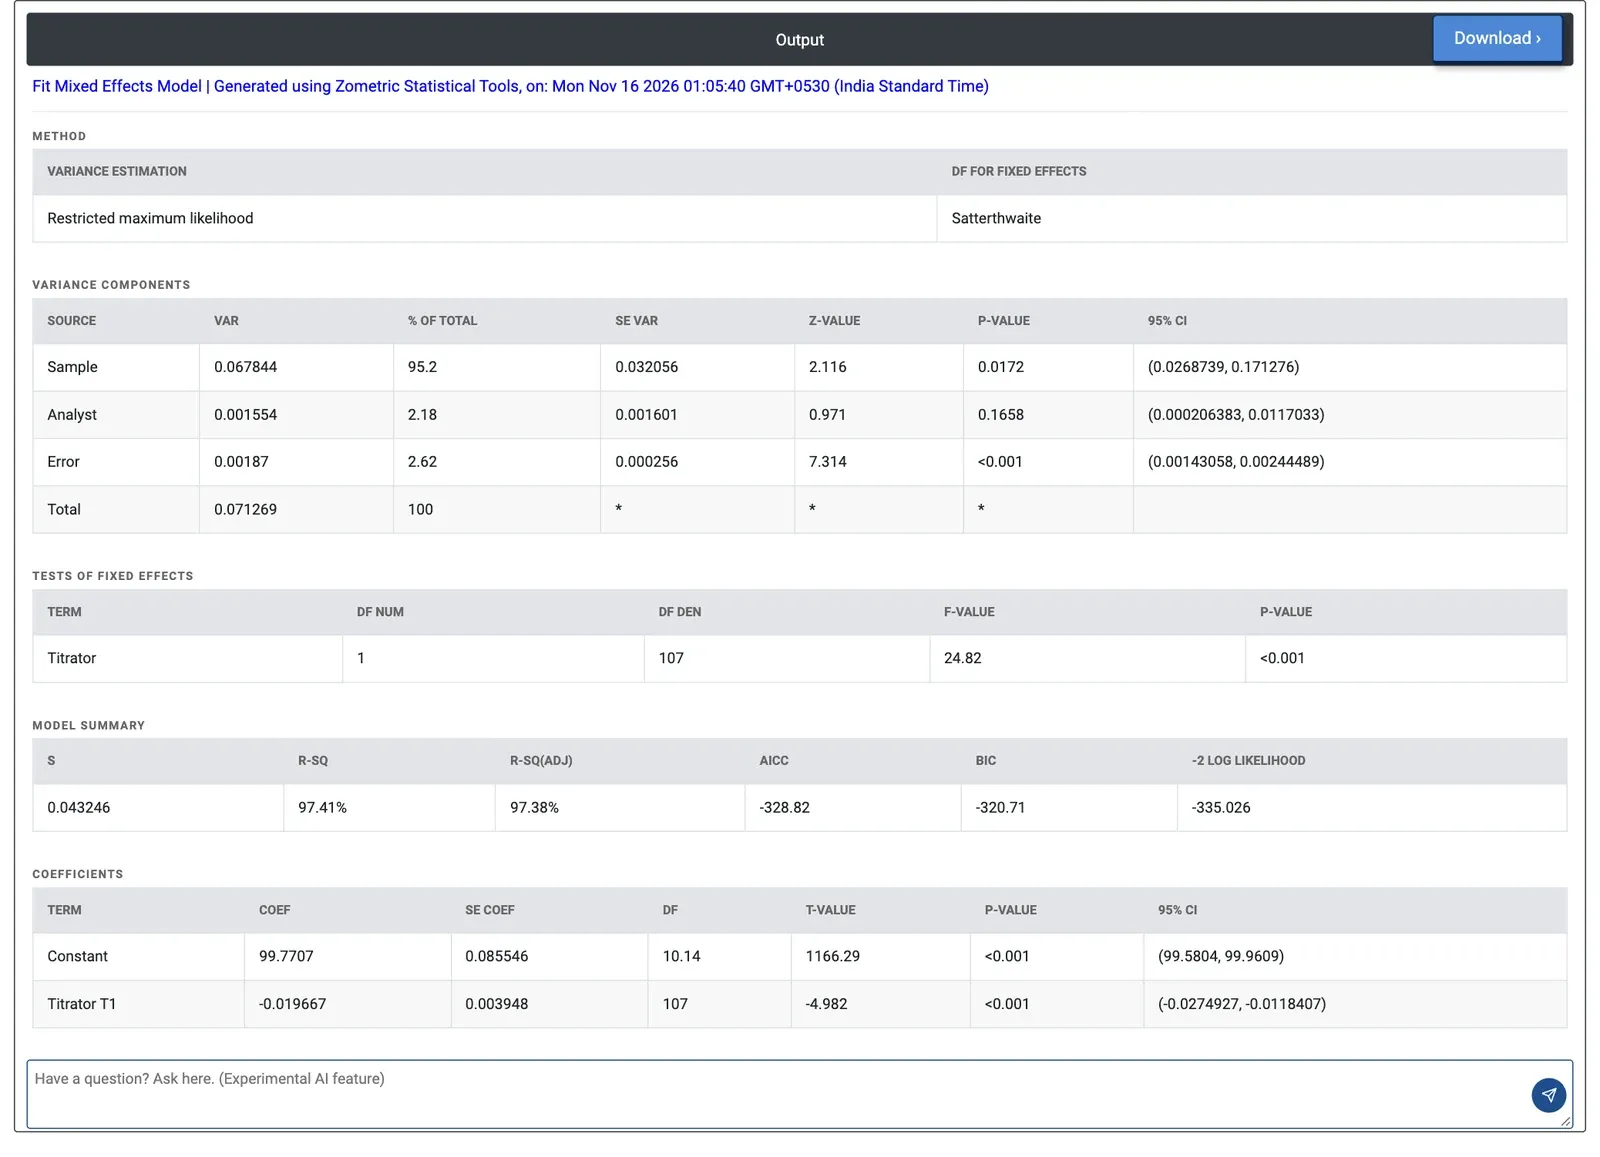
Figure 2 — Modèle mixte des résultats de dosage : les échantillons expliquent 95.2 % de la variance, et les deux titrateurs diffèrent (F = 24.82, p < 0.001).
Exemple résolu
Un laboratoire de carbonate de sodium mesure la pureté d'un produit (Assay_pct) sur deux titrateurs automatiques, T1 et T2. Dix échantillons sont mesurés chacun deux fois par trois analystes sur les deux titrateurs : 120 résultats. La question est de savoir si les deux titrateurs donnent le même résultat. Les titrateurs sont les deux instruments que possède le laboratoire ; Titrator est donc un facteur fixe ; les échantillons et les analystes représentent de nombreux échantillons et analystes possibles ; ce sont donc des facteurs aléatoires. Le laboratoire saisit Assay_pct comme réponse, Titrator comme facteur fixe et Sample et Analyst comme facteurs aléatoires, avec REML. Load Example renseigne ces données (soda-ash-assay-expanded-grr, la même étude que l'exemple Gage R&R Study (Expanded)) et ces paramètres.
Les composantes de la variance montrent que ce sont les échantillons eux-mêmes qui diffèrent le plus : 0.0678 (95.2 % du total, écart-type d'environ 0.26 point de pourcentage). La composante analyste est faible, 0.00155 (2.18 %), et non significativement différente de zéro (p = 0.1658) ; l'erreur, la répétabilité d'un résultat unique, est de 0.00187 (écart-type 0.043).
Titrator est significatif : F = 24.82 sur 1 et 107 degrés de liberté, p < 0.001. Le coefficient de T1 est −0.0197 avec le codage à somme nulle ; T2 donne donc une lecture supérieure d'environ 0.039 point de pourcentage à celle de T1, soit près d'un écart-type de répétabilité. Comme chaque échantillon a été mesuré sur les deux titrateurs, la dispersion entre échantillons ne masque pas cette différence. Le laboratoire décide de vérifier l'étalonnage des deux titrateurs par rapport à un étalon de référence.
Questions fréquentes
Quelle est la différence entre un facteur fixe et un facteur aléatoire ?
Un facteur fixe a des niveaux précis que vous voulez comparer, comme deux machines, trois fournisseurs, ou une méthode nouvelle et une ancienne. Un facteur aléatoire a des niveaux qui sont un échantillon d'une population plus large, comme des lots, des échantillons, des opérateurs ou des jours. Un modèle à effets mixtes teste les facteurs fixes et estime la part de variance qu'apporte chaque facteur aléatoire.
Quand utiliser un modèle à effets mixtes ?
Utilisez un modèle à effets mixtes lorsque ignorer les facteurs aléatoires rendrait les tests des facteurs fixes trop optimistes, par exemple lorsque les mêmes lots ou pièces sont mesurés dans toutes les conditions. Dans l'exemple des titrateurs, dix échantillons ont été mesurés sur les deux titrateurs ; la dispersion entre échantillons n'a donc pas masqué la différence entre titrateurs.
Faut-il utiliser l'estimation REML ou ML pour un modèle mixte ?
REML, par défaut, tient compte des degrés de liberté utilisés par les effets fixes et donne des composantes de la variance presque sans biais. ML est nécessaire pour comparer par AICc ou BIC des modèles ayant des effets fixes différents. Avec REML, AICc et BIC ne permettent de comparer que des modèles ayant les mêmes effets fixes.
Comment interpréter le tableau des composantes de la variance ?
Chaque facteur aléatoire et l'erreur ont une variance, son pourcentage du total, une erreur standard, un test Z unilatéral de nullité de la composante et un intervalle de confiance calculé sur l'échelle logarithmique de sorte qu'il n'est jamais négatif. Avec peu de niveaux d'un facteur aléatoire, le test Z a peu de puissance et l'intervalle est large.