
Ajuster un modèle de régression
Fit Regression Model ajuste une équation de régression pour une réponse continue avec plusieurs prédicteurs continus et qualitatifs. Utilisez-le pour la prédiction, l'analyse de relations et la prévision ; une réponse qualitative requiert une régression logistique. Recueillez des données représentatives et exactes, vérifiez la multicolinéarité avec le VIF et validez avec les graphiques des résidus. Les tests utilisent les sommes des carrés Adjusted (Type III, par défaut) ou Sequential (Type I), avec des intervalles de confiance à 95% par défaut.
Dernière révision
Point clé
Fit Regression Model construit une équation qui quantifie l'influence d'un ou plusieurs prédicteurs continus ou qualitatifs sur une réponse continue, pour identifier les variables significatives et prédire des résultats.
Sur cette page
Qu'est-ce que Fit Regression Model ?
Fit Regression Model est un outil statistique servant à examiner et quantifier la relation entre une ou plusieurs variables prédictives et une variable de réponse continue. Contrairement à Fit Line Model, qui ne gère qu'un seul prédicteur, Fit Regression Model prend en charge plusieurs prédicteurs, continus comme qualitatifs, ce qui le rend plus polyvalent pour l'analyse de données réelles.
Il construit à travers vos données une équation mathématique qui décrit au mieux l'influence collective des prédicteurs sur la réponse. Cette équation peut ensuite servir à comprendre des tendances, identifier les variables significatives et prédire des résultats futurs.
Définition simple : un outil qui trouve la meilleure relation mathématique entre plusieurs variables d'entrée et une variable de sortie, pour comprendre les tendances et faire des prédictions précises.
Quand utiliser Fit Regression Model ?
Un modèle de régression ajusté s'utilise généralement lorsqu'il faut analyser la relation entre une ou plusieurs variables indépendantes et une variable dépendante. C'est un outil utile pour prédire et comprendre le comportement d'une variable dépendante à partir des valeurs des variables indépendantes.
Voici quelques scénarios courants où un modèle de régression ajusté peut être utile :
- Modélisation prédictive: si vous voulez prédire la valeur d'une variable dépendante à partir des valeurs d'une ou plusieurs variables indépendantes, un modèle de régression ajusté peut être utile. Par exemple, vous pouvez vouloir prédire les ventes d'un produit en fonction de facteurs comme le prix, la publicité et les données démographiques des clients.
- Analyse de relations : si vous voulez comprendre la relation entre une variable dépendante et une ou plusieurs variables indépendantes, un modèle de régression ajusté peut vous aider. Par exemple, vous pouvez vouloir comprendre la relation entre le revenu et le niveau d'études, ou entre les habitudes d'exercice et la santé.
- Prévision: si vous voulez prévoir les valeurs futures d'une variable dépendante à partir de données historiques, un modèle de régression ajusté peut être utile. Par exemple, vous pouvez vouloir prévoir les ventes futures à partir de données de ventes historiques et d'autres variables comme des indicateurs économiques et des tendances saisonnières.
- Les prédicteurs peuvent être continus, qualitatifs, ou une combinaison des deux.
- Les variables discrètes peuvent être traitées comme continues ou qualitatives selon le nombre de niveaux et l'objectif de l'analyse.
- La variable de réponse doit être continue.
- Une réponse qualitative a peu de chances de respecter les hypothèses du modèle ou de produire des prédictions exactes.
En général, un modèle de régression ajusté peut être utile chaque fois qu'il faut comprendre ou prédire le comportement d'une variable dépendante à partir d'une ou plusieurs variables indépendantes.
Recommandations pour bien utiliser Fit Regression Model
- Utilisez une variable de réponse continue avec un ou plusieurs prédicteurs continus ou qualitatifs ; si la réponse est qualitative ou un comptage, appliquez plutôt le modèle logistique ou de Poisson approprié.
- Assurez-vous que les données représentent fidèlement la population cible; des échantillons biaisés ou incomplets conduisent à des résultats peu fiables.
- Recueillez suffisamment de points de données pour obtenir la précision statistique nécessaire et garantir un modèle de régression stable.
- Mesurez toutes les variables aussi exactement et précisément que possible; les erreurs de mesure affectent directement la qualité du modèle ajusté.
- Enregistrez les données dans l'ordre où elles sont recueillies pour aider à détecter d'éventuelles tendances ou structures temporelles dans les résidus.
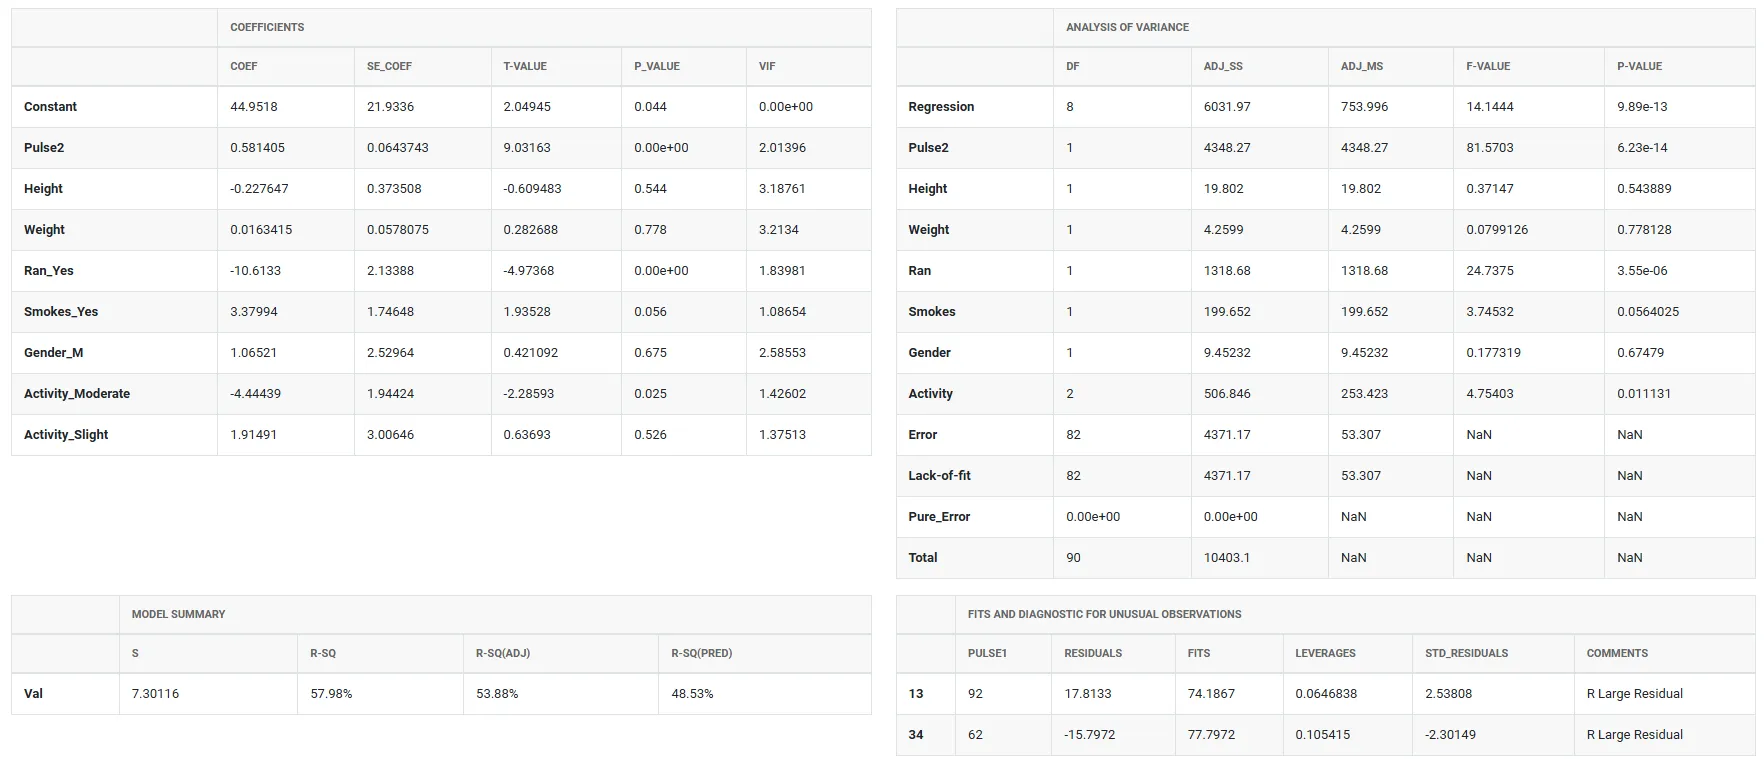
- Vérifiez la multicolinéarité entre les prédicteurs : si elle est sévère, il devient difficile d'identifier quels prédicteurs sont réellement significatifs. Utilisez les facteurs d'inflation de la variance (VIF) du tableau Coefficients pour évaluer sa sévérité.
- Après l'ajustement, validez le modèle avec les graphiques des résidus, les statistiques de diagnostic et les statistiques récapitulatives du modèle; un modèle mal ajusté peut conduire à des conclusions trompeuses
Alternatives : quand ne pas utiliser Fit Regression Model
- Pour visualiser la relation entre un prédicteur continu et une réponse continue, utilisez un Fitted Line Plot.
- Pour une variable de réponse à deux catégories, utilisez Fit Binary Logistic Model.
- Pour des variables de réponse à trois catégories ou plus avec un ordre naturel, comme de « tout à fait en désaccord » à « tout à fait d'accord », utilisez Ordinal Logistic Regression.
- Pour des variables de réponse à trois catégories ou plus sans ordre naturel, comme rayure, bosse et déchirure, utilisez Nominal Logistic Regression.
Exemple de modèle de régression ajusté
Un chercheur en médecine veut étudier les effets de divers facteurs sur le pouls. Il relève la taille, le poids, le sexe, la préférence concernant le tabac, le niveau d'activité et le pouls au repos de 91 étudiants de premier cycle. Il répartit ensuite aléatoirement les étudiants en deux groupes. Le premier groupe court sur place pendant une minute tandis que l'autre reste immobile. Le chercheur relève alors de nouveau le pouls des étudiants. Les étapes sont les suivantes :
- Rassemblez les données nécessaires.
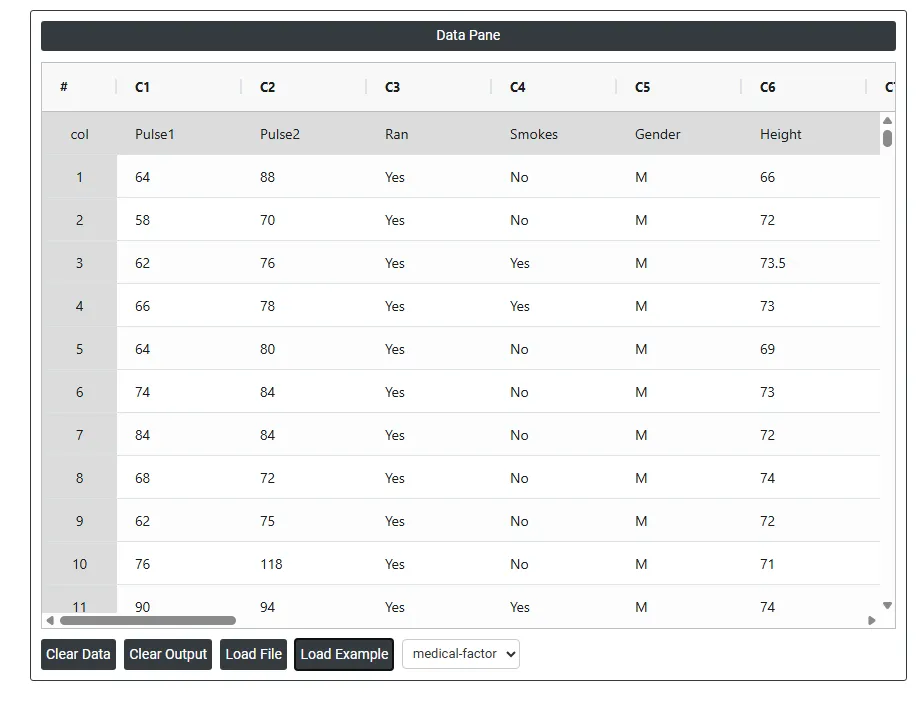
- Analysez ensuite les données dans Zometric Statistical Software à l'adresse https://statsai.zometric.com/.
- Pour trouver Fit Regression Model, choisissez Statistical module> Regression>Fit Regression Model.
- Dans l'outil, saisissez les données et les autres paramètres comme suit :
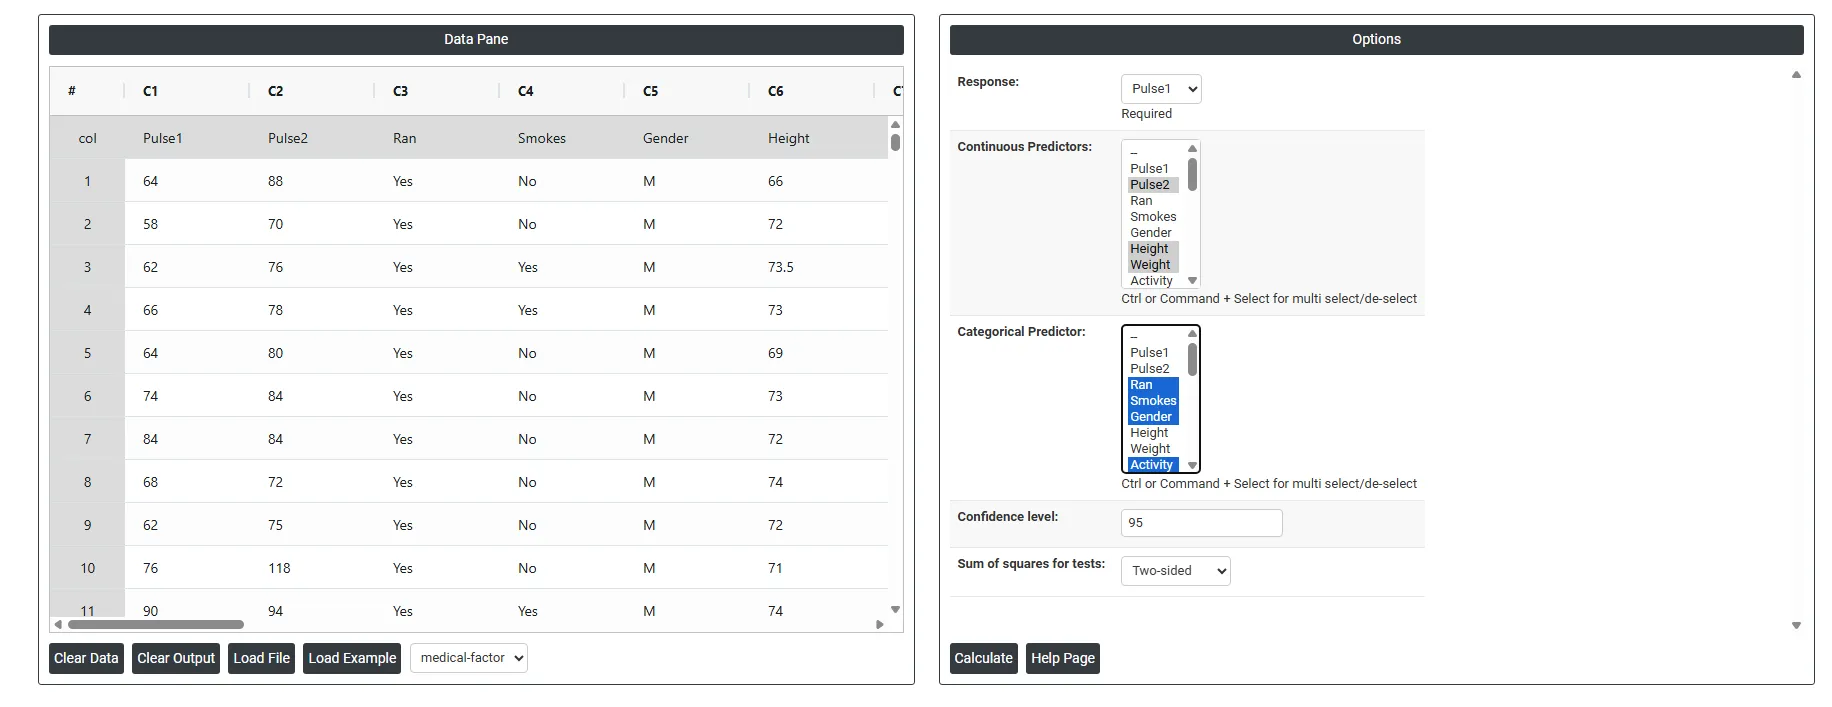
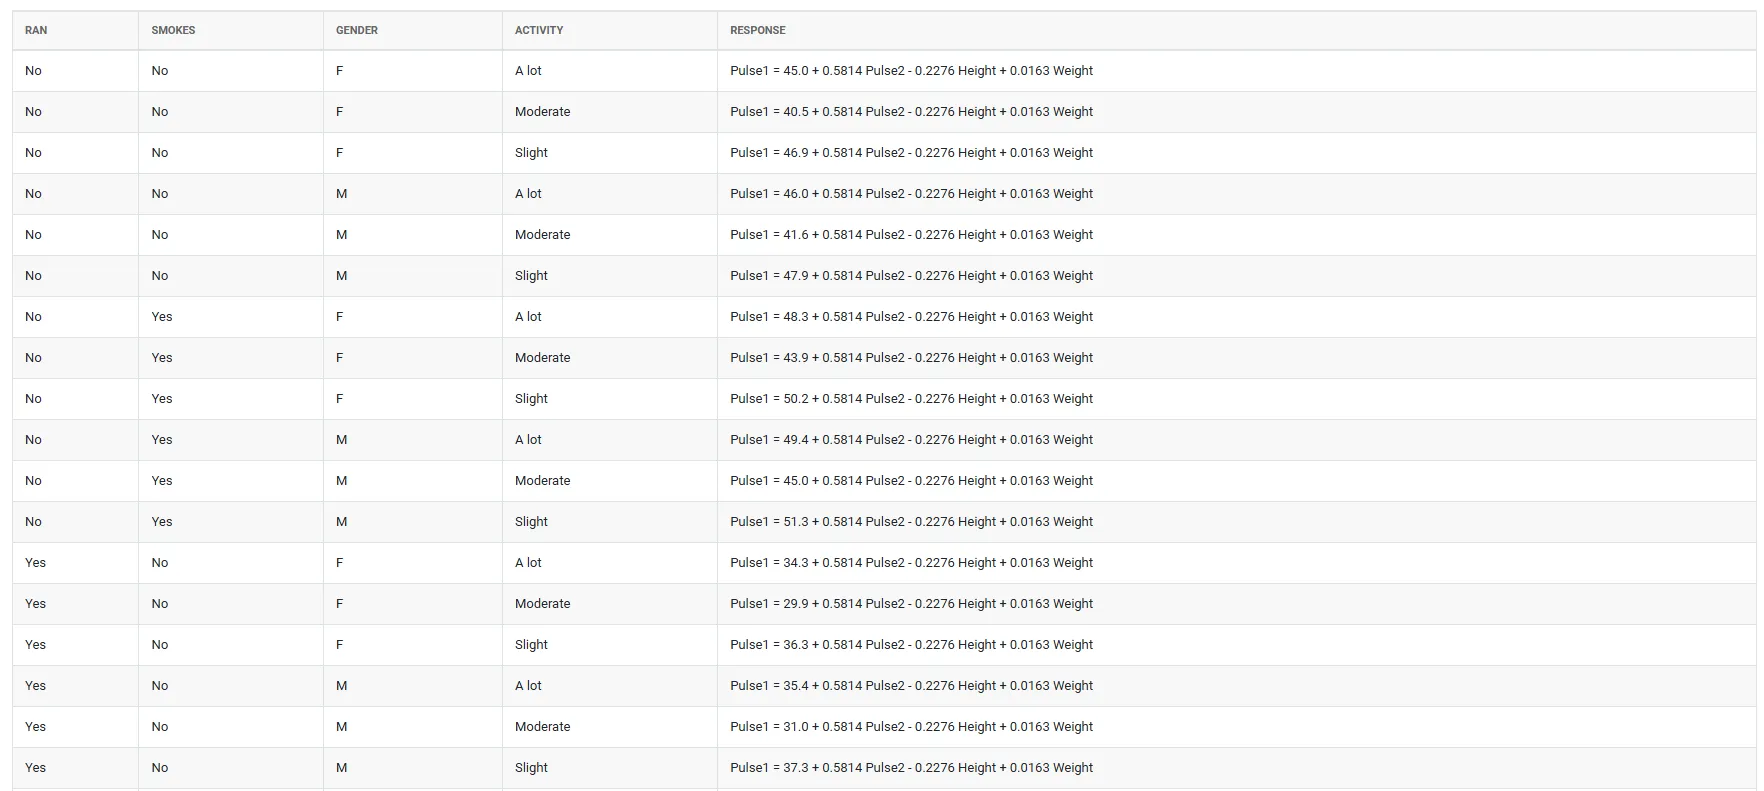
- Après utilisation de l'outil ci-dessus, les résultats obtenus sont les suivants :
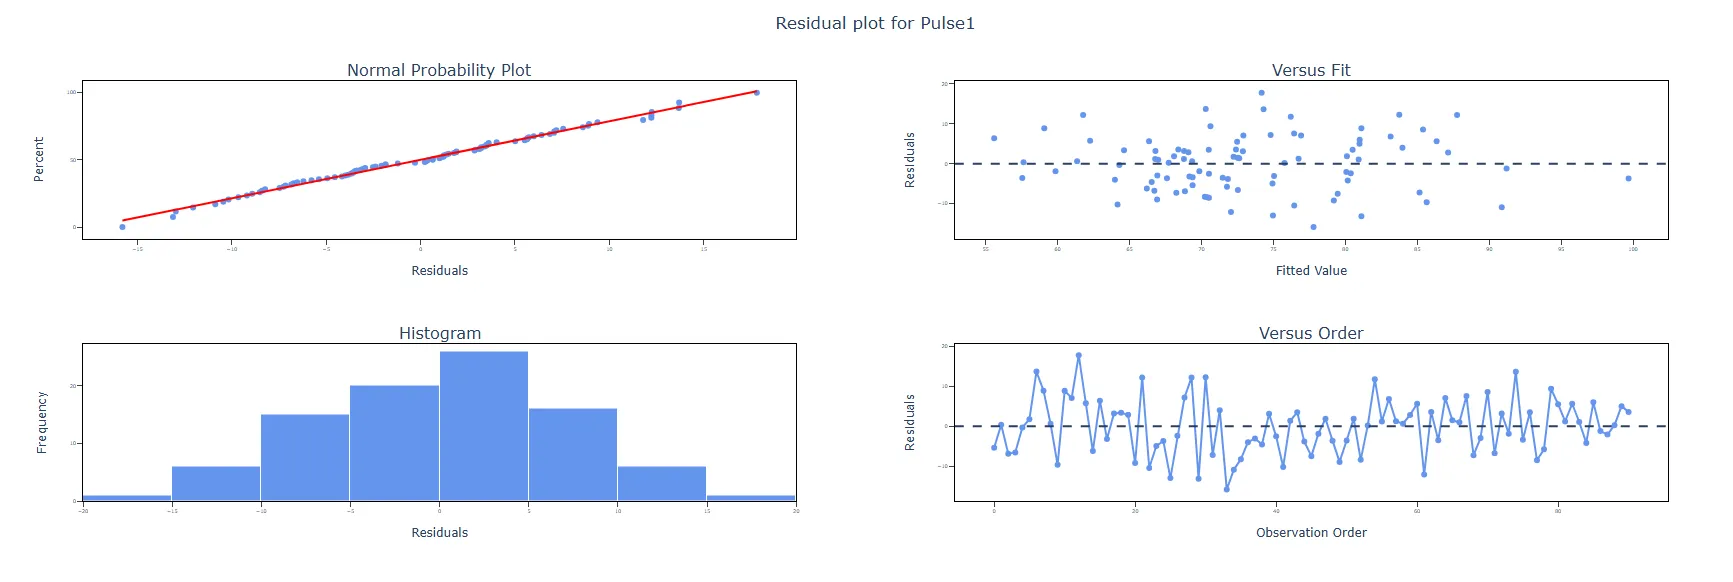
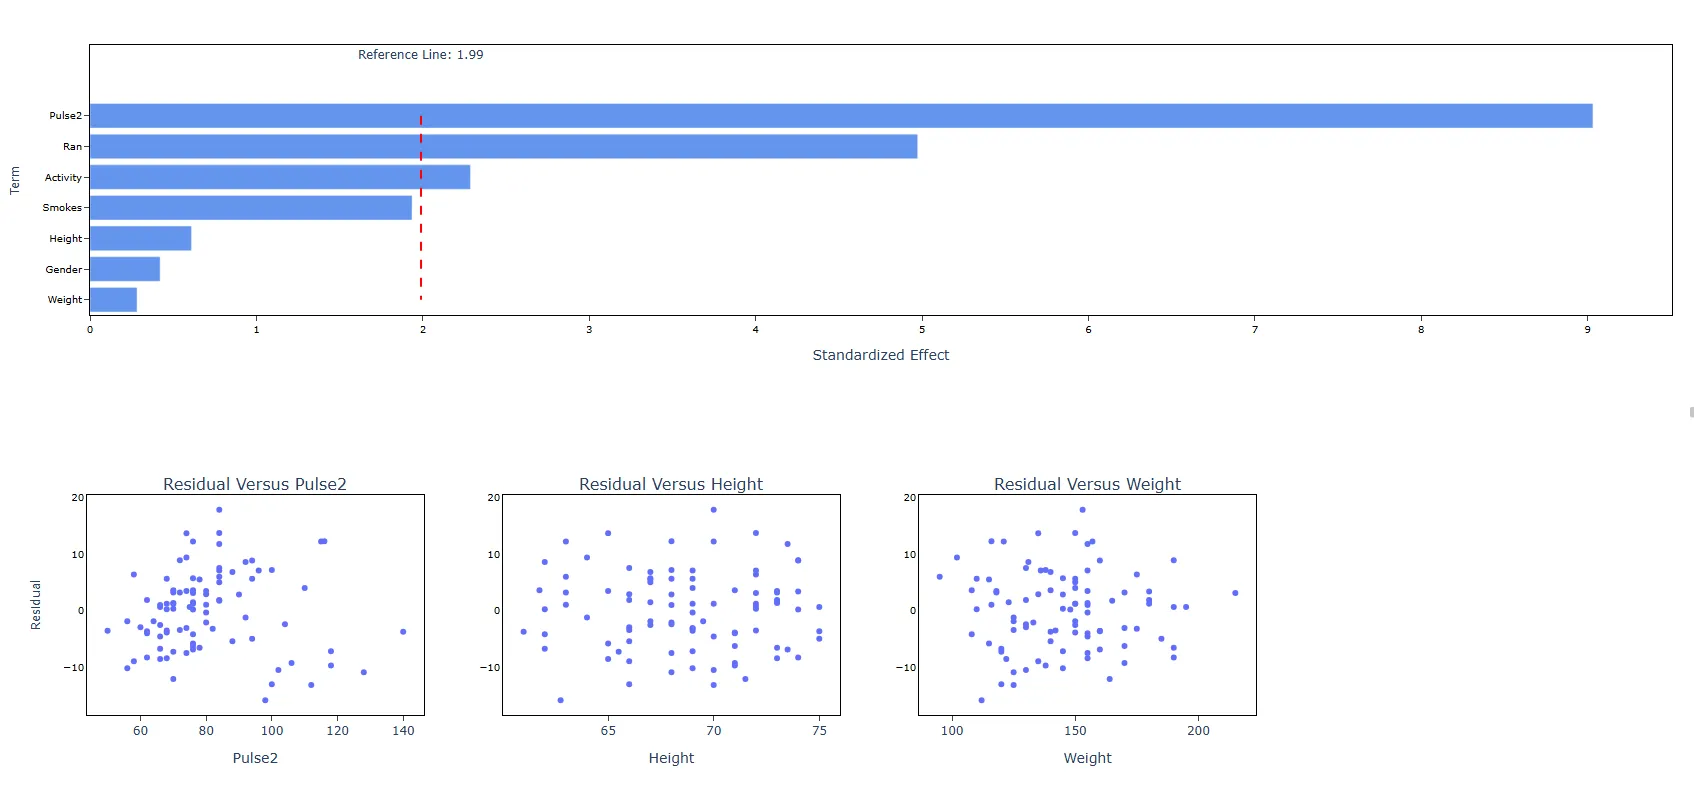
Comment utiliser Fit Regression Model
La marche à suivre est la suivante :
- Connectez-vous à Zometric Statistical Software à l'adresse https://statsai.zometric.com/
- Sur la page d'accueil, choisissez Statistical Tool> Regression > Fit Regression Model.
- Ensuite, saisissez les données manuellement, copiez-les (Ctrl+C) depuis une feuille Excel et collez-les (Ctrl+V), ou encore utilisez l'option Load Example pour charger les données d'exemple.
- Ensuite, renseignez les options requises.
- Enfin, cliquez sur calculate en bas de la page pour obtenir les résultats.
Dans le tableau de bord de Fit Regression Model, la fenêtre est divisée en deux parties.
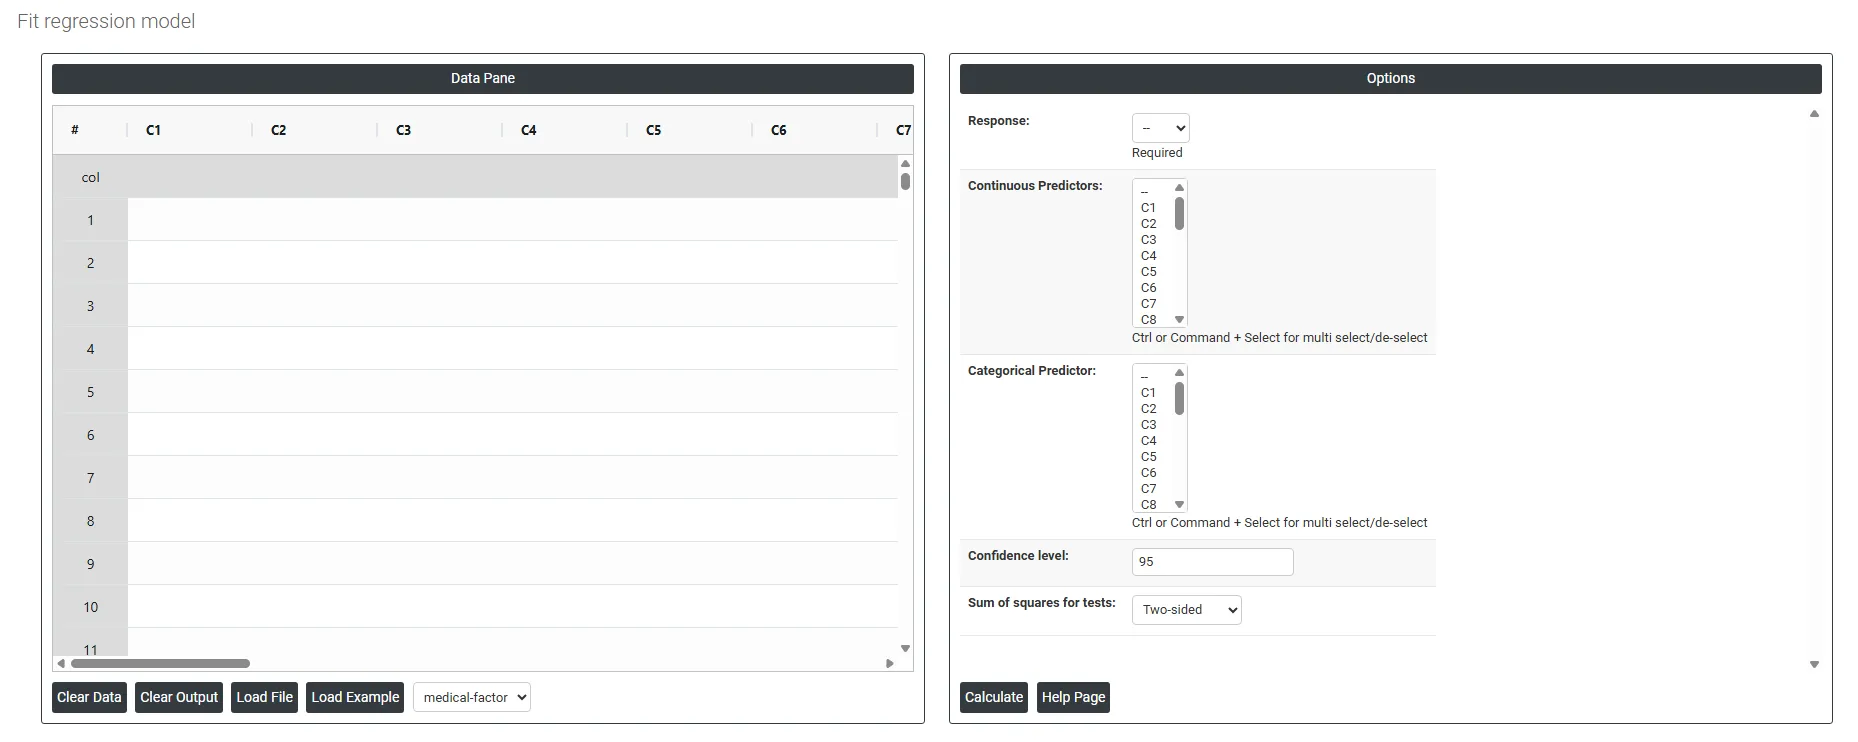
Dans la partie gauche se trouve le Data Pane (volet de données). Dans le Data Pane, chaque ligne constitue un sous-groupe. Les données peuvent être saisies manuellement ou entièrement copiées (Ctrl+C) depuis une feuille Excel puis collées (Ctrl+V) ici.
Load example : des données d'exemple sont chargées.
Load File: permet de charger directement des données Excel.
Dans la partie droite se trouvent de nombreuses options, comme suit :
- Response : dans un modèle de régression, la variable de réponse est la variable que l'on prédit ou que l'on explique à l'aide des variables indépendantes ou prédicteurs. On l'appelle aussi variable dépendante ou variable cible. C'est la variable que le modèle de régression cherche à estimer ou à prédire à partir des valeurs des variables indépendantes.
- Continuous Predictors : dans un modèle de régression, un prédicteur continu est une variable qui prend des valeurs continues ou numériques et sert à prédire ou à expliquer la variation de la variable de réponse. Les prédicteurs continus peuvent prendre n'importe quelle valeur dans un certain domaine ou intervalle, et peuvent avoir des décimales ou des fractions.
- Categorical Predictors : en analyse de régression, les prédicteurs qualitatifs sont des variables qui prennent un nombre limité de valeurs discrètes, souvent appelées catégories ou niveaux. Ces variables sont aussi appelées variables qualitatives ou nominales, par opposition aux variables quantitatives ou numériques.
- Confidence level : en analyse de régression, le niveau de confiance est une mesure de la précision et de l'exactitude des coefficients estimés du modèle de régression. Plus précisément, le niveau de confiance est la proportion, à long terme, des intervalles de confiance calculés de la même manière à partir d'échantillons répétés qui contiendraient la vraie valeur de population d'un coefficient. Le niveau de confiance s'exprime généralement en pourcentage, et une valeur courante est 95%. Cela signifie que si le même modèle de régression était estimé de façon répétée à partir de différents échantillons de données, environ 95% des intervalles de confiance obtenus contiendraient la vraie valeur de ce coefficient.
- Sum of squares for tests :
- Adjusted (Type III) : la somme des carrés de chaque terme est la réduction de la somme des carrés de l'erreur lorsque ce terme est ajouté à un modèle contenant déjà tous les autres termes ; son test ne dépend donc pas de l'ordre dans lequel les termes sont introduits. C'est le réglage par défaut, généralement préféré. Sequential (Type I) : la somme des carrés de chaque terme est la réduction de la somme des carrés de l'erreur lorsque le terme est ajouté au modèle dans l'ordre de saisie ; le test d'un terme dépend donc des termes introduits avant lui.
Questions fréquentes
Qu'est-ce que Fit Regression Model ?
Fit Regression Model examine et quantifie la relation entre une ou plusieurs variables prédictives et une variable de réponse continue. Il construit une équation qui décrit au mieux l'influence conjointe des prédicteurs sur la réponse, ce qui permet de comprendre des tendances, d'identifier les variables significatives et de prédire des résultats futurs. Les prédicteurs peuvent être continus, qualitatifs ou une combinaison des deux.
Quelle est la différence entre Fit Regression Model et Fit Line Model ?
Fit Line Model ne gère qu'un seul prédicteur, alors que Fit Regression Model prend en charge plusieurs prédicteurs, continus comme qualitatifs. Pour visualiser la relation entre un prédicteur continu et une réponse continue, un graphique de droite ajustée est le choix le plus simple ; pour plusieurs prédicteurs, utilisez Fit Regression Model.
Quand ne pas utiliser Fit Regression Model ?
La réponse doit être continue. Pour une réponse à deux catégories, utilisez Fit Binary Logistic Model. Pour trois catégories ou plus avec un ordre naturel, comme de « tout à fait en désaccord » à « tout à fait d'accord », utilisez Ordinal Logistic Regression. Pour trois catégories ou plus sans ordre naturel, comme rayure, bosse et déchirure, utilisez Nominal Logistic Regression.
Comment vérifier la multicolinéarité dans un modèle de régression ?
Utilisez les facteurs d'inflation de la variance (VIF) du tableau Coefficients pour évaluer la sévérité de la multicolinéarité entre les prédicteurs. Si elle est sévère, il devient difficile d'identifier quels prédicteurs sont réellement significatifs. Après l'ajustement, validez aussi le modèle avec les graphiques des résidus, les statistiques de diagnostic et les statistiques récapitulatives du modèle, car un modèle mal ajusté peut conduire à des conclusions trompeuses.