
ANOVA entièrement hiérarchisée
Fully Nested ANOVA estime la part de variation provenant de chaque niveau d'une hiérarchie, avec deux à quatre facteurs aléatoires emboîtés et des lectures répétées comme erreur. Chaque unité de niveau inférieur doit appartenir à une seule unité de niveau supérieur. Les résultats comprennent un tableau d'ANOVA (F et P pour les plans équilibrés seulement), les composantes de la variance avec % du total, les carrés moyens espérés, un récapitulatif du modèle et les moyennes des cellules.
Dernière révision
Point clé
L'ANOVA entièrement hiérarchisée répartit la variation d'une mesure entre les niveaux d'une hiérarchie (lots, échantillons au sein des lots, lectures répétées) pour montrer d'où vient l'essentiel de la variation.
Sur cette page
Objectif
Fully Nested ANOVA répartit la variation d'une mesure entre les niveaux d'une hiérarchie, par exemple des lots, des échantillons au sein de chaque lot et des lectures répétées au sein de chaque échantillon. Utilisez-la lorsque chaque unité de niveau inférieur appartient à une seule unité de niveau supérieur (l'échantillon 1 du lot 1 n'est pas le même matériau que l'échantillon 1 du lot 2) et que vous voulez savoir d'où vient l'essentiel de la variation, pour savoir où agir : le procédé, l'échantillonnage ou la mesure.
Principales fonctionnalités
- Deux à quatre facteurs emboîtés, du plus externe (p. ex. Batch) au plus interne (p. ex. Sample) ; les lectures répétées au sein du facteur le plus interne forment l'erreur.
- Une analyse par réponse lorsque plusieurs réponses sont sélectionnées.
- Tableau d'ANOVA avec sommes des carrés séquentielles et tests F de chaque niveau par rapport au niveau inférieur.
- Composantes de la variance avec leur % du total et leurs écarts-types.
- Carrés moyens espérés, récapitulatif du modèle et tableau des moyennes et écarts-types pour chaque cellule.
- Prend en charge les données déséquilibrées pour les composantes de la variance ; Data Options pour restreindre les lignes.
Méthodes statistiques
Tous les facteurs sont traités comme aléatoires et chacun est emboîté dans le précédent. La somme des carrés de chaque facteur est la dispersion de ses moyennes de cellules autour des moyennes du niveau supérieur ; la somme des carrés de l'erreur est la dispersion des lectures autour des moyennes des cellules les plus internes. Chaque facteur a (nombre de ses cellules − nombre de cellules du niveau supérieur) degrés de liberté, et l'erreur a N − nombre de cellules les plus internes.
Chaque facteur est testé par rapport au facteur suivant qu'il contient, et le facteur le plus interne par rapport à l'erreur : F = MS(facteur) / MS(terme interne suivant). F et P ne sont fournis que pour les plans équilibrés (nombre égal de lectures dans chaque cellule et nombre égal de sous-unités dans chaque unité) ; pour des données déséquilibrées, la page l'indique et les omet.
Les composantes de la variance proviennent des carrés moyens espérés (méthode de l'ANOVA) : E(MS) de chaque facteur est σ²(erreur) plus des multiples des composantes de ce facteur et des facteurs qu'il contient, comme indiqué dans le tableau Expected Mean Squares, où (1), (2), … numérotent les facteurs dans l'ordre d'emboîtement et le dernier numéro est l'erreur. La résolution de ces équations du terme le plus interne vers l'extérieur donne chaque composante ; une estimation négative est affichée avec 0% du total. % of Total est la part de chaque composante dans la variance totale sommée, et StDev sa racine carrée. Les lignes avec une réponse ou une valeur de facteur manquante sont écartées.
Champs et options de saisie
Champ | Description |
Responses | Une ou plusieurs colonnes numériques. Obligatoire ; une analyse par réponse. |
Factor 1 (outermost) | Niveau supérieur de la hiérarchie, p. ex. Batch. Obligatoire. |
Factor 2 (nested in Factor 1) | Obligatoire, p. ex. Sample au sein de Batch. |
Factor 3 (nested in Factor 2) / Factor 4 (nested in Factor 3) | Niveaux plus profonds optionnels ; Factor 4 requiert Factor 3. |
Data Options: Subset (optional) | Exclure les lignes correspondantes (par défaut) ou n'inclure que les lignes correspondantes, selon des numéros de ligne et/ou une condition. |
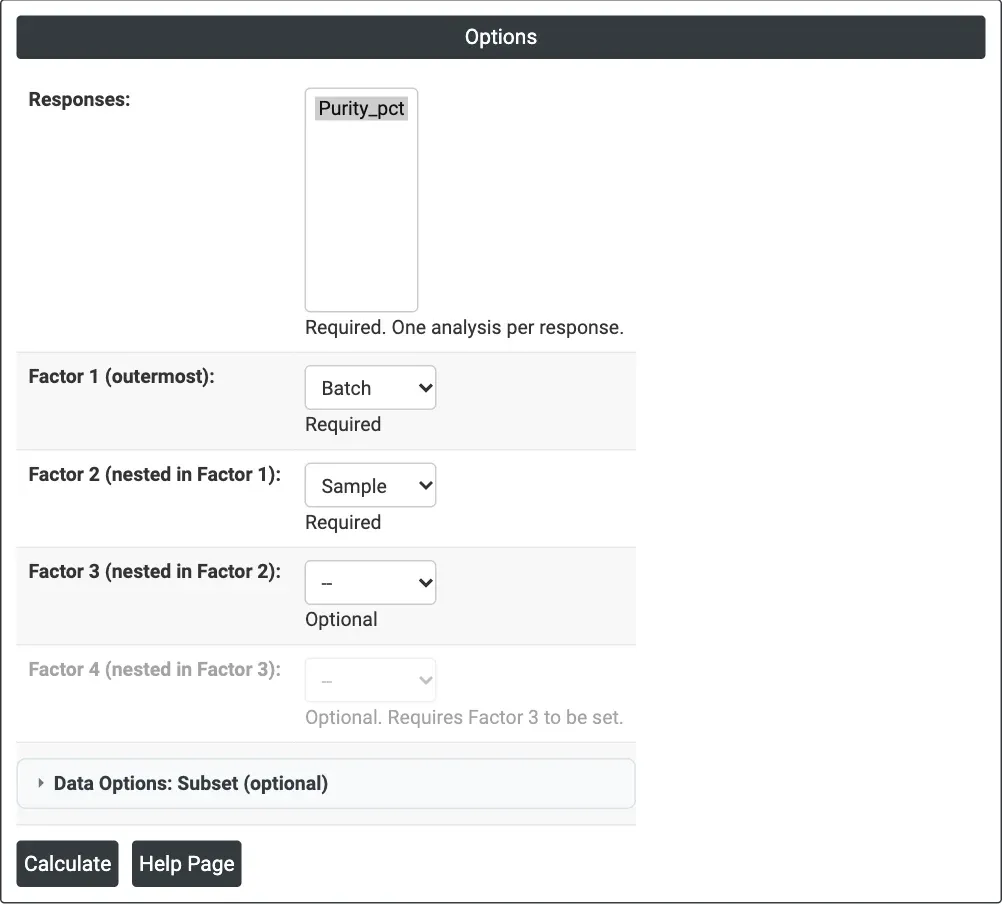
Figure 1 — Options de l'exemple de pureté : Purity_pct comme réponse, Batch comme Factor 1 et Sample (emboîté dans Batch) comme Factor 2.
Description des résultats
- Analysis of Variance — DF, SS, MS, F et P pour chaque facteur, l'erreur et le total.
- Variance Components — Var Comp, % of Total et StDev pour chaque facteur, l'erreur et le total.
- Expected Mean Squares — composition de chaque carré moyen en fonction des composantes de la variance.
- Model Summary — S, R-sq et R-sq(adj).
- Means — N, moyenne et écart-type de chaque cellule la plus interne.
- Export PDF via Download.
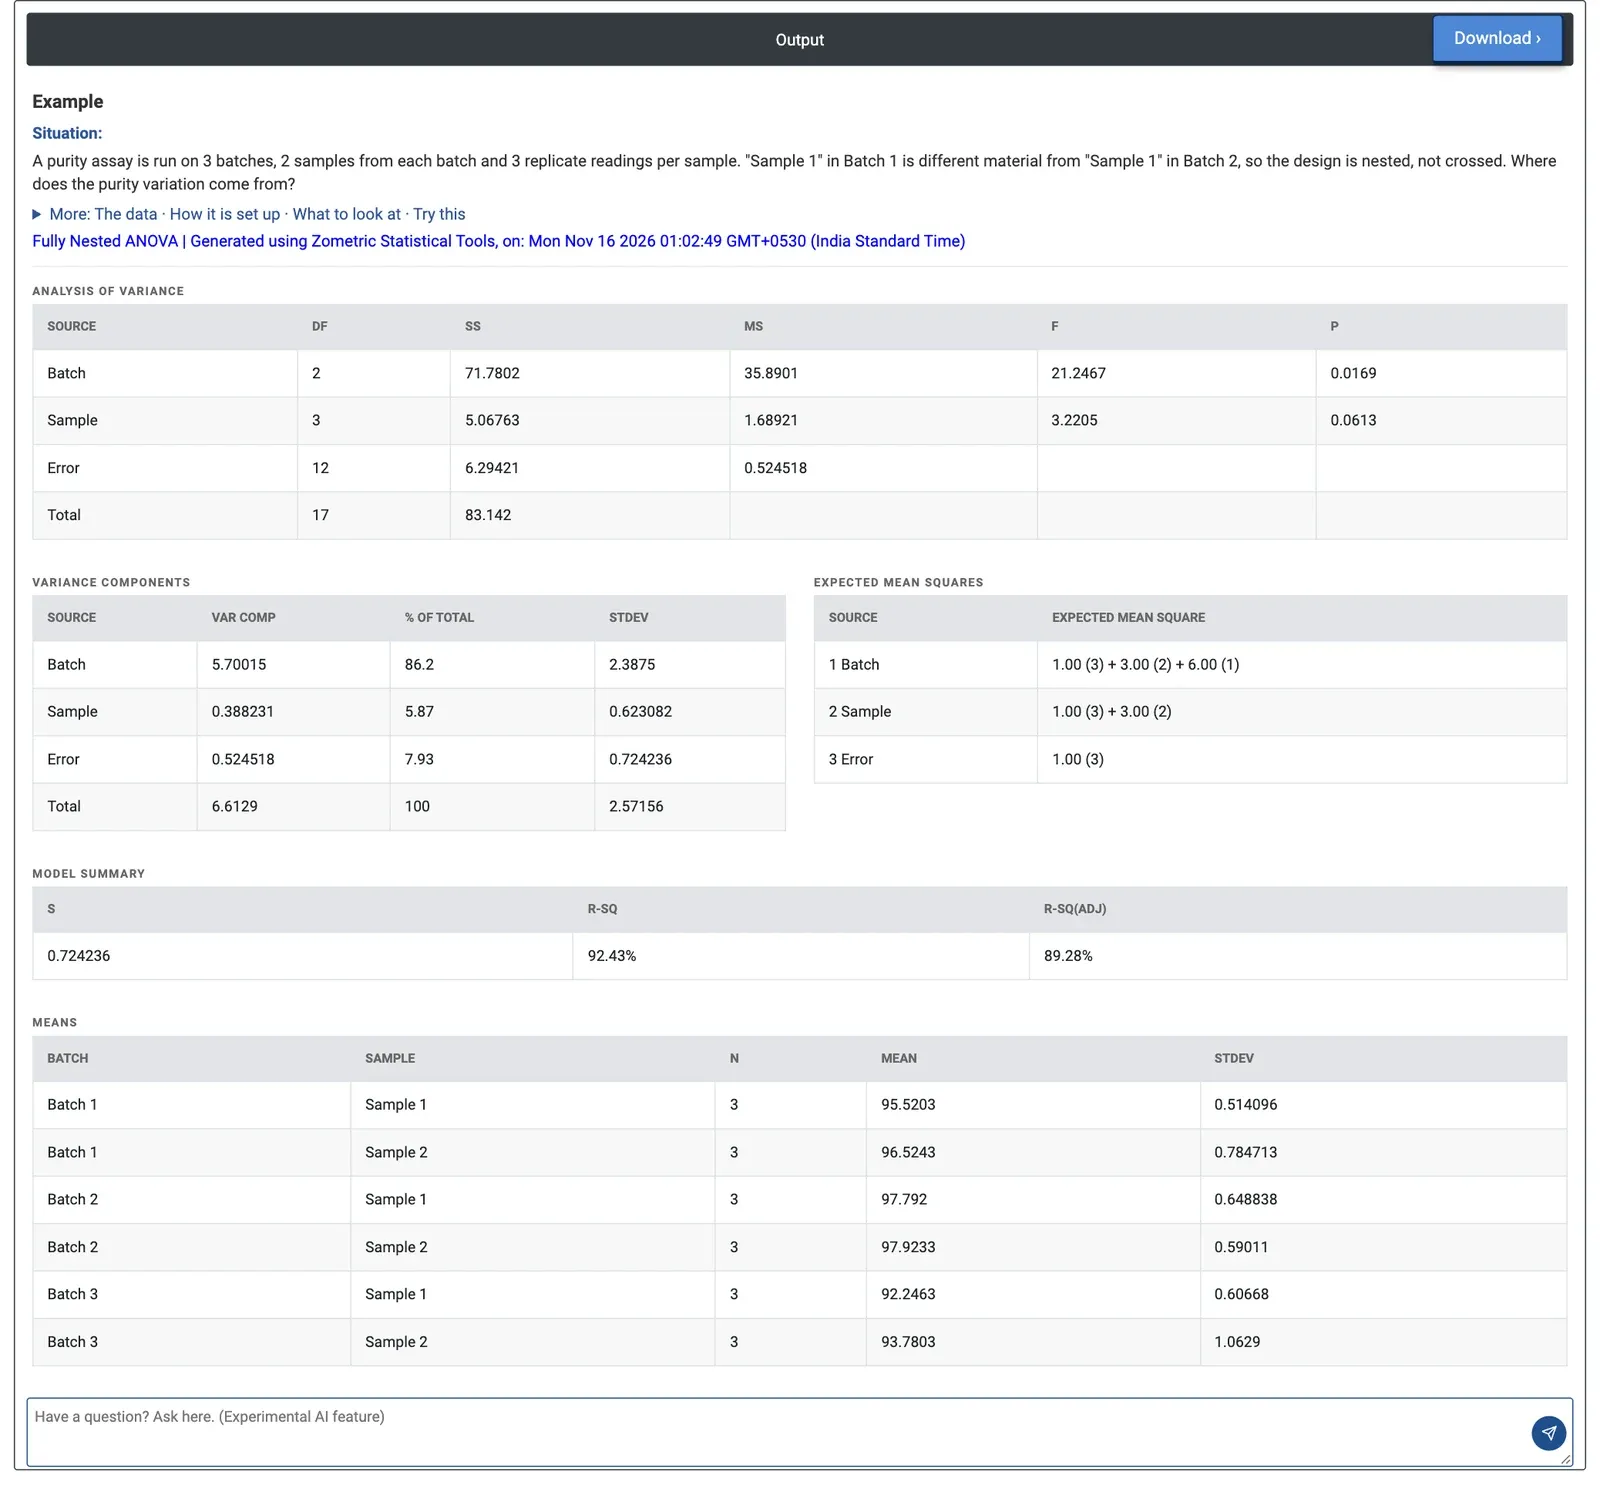
Figure 2 — ANOVA hiérarchisée de la pureté : la variation entre lots représente 86.2% du total ; les échantillons au sein d'un lot y ajoutent 5.87% et les lectures répétées 7.93%.
Exemple résolu
Un dosage de pureté est réalisé sur 3 lots, avec 2 échantillons prélevés dans chaque lot et 3 lectures répétées sur chaque échantillon : 18 résultats. L'équipe qualité veut savoir si la dispersion de la pureté provient du procédé de fabrication des lots, de l'échantillonnage ou de la mesure. Elle sélectionne Purity_pct comme réponse, Batch comme Factor 1 et Sample comme Factor 2 ; les lectures répétées forment l'erreur.
Les lots diffèrent : F = 21.25 avec 2 et 3 degrés de liberté, p = 0.0169 (Batch est testé par rapport à Sample au sein de Batch). Les échantillons au sein d'un lot ne diffèrent pas significativement au seuil de 5 % (F = 3.22, p = 0.0613). Le lot 3 est le plus bas (moyennes de cellules 92.25% et 93.78%) et le lot 2 le plus élevé (97.79% et 97.92%).
Les composantes de la variance rendent le tableau clair : la variance entre lots est de 5.70 (86.2% du total, écart-type 2.39 points de pourcentage), celle entre échantillons de 0.388 (5.87%) et celle des lectures répétées de 0.525 (7.93%, écart-type 0.72). Un meilleur échantillonnage ou un dosage plus précis changerait peu de chose ; l'équipe doit chercher ce qui diffère entre les lots.
Questions fréquentes
Quand utiliser une ANOVA entièrement hiérarchisée ?
Utilisez-la lorsque chaque unité de niveau inférieur appartient à une seule unité de niveau supérieur, par exemple lorsque l'échantillon 1 du lot 1 n'est pas le même matériau que l'échantillon 1 du lot 2, et que vous voulez savoir d'où vient l'essentiel de la variation. Cela indique s'il faut agir sur le procédé, l'échantillonnage ou la mesure.
Comment les facteurs sont-ils testés dans une ANOVA entièrement hiérarchisée ?
Tous les facteurs sont traités comme aléatoires, chacun emboîté dans le précédent. Chaque facteur est testé par rapport au facteur suivant qu'il contient, et le facteur le plus interne par rapport à l'erreur, donc F = MS(facteur) / MS(terme interne suivant). F et P ne sont fournis que pour les plans équilibrés ; pour des données déséquilibrées, ils sont omis, mais les composantes de la variance sont tout de même estimées.
Comment interpréter les composantes de la variance dans une ANOVA hiérarchisée ?
Le % of Total de chaque composante est sa part de la variance totale sommée, et son StDev en est la racine carrée. Dans l'exemple de pureté, la variance entre lots représentait 86.2% du total, les échantillons au sein d'un lot 5.87% et les lectures répétées 7.93% ; un meilleur échantillonnage ou un dosage plus précis changerait donc peu de chose et l'équipe doit chercher les différences entre lots.
Combien de facteurs emboîtés une ANOVA entièrement hiérarchisée peut-elle comporter ?
De deux à quatre facteurs emboîtés, du plus externe, comme Batch, au plus interne, comme Sample. Factor 1 et Factor 2 sont obligatoires, Factor 3 et Factor 4 sont optionnels, et Factor 4 requiert Factor 3. Les lectures répétées au sein du facteur le plus interne forment l'erreur, et une analyse est exécutée par réponse sélectionnée.