
Modèle linéaire général (GLM)
Le modèle linéaire général ajuste par les moindres carrés des facteurs qualitatifs fixes, des interactions d'ordre 2 facultatives et des covariables continues, avec des sommes des carrés ajustées (type III) ou séquentielles. Utilisez-le lorsque l'ANOVA à un facteur ne suffit pas ou que les données sont déséquilibrées. Il suppose des erreurs indépendantes, normales et de variance constante. Les résultats comprennent le tableau d'ANOVA, les moyennes des moindres carrés, les coefficients avec VIF, les comparaisons multiples et les graphiques des résidus.
Dernière révision
Point clé
Un modèle linéaire général (GLM) réalise une analyse de la variance avec un ou plusieurs facteurs qualitatifs, leurs interactions d'ordre 2 et des covariables continues dans un même modèle, y compris avec des données déséquilibrées.
Sur cette page
Objectif
General Linear Model (GLM) réalise une analyse de la variance avec un ou plusieurs facteurs qualitatifs, leurs interactions d'ordre 2 et des covariables continues dans un même modèle. Utilisez-le lorsqu'une ANOVA à un facteur ne suffit pas : par exemple lorsque le rendement peut dépendre de la machine, de l'opérateur, de leur combinaison, et aussi d'une condition mesurée comme la température, ou lorsque les données sont déséquilibrées. Il couvre aussi l'ANOVA à deux facteurs classique.
Principales fonctionnalités
- Nombre quelconque de facteurs qualitatifs fixes, avec toutes les interactions d'ordre 2 entre facteurs sur demande.
- Covariables continues introduites comme effets principaux (analyse de la covariance).
- Sommes des carrés ajustées (type III) ou séquentielles (type I) ; tests corrects pour des données déséquilibrées.
- Moyennes des moindres carrés de chaque facteur, ajustées sur les autres termes.
- Comparaisons multiples des moyennes des moindres carrés d'un facteur par Tukey, Fisher, Bonferroni, Sidak ou Dunnett (par rapport à un témoin), avec lettres de regroupement et graphique d'intervalles des différences.
- Coefficients avec VIF, résumé du modèle avec R-sq(pred), observations inhabituelles et quatre graphiques des résidus.
- Data Options : sélection d'un sous-ensemble de lignes avant l'analyse.
Méthodes statistiques
Le modèle est ajusté par les moindres carrés ordinaires. Les facteurs utilisent un codage à somme nulle (−1, 0, +1) : chaque coefficient est donc l'écart d'un niveau à la moyenne générale, et le test de type III d'un effet principal fait la moyenne sur les niveaux des autres facteurs. Les lignes comportant une valeur manquante dans l'une des colonnes sélectionnées sont écartées. Chaque terme est testé par F = Adj MS(terme) / MS(Error), avec ses propres degrés de liberté et ceux de l'erreur ; avec des sommes des carrés séquentielles, chaque terme est testé après les termes qui le précèdent. La ligne Total est la somme des carrés totale par rapport à la moyenne, que les sommes des carrés ajustées n'ont pas à égaler avec des données déséquilibrées.
S = √MS(Error). R-sq(pred) = 1 − PRESS / SS Total, où PRESS est la somme des carrés des erreurs de prédiction obtenues en retirant chaque observation à tour de rôle. Une moyenne des moindres carrés est la prédiction du modèle pour un niveau de facteur, les autres facteurs étant moyennés sur leurs niveaux et les covariables à leur moyenne ; contrairement aux moyennes brutes, elle n'est pas biaisée par des tailles de groupes inégales ou des différences de covariables.
Les comparaisons utilisent la différence entre moyennes des moindres carrés, avec son erreur-type issue de la matrice de covariance des coefficients. Tukey utilise la distribution de l'étendue studentisée pour toutes les paires ; Fisher utilise des tests t individuels ; Bonferroni et Sidak ajustent la valeur critique de t au nombre de paires ; Dunnett compare chaque niveau à un témoin à l'aide de la distribution t multivariée. Un intervalle qui ne contient pas zéro, ou des moyennes qui ne partagent pas de lettre de regroupement, indiquent une différence significative. Les résidus standardisés au-delà de ±2 sont signalés R et les effets de levier supérieurs à 3p/n sont signalés X. Le modèle suppose des erreurs indépendantes, normalement distribuées et de variance constante : vérifiez les graphiques des résidus.
Champs de saisie et options
Champ | Description |
Response (Y) | Colonne numérique de la réponse. Obligatoire. |
Factors (categorical) | Une ou plusieurs colonnes de prédicteurs qualitatifs. Obligatoire. |
Covariates (continuous) | Colonnes numériques facultatives, introduites uniquement comme effets principaux (sans interactions avec les facteurs). |
Include all 2-way factor interactions | Cochée par défaut : ajoute toutes les interactions entre deux facteurs. |
Confidence level | Par défaut 95 ; utilisé pour les comparaisons. |
Comparison procedure | None (default), Tukey, Fisher, Bonferroni, Sidak ou Dunnett (vs. a control level). |
Comparison factor | Facteur dont les moyennes des moindres carrés sont comparées ; obligatoire si une procédure est choisie. |
Control group level (Dunnett) | Niveau témoin pour Dunnett ; s'il est vide, le premier niveau est utilisé. |
Grouping information / Interval plot for differences of means | Cochée par défaut : tableau des lettres de regroupement et graphique des intervalles de comparaison. |
Sum of squares for tests | Adjusted (Type III, default) ou Sequential (Type I). |
Residual versus fit graph / Residual versus order graph / Histogram / Probability plot | Graphiques des résidus ; tous cochés par défaut. |
Data Options: Subset (optional) | Exclude matching rows (default) ou Include only matching rows, selon les numéros de ligne (par ex. 3,7,12-15) et/ou une condition (par ex. Temperature_C > 185). |
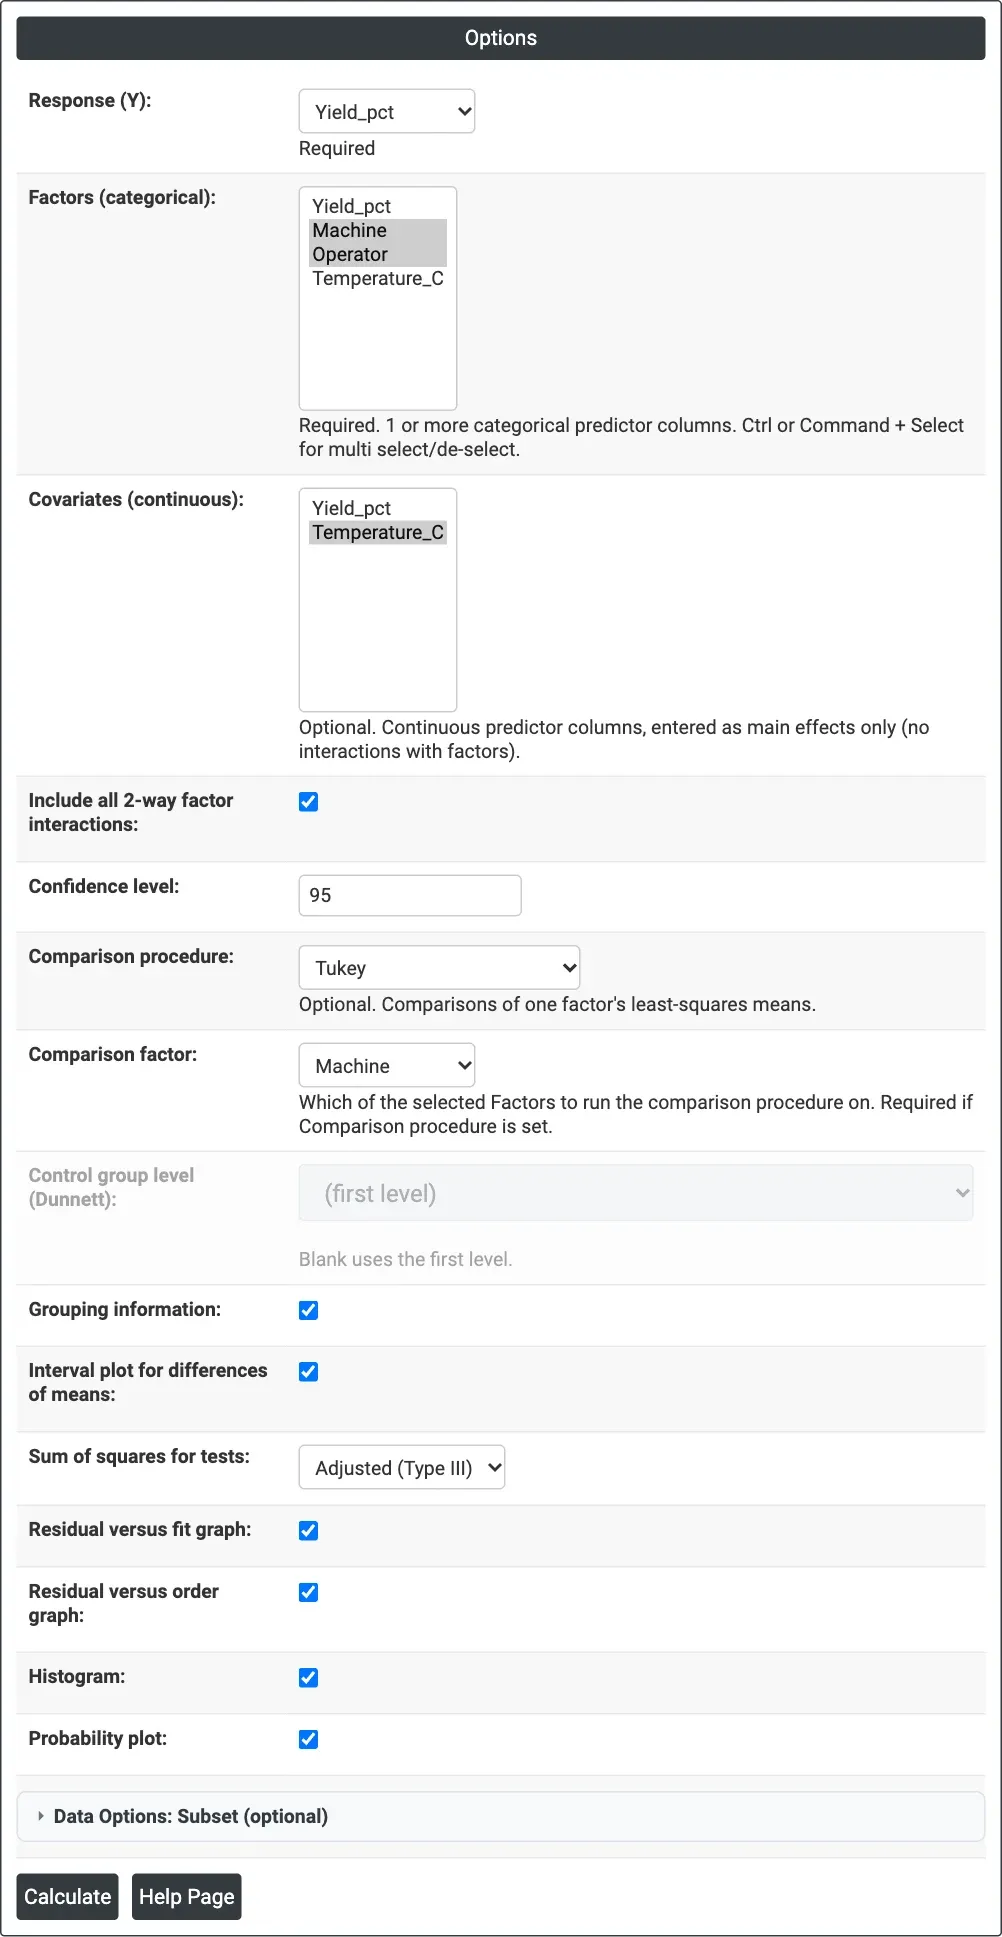
Figure 1 — Options de l'exemple de rendement : Yield_pct avec les facteurs Machine et Operator, leur interaction, la covariable Temperature_C et des comparaisons de Tukey entre les machines.
Description des résultats
- Method — codage des facteurs et type de sommes des carrés.
- Factor Information — type, nombre de niveaux et valeurs des niveaux de chaque facteur.
- Analysis of Variance — DF, Adj SS (ou Seq SS), Adj MS, F-Value et P-Value pour chaque terme, l'erreur et le total.
- Model Summary — S, R-sq, R-sq(adj) et R-sq(pred).
- Least-Squares Means — N et moyenne des moindres carrés (LS mean) de chaque niveau de chaque facteur.
- Coefficients — Coef, SE Coef, T-Value, P-Value et VIF.
- Fits and Diagnostics for Unusual Observations — affiché seulement s'il y en a.
- Grouping Information, Simultaneous (ou Individual) Tests for Differences of Means et le graphique d'intervalles — lorsqu'une procédure de comparaison est choisie.
- Versus Fit, Versus Order, Residuals Histogram et Probability Plot.
- Export PDF via Download.
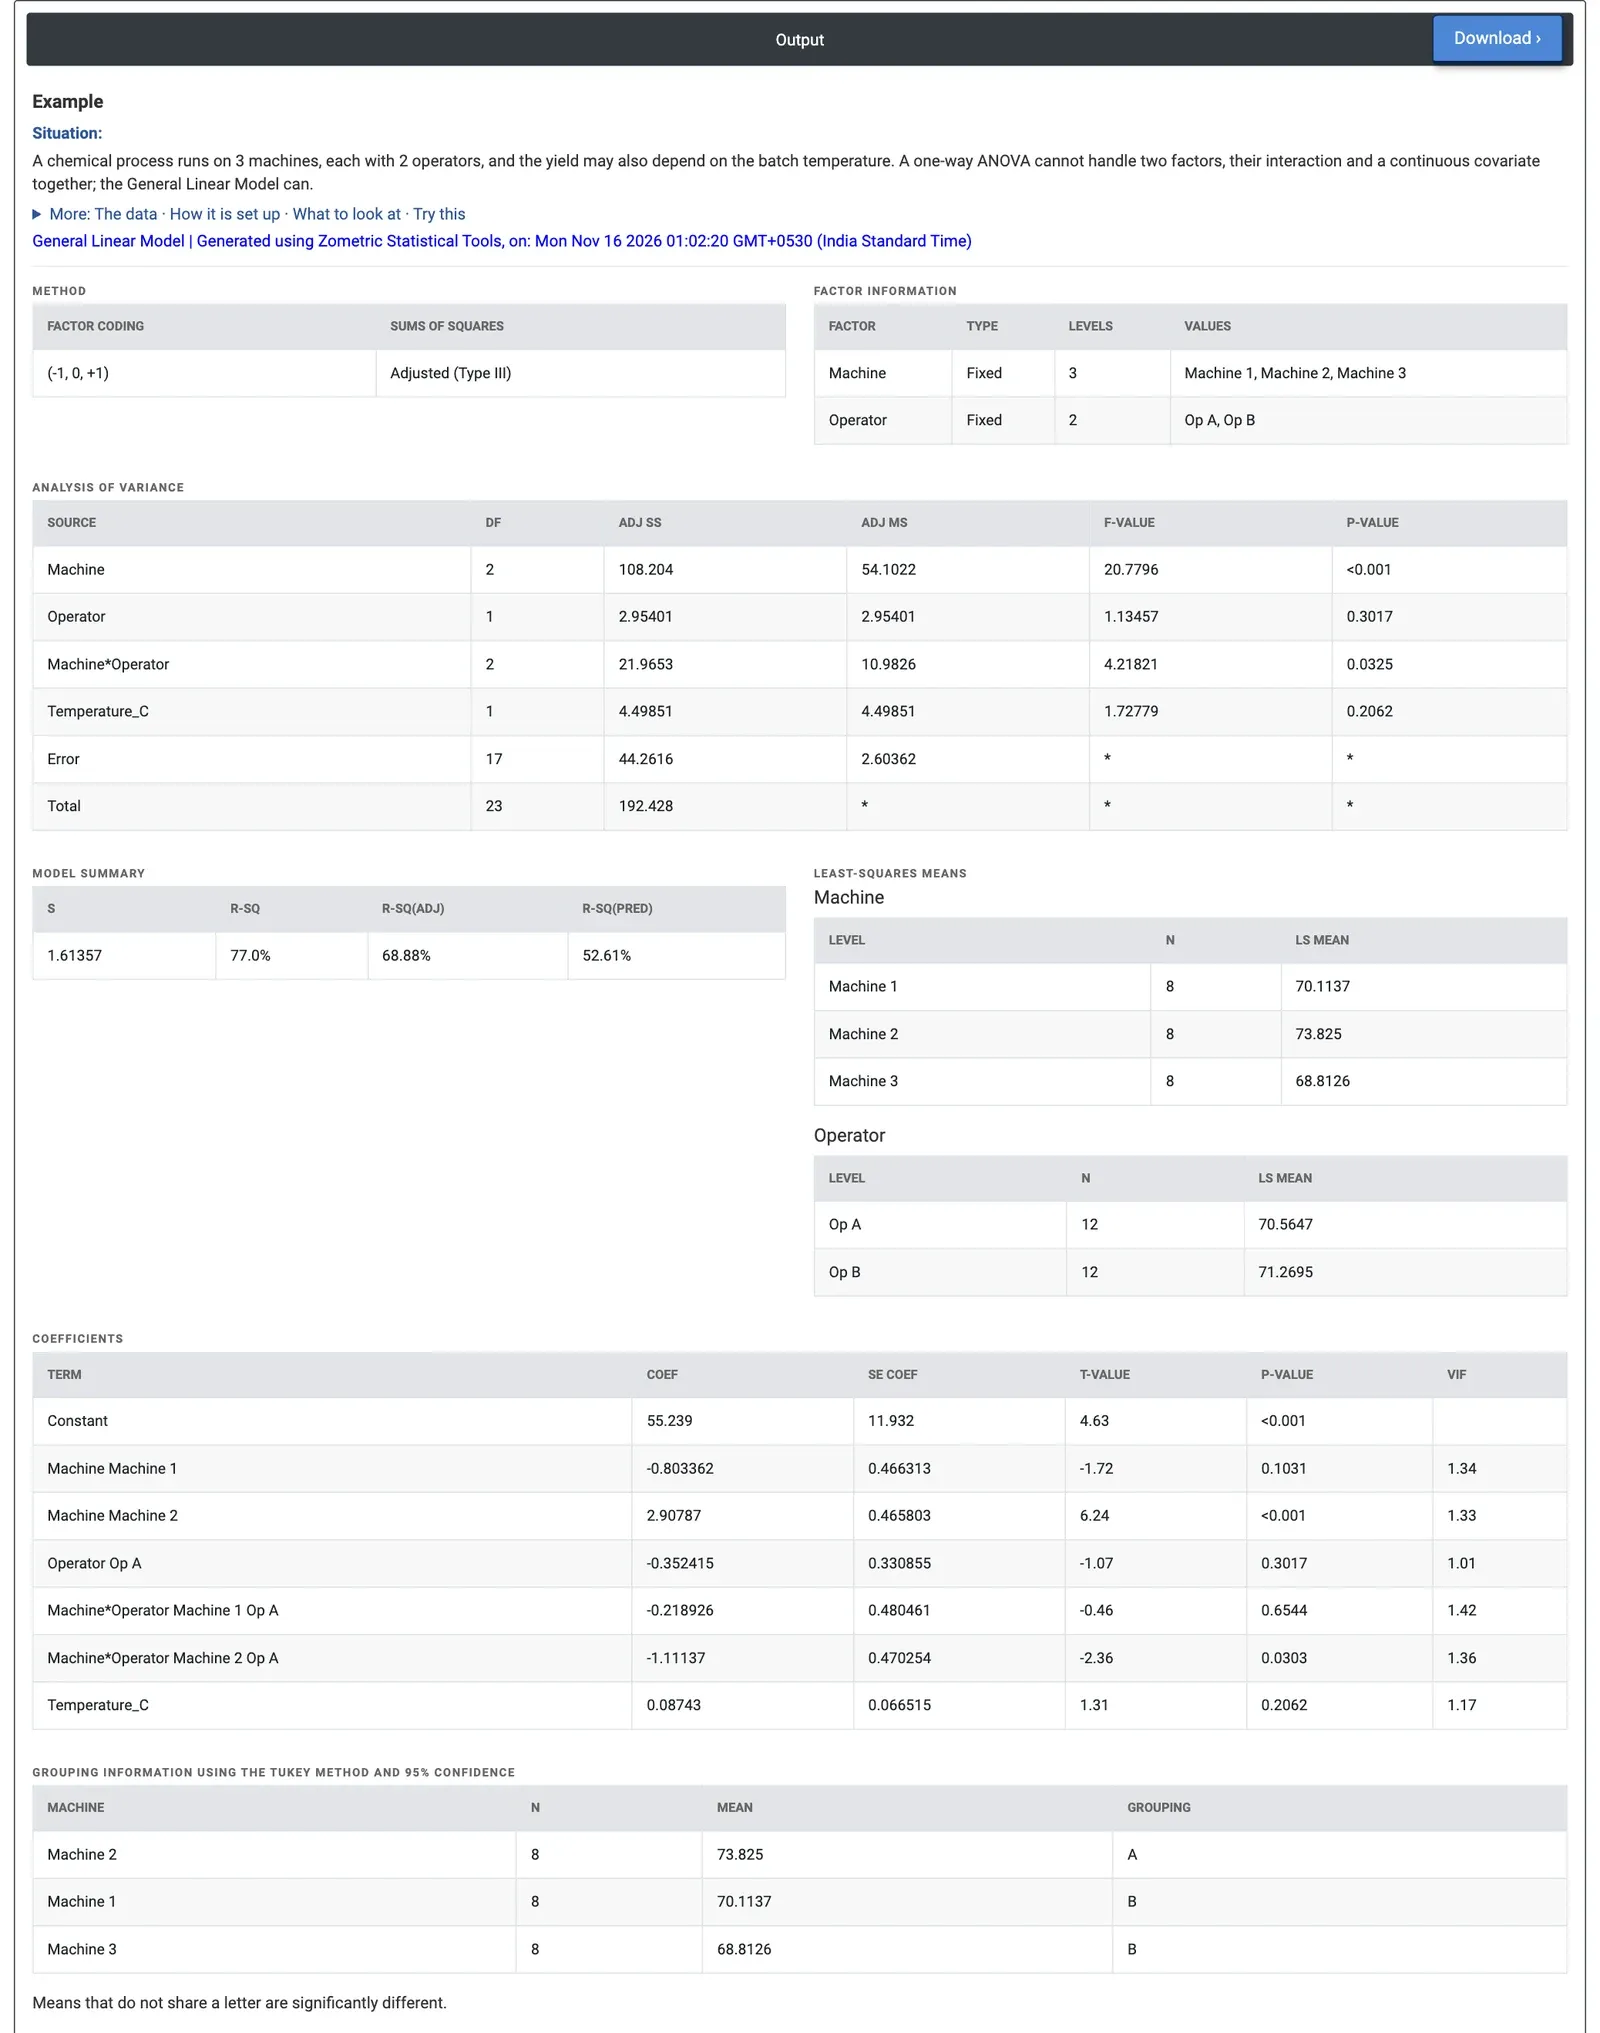
Figure 2 — Résultats du GLM pour le rendement : Machine est significatif (p < 0.001), tout comme l'interaction Machine*Operator (p = 0.0325) ; Machine 2 a la moyenne des moindres carrés la plus élevée, 73.83%.
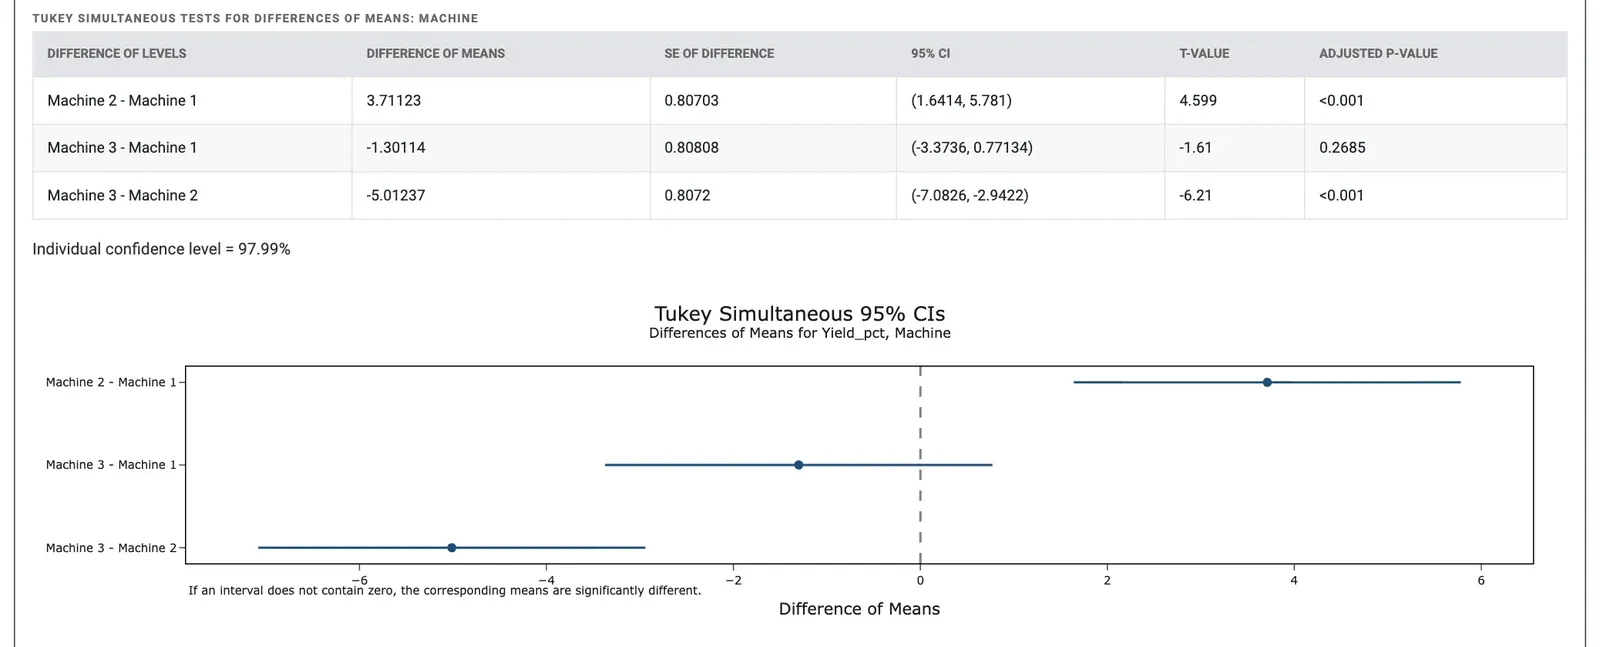
Figure 3 — Comparaisons de Tukey entre les machines : Machine 2 diffère des deux autres ; l'intervalle pour Machine 3 − Machine 1 contient zéro.
Exemple résolu
Un procédé chimique fonctionne sur trois machines, chacune avec deux opérateurs (Op A et Op B), et le rendement des lots peut aussi dépendre de la température du lot (170 à 190 °C). Il y a 24 lots, quatre pour chaque machine et chaque opérateur. L'ingénieur sélectionne Yield_pct comme réponse, Machine et Operator comme facteurs avec leur interaction, Temperature_C comme covariable, et demande des comparaisons de Tukey entre les machines.
Les machines diffèrent nettement (F = 20.78, p < 0.001). L'interaction Machine*Operator est aussi significative (F = 4.22, p = 0.0325) : Op B obtient plus avec les Machines 1 et 2, mais moins avec la Machine 3. L'opérateur seul (p = 0.3017) et la température (p = 0.2062) n'ont pas d'effet significatif dans la plage étudiée. Le modèle explique 77.0% de la variation (R-sq(adj) 68.88%), avec S = 1.61 points de pourcentage ; R-sq(pred) est plus faible, à 52.61%, de sorte que les prédictions pour de nouveaux lots seront moins précises que l'ajustement ne le laisse penser.
Les moyennes des moindres carrés sont de 73.83% pour la Machine 2, 70.11% pour la Machine 1 et 68.81% pour la Machine 3. Tukey place la Machine 2 seule dans le groupe A : son rendement dépasse de 3.71 points celui de la Machine 1 (IC à 95 % de 1.64 à 5.78) et de 5.01 points celui de la Machine 3, avec dans les deux cas une valeur p ajustée < 0.001, tandis que les Machines 1 et 3 ne diffèrent pas (p ajustée = 0.2685). L'ingénieur étudie ce qui est différent sur la Machine 2 et, à cause de l'interaction, examine l'association des opérateurs sur la Machine 3 avant de standardiser la méthode.
Questions fréquentes
Quand utiliser un modèle linéaire général plutôt qu'une ANOVA à un facteur ?
Utilisez un modèle linéaire général lorsqu'une ANOVA à un facteur ne suffit pas, par exemple lorsque le rendement peut dépendre de la machine, de l'opérateur, de leur combinaison et d'une condition mesurée comme la température, ou lorsque les données sont déséquilibrées. Il traite plusieurs facteurs qualitatifs, des interactions d'ordre 2 et des covariables continues dans un même modèle, et couvre aussi l'ANOVA à deux facteurs classique.
Que sont les moyennes des moindres carrés dans un GLM ?
Une moyenne des moindres carrés est la prédiction du modèle pour un niveau de facteur, les autres facteurs étant moyennés sur leurs niveaux et les covariables maintenues à leur moyenne. Contrairement aux moyennes brutes, elle n'est pas biaisée par des tailles de groupes inégales ou des différences de covariables. Les comparaisons multiples du GLM comparent ces moyennes des moindres carrés entre les niveaux d'un facteur.
Quelle méthode de comparaison multiple utiliser dans un GLM ?
Tukey compare toutes les paires avec la distribution de l'étendue studentisée ; Fisher utilise des tests t individuels ; Bonferroni et Sidak ajustent la valeur critique de t au nombre de paires ; Dunnett compare chaque niveau à un témoin. Un intervalle qui ne contient pas zéro, ou des moyennes qui ne partagent pas de lettre de regroupement, indiquent une différence significative.
Quelles sont les hypothèses d'un modèle linéaire général ?
Le modèle suppose des erreurs indépendantes, normalement distribuées et de variance constante, que vous vérifiez avec les graphiques des résidus : résidus en fonction des valeurs ajustées, de l'ordre, histogramme et droite de probabilité. Les résidus standardisés au-delà de plus ou moins 2 sont signalés R, et les observations dont l'effet de levier dépasse 3p/n sont signalées X comme inhabituelles.